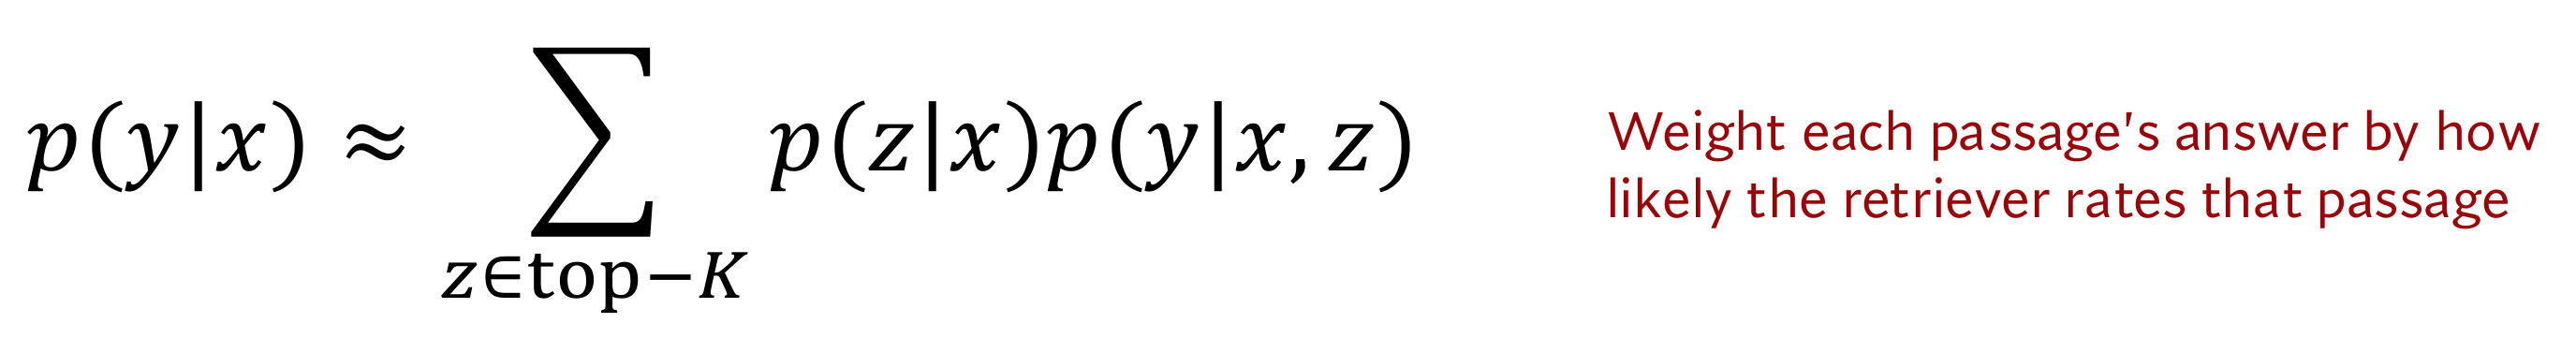LLM एक model है, जो text पढ़कर उसके आगे का text लिखता है, एक बार में एक token। हर अगला token वो probabilities देखकर चुनता है, और ये probabilities उसके parameters और आपके दिए text से बनती हैं।
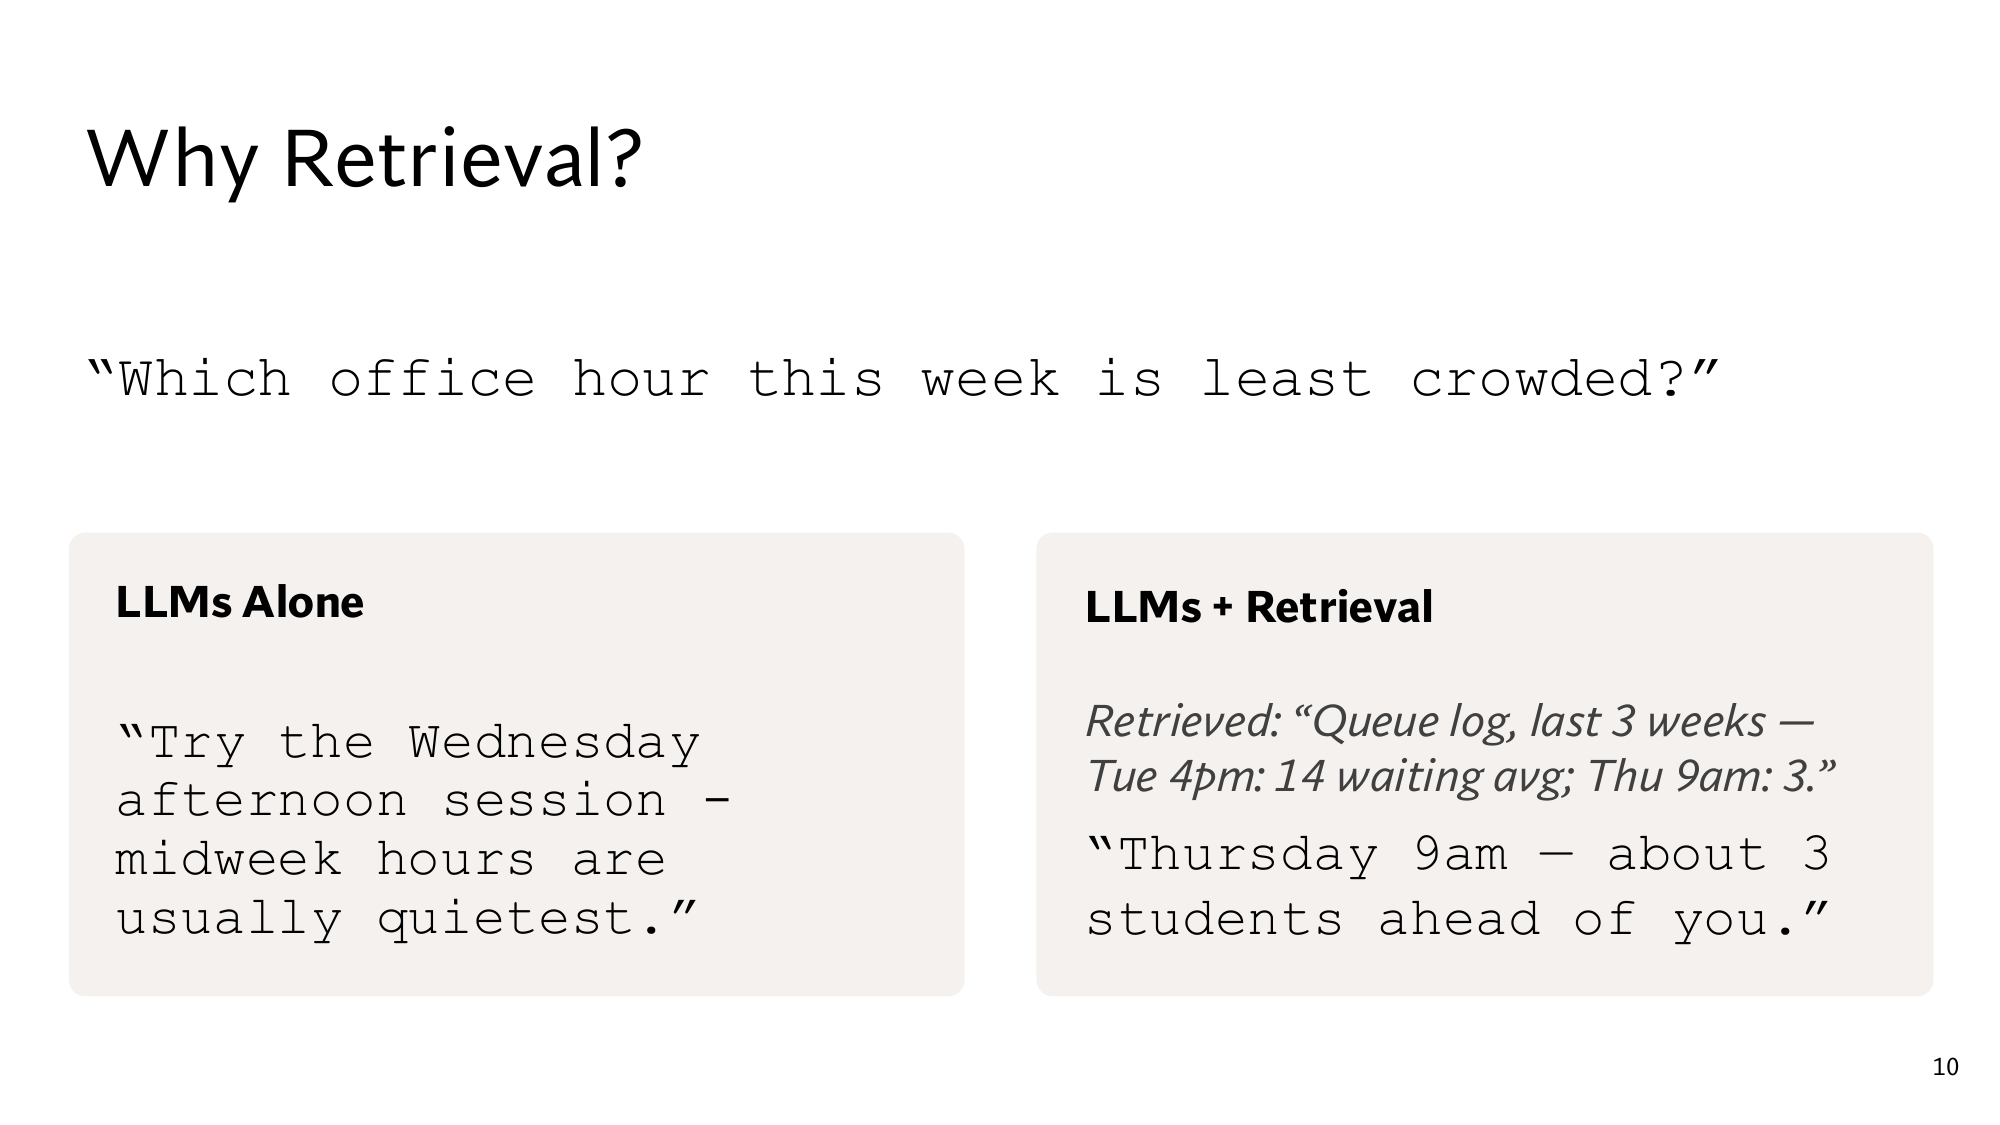
Lecture एक सवाल से शुरू होता है: Which office hour this week is least crowded? इस course के TAs, यानी पढ़ाने में मदद करने वाले senior students, हफ़्ते में दो बार office hours रखते हैं: Tuesday 4pm और Thursday 9am। Office hours वो तय घंटे हैं, जिनमें कोई भी student आकर सवाल पूछ सकता है। अकेले LLM से ये सवाल पूछिए, तो वो भरोसे से कहता है: Try the Wednesday afternoon session - midweek hours are usually quietest.
Course एक queue log रखता है, यानी हर office hour पर line में कितने students थे, उसका record। पिछले 3 हफ़्तों में Tuesday 4pm पर औसतन 14 students थे, और Thursday 9am पर सिर्फ़ 3। तो सही जवाब Thursday 9am है, और Wednesday को office hour होता ही नहीं। LLM ने ये log कभी नहीं देखा, फिर भी वो एक पल नहीं अटका। ये lesson बताता है कि ऐसा क्यों होता है।
इस lesson की सीढ़ी
सीढ़ी में 9 पड़ाव हैं। पहले 5 आसान version जैसे ही हैं, और 6 से 9 आपको Stanford की slides के level तक ले जाते हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
पहले से क्या चाहिए: कुछ नहीं, school का गणित काफ़ी है। पड़ाव 6 से आगे की कुछ बातें lessons 2 से 5 में पूरी आती हैं, और वहाँ उनके links हैं। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1Tokens: model text के टुकड़े पढ़ता है
Token text का एक छोटा टुकड़ा है: कभी पूरा शब्द, कभी शब्द का हिस्सा, कभी एक punctuation mark। LLM text को tokens में तोड़कर पढ़ता है, और जवाब भी tokens में लिखता है।
Tokens की ज़रूरत इसलिए है, क्योंकि computer सिर्फ़ numbers पर हिसाब करता है। Model के पास tokens की एक तय list होती है, जिसमें हर token का एक ID number है। इस list को vocabulary कहते हैं, और text को इसके tokens में तोड़ने वाले program को tokenizer।
आम शब्द अक्सर एक token होता है, और कम दिखने वाला शब्द कुछ टुकड़ों में टूटता है। जैसे Office hours are crowded on Tuesday में 6 शब्द हैं, लेकिन 7 tokens: split मेरा बनाया है
Office hours are crowded on Tuesday
यहाँ crowded दो tokens में टूटा: crowd और ed। इसी तरह vocabulary में Wednesdayy जैसी गलत spelling न हो, तब भी tokenizer उसे Wednesday और y में तोड़ देता है। असली split हर model के अपने tokenizer पर depend करता है।
Model tokens ही पढ़ता और लिखता है, इसलिए ये lecture हर length tokens में नापता है, शब्दों में नहीं।
2Next-token prediction: हर step पर एक token
जवाब लिखते वक्त LLM हर step पर हर token को एक probability देता है, फिर एक token चुनकर text में जोड़ता है। फिर वो नए text पर यही दोहराता है। इस loop को next-token prediction कहते हैं, और पूरा जवाब इसी loop से बनता है।
Probability 0 से 1 के बीच का number है, जो किसी बात का chance बताता है: 0 यानी कभी नहीं, और 1 यानी पक्का। जैसे पिछले 20 lectures में से 5 में quiz हुआ, तो अगले में quiz की probability 5 ÷ 20 = 0.25 है। Quiz न होने की probability 15 ÷ 20 = 0.75 है, और सारे options का जोड़ हमेशा 1 होता है।
अब model को ये text मिला: The least crowded office hour this week is। अगले token की probabilities कुछ ऐसी हो सकती हैं: numbers मेरे बनाए हैं
अगला token
Probability
" Wednesday"
0.34
" Thursday"
0.21
" Tuesday"
0.18
" Friday"
0.15
" Monday"
?
जोड़
1.00
असल में बाकी हज़ारों tokens को भी बहुत छोटी probabilities मिलती हैं। यहाँ हिसाब छोटा रखने के लिए मान लीजिए कि सिर्फ़ ये 5 tokens हैं।
Monday वाली row आप निकालिए
पाँचों probabilities का जोड़ 1 होना चाहिए। Monday की probability कितनी है?
जवाब देखिए
बाकी चार का जोड़ 0.34 + 0.21 + 0.18 + 0.15 = 0.88 है। तो Monday = 1 − 0.88 = 0.12।
अब मान लीजिए model हर step पर सबसे ऊँची probability वाला token लेता है। पहले step पर वो Wednesday लेगा, और फिर उसके बाद के token की probabilities देखेगा। नीचे के widget में “सबसे ज़्यादा वाला चुनिए” तीन बार दबाइए। आगे के steps के numbers भी मेरे बनाए हैं
खुद जवाब बनवाइए
किसी token पर click कीजिए, या “सबसे ज़्यादा वाला चुनिए” तीन बार दबाइए।
तीन steps के बाद model वही लिखता है, जो lesson की शुरुआत में था: Wednesday afternoon। किसी भी step पर उसने queue log नहीं देखा। Wednesday को 0.34 इसलिए मिला, क्योंकि “midweek is quiet” जैसी बातें लोग अक्सर लिखते हैं। मतलब probability बताती है कि इस text के बाद कौन सा token आम है, ये नहीं कि कौन सा सच है।
असली models अक्सर probability के हिसाब से random चुनते हैं। तब 0.34 वाला token करीब 34% बार आता है, और एक ही सवाल पर अलग-अलग जवाब आ सकते हैं।
पहले सोचिए
Widget में आपने Thursday, morning और full stop चुने, यानी 0.21, 0.31 और 0.71 वाले tokens। Queue log के हिसाब से Thursday 9am सच में सबसे खाली है। तो क्या इस बार model को जवाब पता था?
जवाब देखिए
नहीं। जवाब किस्मत से सही निकला। Model ने log देखा ही नहीं, और उसने Thursday को Wednesday से कम probability दी थी।
3Parameters और training: model की जानकारी कहाँ रहती है
Parameters model के अंदर के numbers हैं। Input के tokens इन numbers के साथ एक तय हिसाब से मिलते हैं, और उसी हिसाब से हर अगले token की probability निकलती है। Parameters का दूसरा नाम weights है, और ये बहुत सारे होते हैं। जैसे Stanford की slides वाले T5-11B model में करीब 11 billion parameters हैं। paper से
इन parameters की values training तय करती है। शुरू में parameters random होते हैं। फिर model बहुत सारा text पढ़ता है, और training हर जगह देखती है कि असली अगले token को model ने कितनी probability दी। फिर वो parameters को थोड़ा बदलती है, ताकि वो probability बढ़े।
एक step करके देखिए। Training के text में ये line है: Office hours are on Thursday. Model Office hours are on पढ़कर अगले token Thursday को 0.10 देता है। Training parameters को थोड़ा बदलती है, और अब वही text पढ़ने पर Thursday को 0.12 मिलता है। मेरा example जोड़ 1 ही रहता है, इसलिए बाकी tokens का कुल हिस्सा 0.90 से घटकर 0.88 हो गया।
इस तरह model जो कुछ “जानता” है, वो parameters की values में बँटा हुआ है, किसी अलग file या database में नहीं। ऐसी जानकारी को parametric knowledge कहते हैं। Training किसी एक तारीख पर रुकती है, और उसके बाद parameters नहीं बदलते। उस तारीख को knowledge cutoff कहते हैं।
Queue log इस course का अपना data है, इसलिए वो किसी model की training में कभी गया ही नहीं। उसके 14 और 3 किसी parameter में नहीं हैं। इसी से parametric knowledge की दो दिक्कतें दिखती हैं:
नई बात अंदर नहीं जाती। Knowledge cutoff के बाद की बात, या आपका private data, डालने के लिए model को फिर से train करना पड़ेगा।
Model source नहीं बता सकता। जानकारी अरबों numbers में घुली है, इसलिए model नहीं बता सकता कि कोई बात किस document से आई।
4Prompt और context window
Prompt वो text है, जो आप model को अभी देते हैं: सवाल, instructions, और साथ में कोई document। Next-token prediction हर step पर अब तक का पूरा text देखता है, और उसमें prompt भी है। इसलिए prompt का text हर probability बदल सकता है, जबकि parameters वही रहते हैं।
अब सवाल से पहले prompt में queue log की वो line रखिए, जिसमें Tuesday 4pm पर 14 और Thursday 9am पर 3 लिखा है।
पहले सोचिए: Parameters वही हैं, सिर्फ़ prompt बदला है। Thursday की 0.21 और Wednesday की 0.34 ऊपर जाएँगी या नीचे? अंदाज़ा लगाकर नीचे का box on कीजिए।
Prompt बदलिए, probabilities देखिए
Parameters वही हैं, सिर्फ़ prompt बदल रहा है। numbers मेरे बनाए हैं
Log जोड़ते ही Thursday की probability 0.21 से 0.81 हो गई, और Wednesday की 0.34 से 0.05, जबकि parameters वही रहे। जो जानकारी parameters में नहीं है, उसे prompt में रखिए, तो model उसका इस्तेमाल करता है। पूरा lecture इसी बात पर बना है।
Prompt की भी एक हद है। Model एक बार में गिने हुए tokens ही पढ़ सकता है, और इस limit को context window कहते हैं। इसमें prompt और model का लिखा जवाब, दोनों आते हैं। जैसे window 8,000 tokens की हो, और prompt 7,500 का, तो जवाब के लिए सिर्फ़ 500 tokens बचते हैं।
Course के सारे documents मिलाकर इस window से कहीं बड़े हो सकते हैं। इसलिए हर सवाल पर चुनना पड़ता है कि कौन से टुकड़े prompt में जाएँ, और lesson 2 इसी चुनाव से शुरू होता है।
पहले सोचिए
Context window 8,000 tokens का है। सवाल और instructions 300 tokens के हैं, और जवाब के लिए 700 चाहिए। हर passage, यानी document का एक टुकड़ा, 500 tokens का है। Prompt में ज़्यादा से ज़्यादा कितने passages आएँगे?
जवाब देखिए
Passages के लिए 8,000 − 300 − 700 = 7,000 tokens बचते हैं, और 7,000 ÷ 500 = 14 passages।
5Hallucination: data के बिना भरोसे वाला जवाब
Hallucination ऐसा जवाब है, जो पढ़ने में ठीक और भरोसे वाला लगे, लेकिन गलत हो, या किसी source पर टिका न हो। Wednesday afternoon वाला जवाब ऐसा ही है, और उसकी वजह पिछले तीन पड़ावों को जोड़ने से मिलती है।
Queue log parameters में नहीं था, क्योंकि वो कभी training में गया ही नहीं (पड़ाव 3)। वो prompt में भी नहीं था (पड़ाव 4)। फिर भी next-token prediction हर step पर कोई न कोई token चुनता है, और सबसे आम token Wednesday था (पड़ाव 2)।
Next-token prediction में ऐसा कोई step नहीं है, जो data न होने पर रुक जाए। इसलिए गलत जवाब भी उतने ही भरोसे से लिखा होता है, जितना सही जवाब, और पढ़ने वाला फ़र्क नहीं पकड़ पाता।
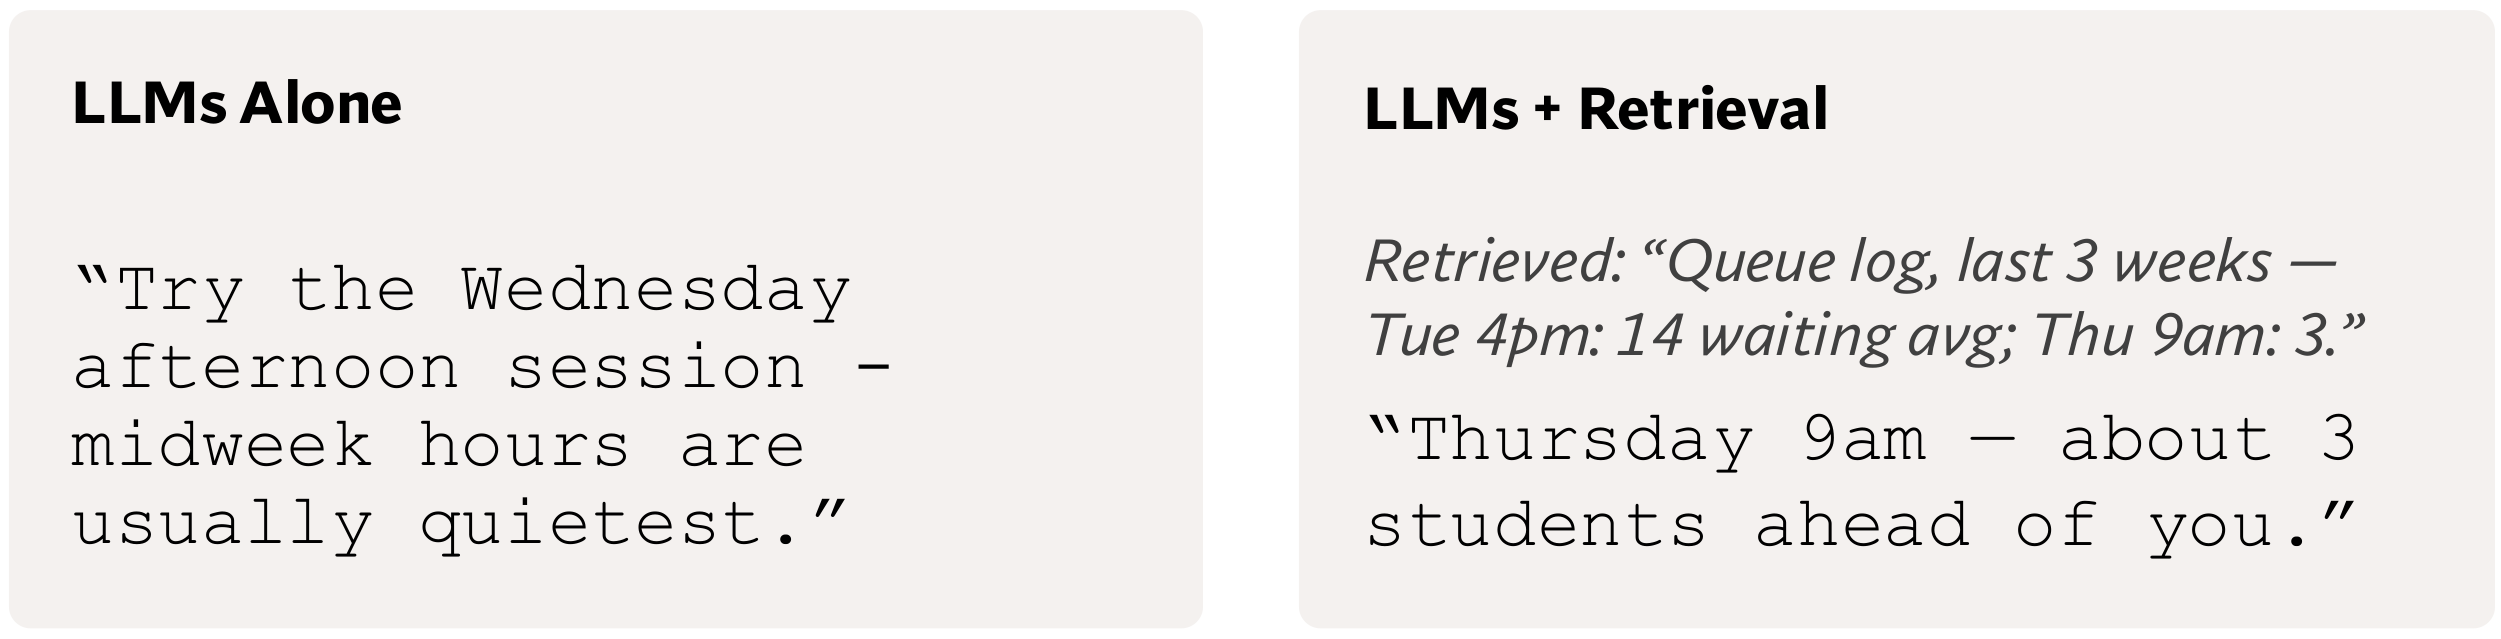
Stanford की Why Retrieval वाली slide। बाईं तरफ़ अकेला LLM है, जिसने Wednesday लिखा। दाईं तरफ़ prompt में queue log की line है, और जवाब Thursday 9am है। Image पर click करने से वो पूरे size में खुलती है।
Slide के दाएँ हिस्से में retrieval है, यानी सवाल के वक्त सही text ढूँढकर prompt में रखना। वहाँ जवाब का 3 सीधे log की line से आया है, इसलिए पढ़ने वाला उसे check कर सकता है। Lesson 2 यहीं से शुरू होता है।
पहले सोचिए
किस prompt में hallucination का chance सबसे कम है? (a) सिर्फ़ सवाल। (b) सवाल और queue log। (c) सवाल और 2024 का एक पुराना forum post, जिसमें लिखा है midweek afternoons are usually quiet।
जवाब देखिए
(b)। (c) में model पुराने post के भरोसे फिर Wednesday लिख सकता है, यानी prompt में गलत text भी नुकसान करता है। ये बात lesson 2 में फिर आएगी।
यहाँ से Stanford वाला level
ऊपर के 5 पड़ाव आसान version जैसे ही हैं। आगे के 4 पड़ाव आपको Stanford की slides के level तक ले जाते हैं। इनमें पहले slide की notation और पूरे जवाब की probability है, फिर सिर्फ़ parameters वाले models के numbers, और फिर papers के experiments। आख़िर में आप slides खुद पढ़ते हैं। हर गणित वहीं समझाया है, जहाँ वो पहली बार आता है।
6Slide की notation: p(y | x, z), θ, और पूरे जवाब की probability
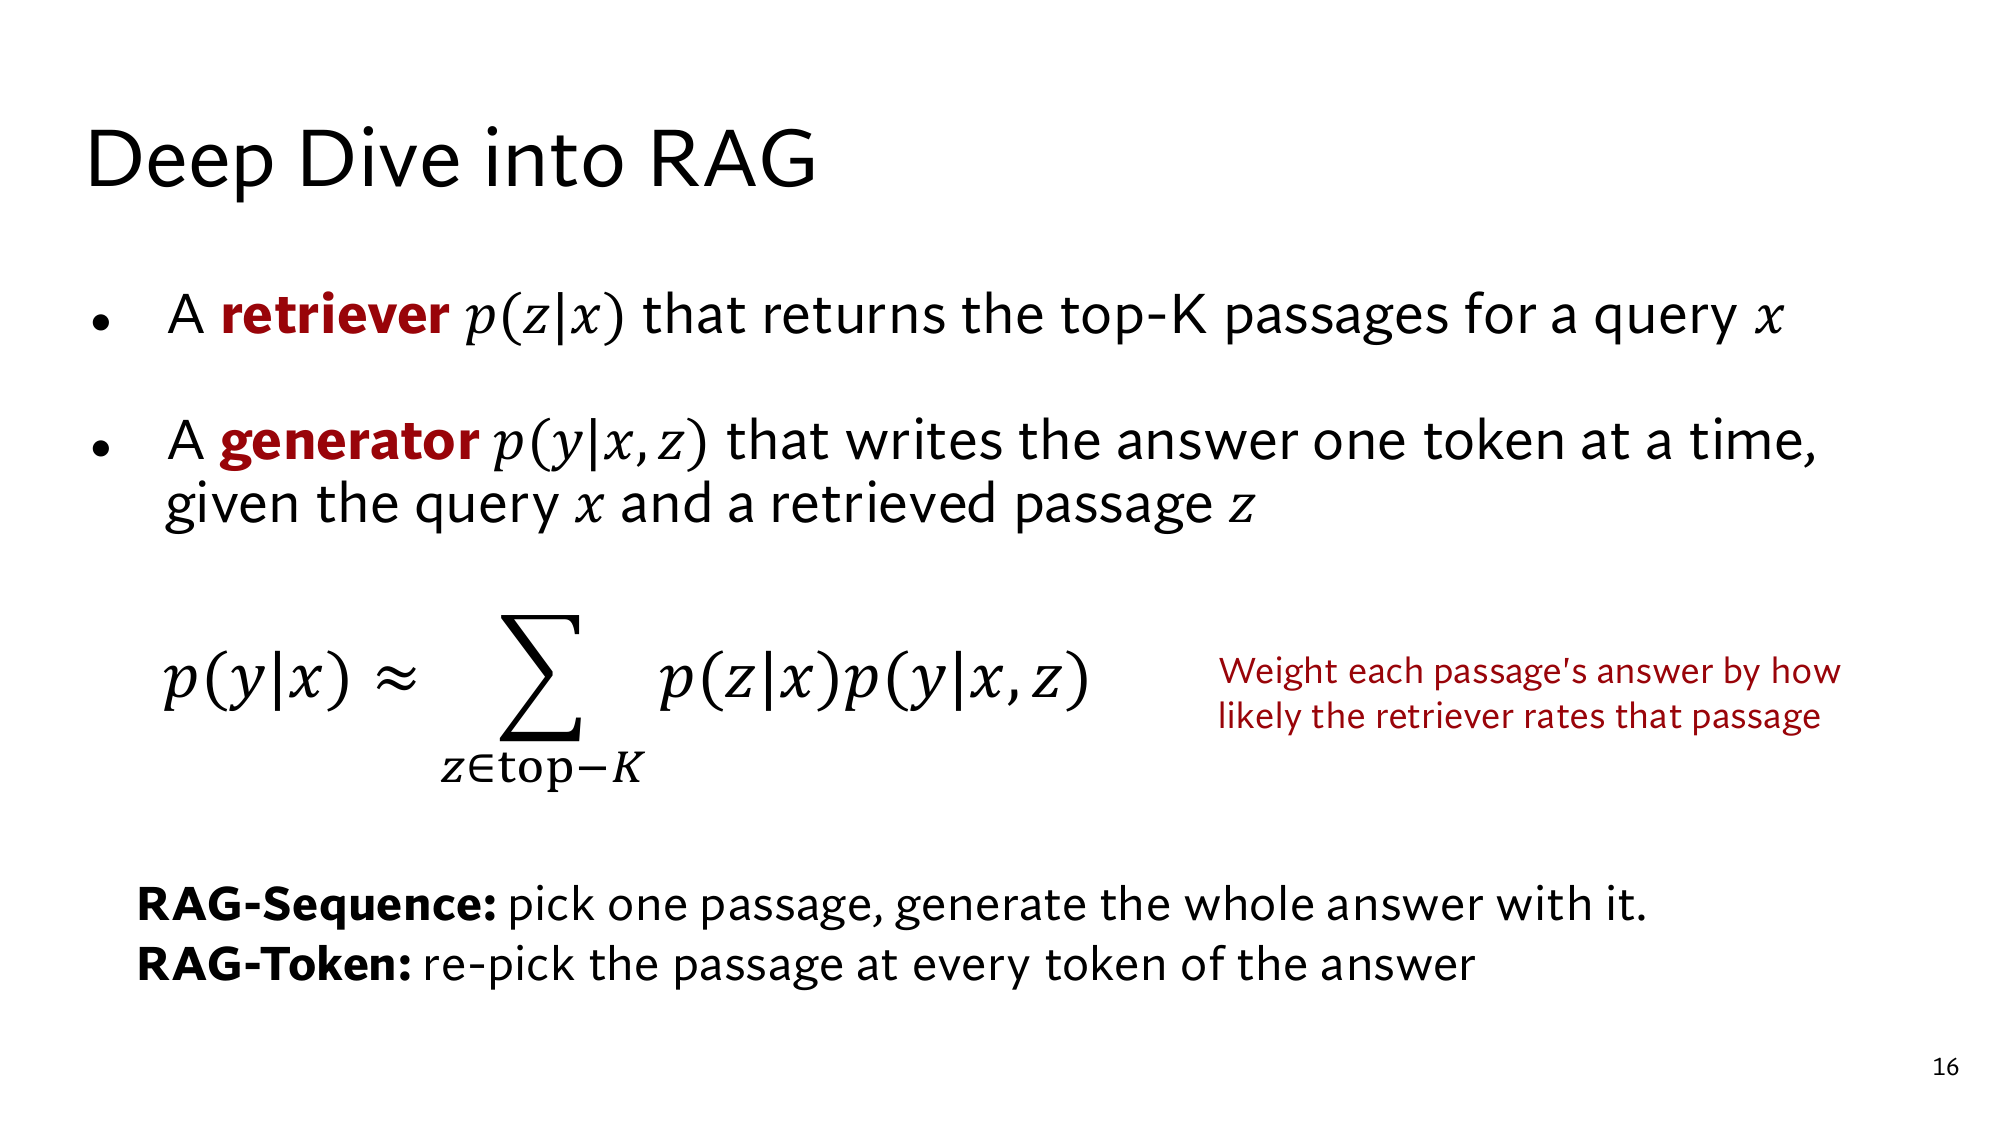
Stanford की slides LLM को generator कहती हैं, और उसका काम एक line में लिखती हैं:
A generator p(y|x, z) that writes the answer one token at a time, given the query x and a retrieved passage z.
ये line पड़ाव 2 वाला next-token prediction ही है, बस symbols में। इस पड़ाव में आप इसका हर symbol अपने numbers से पढ़ेंगे।
“|” के बाद का text: p(y | x) और p(y | x, z)
Symbols से पहले पड़ाव 4 के दो numbers लीजिए। Text The least crowded office hour this week is के बाद Thursday को 0.21 मिला था। उस text से पहले queue log की line रखने पर 0.81 मिला। Token वही था, सिर्फ़ उससे पहले का text बदला। Notation यही फ़र्क लिखता है:
Symbol
मतलब
हमारे example में
x
Query, यानी model को मिला text
The least crowded office hour this week is
z
Retrieved passage, यानी prompt में रखा document का टुकड़ा
Queue log की line
y
जवाब, या उसका कोई token
Thursday
p(y | x)
सिर्फ़ x हो, तो y की probability
0.21
p(y | x, z)
x और z दोनों हों, तो y की probability
0.81
खड़ी line “|” को “given” पढ़ते हैं। उसके बाद वो text आता है, जो model के पास पहले से है, और comma का मतलब “और” है। Lesson 4 इसे के नाम से पूरा समझाता है। यहाँ इतना काफ़ी है कि “|” के बाद का text बदलने से उसी token की probability बदलती है।
θ: generator के parameters
Slide पर generator का पूरा नाम pθ है। θ (theta) generator के parameters का नाम है, यानी पड़ाव 3 वाले वो सारे numbers। नीचे θ लिखने का मतलब है कि ये probabilities इन्हीं parameters से निकलती हैं। Retriever के parameters का नाम η (eta) है, और वो lesson 5 में आता है।
पड़ाव 3 का training step इस notation में ऐसा दिखता है। pθ(Thursday | Office hours are on) पहले 0.10 था, और θ थोड़ा बदलने के बाद 0.12 हुआ। वहाँ text वही रहा, और θ बदला। पड़ाव 4 में उल्टा हुआ था: θ वही रहा, और “|” के बाद का text बदला।
One token at a time: पूरे जवाब की probability
Generator जवाब एक बार में एक token लिखता है, इसलिए पूरे जवाब की probability हर token की probability से बनती है। ये बात गिनती से सबसे साफ़ दिखती है। मान लीजिए model random चुनाव से वही जवाब 1,000 बार लिखता है, और हर step पर widget वाली probabilities लेता है: numbers मेरे बनाए हैं
पहले step पर करीब 1,000 × 0.34 = 340 बार Wednesday आता है।
उन 340 में से 46% बार अगला token afternoon है: 340 × 0.46 = 156.4, यानी करीब 156 बार।
उनमें से 71% बार full stop आता है: 156.4 × 0.71 = 111.0, यानी करीब 111 बार।
1,000 में से 111 बार का मतलब है कि पूरे जवाब Wednesday afternoon. की probability 0.111 है। यही तीनों probabilities का गुणा है: 0.34 × 0.46 × 0.71 = 0.111। हर step पिछले step के cases में से एक हिस्सा लेता है, इसलिए probabilities गुणा होती हैं। Formula यही गुणा ऐसे लिखता है:
यहाँ y1 = Wednesday (0.34), y2 = afternoon (0.46) और y3 = full stop (0.71)। हर token के “|” के बाद सवाल और उससे पहले के सारे tokens हैं। वजह ये है कि next-token prediction हर step पर अब तक का पूरा text देखता है। RAG paper हर token की probability pθ(yi | x, z, y1:i−1) लिखता है, जहाँ y1:i−1 का मतलब है token 1 से token i − 1 तक। paper से
पहले सोचिए
Widget का दूसरा जवाब Thursday morning. लीजिए, जिसके tokens की probabilities 0.21, 0.31 और 0.71 हैं। इस पूरे जवाब की probability कितनी है, और Wednesday afternoon. इससे कितने गुना ज़्यादा बार आता है?
जवाब देखिए
0.21 × 0.31 = 0.0651, और 0.0651 × 0.71 = 0.046, यानी 1,000 बार में करीब 46 बार। Wednesday afternoon 0.111 ÷ 0.046 = 2.4 गुना ज़्यादा बार आता है।
इसी गुणा से एक और बात निकलती है। हर probability 1 से छोटी है, इसलिए हर नया token पूरे जवाब की probability घटाता है। इस widget का सबसे आम जवाब भी सिर्फ़ 0.111 पर है, यानी 1,000 में से करीब 889 बार model कुछ और लिखता है।
Greedy decoding और sampling
Token चुनने के दो आम तरीके हैं, और पड़ाव 2 में दोनों आ चुके हैं। हर step पर सबसे ऊँची probability वाला token लेने को greedy decoding कहते हैं। Widget का “सबसे ज़्यादा वाला चुनिए” यही करता है, और उसका जवाब हर बार Wednesday afternoon होता है। Probability के हिसाब से random चुनने को sampling कहते हैं, और ऊपर की 1,000 बार वाली गिनती sampling की थी।
Sampling में पहला token हर बार बदल सकता है। 100 बार चलाइए, तो करीब 34 बार Wednesday आएगा, 21 बार Thursday, 18 बार Tuesday, 15 बार Friday और 12 बार Monday। यानी sampling कभी-कभी सही Thursday भी लिखता है, लेकिन पड़ाव 2 के सवाल की तरह सिर्फ़ किस्मत से।
Papers सवाल-जवाब के लिए अक्सर greedy decoding लेते हैं। पड़ाव 7 वाला T5 paper हर step पर सबसे ऊँचा token चुनता है, और RAG paper भी सवाल-जवाब के लिए greedy decoding लेता है। paper से
7Closed-book QA: सिर्फ़ parameters से कितने जवाब सही
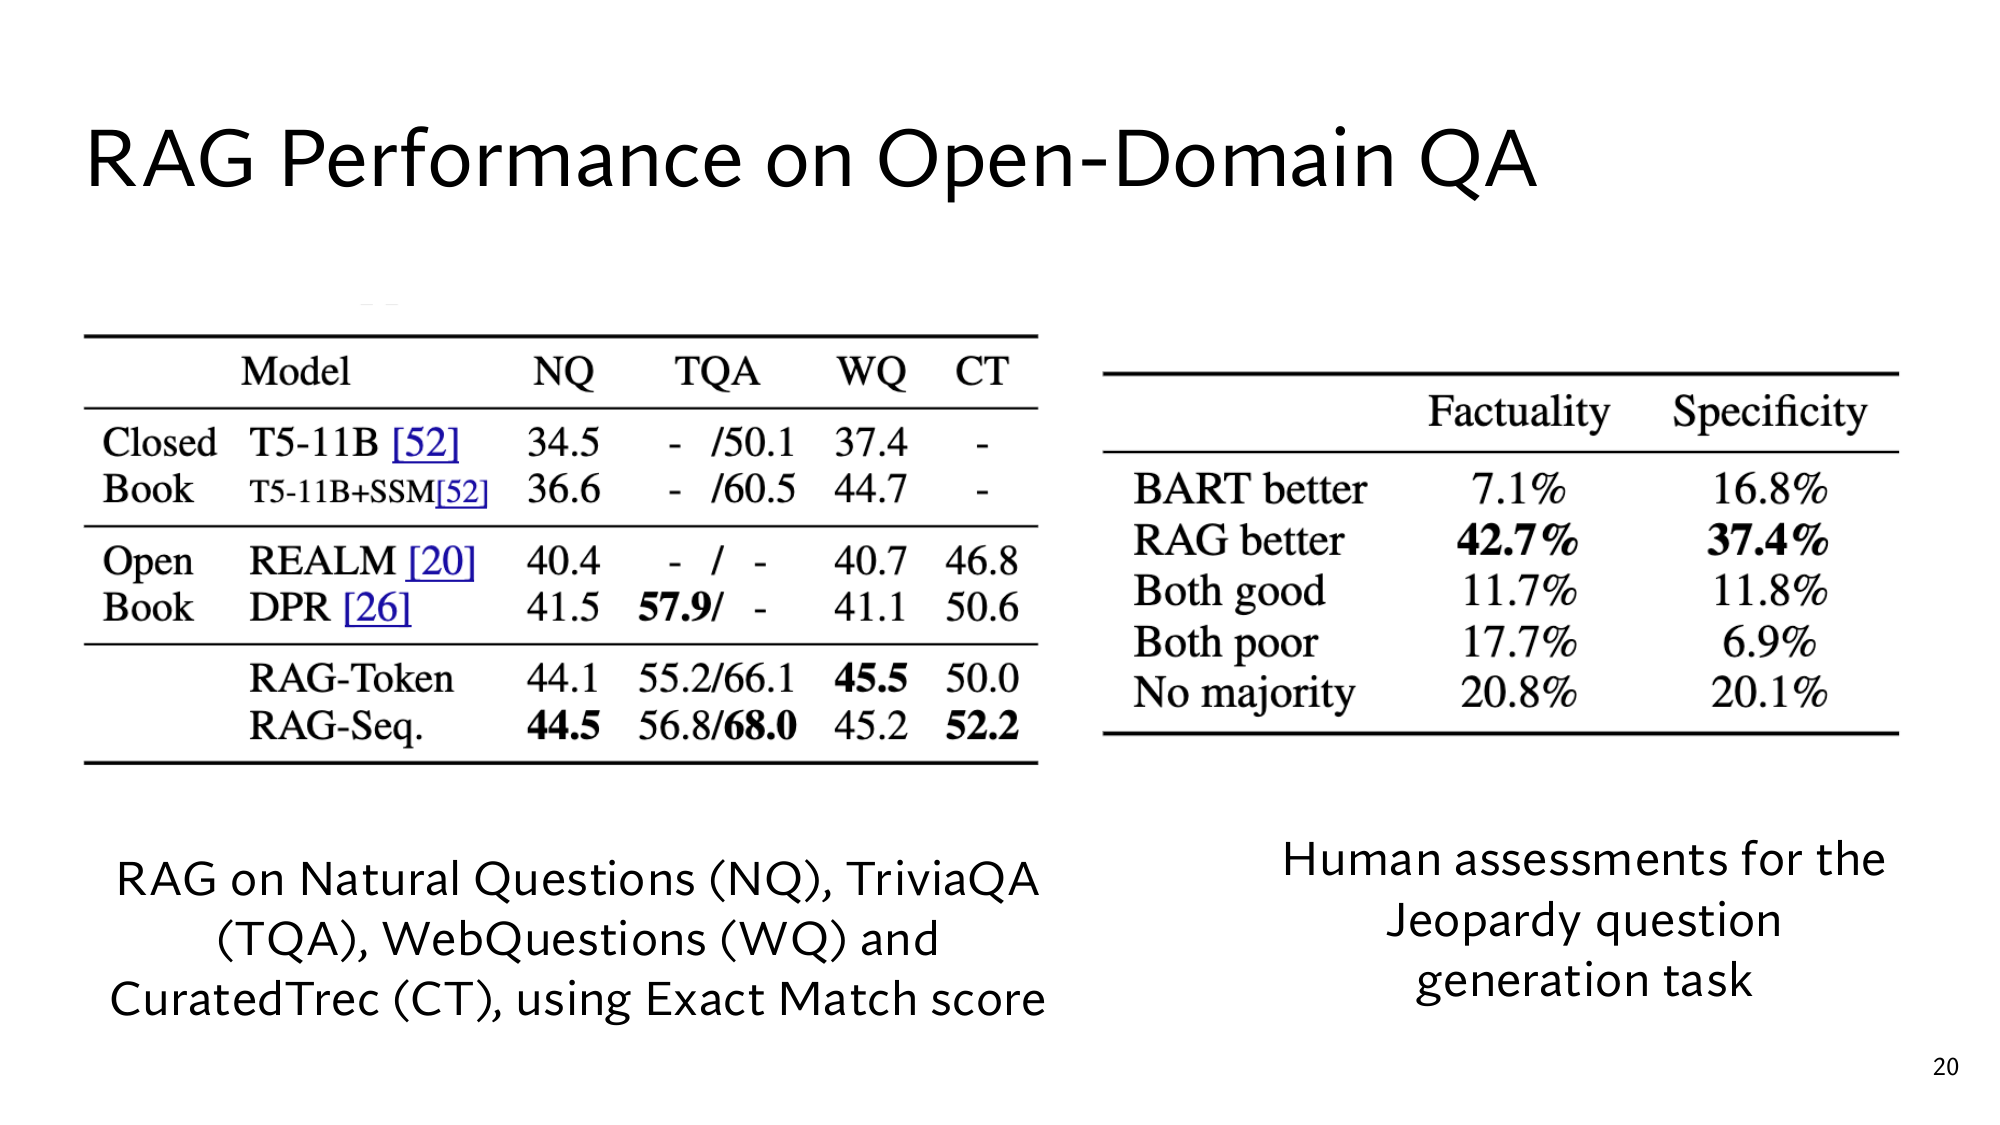
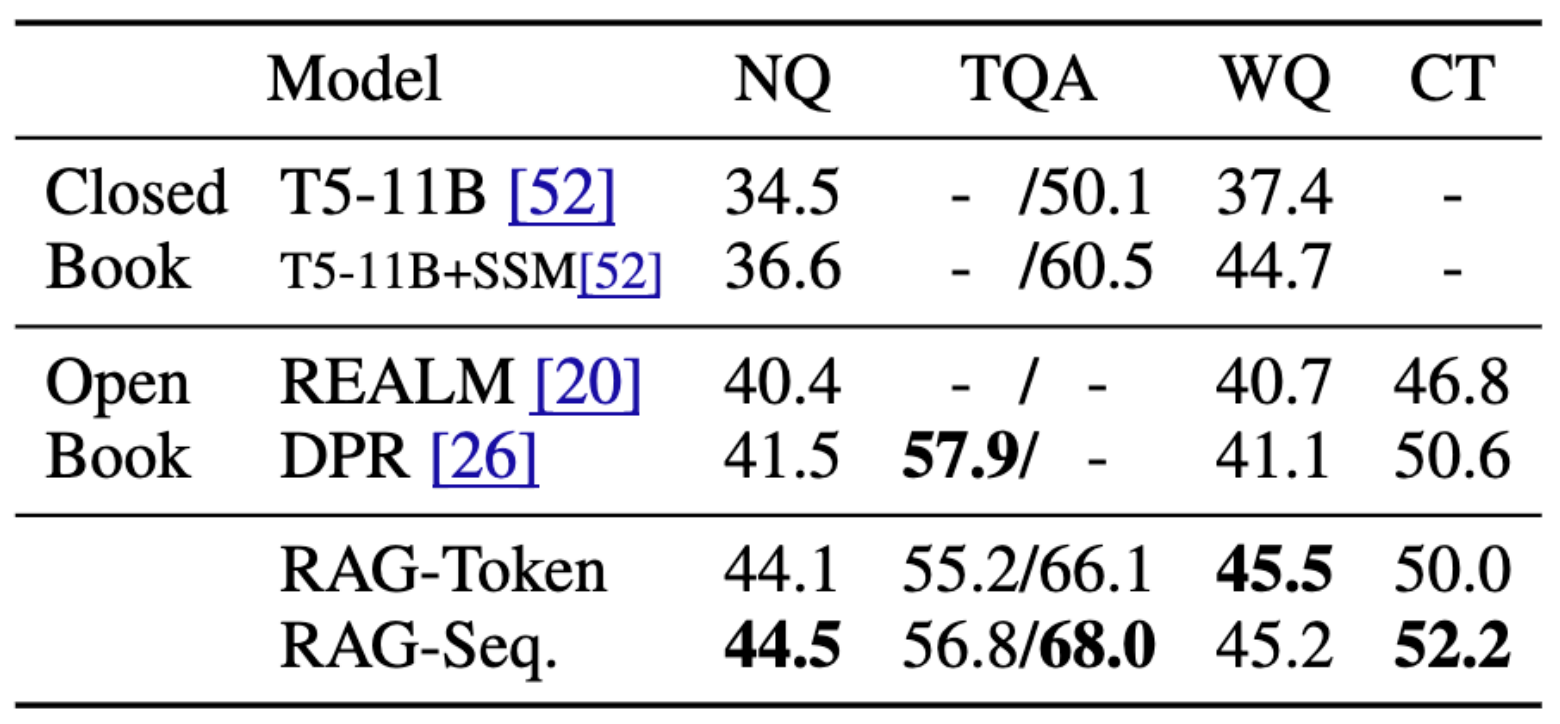
Closed-book question answering में model को सिर्फ़ सवाल मिलता है, कोई document नहीं, इसलिए वो जवाब सिर्फ़ parameters से लिखता है। Lesson की शुरुआत वाला अकेला LLM यही कर रहा था। Open book में system पहले documents में ढूँढता है, और फिर जवाब लिखता है। Stanford की RAG Performance वाली slide , दोनों तरह के models की तुलना करती है।
Slide की closed-book rows Roberts और साथियों के 2020 वाले paper से आती हैं। उन्होंने Google के T5 model को, जो text पढ़कर text लिखता है, सिर्फ़ सवाल देकर जवाब लिखना सिखाया, और कोई document नहीं दिया। paper से इस paper को आगे T5 paper कहेंगे।
Exact Match: जवाब हूबहू मिला या नहीं
इन tables के numbers हैं: कितने % सवालों में model का जवाब सही जवाब से हूबहू मिला। मिलाने से पहले दोनों को lowercase करते हैं, और a, an, the, punctuation और फ़ालतू spaces हटाते हैं। paper से जैसे सही जवाब Thursday 9am हो, तो thursday 9am. मिल जाता है। लेकिन Thursday 9 am नहीं मिलता, क्योंकि उसमें 9 और am के बीच space है।
Slide की table के चार columns चार datasets हैं। NQ यानी Natural Questions, जिसमें Google search के असली सवाल हैं। TQA यानी TriviaQA, जिसमें quiz websites के सवाल हैं। WQ यानी WebQuestions, और CT यानी CuratedTrec, दो छोटे सवाल-जवाब datasets हैं। paper से
Parameters बढ़ाने पर क्या बदलता है
T5 चार sizes में आता है, और paper ने चारों को एक ही तरीके से सवाल-जवाब सिखाया। नीचे TriviaQA के Wikipedia वाले test set के numbers हैं: paper से
Model
Parameters
TriviaQA (%)
T5-Base
220 million
29.1
T5-Large
770 million
35.9
T5-3B
3 billion
43.4
T5-11B
11 billion
50.1
T5-11B + SSM
11 billion
60.5
Base से 11B तक parameters 11,000 ÷ 220 = 50 गुना होते हैं, और score 29.1 से 50.1, यानी 21.0 points बढ़ता है। हर बड़ा size ज़्यादा सवालों के हूबहू सही जवाब देता है, यानी बड़ा model parameters में ज़्यादा जानकारी रखता है। TriviaQA का ये column इसलिए लिया है, क्योंकि उसके 50.1 और 60.5 Stanford की slide पर भी यही हैं। NQ पर इस paper के आज वाले version में T5-11B का 32.6 है, जबकि slide पर 34.5। इसलिए NQ के लिए slide का number लीजिए।
आख़िरी row का SSM, यानी salient span masking, training का एक extra दौर है। इसमें model Wikipedia के ऐसे sentences पढ़ता है, जिनमें नाम और तारीखों की जगह खाली है, और उसे वो खाली जगह भरनी होती है। T5 ने ये दौर 100,000 extra steps चलाया, और TriviaQA का score 50.1 से 60.5 हो गया। paper से ये दौर का हिस्सा है, यानी आम text पर वो बड़ी training, जो सवाल-जवाब सिखाने से पहले होती है।
कम parameters, साथ में documents
अब slide की table में NQ वाला column देखिए। Closed book में T5-11B 34.5 पर है, और SSM के साथ 36.6 पर। Open book में RAG-Seq. 44.5 पर है। 1,000 सवालों में ये 345 और 445 हूबहू सही जवाब हैं, यानी documents वाला system 100 सवाल ज़्यादा सही करता है।
RAG का generator नाम का model है, जिसमें करीब 400 million parameters हैं, और पूरे RAG में करीब 626 million। T5-11B में 11 billion हैं, यानी 11,000 ÷ 626 = 17.6 गुना ज़्यादा। RAG paper ये भी बताता है कि 770 million parameters वाला T5-Large, NQ पर 28.9 पर है। paper से
मतलब documents साथ हों, तो 17.6 गुना कम parameters वाला system भी NQ पर 10 points आगे है। RAG paper का नतीजा भी यही है, कि parameters और documents वाले system को अच्छे सवाल-जवाब के लिए बहुत कम parameters चाहिए। ये फ़ायदा पड़ाव 4 से आता है, क्योंकि जवाब वाला text prompt में मिल जाता है।
8Papers के experiments: hallucination और knowledge cutoff को नापना
पड़ाव 3 और 5 में parametric knowledge की तीन कमियाँ आईं। नई बात अंदर नहीं जाती, source नहीं मिलता, और data न हो, तब भी जवाब आता है। RAG paper की शुरुआत यही तीन कमियाँ लिखती है। ऐसे models अपनी memory आसानी से बढ़ा या बदल नहीं सकते, अपने जवाब की वजह नहीं दिखा सकते, और hallucination कर सकते हैं। paper से इस पड़ाव के तीन experiments इन्हें numbers में नापते हैं।
Exact Match के गलत माने 150 जवाब, हाथ से जाँचे
T5 paper ने NQ के ऐसे 150 जवाब हाथ से जाँचे, जिन्हें Exact Match ने गलत माना था। नतीजा चार हिस्सों में बँटा: paper से
किस्म
जवाब
हिस्सा
सच में गलतGhost of Christmas Present अपनी torch से क्या छिड़कता है? सही: warmth। T5: confetti।
93
62.0%
Wording अलगजैसे April 15 और April 15th।
20
13.3%
सही जवाबों की list अधूरीSpace shuttles कहाँ से launch होते हैं? List में सिर्फ़ florida। T5: kennedy lc39b।
20
13.3%
जवाब पूछने के वक्त पर depend करता हैNorthern Ireland का secretary of state कौन है?
17
11.3%
हिसाब: 93 + 20 + 20 + 17 = 150, और 93 ÷ 150 = 0.620, 20 ÷ 150 = 0.133, 17 ÷ 150 = 0.113। मतलब Exact Match closed-book model को कम आँकता है, लेकिन 62% जवाब फिर भी सच में गलत थे। Confetti वाला जवाब पढ़ने में सही जवाब जितना ही ठीक लगता है, और यही hallucination है। आख़िरी row knowledge cutoff से जुड़ी है, क्योंकि उसका जवाब समय के साथ बदलता है, और parameters training के वक्त पर रुके हुए हैं।
Paper के आख़िर में लेखक खुद तीन बातें लिखते हैं। Model जानकारी parameters में ऐसे बाँटता है, कि कोई उसे समझा नहीं सकता। जब model पक्का नहीं होता, तब वो असली दिखने वाले जवाब बना देता है। और training के बाद किसी खास जानकारी को जोड़ना या हटाना मुमकिन नहीं है। paper से
Jeopardy वाले सवाल: लोगों ने factuality जाँची
RAG paper में लोगों ने hallucination को सीधे जाँचा। Jeopardy एक quiz format है, जिसमें जवाब पहले मिलता है, और ऐसा सवाल लिखना होता है जिसका वो जवाब हो। जैसे जवाब The World Cup के लिए सवाल: In 1986 Mexico scored as the first country to host this international sports competition twice.paper से
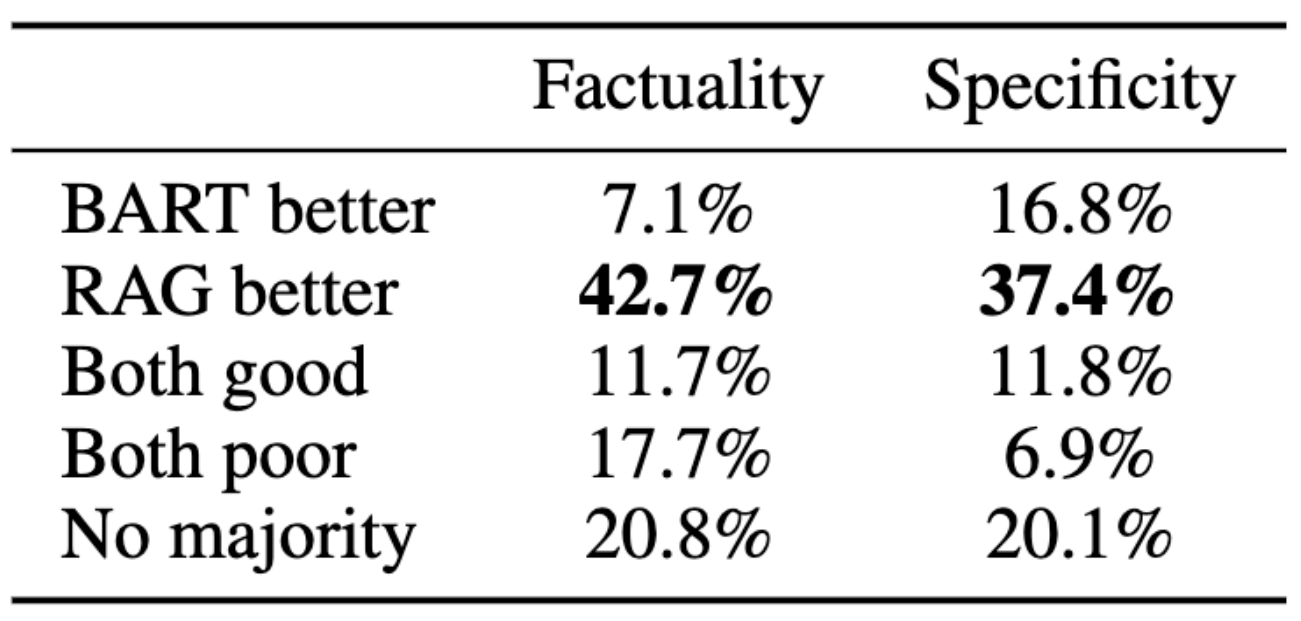
दो models ने ऐसे सवाल लिखे। BART अकेला generator है, जो सिर्फ़ अपने parameters से लिखता है। RAG में वही BART है, लेकिन उसके prompt में Wikipedia के passages भी हैं। लोगों ने 452 जोड़े पढ़े, और हर जोड़े में चुना कि किसका सवाल ज़्यादा factual है। Factual का मतलब है कि बात किसी भरोसेमंद source से साबित हो सके।
लोगों का फ़ैसला
Factuality
RAG बेहतर
42.7%
BART बेहतर
7.1%
दोनों अच्छे
11.7%
दोनों खराब
17.7%
बहुमत नहीं बना
20.8%
जोड़
100.0%
452 जोड़ों में 42.7% करीब 193 जोड़े हैं, और 7.1% करीब 32 जोड़े। हिसाब मेरायानी RAG का सवाल 42.7 ÷ 7.1 = 6.0 गुना ज़्यादा बार ज़्यादा factual निकला।
Paper की examples वाली table में अकेले BART के गलत जवाब भी पढ़ने में बिल्कुल ठीक लगते हैं। Jeopardy में Washington के लिए BART ने लिखा This state has the largest number of counties in the U.S., जिसे paper गलत बताता है। उसी जवाब के लिए RAG ने लिखा It’s the only U.S. state named for a U.S. president। paper से
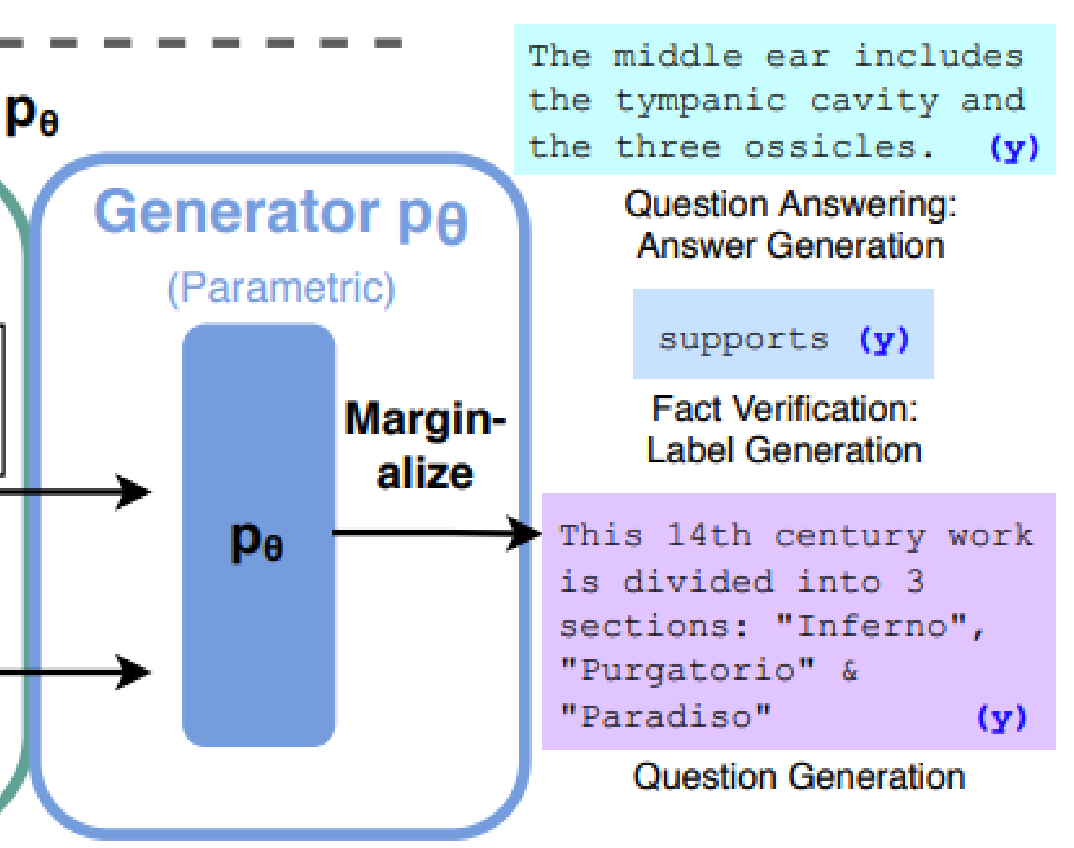
एक दूसरे task में define middle ear का एक sentence वाला जवाब लिखना था। वहाँ BART ने लिखा कि middle ear, middle ear और नाक के बीच का हिस्सा है, जो गलत है। RAG ने लिखा The middle ear includes the tympanic cavity and the three ossicles.paper से
Documents बदलकर नई जानकारी: index hot-swapping
पड़ाव 3 की पहली दिक्कत थी कि नई बात डालने के लिए फिर से training चाहिए। RAG के documents एक में रहते हैं, यानी passages की ऐसी list, जिसमें retriever तेज़ी से ढूँढ सके। RAG paper ने Wikipedia के December 2016 और December 2018 वाले दो indexes बनाए। paper से
फिर paper ने 82 ऐसे world leaders की list बनाई, जो इन दो तारीखों के बीच बदल गए थे। Model से Who is the President of Peru? जैसे सवाल पूछे। Model के parameters चारों हालात में वही थे, सिर्फ़ index बदला: paper से
Index ↓ / किस साल के leaders →
2016 वाले
2018 वाले
December 2016 का index
70%
4%
December 2018 का index
12%
68%
सही साल का index हो, तो 68% से 70% जवाब सही हैं, और गलत साल का हो, तो सिर्फ़ 4% से 12%। मतलब documents बदलने से model की जानकारी बदल गई, और इसके लिए कोई training नहीं लगी। Index को ऐसे बदलने को index hot-swapping कहते हैं। Lesson 2 इसी रास्ते को कहता है: जानकारी parameters के बाहर, documents में।
पहले सोचिए
Course ने Thursday वाला office hour 9am से 10am कर दिया। अकेले LLM वाले system में, और documents वाले system में, इसे सही करने के लिए क्या बदलना होगा?
जवाब देखिए
अकेले LLM के लिए parameters बदलने होंगे, यानी फिर से training। Documents वाले system में सिर्फ़ office hours वाला passage बदलना काफ़ी है, क्योंकि अगले सवाल पर retriever नया passage prompt में लाएगा। Paper का 2016 और 2018 वाला experiment यही दिखाता है।
9अब Stanford की slides खुद पढ़िए
नीचे Stanford की वो चार slides हैं, जिन पर ये lesson टिका है, बिना किसी बदलाव के। हर slide के नीचे कुछ सवाल हैं। पहले खुद जवाब सोचिए, फिर खोलिए। कोई symbol अटके, तो जवाब में लिखे पड़ाव पर लौट जाइए। Phone पर slide छोटी दिखे, तो image पर click कीजिए, वो पूरे size में खुलेगी।
Stanford की Why Retrieval वाली slide, और नीचे उसके दोनों boxes, बड़े करके।
Why Retrieval वाली slide पढ़िए
बाएँ box में LLM ने Wednesday afternoon क्यों लिखा, जबकि उस दिन office hour होता ही नहीं?
जवाब देखिए
Queue log न parameters में था, न prompt में। Next-token prediction फिर भी हर step पर कोई token चुनता है, और सबसे आम token Wednesday था। Probability ने बताया कि क्या आम है, ये नहीं कि क्या सच है। (पड़ाव 2, 3 और 5)
दाएँ box में Retrieved वाली line model तक कैसे पहुँची, और model का क्या बदला?
जवाब देखिए
वो line prompt में है। Parameters वही हैं, सिर्फ़ “|” के बाद का text बदला, यानी p(Thursday | x) = 0.21 से p(Thursday | x, z) = 0.81। (पड़ाव 4 और 6)
दाएँ जवाब का about 3 students ahead of you वाला 3 कहाँ से आया, और ये hallucination क्यों नहीं है?
जवाब देखिए
Log की line में Thu 9am के आगे 3 लिखा है, और जवाब ने वही number लिया। जवाब एक source पर टिका है, जिसे पढ़ने वाला check कर सकता है। (पड़ाव 4 और 5)
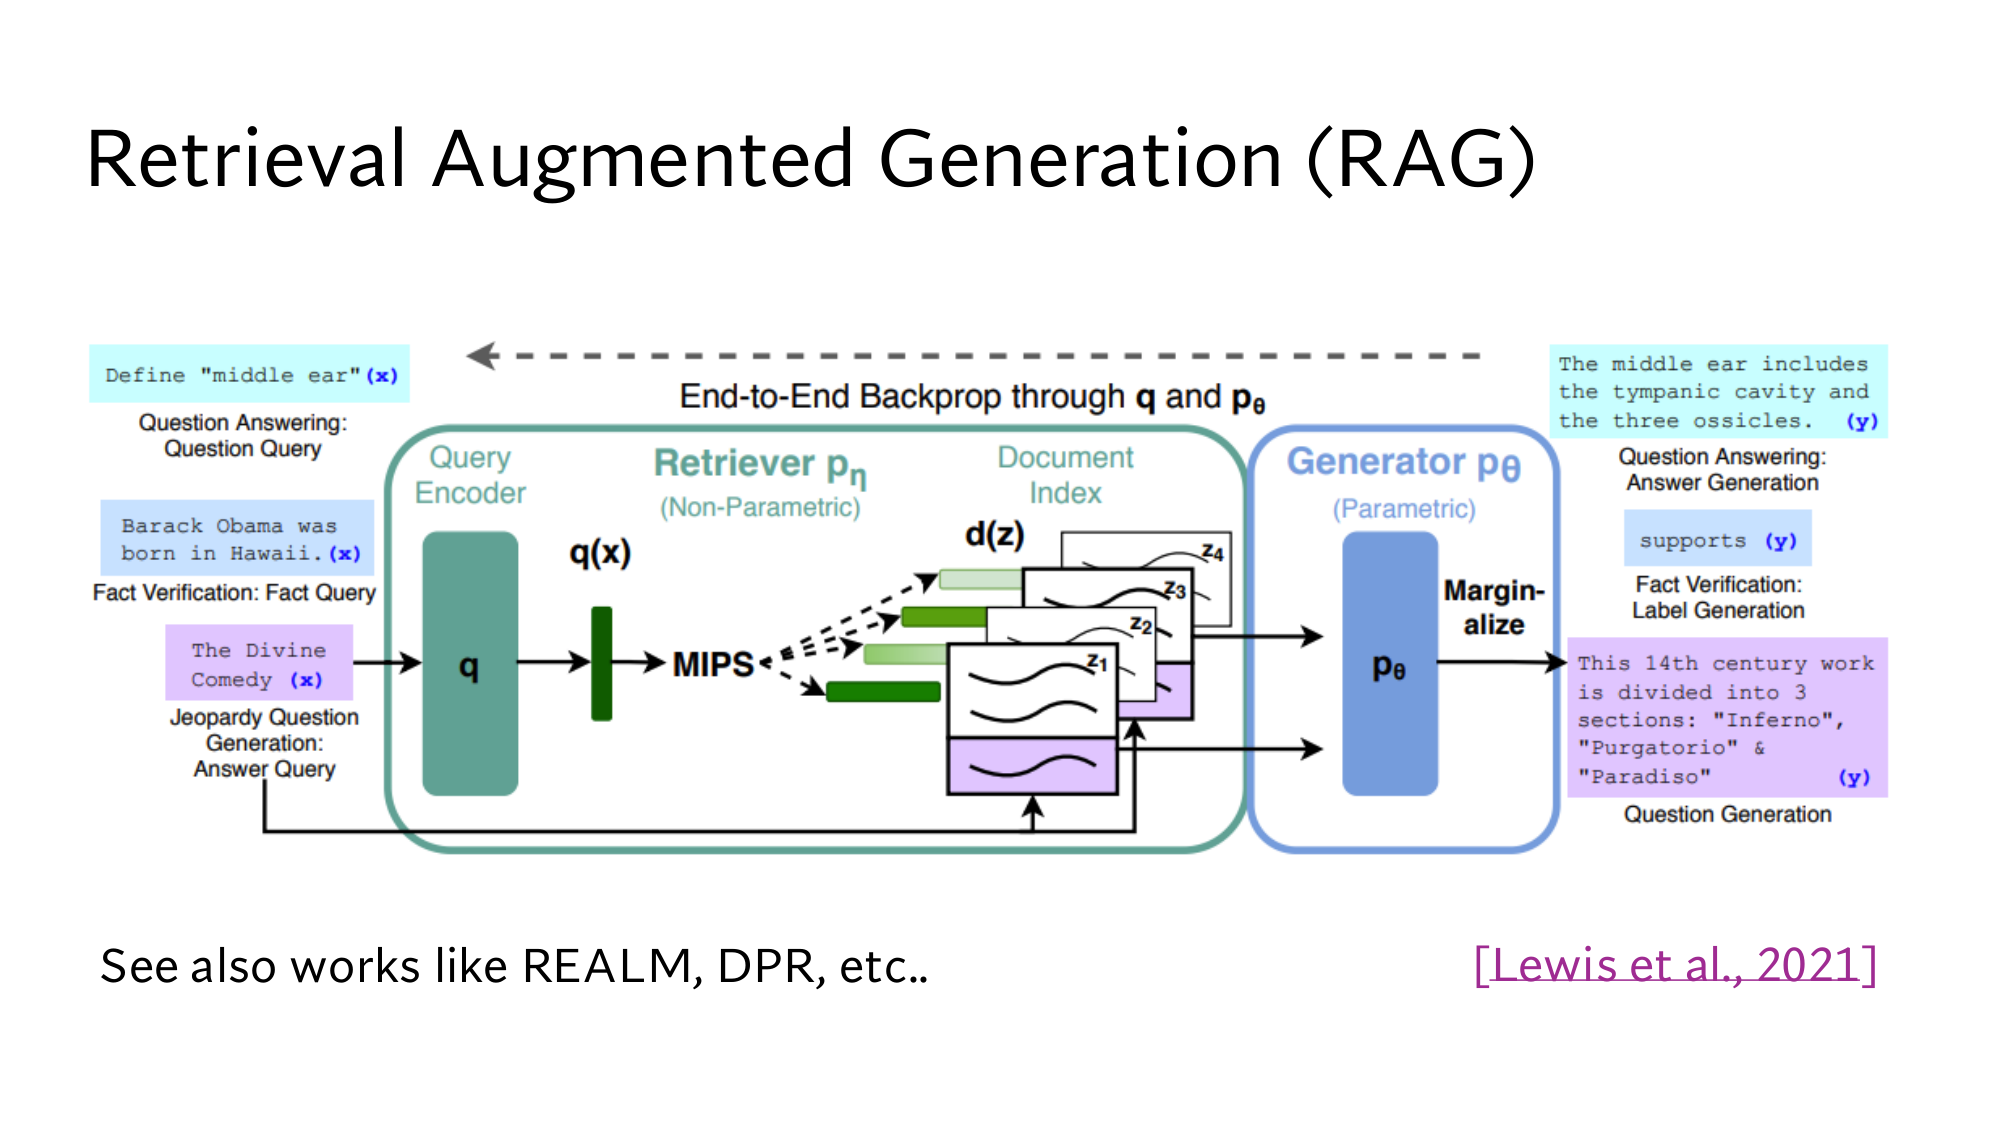
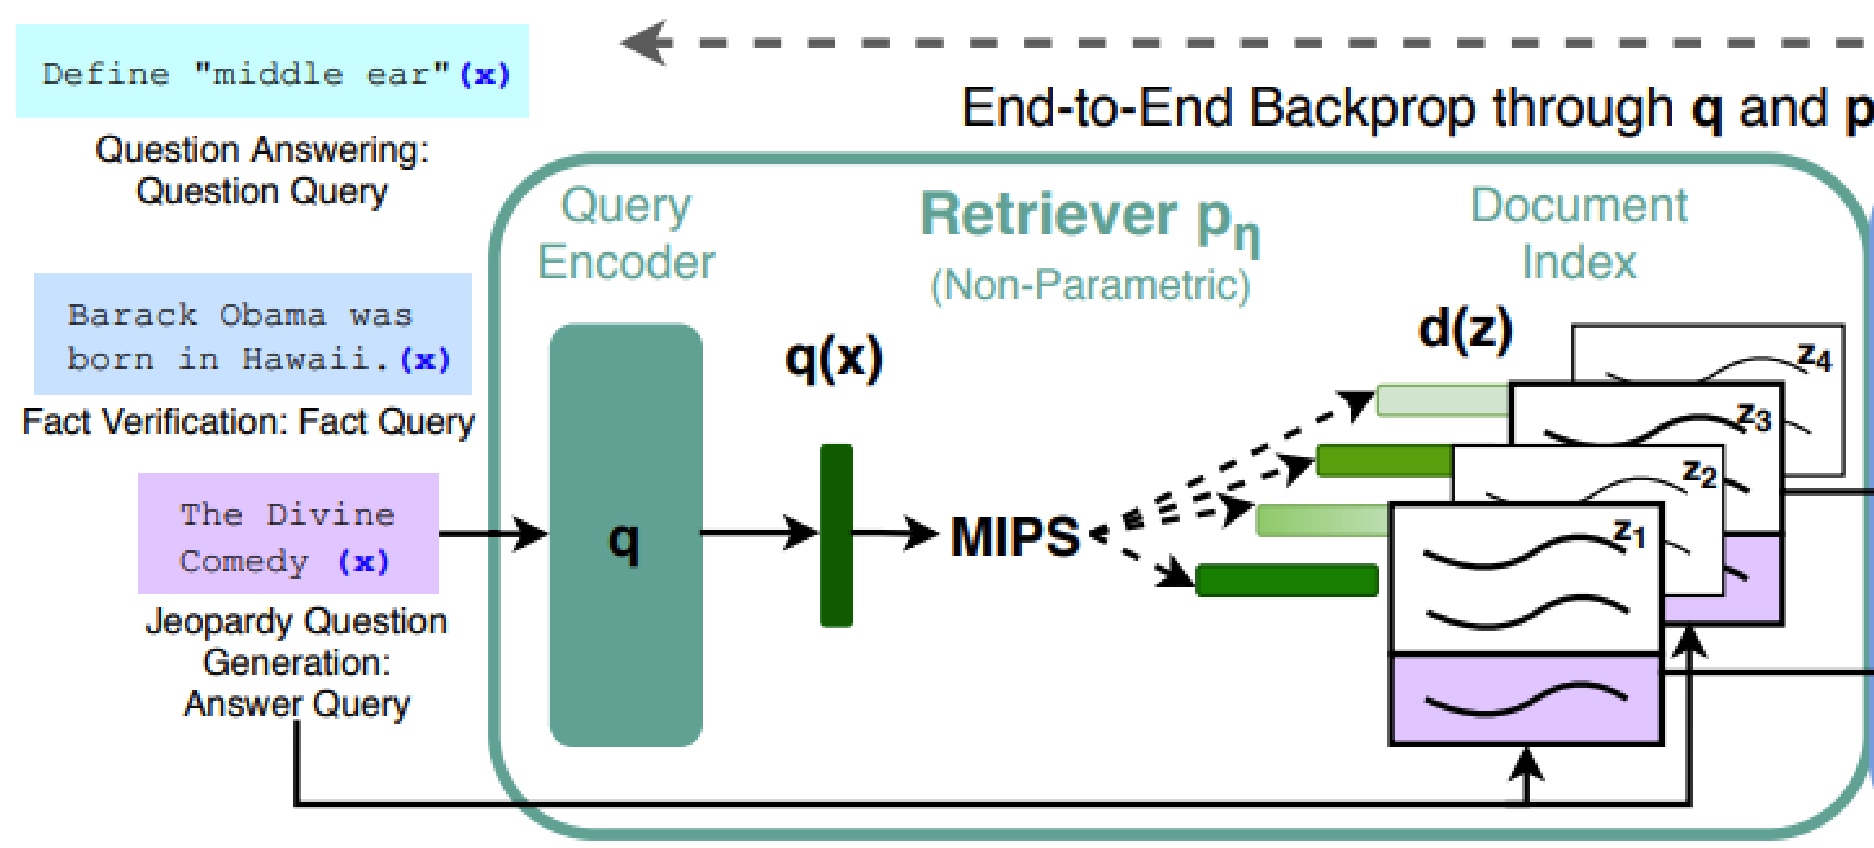
Stanford की slide: Retrieval Augmented Generation (RAG), और नीचे उसका generator वाला और retriever वाला हिस्सा, बड़े करके।
RAG वाली slide पढ़िए
Generator के नीचे (Parametric) और retriever के नीचे (Non-Parametric) क्यों लिखा है?
जवाब देखिए
Generator की जानकारी उसके parameters θ में है, यानी parametric knowledge। Retriever के पीछे Document Index है, जिसमें passages का text parameters के बाहर रहता है, और उसे training के बिना बदल सकते हैं। (पड़ाव 3, 6 और 8)
दाईं तरफ़ सबसे ऊपर वाला y, The middle ear includes the tympanic cavity and the three ossicles., किसने लिखा? उसी सवाल पर अकेले BART ने क्या लिखा था?
जवाब देखिए
ये documents वाले RAG का जवाब है। अकेले BART ने लिखा था कि middle ear, middle ear और नाक के बीच का हिस्सा है, जो गलत है। (पड़ाव 8)
Slide के बाकी हिस्से क्या करते हैं?
जवाब देखिए
बाईं तरफ़ तीन तरह के input x हैं: सवाल, जाँचने वाला fact, और Jeopardy का जवाब। Query Encoder q सवाल का vector q(x) बनाता है, और Document Index में हर passage का vector d(z) है (lesson 3)। MIPS, यानी maximum inner product search, सबसे बड़े dot product वाले passages z1 से z4 निकालता है (lesson 2 और lesson 5)।
Marginalize कई passages के साथ लिखे जवाबों को जोड़ता है (lesson 4)। ऊपर का dashed arrow training है, जो q और pθ, दोनों को एक साथ बदलती है (lesson 5)।
Stanford की slide: Deep Dive into RAG, और नीचे उसका formula, बड़ा करके।
Deep Dive वाली slide पढ़िए
Generator वाली line में p(y|x, z) को हमारे example से पढ़िए: x, z और y क्या हैं?
जवाब देखिए
x model को मिला text है, z queue log की line, और y Thursday। p(Thursday | x, z) = 0.81, जबकि बिना z के p(Thursday | x) = 0.21 था। (पड़ाव 6)
Writes the answer one token at a time: तीन tokens वाले जवाब Wednesday afternoon. की p(y|x) कैसे निकलेगी?
जवाब देखिए
हर token की probability, उससे पहले के text के साथ, और फिर सबका गुणा: 0.34 × 0.46 × 0.71 = 0.111। (पड़ाव 6)
Formula में ∑, p(z|x) और ≈ क्या कर रहे हैं?
जवाब देखिए
Retriever कई passages लाता है, और p(z|x) हर passage पर उसका भरोसा है। हर passage के साथ generator जवाब को अलग probability देता है, और ∑ इन्हें भरोसे के हिसाब से जोड़ता है, जैसा लाल note कहता है। जोड़ सिर्फ़ top-K, यानी सबसे ऊँचे K passages पर है, इसलिए = की जगह ≈ है।
ये जोड़ lesson 4 हाथ से करता है, और नीचे की दोनों lines, RAG-Sequence और RAG-Token, lesson 5 में आती हैं।
Stanford की slide: RAG Performance on Open-Domain QA, और नीचे उसकी दोनों tables, बड़ी करके।
RAG Performance वाली slide पढ़िए
Closed Book वाली दो rows किस जानकारी से जवाब देती हैं, और NQ पर RAG-Seq. से कितनी पीछे हैं?
जवाब देखिए
सिर्फ़ parameters से। T5-11B 44.5 − 34.5 = 10.0 points पीछे है, और SSM के साथ भी 44.5 − 36.6 = 7.9। REALM और DPR open-book systems हैं, जो passages में से जवाब उठाते हैं (lesson 5 और lesson 12)। (पड़ाव 7)
T5-11B+SSM का SSM क्या है, और TQA column में “- /50.1” का क्या मतलब है?
जवाब देखिए
SSM training का extra दौर है, जिसमें model नाम और तारीखों की खाली जगह भरता है। TQA के दो test sets हैं: बाईं तरफ़ आम open-domain वाला, और दाईं तरफ़ Wikipedia वाला। T5 ने सिर्फ़ Wikipedia वाले पर नापा, इसलिए बाईं जगह “-” है। (पड़ाव 7)
RAG paper के हिसाब से Wikipedia वाले सवाल आसान हैं, इसलिए RAG-Seq. भी वहाँ 56.8 की जगह 68.0 पर है। paper से
दाईं table में Factuality के 42.7% और 7.1% क्या कहते हैं? इस column का जोड़ कितना है?
जवाब देखिए
452 जोड़ों में लोगों ने 42.7% बार RAG के सवाल को ज़्यादा factual माना, और सिर्फ़ 7.1% बार अकेले BART के सवाल को। Column का जोड़ 7.1 + 42.7 + 11.7 + 17.7 + 20.8 = 100.0 है। (पड़ाव 8)
Specificity का मतलब है कि सवाल अपने जवाब से कितना खास जुड़ा है। उस column का जोड़ 93.0 निकलता है, 100 नहीं, और paper इसकी वजह नहीं बताता।
इस lesson की 3 बातें
LLM एक बार में एक token लिखता है। पूरे जवाब की probability हर token की probability का गुणा है, जैसे 0.34 × 0.46 × 0.71 = 0.111।
जानकारी दो जगह से आती है: parameters और prompt। सिर्फ़ parameters वाला T5-11B NQ पर 34.5 पर है, जबकि documents वाला RAG, 17.6 गुना कम parameters के साथ, 44.5 पर।
Probability बताती है कि क्या आम है, ये नहीं कि क्या सच है। लोगों ने RAG के सवाल 6 गुना ज़्यादा बार ज़्यादा factual पाए, और index बदलने से training के बिना नई जानकारी आई।
इस lesson के नए शब्द
LLM
Large language model: text पढ़कर आगे का text, एक बार में एक token, लिखने वाला model। जैसे Wednesday afternoon लिखने वाला model।
Token
Text का छोटा टुकड़ा: शब्द, शब्द का हिस्सा, या punctuation। Model इन्हीं को पढ़ता और लिखता है। जैसे crowded के दो tokens: crowd और ed।
Vocabulary
Model के सारे tokens की तय list, जिसमें हर token का एक ID number है। जैसे उसमें Wednesday है, लेकिन Wednesdayy नहीं।
Tokenizer
Text को vocabulary के tokens में तोड़ने वाला program। जैसे Wednesdayy को Wednesday और y में।
Probability
0 से 1 के बीच का number, जो किसी बात का chance बताता है। सारे options का जोड़ 1 होता है। जैसे 20 में से 5 lectures में quiz हुआ, तो 5 ÷ 20 = 0.25।
Next-token prediction
अब तक का text देखकर हर token को probability देना, एक चुनना, जोड़ना, और दोहराना। जैसे Wednesday, फिर afternoon, फिर full stop।
Parameters (weights)
Model के अंदर के numbers, जिनसे हर अगले token की probability निकलती है। जैसे T5-11B में करीब 11 billion parameters हैं।
Training
Parameters को थोड़ा-थोड़ा बदलना, ताकि text के असली अगले token की probability बढ़े। जैसे Office hours are on के बाद Thursday 0.10 से 0.12।
Parametric knowledge
Parameters में बँटी हुई जानकारी। Model इसका source नहीं बता सकता, और नई बात के लिए फिर से training चाहिए।
Knowledge cutoff
वो तारीख, जिस पर training रुकी। उसके बाद की बातें, और आपका private data, model में नहीं हैं। जैसे March 2026 की cutoff हो, तो Oct 2026 की announcement model में नहीं है।
Prompt
वो text, जो आप model को अभी देते हैं: सवाल, instructions, और साथ के documents। जैसे queue log की line, जिससे Thursday 0.21 से 0.81 हुआ।
Context window
Model एक बार में ज़्यादा से ज़्यादा कितने tokens पढ़ सकता है। Prompt और जवाब, दोनों इसमें आते हैं। जैसे 8,000 की window में 7,500 का prompt हो, तो जवाब के लिए 500 बचते हैं।
Hallucination
भरोसे वाला, लेकिन गलत या बिना source वाला जवाब। जैसे log देखे बिना लिखा Wednesday afternoon।
Greedy decoding और sampling
हर step पर सबसे ऊँची probability वाला token लेना greedy decoding है, और probability के हिसाब से random चुनना sampling। जैसे greedy हर बार Wednesday afternoon लिखता है, और sampling 100 में से करीब 21 बार Thursday से शुरू करता है।
Salient span masking (SSM)
Pretraining का extra दौर, जिसमें model Wikipedia के sentences में नाम और तारीखों की खाली जगह भरता है। जैसे इससे T5-11B का TriviaQA score 50.1 से 60.5 हुआ।
BART
Text पढ़कर text लिखने वाला model, जिसमें करीब 400 million parameters हैं। RAG का generator यही है। जैसे Jeopardy test में अकेला BART सिर्फ़ 7.1% जोड़ों में ज़्यादा factual निकला।
Index hot-swapping
Parameters छुए बिना documents का index बदलना, ताकि model की जानकारी बदले। जैसे 2018 के index से 2018 के leaders पर 68% सही जवाब, और 2016 के index से सिर्फ़ 4%।