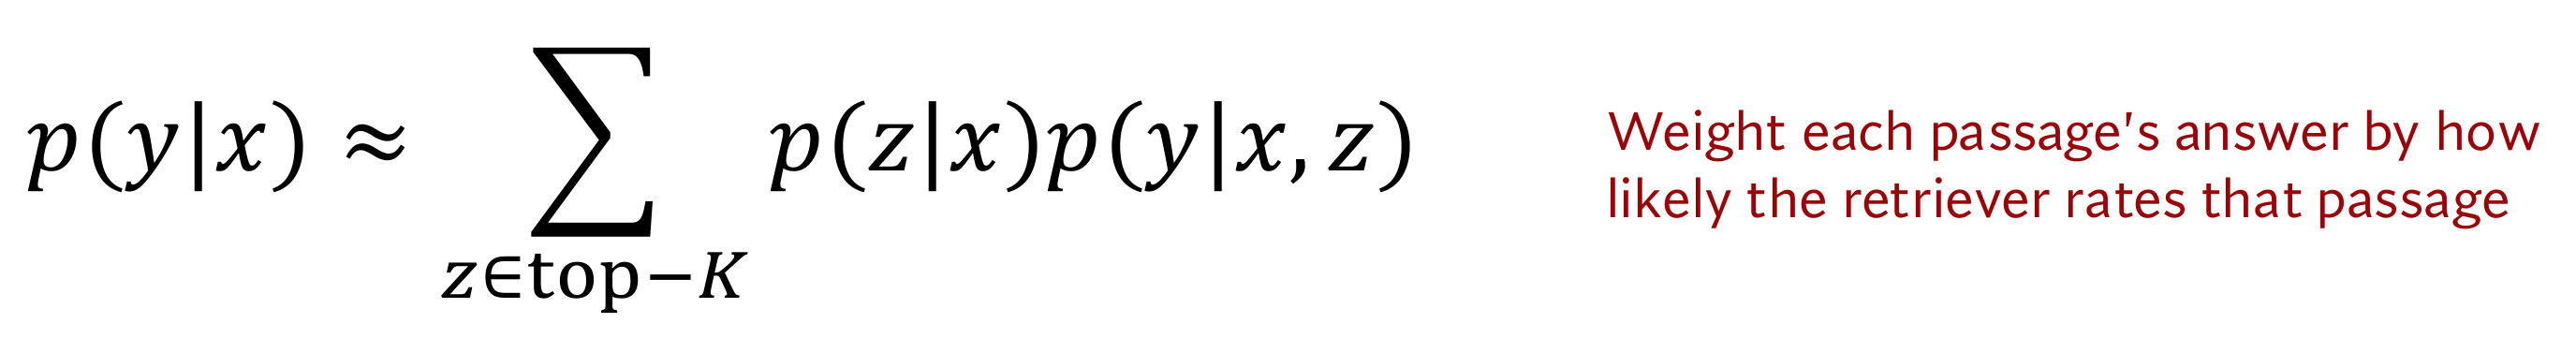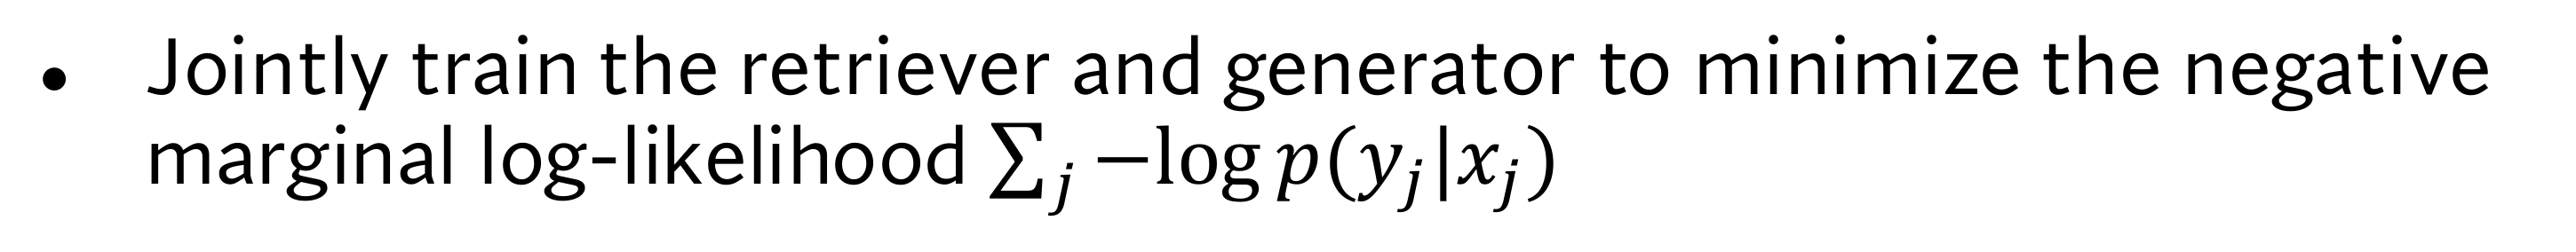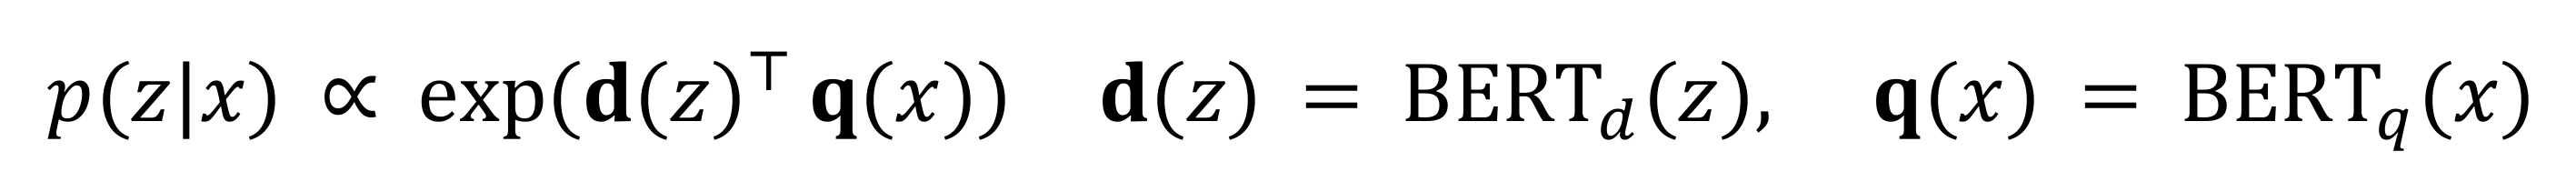Probability के औज़ार: RAG का formula पढ़ने की तैयारी
ये lesson पाँच औज़ार बनाता है: conditional probability, chain rule, marginalization, softmax और loss। Lesson 5 का RAG formula इन्हीं पाँच से बना है। वो formula दो तरह के numbers जोड़ता है। Lesson 1 में LLM ने queue log पढ़कर Thursday को 0.81 दी थी। Lesson 3 में retriever ने course के लंबे FAQ page को 1.56 दिया था।
ये दोनों numbers सीधे नहीं जुड़ते। 1.56 probability नहीं हो सकता, क्योंकि probability 1 से बड़ी नहीं होती। और 0.81 पूरे जवाब का नहीं, सिर्फ़ पहले token का chance है। Lesson 5 का formula इन्हें ऐसे जोड़ता है: p(y|x) ≈ ∑ p(z|x) · p(y|x, z), जहाँ p(z|x) ∝ exp(d(z)⊤q(x)), और training ∑ −log p(y|x) को छोटा करती है। पड़ाव 5 में आप ये पूरा formula हाथ से चलाएँगे।
इस lesson की सीढ़ी
सीढ़ी में 10 पड़ाव हैं। पहले 5 आसान version जैसे ही हैं, और 6 से 10 आपको Stanford की slides के level तक ले जाते हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
Conditional probability और chain rulep(भरा | Tuesday) जैसी probability गिनती से निकाल पाएँगे, और tokens की probabilities से पूरे जवाब की probability बना पाएँगे।
पहले से क्या चाहिए: Lesson 1 (probability, token, next-token prediction, training) और Lesson 3 (vector, dot product, ∑)। पड़ाव 6 से आगे कुछ शब्द lesson 5 के हैं, जैसे BERT, MIPS, η और θ। उन पर click करने से उनका मतलब खुलता है। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1Conditional probability और chain rule: पता बात से बदलता chance
“|” के बाद लिखी बात पहले से पता है
Conditional probability किसी बात का chance है, जब कोई दूसरी बात पहले से पता हो। इसे p(A | B) लिखते हैं, और “B पता हो, तो A की probability” पढ़ते हैं। RAG के formula में हर probability के अंदर यही खड़ी line “|” है, इसलिए पहले इसका मतलब numbers पर देखिए।
पिछले 20 हफ़्तों में 40 office hour sessions हुए, 20 Tuesday को और 20 Thursday को। जिस session में 10 से ज़्यादा students इंतज़ार में थे, उसे “भरा” मानिए। numbers मेरे बनाए हैं
भरा
खाली
कुल
Tuesday
16
4
20
Thursday
2
18
20
कुल
18
22
40
दिन पता न हो, तो सारे 40 sessions गिनिए। उनमें 18 भरे थे, इसलिए p(भरा) = 18 ÷ 40 = 0.45। अब पता है कि आज Tuesday है, तो सिर्फ़ Tuesday वाली row गिनिए। उसमें 20 में से 16 भरे थे, यानी p(भरा | Tuesday) = 16 ÷ 20 = 0.80। Thursday पता हो, तो p(भरा | Thursday) = 2 ÷ 20 = 0.10। दिन पता चलते ही chance 0.45 से 0.80 या 0.10 हो गया।
p(A | B) = A और B, दोनों वाले casesB वाले cases
Tuesday के लिए ऊपर 16 है, यानी भरे हुए Tuesdays, और नीचे 20, यानी सारे Tuesdays।
Lesson 1 का next-token prediction भी conditional probability है। वहाँ prompt पता था, और Thursday की probability 0.21 थी। Prompt में queue log जुड़ा, यानी पता बात बदली, तो वही probability 0.81 हो गई।
अब आप formula के दोनों टुकड़े पढ़ सकते हैं। p(z|x) यानी सवाल x पता हो, तो passage z की probability। p(y|x, z) यानी सवाल x और passage z, दोनों पता हों, तो जवाब y की probability। “|” के बाद का comma “और” पढ़िए।
पूरे जवाब की probability: chain rule
LLM एक बार में एक token लिखता है, और हर token की अपनी probability होती है। लेकिन formula में p(y|x, z) पूरे जवाब y की probability है, जैसे Thursday morning. की। तीन tokens की तीन probabilities से एक probability बनाने का नियम ऊपर की table में ही दिखता है।
Table में Tuesday और भरा, दोनों साथ 40 में से 16 बार हुए, यानी 0.40। यही number दो कदम में भी आता है। पहले Tuesday का chance लीजिए: p(Tuesday) = 20 ÷ 40 = 0.5। फिर Tuesday होते हुए भरे होने का chance लीजिए: p(भरा | Tuesday) = 0.8। दोनों का गुणा 0.5 × 0.8 = 0.40 है।
p(A और B) = p(A) × p(B | A)
दो बातें साथ होने की probability, पहली बात की probability गुणा पहली के बाद दूसरी की probability है। इस नियम को कहते हैं। Lesson 12 में इसी नाम का एक और नियम आता है, जो दरों के बारे में है, इसलिए इसे probability वाला chain rule कहिए।
जवाब के tokens पर यही नियम एक के बाद एक चलता है। पहला token Thursday है, जिसकी probability 0.21 है। Thursday लिख चुकने के बाद morning की probability 0.31 है, और फिर full stop की 0.71। पूरे जवाब की probability इन तीनों का गुणा है। Lesson 1 के widget वाले दोनों जवाबों पर ये ऐसा दिखता है:
जवाब
हर token की probability
पूरे जवाब की probability
Thursday morning.
0.21 × 0.31 × 0.71
0.046
Wednesday afternoon.
0.34 × 0.46 × 0.71
0.111
n tokens वाले जवाब पर यही गुणा से लिखते हैं। ∏ का मतलब है नीचे लिखी range पर सबका गुणा, जैसे ∑ का मतलब सबका जोड़ था। yi जवाब का i-वाँ token है, और उसकी probability में “|” के बाद सवाल x और उससे पहले के सारे tokens हैं:
p(y | x) = ∏i = 1 … n p(yi | x, y1 … yi−1)
हमारे जवाब में n = 3 है: y1 = Thursday, y2 = morning और y3 = full stop। y2 की probability में “|” के बाद सवाल और Thursday हैं। पूरा गुणा 0.21 × 0.31 × 0.71 = 0.046 है।
इस गुणा में एक दिक्कत है। हर probability 1 से छोटी है, इसलिए हर गुणा के साथ नतीजा और छोटा होता जाता है। 20 tokens हों, और हर एक की probability 0.5, तो पूरे जवाब की probability 0.520 = 0.00000095 बनती है। पड़ाव 4 का ln इसी दिक्कत को हल करता है।
पहले सोचिए
4 tokens वाले एक जवाब में tokens की probabilities 0.9, 0.8, 0.5 और 0.9 हैं। पूरे जवाब की probability कितनी है?
जवाब देखिए
0.9 × 0.8 = 0.72, फिर 0.72 × 0.5 = 0.36, और फिर 0.36 × 0.9 = 0.324। बाकी तीन tokens 0.8 या उससे ऊपर हैं, फिर भी 0.5 वाले एक token ने पूरे जवाब की probability आधी कर दी।
2Marginalization: पता न हो कि कौन सा case सच है
Marginalization कुल probability निकालने का तरीका है, जब पता न हो कि कौन सा case सच है। हर case की probability को उस case वाले chance से गुणा कीजिए, फिर सारे गुणा जोड़ दीजिए। Case की probability को उसका वज़न कहेंगे।
RAG में यही हालत है। Retriever कई passages लाता है, और system को पहले से पता नहीं कि कौन सा passage सही है। Queue log के साथ LLM Thursday 9am को ऊँची probability देगा, और पुराने forum post के साथ नीची। System को इनसे एक ही probability बनानी है।
पहले यही हालत office hours पर देखिए, जहाँ numbers छोटे हैं। एक student आधे हफ़्ते Tuesday जाता है और आधे Thursday, यानी p(Tuesday) = 0.5 और p(Thursday) = 0.5। हर दिन भरे होने का chance पड़ाव 1 से पता है: 0.8 और 0.1। बस ये पता नहीं कि आज वो किस दिन जाएगा।
Case z
वज़न p(z)
p(भरा | z)
गुणा
Tuesday
0.5
0.8
0.40
Thursday
0.5
0.1
?
जोड़ = p(भरा)
?
Thursday वाली row आप निकालिए
Thursday का गुणा कितना है, और कुल p(भरा) कितना? Student 90% बार Thursday जाए, तो कुल chance कितना होगा?
जवाब देखिए
Thursday: 0.5 × 0.1 = 0.05। जोड़ 0.40 + 0.05 = 0.45, यानी वही, जो पड़ाव 1 में 18 ÷ 40 से सीधे गिनकर आया था।
90% Thursday पर: 0.1 × 0.8 + 0.9 × 0.1 = 0.08 + 0.09 = 0.17। हर दिन का chance वही रहा, सिर्फ़ वज़न बदले, और कुल chance 0.45 से 0.17 हो गया।
इस तरीके को कहते हैं। ये तभी सही है, जब cases आपस में overlap न करें, और उनके वज़नों का जोड़ 1 हो। यहाँ दोनों बातें सच हैं, क्योंकि student एक दिन या तो Tuesday जाता है या Thursday, और 0.5 + 0.5 = 1।
p(A) = ∑z p(z) × p(A | z)
z एक case है, यहाँ Tuesday या Thursday। p(z) उसका वज़न है, 0.5 और 0.5, और p(A | z) उस case में भरे होने का chance, 0.8 और 0.1। सारे cases का जोड़ है, यहाँ 0.40 + 0.05, और नतीजा p(A) = 0.45 है।
Lesson 5 का RAG formula यही है। वहाँ case z एक passage है, और उसका वज़न retriever का भरोसा p(z|x) है। हर passage के साथ जवाब की probability p(y|x, z) है, यानी पड़ाव 1 वाला tokens का गुणा।
RAG के formula में “=” की जगह है, यानी “करीब बराबर”। RAG सारे passages नहीं जोड़ता, सिर्फ़ retriever के passages जोड़ता है, यानी सबसे ऊँचे K scores वाले passages। बाकी passages के वज़न बहुत छोटे होते हैं, इसलिए जोड़ करीब वही रहता है।
एक शर्त अभी बाकी है। हर वज़न 0 और 1 के बीच होना चाहिए, और सारे वज़नों का जोड़ 1। Retriever के scores ऐसे नहीं होते, इसलिए पड़ाव 3 उन्हें वज़न में बदलता है।
3Softmax: retriever के scores से वज़न
Softmax scores की list को probabilities की list में बदलता है। उसके दो steps हैं: हर score का exp लीजिए, फिर हर exp को सारे exps के जोड़ से भाग दीजिए। पहले देखिए कि ये दोनों steps क्यों चाहिए।
Lesson 3 में सवाल when can I get help from a TA का एक vector था। Retriever ने उस vector से हर passage का निकाला था, यानी एक ही जगह वाले numbers का गुणा, फिर जोड़। जैसे office hours page के लिए 0.8 × 0.9 + 0.2 × 0.1 = 0.74। बाकी scores थे: syllabus 0.26, project page 0.32 और course का लंबा FAQ page 1.56।
ये probabilities नहीं हैं, क्योंकि 1.56 तो 1 से बड़ा है, और चारों का जोड़ 2.88 है, 1 नहीं। हर score को चारों के जोड़ से भाग देना भी हमेशा नहीं चलता, क्योंकि dot product negative भी हो सकता है। तब negative हिस्सा बनता, और probability negative नहीं होती।
इसलिए softmax पहले हर score को positive number में बदलता है, और इसके लिए लेता है। exp(s) = es, जहाँ e एक तय number है, करीब 2.718। जैसे exp(1) = 2.718 और exp(2) = e × e = 7.389। exp(0) = 1 है, क्योंकि किसी भी number की power 0 पर नतीजा 1 होता है।
Negative score पर भी exp positive रहता है: exp(−1) = 1 ÷ e = 0.368। Score कुछ भी हो, exp हमेशा 0 से बड़ा होता है, और बड़ा score बहुत बड़ा exp बनता है। exp का एक नियम आगे काम आएगा: score में 1 जोड़ने पर exp, e गुना हो जाता है, क्योंकि ea+1 = ea × e। जाँच: exp(2) = exp(1) × e = 2.7183 × 2.7183 = 7.389।
अब softmax के दोनों steps scores 2.0, 1.0 और 0.1 पर देखिए: scores मेरे बनाए हैं
Score s
exp(s)
हिसाब
Probability
2.0
7.389
7.389 ÷ 11.212
0.659
1.0
2.718
2.718 ÷ 11.212
0.242
0.1
1.105
1.105 ÷ 11.212
0.099
जोड़
11.212
1.000
तीनों exps का जोड़ 11.212 है, और हर exp को इससे भाग देने पर 0.659, 0.242 और 0.099 मिलते हैं। तीनों 0 और 1 के बीच हैं, और उनका जोड़ 1 है, इसलिए ये वज़न बन सकते हैं। इस पूरे तरीके को कहते हैं:
pi = exp(si)∑j exp(sj)
ऊपर score si का exp है, जैसे पहली row में exp(2.0) = 7.389। नीचे सारे scores के exps का जोड़ है, 11.212। तो p1 = 7.389 ÷ 11.212 = 0.659।
पहले सोचिए
हर score में 1 जोड़ दीजिए, यानी 3.0, 2.0 और 1.1। Probabilities बढ़ेंगी, घटेंगी, या वैसी ही रहेंगी?
जवाब देखिए
वैसी ही रहेंगी: 0.659, 0.242 और 0.099। Score में 1 जोड़ने से हर exp, e गुना हो जाता है, जैसे exp(2.0) = 7.389 से exp(3.0) = 20.09। ऊपर और नीचे, दोनों e से गुणा होते हैं, और भाग में e कट जाता है। मतलब softmax सिर्फ़ scores के आपसी फ़र्क देखता है।
Lesson 5 का formula softmax को छोटे में ऐसे लिखता है:
p(z|x) ∝ exp(d(z)⊤q(x))
का मतलब है “के अनुपात में”। यानी पहले हर passage का exp निकालिए, फिर सबको एक ही number से ऐसे भाग दीजिए कि जोड़ 1 हो। वो number सारे exps का जोड़ है, इसलिए ∝ में softmax का भाग छिपा है।
passage और सवाल के vectors का dot product है। d(z) passage z का vector है, और q(x) सवाल x का। ऊपर का ⊤ सिर्फ़ लिखने का एक तरीका है, और हिसाब वही lesson 3 वाला है। जैसे office hours page [0.9, 0.1] और सवाल [0.8, 0.2] से 0.74।
अब lede वाला 1.56 भी वज़न बन सकता है। Lesson 3 के चारों scores पर softmax ये वज़न देता है: FAQ page 0.50, office hours page 0.22, project page 0.14 और syllabus 0.14। हिसाब मेरा Softmax क्रम नहीं बदलता, क्योंकि बड़ा score हमेशा बड़ा exp बनता है। इसलिए FAQ page अब भी सबसे ऊपर है, और lesson 3 वाली लंबे vector की दिक्कत softmax से ठीक नहीं होती।
Softmax खुद चलाइए
तीन passages के scores बदलिए। Probabilities का जोड़ हमेशा 1 रहता है, और negative score पर भी हर probability 0 से बड़ी रहती है।
Passage
Score
exp(score)
Probability
4ln और loss: गलती का एक number
Loss एक number है, जो बताता है कि model सही जवाब से कितना दूर है, और training इसी number को छोटा करती है। RAG में loss सही जवाब की probability से बनता है, और उसमें ln लगता है। ln पड़ाव 1 वाली छोटे numbers की दिक्कत भी हल करता है, इसलिए पहले ln देखिए।
, यानी ln x, वो power है, जिस तक e को उठाने पर x मिले। मतलब ln, exp का उल्टा है: ln(ex) = x। जैसे e1 = 2.718, इसलिए ln 2.718 = 1। और e0 = 1, इसलिए ln 1 = 0।
1 से छोटे number का ln negative होता है, क्योंकि उसके लिए e की power negative चाहिए। जैसे ln 0.1 = −2.303, क्योंकि e−2.303 = 1 ÷ e2.303 = 1 ÷ 10 = 0.1।
ln का सबसे काम का नियम ये है: ln(a × b) = ln a + ln b, यानी गुणा का ln, दोनों ln का जोड़ है। ये exp के नियम से आता है, क्योंकि गुणा में powers जुड़ती हैं: e2 × e3 = e5। Numbers में 7.389 × 20.09 = 148.4, और e5 भी 148.4 है। ln powers ही बताता है, इसलिए ln 148.4 = 5 = 2 + 3 = ln 7.389 + ln 20.09।
Thursday morning. पर ये नियम तीन probabilities का गुणा, तीन ln का जोड़ बना देता है:
जाँच: e−3.074 = 0.046, यानी वही पूरा गुणा। 20 tokens वाले जवाब पर 0.520 = 0.00000095 जैसे छोटे number की जगह 20 बार ln 0.5 जुड़ता है: 20 × (−0.693) = −13.86। हिसाब मेरा
अब गलती का number बनाइए: = −ln p, जहाँ p वो probability है, जो model ने सही जवाब को दी। सामने का minus loss को positive बनाता है, क्योंकि 1 से छोटी हर probability का ln negative है। नीचे की table में देखिए कि p घटने पर loss कैसे बढ़ता है:
सही जवाब की probability
Loss = −ln p
मतलब
1
0
पूरा पक्का और सही। Loss इससे कम नहीं हो सकता।
0.9
0.105
अच्छा
0.5
0.693
आधा भरोसा
0.1
2.303
ज़्यादातर गलत
0.01
4.605
बहुत गलत
p = 0.9 पर loss 0.105 है, लेकिन p = 0.1 पर 2.303, यानी 20 गुना से भी ज़्यादा।
Model ने सही जवाब को जो probability दी, उसे कहते हैं। Loss उसी का minus ln है, इसलिए इस loss का नाम है। Thursday morning. सही जवाब हो, तो उसका loss −(−3.074) = 3.074 है।
Lesson 1 में training ने parameters को थोड़ा बदला था। उससे Office hours are on के बाद Thursday की probability 0.10 से 0.12 हो गई थी। Loss −ln 0.10 = 2.303 से घटकर −ln 0.12 = 2.120 हुआ, यानी 2.303 − 2.120 = 0.183 कम।
Training data में बहुत सारे examples होते हैं। Example j में सवाल xj है और उसका सही जवाब yj, और कुल loss सारे examples के losses का जोड़ है:
कुल loss = ∑j − log p(yj | xj)
Stanford की slide और lesson 5 का formula log लिखते हैं, और उसका मतलब यही ln है।
Training हर parameter को किस दिशा में और कितना बदले, कि कुल loss घटे, ये बताता है। Thursday वाले example में training ने parameters को उस दिशा में बदला, जिसमें probability 0.10 से 0.12 हुई और loss 0.183 घटा। Gradient numbers से कैसे निकलता है, वो lesson 12 में आता है।
5पूरा RAG formula हाथ से
अब औज़ार एक साथ चलते हैं: softmax हर passage को वज़न देता है, marginalization जवाब की कुल probability देता है, और −ln उसका loss। Lede वाला सवाल फिर लीजिए: Which office hour is least crowded? Retriever दो passages लाता है: queue log और पुराना forum post। उनके dot product scores 1.0 और 0.0 हैं।
LLM सही जवाब Thursday 9am को queue log के साथ 0.9 probability देता है, और forum post के साथ 0.1। numbers मेरे बनाए हैं पूरा हिसाब तीन steps में है:
Softmax (पड़ाव 3): e1.0 = 2.718 और e0 = 1, जिनका जोड़ 3.718 है। Queue log का वज़न 2.718 ÷ 3.718 = 0.731 है, और forum post का 1 ÷ 3.718 = 0.269।
यानी system 0.685 पक्का है कि जवाब Thursday 9am है, और इस सवाल पर loss 0.378 है। Retriever queue log को और ऊँचा score दे, तो उसका वज़न 0.731 से बढ़ेगा, 0.685 भी बढ़ेगा, और loss घटेगा। Formula में यही तीन steps हैं:
Passage और सवाल के vectors का dot product, यहाँ 1.0 और 0.0।
p(z|x)
Softmax वाला वज़न, यहाँ 0.731 और 0.269।
p(y|x, z)
उस passage के साथ पूरे जवाब की probability, यहाँ 0.9 और 0.1।
∑ और ≈
K = 2 passages पर वज़न वाला जोड़, यहाँ 0.685।
−log p(y|x)
इस सवाल का loss, यहाँ 0.378।
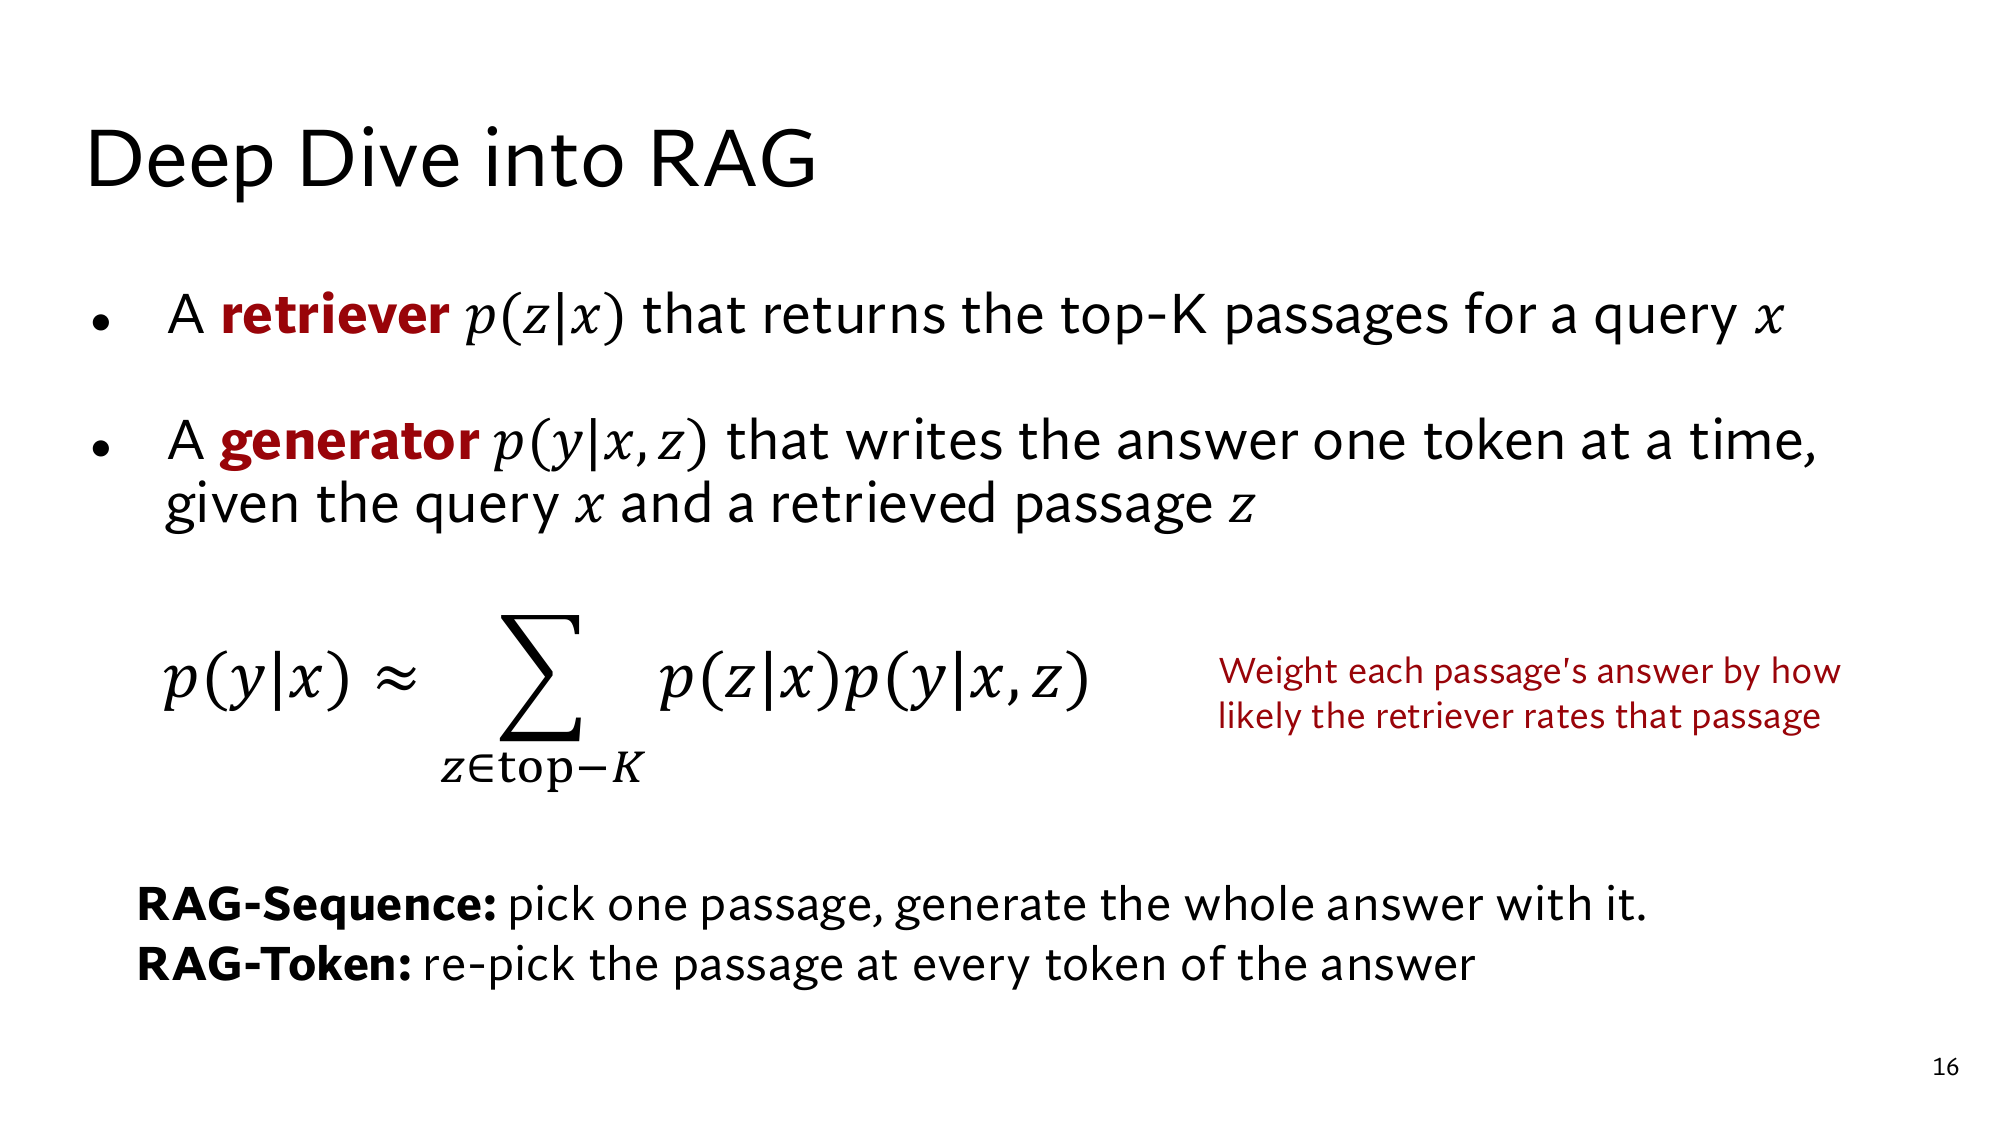
Stanford की slide: Deep Dive into RAG। ऊपर retriever p(z|x) है, और p(y|x, z), यानी जवाब लिखने वाला LLM। बीच में यही formula है। लाल line कहती है कि हर passage के जवाब को उतना वज़न दीजिए, जितना retriever उस passage को देता है। नीचे की RAG-Sequence और RAG-Token वाली lines lesson 5 में आती हैं। Image पर click करने से वो पूरे size में खुलती है।
पहले सोचिए
Retriever उल्टा भरोसा करे: queue log को score 0.0, और forum post को 1.0। LLM के numbers वही हैं, 0.9 और 0.1। अब Thursday 9am की कुल probability और loss कितने हैं?
जवाब देखिए
वज़न उलट गए: queue log को 0.269, और forum post को 0.731। कुल probability = 0.269 × 0.9 + 0.731 × 0.1 = 0.242 + 0.073 = 0.315, और loss = −ln 0.315 = 1.155।
LLM ने कुछ नहीं बदला, फिर भी probability 0.685 से 0.315 हो गई। गलत वज़न पूरे जवाब को नीचे खींचते हैं, और lesson 5 में training इसी गलती को ठीक करती है।
यहाँ से Stanford वाला level
ऊपर के 5 पड़ाव आसान version जैसे ही हैं। आगे के 5 पड़ाव आपको Stanford की slides के level तक ले जाते हैं। पहले slide के formula का हर symbol और probability के बाकी नियम आते हैं, फिर exp और ln के बाकी नियम। उसके बाद softmax पूरा, फिर training का loss और उसकी दरें numbers में, और आख़िर में आप slides खुद पढ़ते हैं। हर गणित वहीं समझाया है, जहाँ वो पहली बार आता है।
6Slide के formula का हर symbol, और probability के बाकी नियम
पड़ाव 5 तक formula एक सवाल और दो passages पर चला। Stanford की slide वही formula symbols में लिखती है, ताकि वो हर सवाल और हर passage पर लागू हो:
p(y|x) ≈ ∑z ∈ top−K p(z|x) p(y|x, z)
नीचे की table slide के हर symbol को हमारे example के number से जोड़ती है:
Symbol
मतलब
हमारे example में
x
सवाल, जिसे slide query कहती है
Which office hour is least crowded?
y
जवाब
Thursday 9am
z
एक passage
queue log या forum post
p(z|x)
Retriever: सवाल पता हो, तो passage z का वज़न
0.731 और 0.269
p(y|x, z)
Generator: सवाल और passage पता हों, तो जवाब की probability
0.9 और 0.1
p(z|x) p(y|x, z)
दोनों का गुणा। Maths में दो चीज़ें सटाकर लिखें, तो उसका मतलब गुणा है।
0.658 और 0.027
z ∈ top−K
∑ के नीचे की range: retriever के top-K passages में से हर z। ∈ का मतलब है “इसका हिस्सा है”।
K = 2: queue log और forum post
≈ और p(y|x)
जवाब की कुल probability, करीब बराबर, क्योंकि बाकी passages नहीं जुड़े
0.685
Generator का गुणा, paper के symbols में
Slide कहती है कि generator जवाब one token at a time लिखता है। ये पड़ाव 1 का chain rule है, और RAG paper इसे पूरा लिखता है: paper से
pθ(y | x, z) = ∏i = 1 … N pθ(yi | x, z, y1:i−1)
यहाँ N जवाब के tokens की गिनती है। y1:i−1 का मतलब है token 1 से token i−1 तक, यानी token i से पहले के सारे tokens। Thursday morning. में i = 2 के लिए y1:1 = Thursday है, और i = 1 के लिए पहले कोई token नहीं है। Paper generator को pθ और retriever को pη लिखता है, और lesson 5 में आते हैं।
Chain rule तीन या ज़्यादा बातों पर भी वैसे ही चलता है: p(A और B और C) = p(A) × p(B | A) × p(C | A और B)। हर नई बात की probability में “|” के बाद उससे पहले की सारी बातें आती हैं। Generator के गुणा में यही है, बस हर token की probability में सवाल x और passage z भी पहले से पता हैं।
p(A|B) और p(B|A) अलग हैं
“|” के दोनों तरफ़ की बातें आपस में बदल दें, तो probability बदल जाती है। पड़ाव 1 की table में p(भरा | Tuesday) = 16 ÷ 20 = 0.80 है। लेकिन p(Tuesday | भरा) में भरे हुए sessions गिनते हैं: 18 भरे sessions में से 16 Tuesday को थे, यानी 16 ÷ 18 = 0.89।
ऊपर का 16 दोनों में एक है, लेकिन नीचे अलग है। इसलिए formula पढ़ते वक्त देखिए कि “|” के बाद क्या लिखा है। p(y|x, z) passage पता होने पर जवाब की probability है, जवाब पता होने पर passage की नहीं।
≈ कितना करीब है
Marginalization की शर्त है कि सारे cases जुड़ें। RAG सिर्फ़ top-K passages जोड़ता है, और softmax भी सिर्फ़ उन्हीं K scores पर लगता है। इसका असर देखने के लिए corpus में एक तीसरा passage जोड़िए: Homework 1 की announcement, जिसका score −1.0 है। उसके साथ LLM Thursday 9am को 0.1 probability देता है। numbers मेरे बनाए हैं
तीनों passages के exps 2.718, 1 और 0.368 हैं, और उनका जोड़ 4.086। इसलिए softmax के वज़न 0.665, 0.245 और 0.090 हैं। तब पूरा जोड़ 0.665 × 0.9 + 0.245 × 0.1 + 0.090 × 0.1 = 0.599 + 0.024 + 0.009 = 0.632 है, जबकि top-2 पर, यानी पड़ाव 5 में, जोड़ 0.685 था।
Homework 1 की announcement
तीनों passages पर जोड़
Top-2 पर जोड़
Score −1.0वज़न 0.090
0.632
0.685
Score −3.0वज़न 0.013
0.677
0.685
Homework का score −3.0 हो, तो उसका वज़न सिर्फ़ 0.013 है, और दोनों जोड़ों का फ़र्क 0.053 से घटकर 0.008 रह जाता है। मतलब छोड़े गए passages का वज़न जितना छोटा, ≈ उतना करीब। Top-2 वाला जोड़ थोड़ा बड़ा है, क्योंकि छोड़े गए passage का वज़न softmax में बाकी दो पर बँट गया। उस passage के साथ जवाब की probability सिर्फ़ 0.1 थी।
Paper कहता है कि retriever top-K पर कटा हुआ distribution देता है, यानी सिर्फ़ K passages की probabilities की list, जिसका जोड़ 1 है। Training में K = 5 या 10 है। paper से Wikipedia के करीब 2.1 करोड़ passages में से सिर्फ़ 5 या 10 जुड़ते हैं। इसलिए ≈ तभी करीब है, जब बाकी सारे passages के वज़न बहुत छोटे हों।
7exp और ln के बाकी नियम
पड़ाव 3 और 4 में exp और ln के कुछ नियम आए थे। Slides और आगे के lessons में कुछ और नियम चाहिए, और ये सब इसी बात से निकलते हैं कि ln, exp का उल्टा है। नीचे हर नियम के साथ numbers में उसकी जाँच है:
नियम
जाँच
1. ea+b = ea × eb
e1.5 = e1 × e0.5 = 2.718 × 1.649 = 4.482
2. e−a = 1 ÷ ea
e−1 = 1 ÷ 2.718 = 0.368
3. ln(ex) = x, और eln x = x
ln 7.389 = 2, और eln 0.685 = e−0.378 = 0.685
4. ln(a × b) = ln a + ln b
ln(0.21 × 0.31) = (−1.561) + (−1.171) = −2.732
5. ln(a ÷ b) = ln a − ln b
ln(7.3891 ÷ 2.7183) = 2 − 1 = 1, और सच में 7.3891 ÷ 2.7183 = 2.7183, यानी e
6. ln(an) = n × ln a
ln(0.520) = 20 × (−0.693) = −13.86
नियम 5, नियम 4 से आता है। a ÷ b का मतलब a × (1 ÷ b) है। नियम 2 और 3 से ln(1 ÷ b) = −ln b, क्योंकि e−ln b = 1 ÷ eln b = 1 ÷ b। नियम 6, नियम 4 को n बार लगाना है, जैसे 20 tokens वाले जवाब में हुआ।
Softmax के हिस्से का ln
नियम 3 और 5 मिलकर softmax के हिस्से का ln आसान कर देते हैं। हिस्सा es ÷ Z है, जहाँ Z सारे exps का जोड़ है, इसलिए ln(es ÷ Z) = s − ln Z। पड़ाव 5 में queue log का score 1.0 था, और Z = 3.718। तो −ln 0.731 = −1.0 + ln 3.718 = −1.0 + 1.313 = 0.313। Lesson 12 का contrastive loss इसी रूप से शुरू होता है।
जोड़ का ln नहीं टूटता
ln(a + b) के लिए ऐसा कोई नियम नहीं है, और आम तौर पर ln(a + b), ln a + ln b के बराबर नहीं होता। पड़ाव 5 का जोड़ लीजिए: −ln(0.658 + 0.027) = −ln 0.685 = 0.378। हर हिस्से का अलग से −ln लेकर जोड़ें, तो 0.419 + 3.612 = 4.031 आता है, जो बिल्कुल अलग number है।
इसीलिए slide loss को negative marginal log-likelihood कहती है: पहले passages पर marginalization होता है, फिर पूरे जोड़ पर log लगता है। Loss को passage-passage अलग नहीं तोड़ सकते। इसका मतलब है कि एक ही loss में retriever के वज़न और generator की probabilities, दोनों बैठे हैं, और पड़ाव 9 यही दिखाता है।
log10 और ln, और −ln 0
Slide पर सिर्फ़ log लिखा है। Machine learning के papers में इसका मतलब लगभग हमेशा natural log, यानी ln होता है। School में log का मतलब अक्सर log10 था, जो बताता है कि 10 को किस power तक उठाएँ: log10 0.1 = −1, जबकि ln 0.1 = −2.303।
दोनों में फ़र्क एक तय गुणा का है: हर number का ln, उसके log10 का 2.303 गुना है, क्योंकि ln 10 = 2.303। जैसे पड़ाव 5 का loss log10 से 0.378 ÷ 2.303 = 0.164 होता। हर example का loss एक ही number से भाग होता, इसलिए कौन से parameters सबसे अच्छे हैं, ये नहीं बदलता।
दूसरी हद 0 पर है। ex कभी 0 नहीं होता, इसलिए ln 0 का कोई value नहीं है। p जितना 0 के पास जाता है, −ln p उतना बढ़ता है: −ln 0.001 = 6.908, और −ln 0.000001 = 13.816। Softmax से आई कोई probability ठीक 0 नहीं होती, क्योंकि exp हमेशा 0 से बड़ा है। इसलिए ऐसा loss बहुत बड़ा हो सकता है, लेकिन अनंत नहीं।
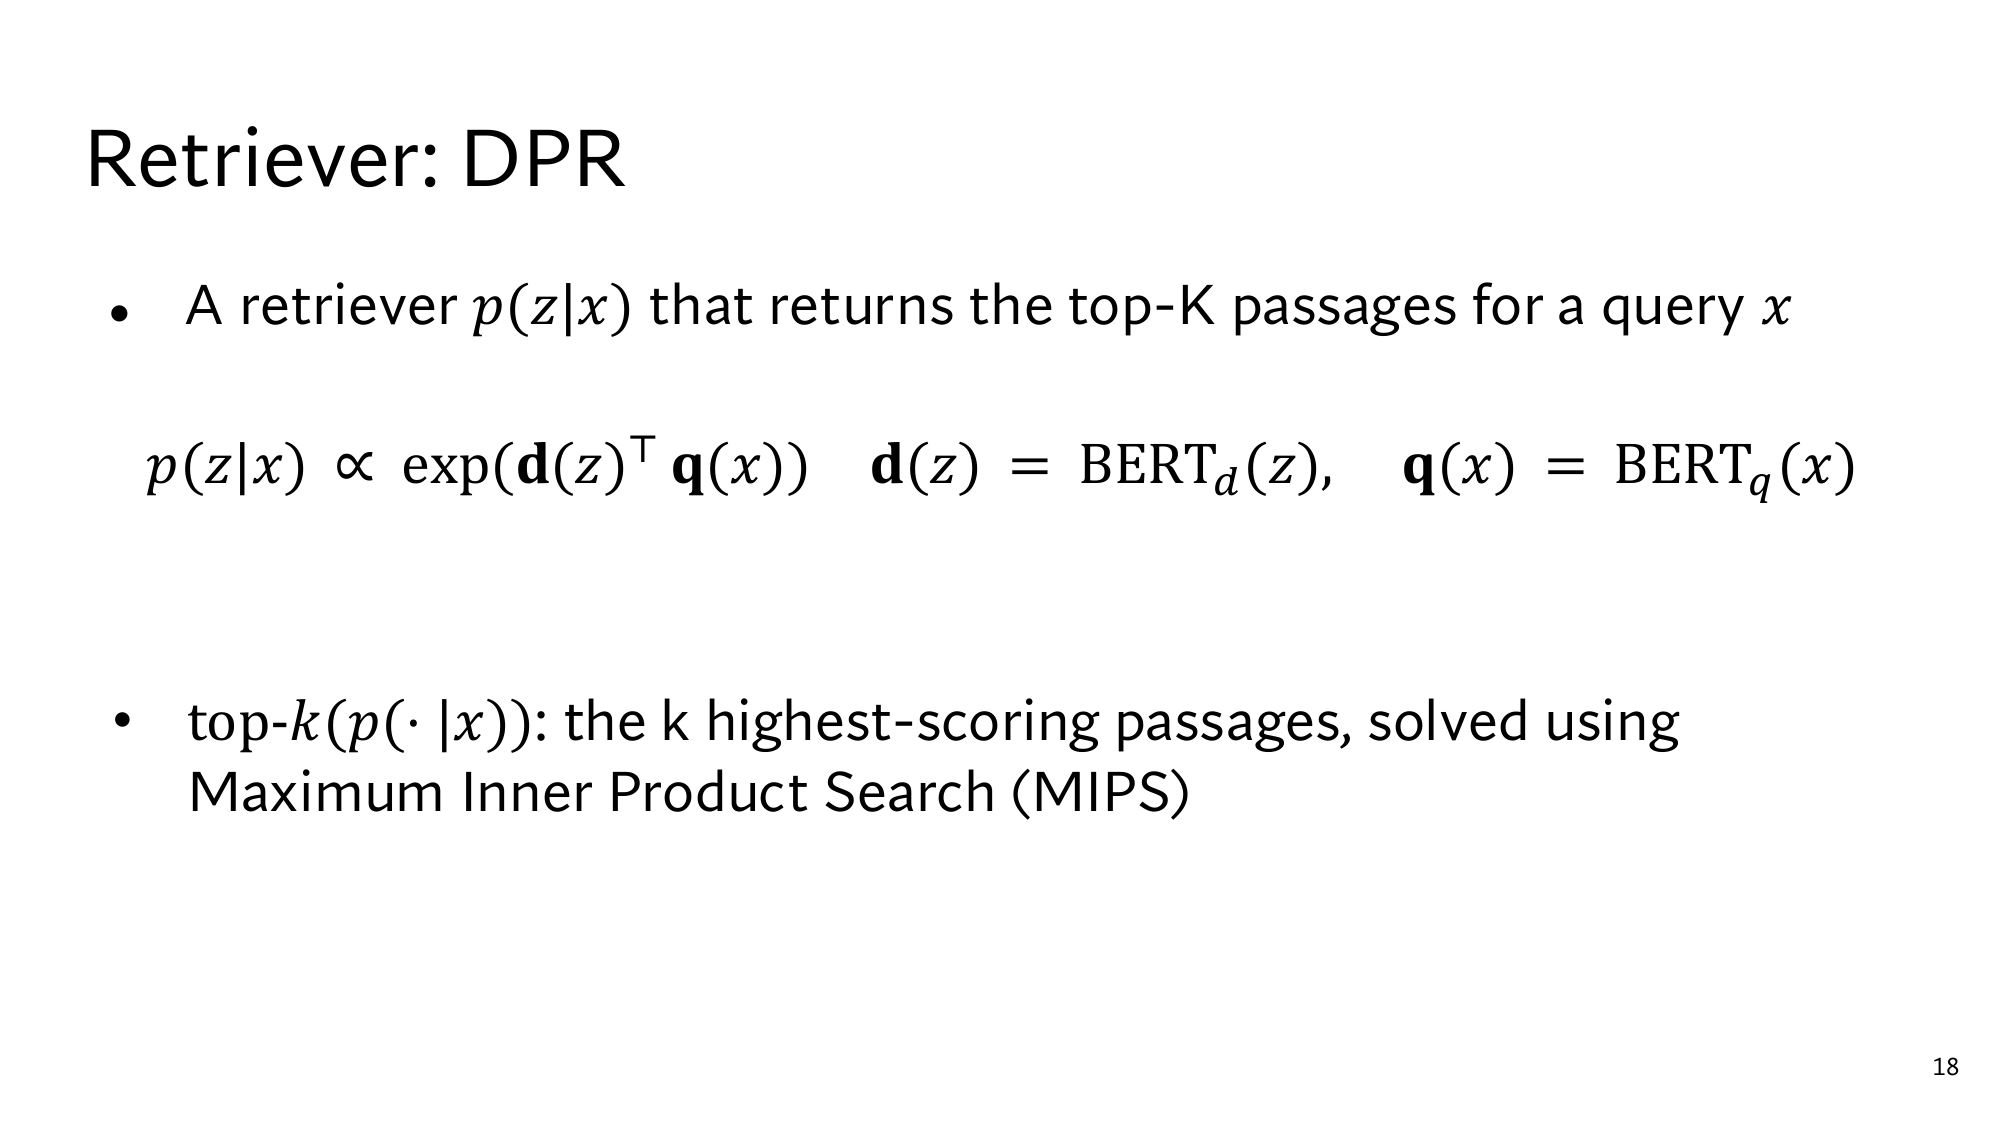
इस पड़ाव में इसका हर हिस्सा आता है। पहले softmax के बाकी गुण आते हैं, फिर ∝ के पीछे का भाग, फिर bold 𝐝 और 𝐪 और ⊤, और आख़िर में top-k।
Negative scores और scale
Dot product negative हो सकता है, और softmax उस पर भी चलता है। Scores 1, 0 और −1 का सीधा जोड़ 0 है, और 0 से भाग नहीं हो सकता। लेकिन उनके exps 2.718, 1 और 0.368 का जोड़ 4.086 है, और probabilities 0.665, 0.245 और 0.090 बनती हैं।
पड़ाव 3 में हर score में 1 जोड़ने से कुछ नहीं बदला। ये किसी भी number c के लिए सच है, क्योंकि नियम 1 से es+c = es × ec, और ec ऊपर और नीचे कट जाता है। Scores को गुणा करने से फ़र्क पड़ता है। 2.0, 1.0 और 0.1 को 2 से गुणा कीजिए, यानी 4.0, 2.0 और 0.2। तब probabilities 0.659, 0.242 और 0.099 से बदलकर 0.864, 0.117 और 0.019 हो जाती हैं। फ़र्क दोगुने हुए, इसलिए सबसे ऊँचे score का हिस्सा और बढ़ा।
Dot product में ये scale vector की लंबाई से आता है। Lesson 3 में FAQ page का vector [1.6, 1.4] था, जो [0.8, 0.7] का दोगुना है। इसलिए उसका score भी दोगुना था: 1.56 = 2 × 0.78।
∝ के पीछे का भाग: normalizer Z
a ∝ b का मतलब है a = c × b, जहाँ c हर passage के लिए एक ही number है। Softmax में c = 1 ÷ Z है, और Z सारे exps का जोड़ है। इस Z को normalizer कहते हैं, क्योंकि यही probabilities का जोड़ 1 करता है।
पड़ाव 5 में Z = 2.718 + 1 = 3.718 था, तो c = 1 ÷ 3.718 = 0.269। Queue log का वज़न 2.718 × 0.269 = 0.731 है, और forum post का 1 × 0.269 = 0.269। Z सवाल पर टिका है, किसी एक passage पर नहीं। इसलिए passages का आपसी अनुपात उसके बिना भी दिखता है, और formula उसे ∝ में छिपा देता है। RAG में ये जोड़ सिर्फ़ top-K passages पर है, जैसा पड़ाव 6 में आया।
Bold 𝐝 और 𝐪, column vector और ⊤
Slide पर 𝐝 और 𝐪 bold हैं। Maths में bold अक्षर का मतलब है कि वो एक number नहीं, vector है। 𝐝(z) passage z का vector है, और 𝐪(x) सवाल x का।
Maths में vector को अक्सर खड़ा लिखते हैं, यानी numbers ऊपर-नीचे, और इसे column vector कहते हैं। ⊤ का मतलब transpose है: खड़े vector को लिटा देना, यानी column को row बनाना। Office hours page और सवाल के vectors पर ये ऐसा दिखता है:
Row गुणा column का नियम ये है: row का पहला number column के पहले number से गुणा कीजिए, दूसरा दूसरे से, फिर सब जोड़िए। यही dot product है, इसलिए 𝐝⊤𝐪 dot product लिखने का तरीका है। कई passages की rows एक के नीचे एक रखें, तो एक ही गुणा से सबके scores निकलते हैं। ये matrix गुणा lesson 12 में आता है।
BERTd और BERTq दो अलग हैं। छोटा d बताता है कि पहला encoder passage पढ़ता है, क्योंकि paper passage को document कहता है। छोटा q बताता है कि दूसरा query, यानी सवाल पढ़ता है। दोनों -base से बने हैं। paper से
top-k(p(·|x)) के लिए MIPS क्यों काफ़ी है
Slide की दूसरी line top-k(p(·|x)) है। “·” खाली जगह का निशान है, और वहाँ हर passage बारी-बारी से आता है। इसलिए p(·|x) सवाल x के लिए सारे passages के वज़नों की पूरी list है, और top-k उसमें सबसे बड़े k वज़न वाले passages हैं।
ये k passages ढूँढने के लिए softmax चलाने की ज़रूरत नहीं, क्योंकि exp एक increasing function है: बड़ा input हमेशा बड़ा output देता है। Z से भाग भी हर passage पर एक जैसा है, इसलिए वज़नों का क्रम वही है, जो scores का। Lesson 3 के scores 1.56, 0.74, 0.32 और 0.26 से वज़न 0.499, 0.220, 0.145 और 0.136 बनते हैं, यानी ठीक उसी क्रम में।
तो सबसे बड़े k वज़न वाले passages वही हैं, जिनके dot products सबसे बड़े हैं। Dot product का दूसरा नाम inner product है, इसलिए इस search को Maximum Inner Product Search, यानी कहते हैं। Paper के हिसाब से MIPS हर passage को देखे बिना लगभग सही top-k ढूँढ लेता है। यानी passages दोगुने हों, तो search का समय दोगुने से कम बढ़ता है। paper से ये कैसे होता है, वो lesson 10 में है।
9Negative marginal log-likelihood, और loss की दरें numbers में
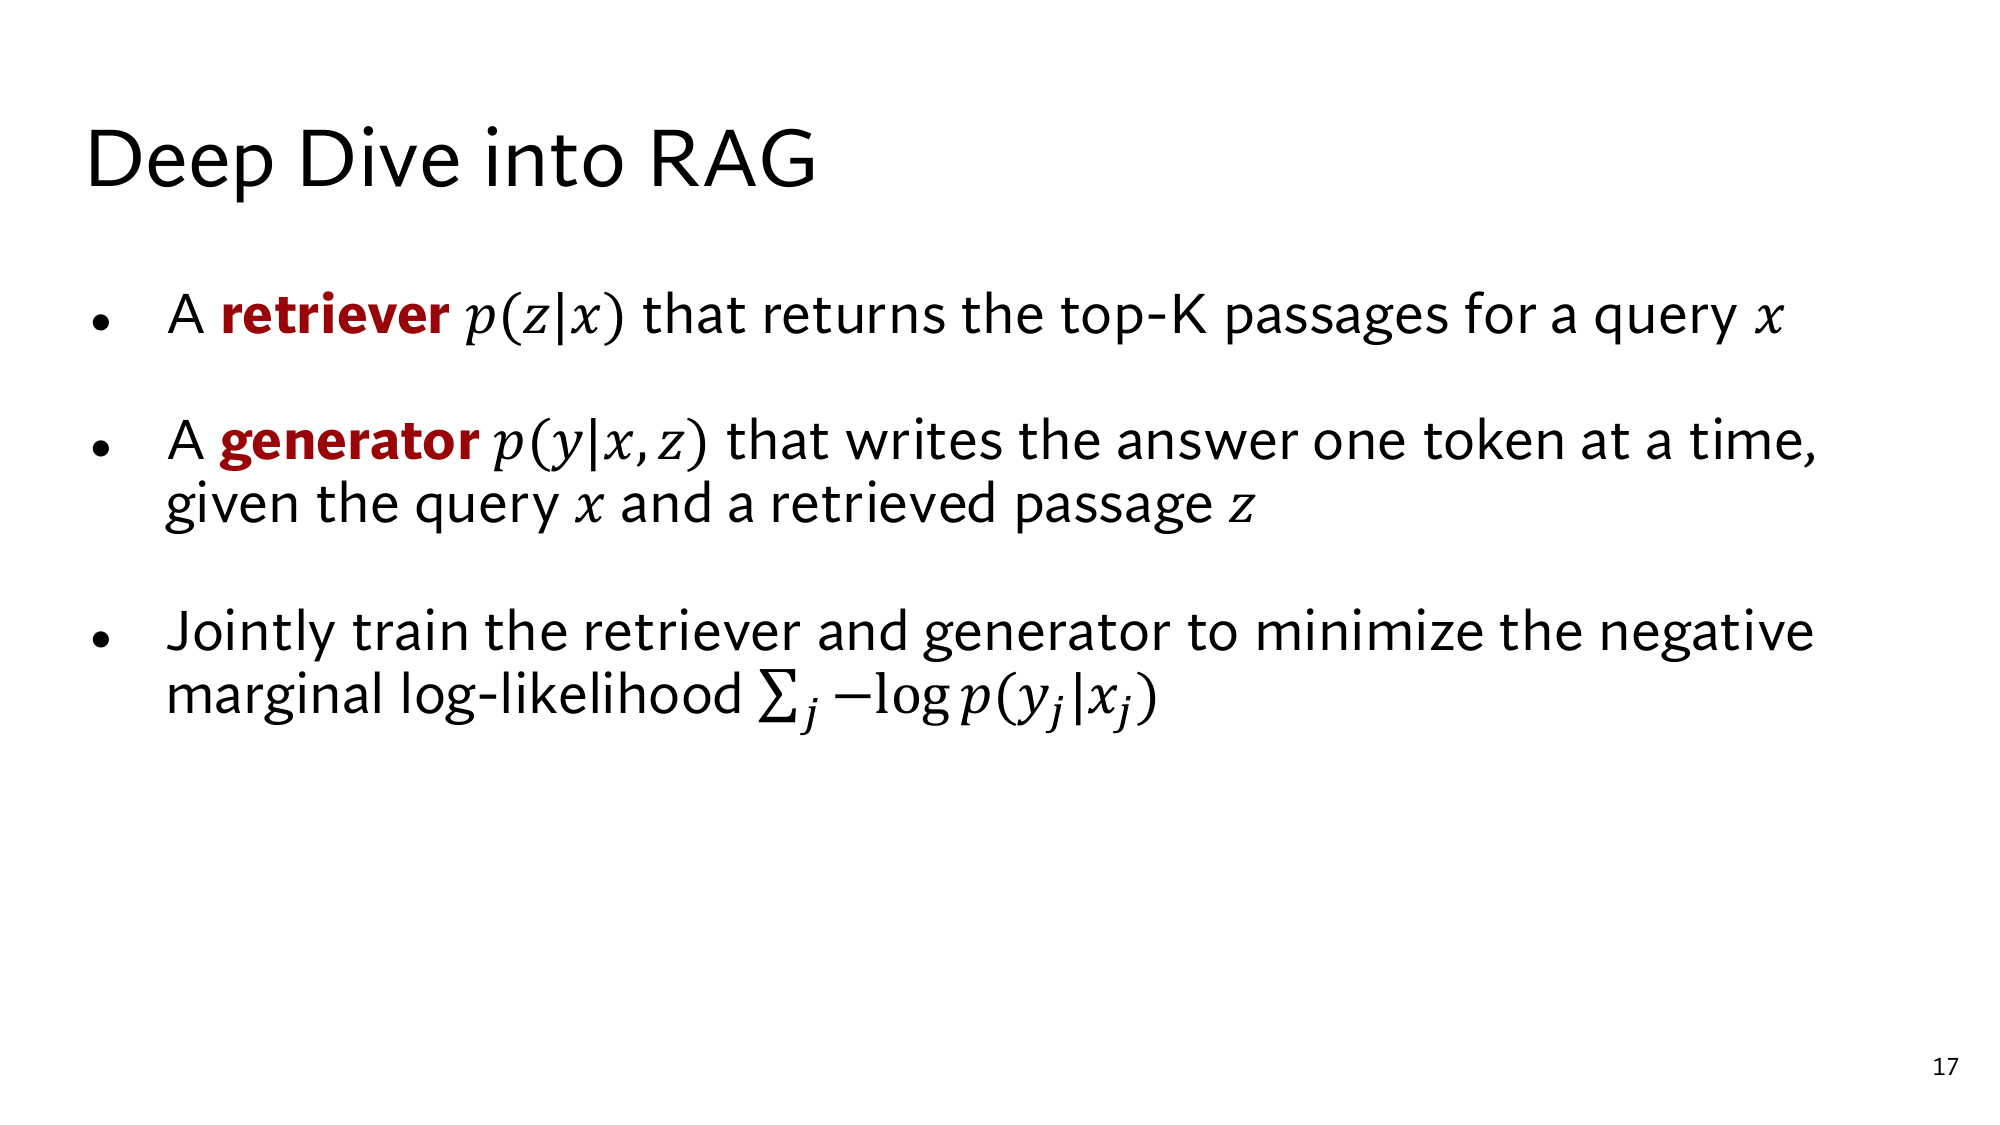
Stanford की दूसरी slide कहती है: Jointly train the retriever and generator to minimize the negative marginal log-likelihood ∑j −log p(yj|xj)। इस पड़ाव में पहले ये नाम शब्द-शब्द पढ़िए। फिर देखिए कि एक ही loss दोनों models को कैसे बताता है कि उन्हें किस तरफ़ बदलना है।
नाम के चार शब्द
शब्द
मतलब
पड़ाव 5 में
likelihood
सही जवाब की probability, p(y|x)
0.685
marginal
ये probability passages पर marginalization से बनी है
0.658 + 0.027
log-likelihood
उसका ln
ln 0.685 = −0.378
negative
सामने minus, ताकि loss positive हो
0.378
इसलिए हर example का loss एक जोड़ का −ln है, और पड़ाव 7 में आया कि ये जोड़ passage-passage नहीं टूटता।
कई examples का loss
∑j सारे training examples पर जोड़ है। मान लीजिए दूसरा example सवाल Where are office hours held? है, और system उसके सही जवाब को 0.5 probability देता है। number मेरा बनाया तब दोनों examples का कुल loss 0.378 + 0.693 = 1.071 है।
यही number एक और तरीके से भी आता है। दोनों सवाल एक-दूसरे पर टिके नहीं हैं, इसलिए chain rule में दूसरे जवाब की probability पहले से नहीं बदलती। तब दोनों जवाब सही होने की probability 0.685 × 0.5 = 0.3425 है, और −ln 0.3425 = 1.071, क्योंकि ln का नियम गुणा को जोड़ बनाता है। मतलब कुल loss छोटा करना, पूरे training data के सही होने की probability बढ़ाना है।
Training p को बड़ा करने की जगह −ln p को छोटा करती है। फिर भी सबसे अच्छे parameters वही रहते हैं, क्योंकि ln भी increasing function है। p जितना बड़ा, −ln p उतना छोटा, इसलिए दोनों का सबसे अच्छा point एक है। −ln का फ़ायदा ये है कि गुणा जोड़ बन जाता है, और बहुत छोटे numbers नहीं बनते।
दर: loss कितना बदलता है
Gradient का मतलब पड़ाव 4 में आया था: हर parameter को किस दिशा में बदलें, कि loss घटे। ये दिशा एक दर से निकलती है। Input को थोड़ा बदलिए, जैसे 0.01, देखिए कि loss कितना बदला, और उस बदलाव को 0.01 से भाग दीजिए। पहले ये सीधे loss = −ln p पर देखिए:
p
p को 0.01 बढ़ाने पर loss का बदलाव
बदलाव ÷ 0.01
0.10
−0.0953
−9.53
0.50
−0.0198
−1.98
0.90
−0.0110
−1.10
बदलाव 0.01 से और छोटा लें, तो ये दरें −10, −2 और −1.11 पर टिकती हैं, यानी −1 ÷ p। जिस जवाब की probability छोटी है, उस पर loss की दर सबसे बड़ी है, इसलिए training का सबसे ज़्यादा ज़ोर उसी पर पड़ता है। Lesson 1 में p, 0.10 से 0.12 हुआ, और loss 0.183 घटा। उस पूरे कदम की दर −0.183 ÷ 0.02 = −9.15 है। ये 0.10 के पास की दर −10 और 0.12 के पास की दर −8.33 के बीच है।
Jointly train: एक loss, दोनों models की दरें
पड़ाव 5 के loss 0.378 में चार numbers हैं: retriever के दो scores, 1.0 और 0.0, और generator की दो probabilities, 0.9 और 0.1। हर एक को बारी-बारी से 0.01 बढ़ाइए, और बाकी तीन वैसे ही रखिए: हिसाब मेरा
क्या 0.01 बढ़ा
Loss का बदलाव
बदलाव ÷ 0.01
Retriever: queue log का score
−0.00229
−0.229
Retriever: forum post का score
+0.00230
+0.230
Generator: queue log के साथ 0.9
−0.01062
−1.062
Generator: forum post के साथ 0.1
−0.00392
−0.392
Retriever की दोनों दरें बताती हैं कि queue log का score बढ़ने पर loss घटता है, और forum post का score बढ़ने पर बढ़ता है। दोनों का जोड़ −0.229 + 0.230 = 0.001, यानी करीब 0 है, क्योंकि दोनों scores बराबर बढ़ें, तो softmax के वज़न नहीं बदलते।
Generator की दोनों दरें negative हैं, यानी किसी भी passage के साथ सही जवाब की probability बढ़े, तो loss घटता है। Queue log वाली दर बड़ी है: 1.062 ÷ 0.392 = 2.71, जो करीब 0.731 ÷ 0.269 = 2.72 है। मतलब generator की हर probability उतना असर डालती है, जितना उसके passage का वज़न है।
एक ही loss से दोनों models को अपनी दिशा मिलती है, और slide के “jointly train” का यही मतलब है। असली models में ये चार numbers खुद करोड़ों parameters से बनते हैं। हर parameter पर loss की ऐसी ही एक दर है, और इन सारी दरों की list gradient है। Training हर parameter को उसकी दर की उल्टी दिशा में थोड़ा खिसकाती है।
ये दरें symbols ∂ और ∇ के साथ lesson 12 में आती हैं। किस passage का score बढ़ता है और किसका घटता है, इसका नियम lesson 5 में है। Paper training के बारे में तीन बातें और कहता है: paper से
Training data में सिर्फ़ सवाल और जवाब के जोड़े (xj, yj) हैं। कौन सा passage सही है, ये data में कहीं नहीं लिखा।
Paper parameters को gradient से छोटे-छोटे कदमों में बदलता है, और इसके लिए Adam नाम का तरीका लेता है।
Passage encoder BERTd और index नहीं बदलते। Training सिर्फ़ BERTq और generator BART के parameters बदलती है, क्योंकि passage encoder बदलने पर index दोबारा बनाना पड़ता।
10अब Stanford की slides खुद पढ़िए
नीचे Stanford की तीन slides हैं, बिना किसी बदलाव के, और हर slide के नीचे उसका formula बड़ा करके। हर slide के नीचे कुछ सवाल हैं। पहले खुद जवाब सोचिए, फिर खोलिए। कोई symbol अटके, तो जवाब में लिखे पड़ाव पर लौट जाइए। Phone पर slide छोटी दिखे, तो image पर click कीजिए, वो पूरे size में खुलेगी।
Stanford की slide: Deep Dive into RAG, और नीचे उसका formula, बड़ा करके।
RAG formula वाली slide पढ़िए
∑ के नीचे z∈top−K लिखा है, और बराबर की जगह ≈ है। दोनों का मतलब क्या है, और हमारे example में ≈ कितना दूर था?
जवाब देखिए
∑ सिर्फ़ retriever के top-K passages पर चलता है, और ∈ का मतलब है “इसका हिस्सा है”। बाकी passages नहीं जुड़ते, इसलिए ≈ है। Top-2 पर जोड़ 0.685 था, और Homework 1 की announcement भी जोड़ें, तो 0.632, यानी 0.053 का फ़र्क। (पड़ाव 2 और 6)
Generator जवाब one token at a time लिखता है। तब p(y|x, z) एक number कैसे बनता है?
जवाब देखिए
Chain rule से। हर token की probability लीजिए, जब सवाल, passage और पिछले tokens पता हों, और फिर सबका गुणा कीजिए। Paper इसे ∏ pθ(yi | x, z, y1:i−1) लिखता है, जैसे 0.21 × 0.31 × 0.71 = 0.046। (पड़ाव 1 और 6)
Slide के नीचे RAG-Sequence और RAG-Token लिखे हैं। ऊपर वाला formula इन दोनों में से किसका है?
जवाब देखिए
RAG-Sequence का। उसमें एक passage से पूरा जवाब बनता है, यानी p(y|x, z) पूरे जवाब के tokens का गुणा है। फिर passages पर वज़न वाला जोड़ लगता है। paper से RAG-Token हर token पर अलग passage ले सकता है, और उसका formula lesson 5 में है।
Stanford की slide: वही दो lines, और तीसरी line में training का loss। नीचे वो line बड़ी करके।
Training वाली slide पढ़िए
“Negative marginal log-likelihood” का हर शब्द ∑j −log p(yj|xj) के किस हिस्से में है?
जवाब देखिए
Likelihood p(yj|xj) है, यानी सही जवाब की probability। Marginal का मतलब है कि ये probability passages पर जोड़ से बनी है। Log उसका ln है, negative सामने का minus, और ∑j सारे examples का जोड़। दो examples पर ये 0.378 + 0.693 = 1.071 था। (पड़ाव 4 और 9)
इस loss को हर passage के अलग loss में क्यों नहीं तोड़ सकते?
जवाब देखिए
क्योंकि log पूरे जोड़ पर लगता है, और ln(a + b) टूटता नहीं। −ln(0.658 + 0.027) = 0.378 है, जबकि अलग-अलग −ln का जोड़ 4.031। (पड़ाव 7)
“Jointly train” हमारे numbers में कैसा दिखता है?
जवाब देखिए
एक ही loss की दर retriever के score पर भी है, और generator की probability पर भी। Queue log का score 0.01 बढ़े, तो loss 0.00229 घटता है, और generator का 0.9, 0.91 हो, तो 0.01062। Paper में passage encoder और index नहीं बदलते, लेकिन query encoder और generator बदलते हैं। (पड़ाव 9)
Stanford की slide: Retriever: DPR, और नीचे उसका formula और top-k वाली line, बड़ी करके।
Retriever वाली slide पढ़िए
∝ के पीछे कौन सा भाग छिपा है? पड़ाव 5 के example में वो number कितना था?
जवाब देखिए
सारे exps के जोड़ Z से भाग, और इस Z को normalizer कहते हैं। पड़ाव 5 में Z = 2.718 + 1 = 3.718 था, और queue log का वज़न 2.718 ÷ 3.718 = 0.731। (पड़ाव 3 और 8)
Bold 𝐝 और 𝐪, ⊤, और BERTd और BERTq के छोटे d और q क्या बताते हैं?
जवाब देखिए
Bold का मतलब vector है। ⊤ column vector को row बनाता है, और row गुणा column dot product है: [0.9, 0.1] और [0.8, 0.2] से 0.74। BERTd passages का encoder है और BERTq सवालों का, यानी ये दो अलग encoders हैं। (पड़ाव 8)
top-k(p(·|x)) ढूँढने के लिए सारे passages पर softmax क्यों नहीं चलाना पड़ता, और इस search को MIPS क्यों कहते हैं?
जवाब देखिए
exp increasing function है, और Z से भाग सब पर एक जैसा है, इसलिए वज़नों का क्रम वही है, जो dot products का। तो सबसे बड़े k dot products वाले passages ढूँढना काफ़ी है, और dot product का दूसरा नाम inner product है। (पड़ाव 8)
इस lesson की 3 बातें
p(A|B) का मतलब है “B पता हो, तो A का chance”, और ये p(B|A) से अलग है। Chain rule से पूरे जवाब की probability हर token की conditional probability का गुणा है।
RAG formula top-K passages पर marginalization है। ≈ तभी करीब है, जब छोड़े गए passages के वज़न छोटे हों।
Softmax exp और normalizer Z से वज़न बनाता है, और क्रम नहीं बदलता, इसलिए top-k के लिए MIPS काफ़ी है। Loss एक जोड़ का −ln है, जो नहीं टूटता, इसलिए एक ही loss retriever और generator, दोनों को उनकी दरें देता है।
इस lesson के नए शब्द
Conditional probability, p(A|B)
B पता हो, तो A की probability। “|” को “given” पढ़िए। जैसे p(भरा | Tuesday) = 16 ÷ 20 = 0.80।
Chain rule (probability वाला)
p(A और B) = p(A) × p(B|A)। कई steps हों, तो सबका गुणा। जैसे p(Tuesday) × p(भरा | Tuesday) = 0.5 × 0.8 = 0.40। Lesson 12 का दरों वाला chain rule इससे अलग है।
∏ (capital pi)
नीचे लिखी range पर सबका गुणा। जैसे तीन tokens पर 0.21 × 0.31 × 0.71 = 0.046।
Marginalization
हर case का वज़न गुणा उस case में probability, फिर सारे cases का जोड़। जैसे 0.5 × 0.8 + 0.5 × 0.1 = 0.45।
≈
करीब बराबर। RAG के formula में सिर्फ़ top-K passages जुड़ते हैं, इसलिए जोड़ “करीब” बराबर है।
exp और e
exp(s) = es, जहाँ e करीब 2.718 है। हमेशा 0 से बड़ा, और ea+1 = ea × e। जैसे exp(1) = 2.718, exp(0) = 1, exp(−1) = 0.368।
Softmax
हर score का exp, फिर सबके जोड़ से भाग। Scores को probabilities बनाता है। जैसे 2.0, 1.0, 0.1 से 0.659, 0.242, 0.099।
∝
के अनुपात में। आख़िर में सबको एक ही number से ऐसे भाग दीजिए कि जोड़ 1 हो। जैसे exps 2.718 और 1 से 0.731 और 0.269।
d⊤q
Vectors d और q का dot product लिखने का एक तरीका। जैसे office hours page [0.9, 0.1] और सवाल [0.8, 0.2] पर 0.74।
Natural log, ln
e को किस power तक उठाएँ कि x मिले। ln(ex) = x, और ln(a × b) = ln a + ln b। जैसे ln(0.1) = −2.303।
Loss
Model कितना गलत है, उसका number। Training इसे छोटा करती है। जैसे सही जवाब की probability 0.5 हो, तो loss −ln 0.5 = 0.693।
Likelihood
Model ने सही data को जो probability दी। जैसे सही जवाब को 0.12 दिया, तो likelihood 0.12।
Negative log-likelihood
−ln p(सही जवाब)। सबसे आम loss। जैसे p = 0.12 पर −ln 0.12 = 2.120।
Gradient
हर parameter को किस दिशा में और कितना बदलें कि loss घटे, उसका हिसाब। जैसे lesson 1 में training ने parameters को उस दिशा में बदला, जिसमें Thursday की probability 0.10 से 0.12 हुई और loss 2.303 से 2.120।
Normalizer, Z
Softmax में सारे exps का जोड़, जिससे भाग देने पर वज़नों का जोड़ 1 होता है। ∝ के पीछे यही भाग छिपा है। जैसे exps 2.718 और 1 पर Z = 3.718।
Column vector और ⊤
Column vector के numbers ऊपर-नीचे लिखे होते हैं, और ⊤ (transpose) उसे row बना देता है। Row गुणा column dot product है। जैसे row [0.9, 0.1] गुणा column [0.8, 0.2] = 0.74।
Increasing function
ऐसा function, जिसमें बड़ा input हमेशा बड़ा output देता है, इसलिए क्रम नहीं बदलता। exp और ln ऐसे हैं। जैसे scores 1.56 और 0.74 से वज़न 0.499 और 0.220, उसी क्रम में।
Negative marginal log-likelihood
सही जवाब की probability का −ln, जब वो probability passages पर marginalization से बनी हो, और सारे examples पर उसका जोड़। RAG का training loss। जैसे दो examples पर 0.378 + 0.693 = 1.071।