Probability के औज़ार: RAG का formula पढ़ने की तैयारी
ये lesson पाँच औज़ार बनाता है: conditional probability, chain rule, marginalization, softmax और loss। Lesson 5 का RAG formula इन्हीं पाँच से बना है। वो formula दो तरह के numbers जोड़ता है। Lesson 1 में LLM ने queue log पढ़कर Thursday को 0.81 दी थी। Lesson 3 में retriever ने course के लंबे FAQ page को 1.56 दिया था।
ये दोनों numbers सीधे नहीं जुड़ते। 1.56 probability नहीं हो सकता, क्योंकि probability 1 से बड़ी नहीं होती। और 0.81 पूरे जवाब का नहीं, सिर्फ़ पहले token का chance है। Lesson 5 का formula इन्हें ऐसे जोड़ता है: p(y|x) ≈ ∑ p(z|x) · p(y|x, z), जहाँ p(z|x) ∝ exp(d(z)⊤q(x)), और training ∑ −log p(y|x) को छोटा करती है। पड़ाव 5 में आप ये पूरा formula हाथ से चलाएँगे।
इस lesson की सीढ़ी
सीढ़ी में 5 पड़ाव हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
Conditional probability और chain rulep(भरा | Tuesday) जैसी probability गिनती से निकाल पाएँगे, और tokens की probabilities से पूरे जवाब की probability बना पाएँगे।
पूरा RAG formula हाथ सेFormula का हर हिस्सा अपने numbers से निकाल पाएँगे, और Stanford की RAG वाली slide पढ़ पाएँगे।
पहले से क्या चाहिए: Lesson 1 (probability, token, next-token prediction, training) और Lesson 3 (vector, dot product, ∑)। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1Conditional probability और chain rule: पता बात से बदलता chance
“|” के बाद लिखी बात पहले से पता है
Conditional probability किसी बात का chance है, जब कोई दूसरी बात पहले से पता हो। इसे p(A | B) लिखते हैं, और “B पता हो, तो A की probability” पढ़ते हैं। RAG के formula में हर probability के अंदर यही खड़ी line “|” है, इसलिए पहले इसका मतलब numbers पर देखिए।
पिछले 20 हफ़्तों में 40 office hour sessions हुए, 20 Tuesday को और 20 Thursday को। जिस session में 10 से ज़्यादा students इंतज़ार में थे, उसे “भरा” मानिए। numbers मेरे बनाए हैं
भरा
खाली
कुल
Tuesday
16
4
20
Thursday
2
18
20
कुल
18
22
40
दिन पता न हो, तो सारे 40 sessions गिनिए। उनमें 18 भरे थे, इसलिए p(भरा) = 18 ÷ 40 = 0.45। अब पता है कि आज Tuesday है, तो सिर्फ़ Tuesday वाली row गिनिए। उसमें 20 में से 16 भरे थे, यानी p(भरा | Tuesday) = 16 ÷ 20 = 0.80। Thursday पता हो, तो p(भरा | Thursday) = 2 ÷ 20 = 0.10। दिन पता चलते ही chance 0.45 से 0.80 या 0.10 हो गया।
p(A | B) = A और B, दोनों वाले casesB वाले cases
Tuesday के लिए ऊपर 16 है, यानी भरे हुए Tuesdays, और नीचे 20, यानी सारे Tuesdays।
Lesson 1 का next-token prediction भी conditional probability है। वहाँ prompt पता था, और Thursday की probability 0.21 थी। Prompt में queue log जुड़ा, यानी पता बात बदली, तो वही probability 0.81 हो गई।
अब आप formula के दोनों टुकड़े पढ़ सकते हैं। p(z|x) यानी सवाल x पता हो, तो passage z की probability। p(y|x, z) यानी सवाल x और passage z, दोनों पता हों, तो जवाब y की probability। “|” के बाद का comma “और” पढ़िए।
पूरे जवाब की probability: chain rule
LLM एक बार में एक token लिखता है, और हर token की अपनी probability होती है। लेकिन formula में p(y|x, z) पूरे जवाब y की probability है, जैसे Thursday morning. की। तीन tokens की तीन probabilities से एक probability बनाने का नियम ऊपर की table में ही दिखता है।
Table में Tuesday और भरा, दोनों साथ 40 में से 16 बार हुए, यानी 0.40। यही number दो कदम में भी आता है। पहले Tuesday का chance लीजिए: p(Tuesday) = 20 ÷ 40 = 0.5। फिर Tuesday होते हुए भरे होने का chance लीजिए: p(भरा | Tuesday) = 0.8। दोनों का गुणा 0.5 × 0.8 = 0.40 है।
p(A और B) = p(A) × p(B | A)
दो बातें साथ होने की probability, पहली बात की probability गुणा पहली के बाद दूसरी की probability है। इस नियम को कहते हैं। Lesson 12 में इसी नाम का एक और नियम आता है, जो दरों के बारे में है, इसलिए इसे probability वाला chain rule कहिए।
जवाब के tokens पर यही नियम एक के बाद एक चलता है। पहला token Thursday है, जिसकी probability 0.21 है। Thursday लिख चुकने के बाद morning की probability 0.31 है, और फिर full stop की 0.71। पूरे जवाब की probability इन तीनों का गुणा है। Lesson 1 के widget वाले दोनों जवाबों पर ये ऐसा दिखता है:
जवाब
हर token की probability
पूरे जवाब की probability
Thursday morning.
0.21 × 0.31 × 0.71
0.046
Wednesday afternoon.
0.34 × 0.46 × 0.71
0.111
n tokens वाले जवाब पर यही गुणा से लिखते हैं। ∏ का मतलब है नीचे लिखी range पर सबका गुणा, जैसे ∑ का मतलब सबका जोड़ था। yi जवाब का i-वाँ token है, और उसकी probability में “|” के बाद सवाल x और उससे पहले के सारे tokens हैं:
p(y | x) = ∏i = 1 … n p(yi | x, y1 … yi−1)
हमारे जवाब में n = 3 है: y1 = Thursday, y2 = morning और y3 = full stop। y2 की probability में “|” के बाद सवाल और Thursday हैं। पूरा गुणा 0.21 × 0.31 × 0.71 = 0.046 है।
इस गुणा में एक दिक्कत है। हर probability 1 से छोटी है, इसलिए हर गुणा के साथ नतीजा और छोटा होता जाता है। 20 tokens हों, और हर एक की probability 0.5, तो पूरे जवाब की probability 0.520 = 0.00000095 बनती है। पड़ाव 4 का ln इसी दिक्कत को हल करता है।
पहले सोचिए
4 tokens वाले एक जवाब में tokens की probabilities 0.9, 0.8, 0.5 और 0.9 हैं। पूरे जवाब की probability कितनी है?
जवाब देखिए
0.9 × 0.8 = 0.72, फिर 0.72 × 0.5 = 0.36, और फिर 0.36 × 0.9 = 0.324। बाकी तीन tokens 0.8 या उससे ऊपर हैं, फिर भी 0.5 वाले एक token ने पूरे जवाब की probability आधी कर दी।
2Marginalization: पता न हो कि कौन सा case सच है
Marginalization कुल probability निकालने का तरीका है, जब पता न हो कि कौन सा case सच है। हर case की probability को उस case वाले chance से गुणा कीजिए, फिर सारे गुणा जोड़ दीजिए। Case की probability को उसका वज़न कहेंगे।
RAG में यही हालत है। Retriever कई passages लाता है, और system को पहले से पता नहीं कि कौन सा passage सही है। Queue log के साथ LLM Thursday 9am को ऊँची probability देगा, और पुराने forum post के साथ नीची। System को इनसे एक ही probability बनानी है।
पहले यही हालत office hours पर देखिए, जहाँ numbers छोटे हैं। एक student आधे हफ़्ते Tuesday जाता है और आधे Thursday, यानी p(Tuesday) = 0.5 और p(Thursday) = 0.5। हर दिन भरे होने का chance पड़ाव 1 से पता है: 0.8 और 0.1। बस ये पता नहीं कि आज वो किस दिन जाएगा।
Case z
वज़न p(z)
p(भरा | z)
गुणा
Tuesday
0.5
0.8
0.40
Thursday
0.5
0.1
?
जोड़ = p(भरा)
?
Thursday वाली row आप निकालिए
Thursday का गुणा कितना है, और कुल p(भरा) कितना? Student 90% बार Thursday जाए, तो कुल chance कितना होगा?
जवाब देखिए
Thursday: 0.5 × 0.1 = 0.05। जोड़ 0.40 + 0.05 = 0.45, यानी वही, जो पड़ाव 1 में 18 ÷ 40 से सीधे गिनकर आया था।
90% Thursday पर: 0.1 × 0.8 + 0.9 × 0.1 = 0.08 + 0.09 = 0.17। हर दिन का chance वही रहा, सिर्फ़ वज़न बदले, और कुल chance 0.45 से 0.17 हो गया।
इस तरीके को कहते हैं। ये तभी सही है, जब cases आपस में overlap न करें, और उनके वज़नों का जोड़ 1 हो। यहाँ दोनों बातें सच हैं, क्योंकि student एक दिन या तो Tuesday जाता है या Thursday, और 0.5 + 0.5 = 1।
p(A) = ∑z p(z) × p(A | z)
z एक case है, यहाँ Tuesday या Thursday। p(z) उसका वज़न है, 0.5 और 0.5, और p(A | z) उस case में भरे होने का chance, 0.8 और 0.1। सारे cases का जोड़ है, यहाँ 0.40 + 0.05, और नतीजा p(A) = 0.45 है।
Lesson 5 का RAG formula यही है। वहाँ case z एक passage है, और उसका वज़न retriever का भरोसा p(z|x) है। हर passage के साथ जवाब की probability p(y|x, z) है, यानी पड़ाव 1 वाला tokens का गुणा।
RAG के formula में “=” की जगह है, यानी “करीब बराबर”। RAG सारे passages नहीं जोड़ता, सिर्फ़ retriever के passages जोड़ता है, यानी सबसे ऊँचे K scores वाले passages। बाकी passages के वज़न बहुत छोटे होते हैं, इसलिए जोड़ करीब वही रहता है।
एक शर्त अभी बाकी है। हर वज़न 0 और 1 के बीच होना चाहिए, और सारे वज़नों का जोड़ 1। Retriever के scores ऐसे नहीं होते, इसलिए पड़ाव 3 उन्हें वज़न में बदलता है।
3Softmax: retriever के scores से वज़न
Softmax scores की list को probabilities की list में बदलता है। उसके दो steps हैं: हर score का exp लीजिए, फिर हर exp को सारे exps के जोड़ से भाग दीजिए। पहले देखिए कि ये दोनों steps क्यों चाहिए।
Lesson 3 में सवाल when can I get help from a TA का एक vector था। Retriever ने उस vector से हर passage का निकाला था, यानी एक ही जगह वाले numbers का गुणा, फिर जोड़। जैसे office hours page के लिए 0.8 × 0.9 + 0.2 × 0.1 = 0.74। बाकी scores थे: syllabus 0.26, project page 0.32 और course का लंबा FAQ page 1.56।
ये probabilities नहीं हैं, क्योंकि 1.56 तो 1 से बड़ा है, और चारों का जोड़ 2.88 है, 1 नहीं। हर score को चारों के जोड़ से भाग देना भी हमेशा नहीं चलता, क्योंकि dot product negative भी हो सकता है। तब negative हिस्सा बनता, और probability negative नहीं होती।
इसलिए softmax पहले हर score को positive number में बदलता है, और इसके लिए लेता है। exp(s) = es, जहाँ e एक तय number है, करीब 2.718। जैसे exp(1) = 2.718 और exp(2) = e × e = 7.389। exp(0) = 1 है, क्योंकि किसी भी number की power 0 पर नतीजा 1 होता है।
Negative score पर भी exp positive रहता है: exp(−1) = 1 ÷ e = 0.368। Score कुछ भी हो, exp हमेशा 0 से बड़ा होता है, और बड़ा score बहुत बड़ा exp बनता है। exp का एक नियम आगे काम आएगा: score में 1 जोड़ने पर exp, e गुना हो जाता है, क्योंकि ea+1 = ea × e। जाँच: exp(2) = exp(1) × e = 2.7183 × 2.7183 = 7.389।
अब softmax के दोनों steps scores 2.0, 1.0 और 0.1 पर देखिए: scores मेरे बनाए हैं
Score s
exp(s)
हिसाब
Probability
2.0
7.389
7.389 ÷ 11.212
0.659
1.0
2.718
2.718 ÷ 11.212
0.242
0.1
1.105
1.105 ÷ 11.212
0.099
जोड़
11.212
1.000
तीनों exps का जोड़ 11.212 है, और हर exp को इससे भाग देने पर 0.659, 0.242 और 0.099 मिलते हैं। तीनों 0 और 1 के बीच हैं, और उनका जोड़ 1 है, इसलिए ये वज़न बन सकते हैं। इस पूरे तरीके को कहते हैं:
pi = exp(si)∑j exp(sj)
ऊपर score si का exp है, जैसे पहली row में exp(2.0) = 7.389। नीचे सारे scores के exps का जोड़ है, 11.212। तो p1 = 7.389 ÷ 11.212 = 0.659।
पहले सोचिए
हर score में 1 जोड़ दीजिए, यानी 3.0, 2.0 और 1.1। Probabilities बढ़ेंगी, घटेंगी, या वैसी ही रहेंगी?
जवाब देखिए
वैसी ही रहेंगी: 0.659, 0.242 और 0.099। Score में 1 जोड़ने से हर exp, e गुना हो जाता है, जैसे exp(2.0) = 7.389 से exp(3.0) = 20.09। ऊपर और नीचे, दोनों e से गुणा होते हैं, और भाग में e कट जाता है। मतलब softmax सिर्फ़ scores के आपसी फ़र्क देखता है।
Lesson 5 का formula softmax को छोटे में ऐसे लिखता है:
p(z|x) ∝ exp(d(z)⊤q(x))
का मतलब है “के अनुपात में”। यानी पहले हर passage का exp निकालिए, फिर सबको एक ही number से ऐसे भाग दीजिए कि जोड़ 1 हो। वो number सारे exps का जोड़ है, इसलिए ∝ में softmax का भाग छिपा है।
passage और सवाल के vectors का dot product है। d(z) passage z का vector है, और q(x) सवाल x का। ऊपर का ⊤ सिर्फ़ लिखने का एक तरीका है, और हिसाब वही lesson 3 वाला है। जैसे office hours page [0.9, 0.1] और सवाल [0.8, 0.2] से 0.74।
अब lede वाला 1.56 भी वज़न बन सकता है। Lesson 3 के चारों scores पर softmax ये वज़न देता है: FAQ page 0.50, office hours page 0.22, project page 0.14 और syllabus 0.14। हिसाब मेरा Softmax क्रम नहीं बदलता, क्योंकि बड़ा score हमेशा बड़ा exp बनता है। इसलिए FAQ page अब भी सबसे ऊपर है, और lesson 3 वाली लंबे vector की दिक्कत softmax से ठीक नहीं होती।
Softmax खुद चलाइए
तीन passages के scores बदलिए। Probabilities का जोड़ हमेशा 1 रहता है, और negative score पर भी हर probability 0 से बड़ी रहती है।
Passage
Score
exp(score)
Probability
4ln और loss: गलती का एक number
Loss एक number है, जो बताता है कि model सही जवाब से कितना दूर है, और training इसी number को छोटा करती है। RAG में loss सही जवाब की probability से बनता है, और उसमें ln लगता है। ln पड़ाव 1 वाली छोटे numbers की दिक्कत भी हल करता है, इसलिए पहले ln देखिए।
, यानी ln x, वो power है, जिस तक e को उठाने पर x मिले। मतलब ln, exp का उल्टा है: ln(ex) = x। जैसे e1 = 2.718, इसलिए ln 2.718 = 1। और e0 = 1, इसलिए ln 1 = 0।
1 से छोटे number का ln negative होता है, क्योंकि उसके लिए e की power negative चाहिए। जैसे ln 0.1 = −2.303, क्योंकि e−2.303 = 1 ÷ e2.303 = 1 ÷ 10 = 0.1।
ln का सबसे काम का नियम ये है: ln(a × b) = ln a + ln b, यानी गुणा का ln, दोनों ln का जोड़ है। ये exp के नियम से आता है, क्योंकि गुणा में powers जुड़ती हैं: e2 × e3 = e5। Numbers में 7.389 × 20.09 = 148.4, और e5 भी 148.4 है। ln powers ही बताता है, इसलिए ln 148.4 = 5 = 2 + 3 = ln 7.389 + ln 20.09।
Thursday morning. पर ये नियम तीन probabilities का गुणा, तीन ln का जोड़ बना देता है:
जाँच: e−3.074 = 0.046, यानी वही पूरा गुणा। 20 tokens वाले जवाब पर 0.520 = 0.00000095 जैसे छोटे number की जगह 20 बार ln 0.5 जुड़ता है: 20 × (−0.693) = −13.86। हिसाब मेरा
अब गलती का number बनाइए: = −ln p, जहाँ p वो probability है, जो model ने सही जवाब को दी। सामने का minus loss को positive बनाता है, क्योंकि 1 से छोटी हर probability का ln negative है। नीचे की table में देखिए कि p घटने पर loss कैसे बढ़ता है:
सही जवाब की probability
Loss = −ln p
मतलब
1
0
पूरा पक्का और सही। Loss इससे कम नहीं हो सकता।
0.9
0.105
अच्छा
0.5
0.693
आधा भरोसा
0.1
2.303
ज़्यादातर गलत
0.01
4.605
बहुत गलत
p = 0.9 पर loss 0.105 है, लेकिन p = 0.1 पर 2.303, यानी 20 गुना से भी ज़्यादा।
Model ने सही जवाब को जो probability दी, उसे कहते हैं। Loss उसी का minus ln है, इसलिए इस loss का नाम है। Thursday morning. सही जवाब हो, तो उसका loss −(−3.074) = 3.074 है।
Lesson 1 में training ने parameters को थोड़ा बदला था। उससे Office hours are on के बाद Thursday की probability 0.10 से 0.12 हो गई थी। Loss −ln 0.10 = 2.303 से घटकर −ln 0.12 = 2.120 हुआ, यानी 2.303 − 2.120 = 0.183 कम।
Training data में बहुत सारे examples होते हैं। Example j में सवाल xj है और उसका सही जवाब yj, और कुल loss सारे examples के losses का जोड़ है:
कुल loss = ∑j − log p(yj | xj)
Stanford की slide और lesson 5 का formula log लिखते हैं, और उसका मतलब यही ln है।
Training हर parameter को किस दिशा में और कितना बदले, कि कुल loss घटे, ये बताता है। Thursday वाले example में training ने parameters को उस दिशा में बदला, जिसमें probability 0.10 से 0.12 हुई और loss 0.183 घटा। Gradient numbers से कैसे निकलता है, वो lesson 12 में आता है।
5पूरा RAG formula हाथ से
अब औज़ार एक साथ चलते हैं: softmax हर passage को वज़न देता है, marginalization जवाब की कुल probability देता है, और −ln उसका loss। Lede वाला सवाल फिर लीजिए: Which office hour is least crowded? Retriever दो passages लाता है: queue log और पुराना forum post। उनके dot product scores 1.0 और 0.0 हैं।
LLM सही जवाब Thursday 9am को queue log के साथ 0.9 probability देता है, और forum post के साथ 0.1। numbers मेरे बनाए हैं पूरा हिसाब तीन steps में है:
Softmax (पड़ाव 3): e1.0 = 2.718 और e0 = 1, जिनका जोड़ 3.718 है। Queue log का वज़न 2.718 ÷ 3.718 = 0.731 है, और forum post का 1 ÷ 3.718 = 0.269।
यानी system 0.685 पक्का है कि जवाब Thursday 9am है, और इस सवाल पर loss 0.378 है। Retriever queue log को और ऊँचा score दे, तो उसका वज़न 0.731 से बढ़ेगा, 0.685 भी बढ़ेगा, और loss घटेगा। Formula में यही तीन steps हैं:
Passage और सवाल के vectors का dot product, यहाँ 1.0 और 0.0।
p(z|x)
Softmax वाला वज़न, यहाँ 0.731 और 0.269।
p(y|x, z)
उस passage के साथ पूरे जवाब की probability, यहाँ 0.9 और 0.1।
∑ और ≈
K = 2 passages पर वज़न वाला जोड़, यहाँ 0.685।
−log p(y|x)
इस सवाल का loss, यहाँ 0.378।
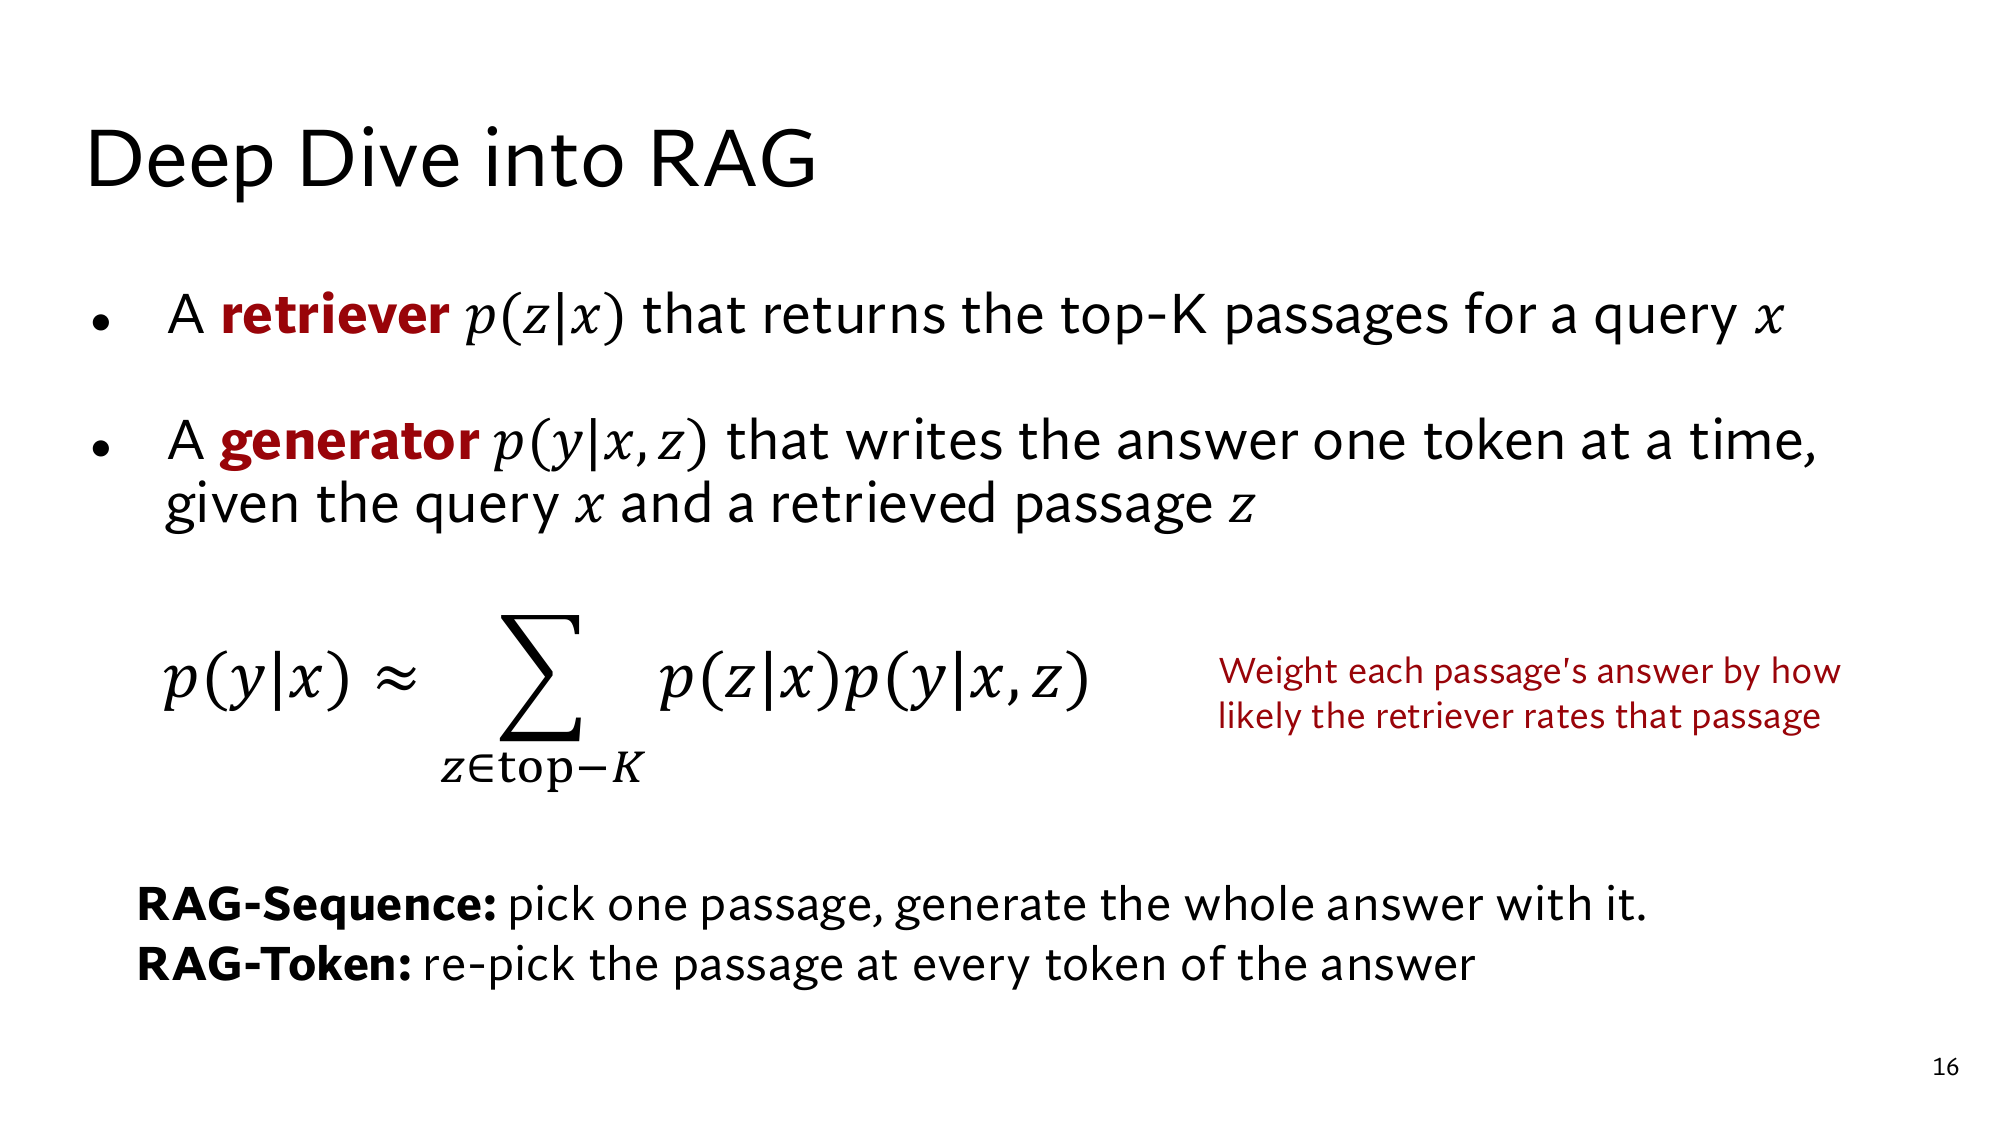
Stanford की slide: Deep Dive into RAG। ऊपर retriever p(z|x) है, और p(y|x, z), यानी जवाब लिखने वाला LLM। बीच में यही formula है। लाल line कहती है कि हर passage के जवाब को उतना वज़न दीजिए, जितना retriever उस passage को देता है। नीचे की RAG-Sequence और RAG-Token वाली lines lesson 5 में आती हैं। Image पर click करने से वो पूरे size में खुलती है।
पहले सोचिए
Retriever उल्टा भरोसा करे: queue log को score 0.0, और forum post को 1.0। LLM के numbers वही हैं, 0.9 और 0.1। अब Thursday 9am की कुल probability और loss कितने हैं?
जवाब देखिए
वज़न उलट गए: queue log को 0.269, और forum post को 0.731। कुल probability = 0.269 × 0.9 + 0.731 × 0.1 = 0.242 + 0.073 = 0.315, और loss = −ln 0.315 = 1.155।
LLM ने कुछ नहीं बदला, फिर भी probability 0.685 से 0.315 हो गई। गलत वज़न पूरे जवाब को नीचे खींचते हैं, और lesson 5 में training इसी गलती को ठीक करती है।
गहरे version में और क्या है
गहरे version में ये पूरा lesson है, और उसके बाद 5 पड़ाव और, जो Stanford की slides के level तक ले जाते हैं:
पड़ाव 6: slide के formula का हर symbol, paper में generator का पूरा गुणा, और p(A|B) और p(B|A) का फ़र्क। साथ में एक तीसरे passage से ये जाँच कि ≈ कितना करीब है।
पड़ाव 7: exp और ln के बाकी नियम, जैसे ln(a ÷ b) = ln a − ln b, और ये कि ln(a + b) टूटता नहीं। साथ में log10 और −ln 0।
पड़ाव 8: softmax पूरा: negative scores, scale का असर, normalizer Z, column vector और transpose, और top-k के लिए MIPS क्यों काफ़ी है।
पड़ाव 9: slide का negative marginal log-likelihood शब्द-शब्द, दो examples का कुल loss, और retriever और generator पर loss की दरें numbers में।
पड़ाव 10: Stanford की तीनों slides, जिन्हें आप खुद पढ़ते हैं।
p(A|B) का मतलब है “B पता हो, तो A का chance”। Chain rule से पूरे जवाब की probability हर token की conditional probability का गुणा है।
कौन सा case सच है, ये पता न हो, तो हर case का वज़न गुणा उस case में chance, फिर सबका जोड़। यही marginalization है, और यही lesson 5 का RAG formula है।
Softmax exp और भाग से scores को वज़न बनाता है, और सिर्फ़ scores के फ़र्क देखता है। −ln p loss है, और training gradient से इसी को छोटा करती है।
इस lesson के नए शब्द
Conditional probability, p(A|B)
B पता हो, तो A की probability। “|” को “given” पढ़िए। जैसे p(भरा | Tuesday) = 16 ÷ 20 = 0.80।
Chain rule (probability वाला)
p(A और B) = p(A) × p(B|A)। कई steps हों, तो सबका गुणा। जैसे p(Tuesday) × p(भरा | Tuesday) = 0.5 × 0.8 = 0.40। Lesson 12 का दरों वाला chain rule इससे अलग है।
∏ (capital pi)
नीचे लिखी range पर सबका गुणा। जैसे तीन tokens पर 0.21 × 0.31 × 0.71 = 0.046।
Marginalization
हर case का वज़न गुणा उस case में probability, फिर सारे cases का जोड़। जैसे 0.5 × 0.8 + 0.5 × 0.1 = 0.45।
≈
करीब बराबर। RAG के formula में सिर्फ़ top-K passages जुड़ते हैं, इसलिए जोड़ “करीब” बराबर है।
exp और e
exp(s) = es, जहाँ e करीब 2.718 है। हमेशा 0 से बड़ा, और ea+1 = ea × e। जैसे exp(1) = 2.718, exp(0) = 1, exp(−1) = 0.368।
Softmax
हर score का exp, फिर सबके जोड़ से भाग। Scores को probabilities बनाता है। जैसे 2.0, 1.0, 0.1 से 0.659, 0.242, 0.099।
∝
के अनुपात में। आख़िर में सबको एक ही number से ऐसे भाग दीजिए कि जोड़ 1 हो। जैसे exps 2.718 और 1 से 0.731 और 0.269।
d⊤q
Vectors d और q का dot product लिखने का एक तरीका। जैसे office hours page [0.9, 0.1] और सवाल [0.8, 0.2] पर 0.74।
Natural log, ln
e को किस power तक उठाएँ कि x मिले। ln(ex) = x, और ln(a × b) = ln a + ln b। जैसे ln(0.1) = −2.303।
Loss
Model कितना गलत है, उसका number। Training इसे छोटा करती है। जैसे सही जवाब की probability 0.5 हो, तो loss −ln 0.5 = 0.693।
Likelihood
Model ने सही data को जो probability दी। जैसे सही जवाब को 0.12 दिया, तो likelihood 0.12।
Negative log-likelihood
−ln p(सही जवाब)। सबसे आम loss। जैसे p = 0.12 पर −ln 0.12 = 2.120।
Gradient
हर parameter को किस दिशा में और कितना बदलें कि loss घटे, उसका हिसाब। जैसे lesson 1 में training ने parameters को उस दिशा में बदला, जिसमें Thursday की probability 0.10 से 0.12 हुई और loss 2.303 से 2.120।