RAG एक model है, जिसमें दो models जुड़े हैं। Retriever सवाल के लिए passages लाकर हर एक को वज़न देता है, और generator हर passage के साथ जवाब लिखता है। दोनों एक ही loss से साथ train होते हैं, और इस training को सिर्फ़ सवाल-जवाब के जोड़े चाहिए। RAG का पूरा नाम Retrieval-Augmented Generation है, और ये Lewis और साथियों का 2020 का model है।
इसकी ज़रूरत lesson 4 के आख़िरी सवाल में दिखी। वहाँ retriever ने पुराने forum post को 0.731 वज़न दिया, और queue log को सिर्फ़ 0.269। Generator के numbers वही रहे, फिर भी सही जवाब Thursday 9am का chance 0.685 से गिरकर 0.315 हो गया। गलती retriever की है, लेकिन training data में सिर्फ़ सवाल और जवाब लिखे हैं। जवाब queue log से आया, ये कहीं नहीं लिखा, और RAG इसी हालत में retriever को सिखा लेता है।
इस lesson की सीढ़ी
सीढ़ी में 5 पड़ाव हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
NQ पर नतीजेPaper की मुख्य table पढ़ पाएँगे, और बता पाएँगे कि lesson 6 की ज़रूरत क्यों है।
पहले से क्या चाहिए: Lesson 2 (retriever, top-K), Lesson 3 (vector, dot product, encoder, index) और Lesson 4 (marginalization, softmax, ∏, loss)। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1RAG के दो models: retriever और generator
RAG के अंदर दो models हैं। Retriever pη(z|x) हर passage z को वज़न देता है, और generator pθ(y|x, z) सवाल x और एक passage पढ़कर जवाब y लिखता है। ये वही दो probabilities हैं, जो lesson 4 के formula में थीं। नीचे लिखे छोटे η (eta) और θ (theta) दोनों models के के नाम हैं, यानी वो numbers, जिन्हें training बदलती है।
Retriever: DPR
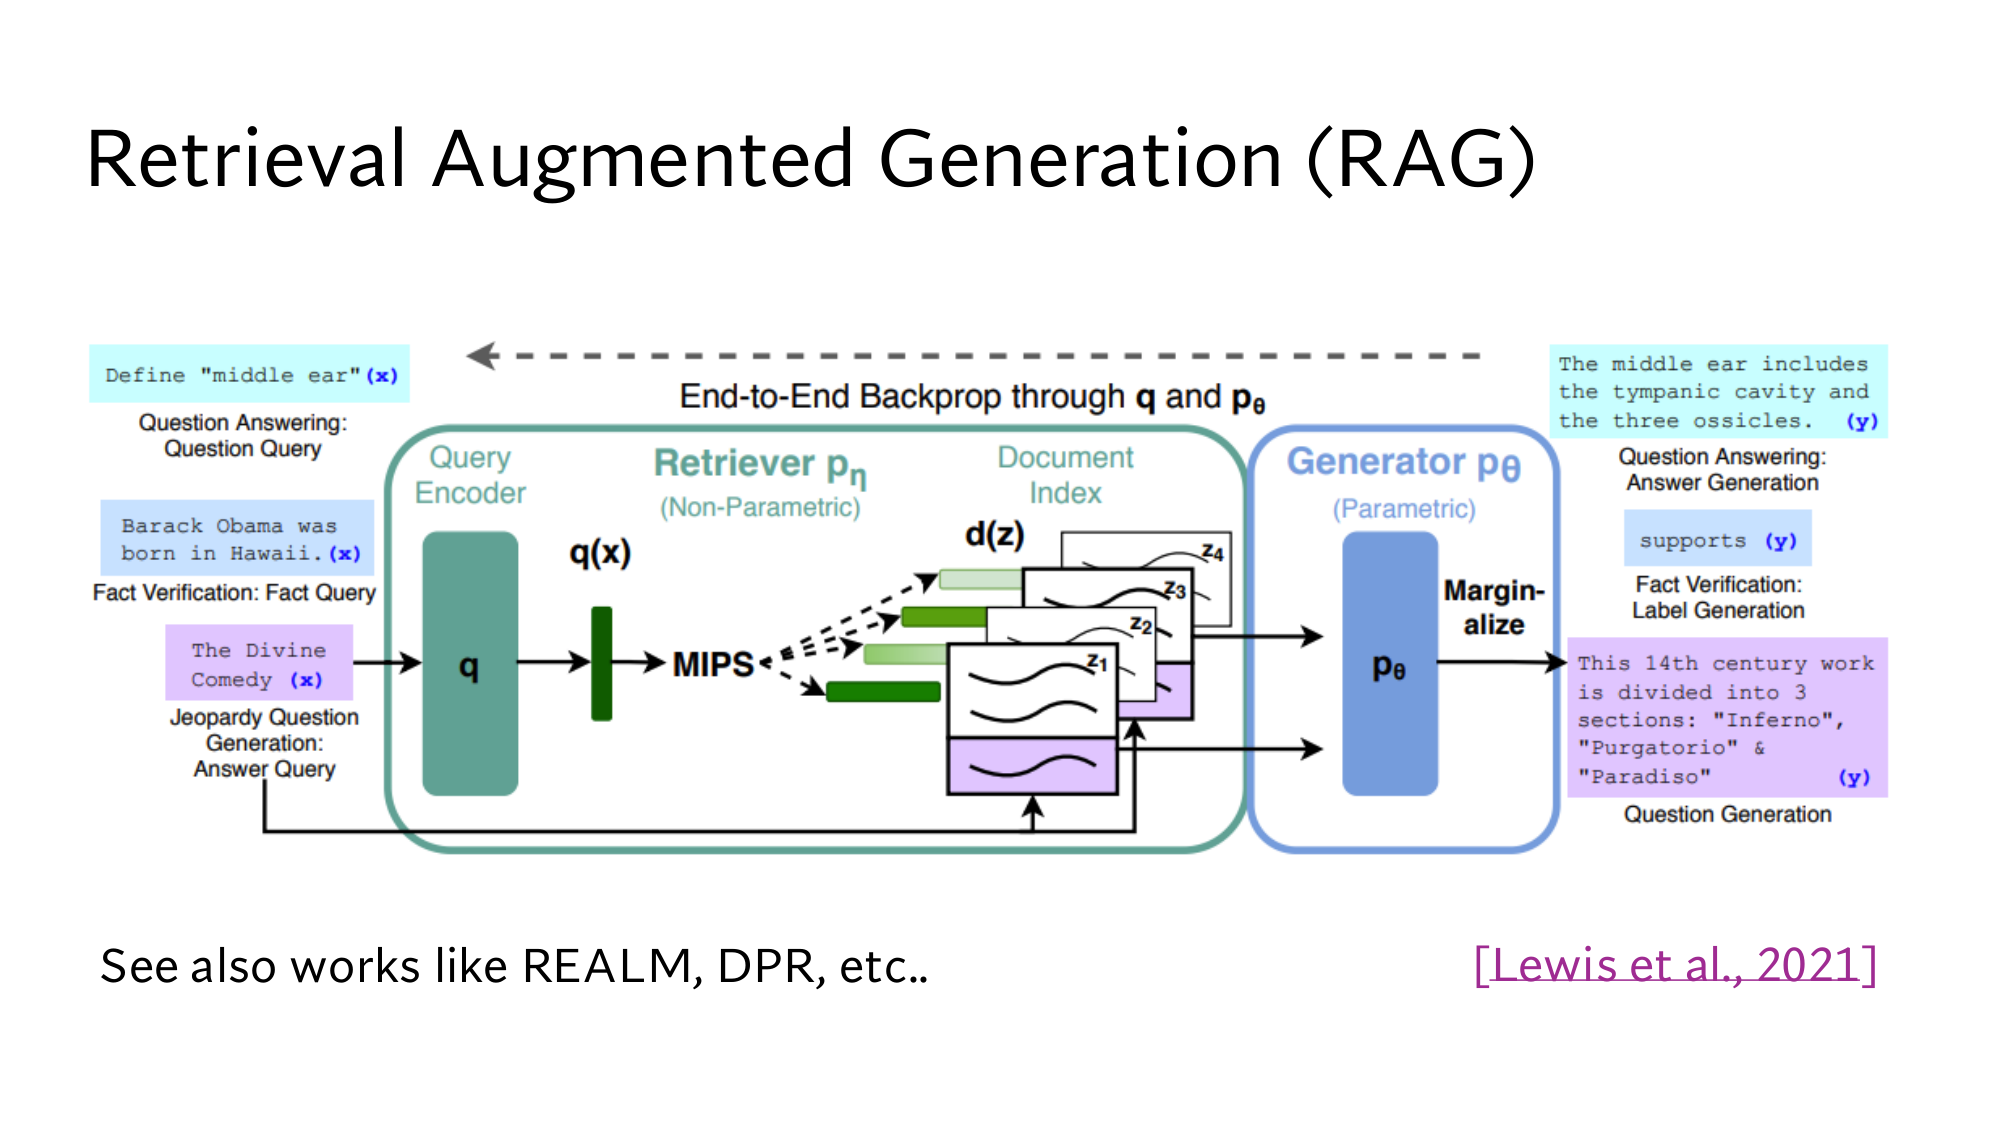
RAG का retriever DPR नाम का model है, जिसकी अपनी training lesson 12 में आती है। उसमें दो हैं, और दोनों BERT से बने हैं, जो Google का 2018 का एक encoder model है। Query encoder सवाल x का vector q(x) बनाता है, और passage encoder हर passage z का vector d(z)।
किसी passage का score इन दोनों vectors का है, जिसे d(z)⊤q(x) लिखते हैं। फिर scores को वज़नों में बदलता है, जिनका जोड़ 1 होता है। Lesson 4 में scores 1.0 और 0.0 से वज़न 0.731 और 0.269 बने थे। Stanford की slide यही बात ऐसे लिखती है:
pη(z|x) ∝ exp(d(z)⊤q(x))
यहाँ का मतलब है: हर passage का exp निकालिए, फिर सबको एक ही number से भाग दीजिए, ताकि जोड़ 1 हो।
Passages बहुत सारे हैं। Paper में Wikipedia के करीब 2.1 करोड़ passages हैं, हर एक 100 शब्दों का। paper से इनके vectors सवाल आने से पहले एक बार बनते हैं, और एक में रखे रहते हैं। सवाल आने पर सिर्फ़ query encoder चलता है, और फिर एक search सबसे बड़े K dot products वाले passages निकालती है। इस search को MIPS कहते हैं, यानी maximum inner product search, क्योंकि inner product dot product का ही दूसरा नाम है।
Generator: BART
Generator सवाल और एक passage पढ़कर जवाब लिखता है, lesson 1 के LLM की तरह एक बार में एक token। RAG का generator है, जो एक encoder-decoder model है। उसका encoder input text पढ़कर उसके vectors बनाता है, और decoder उन vectors को देखते हुए जवाब का एक-एक token लिखता है।
BART एक ही text पढ़ता है, इसलिए सवाल और passage को आगे-पीछे जोड़कर एक text बनाते हैं। दो texts को ऐसे जोड़ने को concatenate करना कहते हैं। Queue log के साथ input और output ऐसा दिखेगा: मेरा example
Input: question: Which office hour is least crowded? passage: Queue log, last 3 weeks: Tuesday 4pm office hour averaged 14 students waiting; Thursday 9am office hour averaged 3. Output: Thursday 9am
सवाल xWhich office hour is least crowded?
Query encoder q(x)सवाल का vector
MIPSIndex के हर d(z) से dot product, top-K
z1 … zKहर एक का वज़न, softmax से
Generator pθहर z के साथ एक बार
Marginalizeजोड़कर p(y|x)
एक सवाल पर RAG का पूरा रास्ता। पहले चार boxes retriever हैं, और आख़िरी दो generator। Marginalize वाला box पड़ाव 2 में आता है।
इस ढाँचे की एक कीमत है। Generator हर passage के साथ अलग से चलता है, इसलिए K = 5 हो, तो एक सवाल पर generator 5 बार चलता है।
Stanford की slide: RAG का ढाँचा। हरा box retriever pη है, जिसमें query encoder q, MIPS और document index d(z) हैं। नीला box generator pθ है। ऊपर का dashed arrow training है, जो पड़ाव 4 में आता है। Image पर click करने से वो पूरे size में खुलती है।
2Marginalization: passage का label नहीं चाहिए
RAG passage को एक छिपा हुआ choice मानता है, और जवाब की probability सारे लाए गए passages पर वज़न वाले जोड़ से निकालता है। ऐसे छिपे हुए choice को latent variable कहते हैं। जवाब किसी एक passage से आया, लेकिन किससे, ये data में नहीं लिखा।
Retriever को सीधे सिखाने के लिए हर सवाल के साथ उसका सही passage लिखा होना चाहिए। लाखों सवालों के लिए कोई इंसान इतने passages नहीं चुनता। Lesson 4 का इसी हालत का तरीका है: हर case की probability को उसके वज़न से गुणा कीजिए, फिर सब जोड़िए। वहाँ 0.5 × 0.8 + 0.5 × 0.1 = 0.45 था।
अब सवाल Which office hour is least crowded? पर देखिए। Retriever 3 passages लाया, यानी K = 3, और उनके scores 1.8, 1.1 और 0.0 हैं। Softmax में e1.8 = 6.05, e1.1 = 3.00 और e0 = 1 हैं, जिनका जोड़ 10.05 है। तो queue log का वज़न 6.05 ÷ 10.05 = 0.60 है, और इसी तरह बाकी दो के 0.30 और 0.10। numbers मेरे बनाए हैं
Generator हर passage के साथ Thursday 9am को एक probability देता है। हर row में वज़न और generator की probability का गुणा है:
Passage z
वज़न p(z|x)
p(“Thu 9am” | x, z)
गुणा
Queue logThursday 9am पर average 3 students
0.6
0.9
0.54
Office hours pageTuesday 4pm और Thursday 9am, कौन खाली है ये नहीं लिखा
0.3
0.5
?
पुराना forum postmidweek afternoons are usually the least crowded
0.1
0.1
0.01
जोड़ = p(“Thu 9am” | x)
?
दूसरी row आप निकालिए
Office hours page का वज़न 0.3 है, और उसके साथ generator 0.5 देता है। गुणा कितना है, और Thursday 9am का कुल chance कितना?
Wednesday afternoon के लिए generator के numbers 0.05, 0.2 और 0.8 हैं, क्योंकि forum post midweek afternoons की बात करता है। उसका जोड़ 0.6 × 0.05 + 0.3 × 0.2 + 0.1 × 0.8 = 0.03 + 0.06 + 0.08 = 0.17 है। तो RAG Thursday 9am चुनता है, 0.70 बनाम 0.17।
यही हिसाब symbols में ऐसा लिखते हैं:
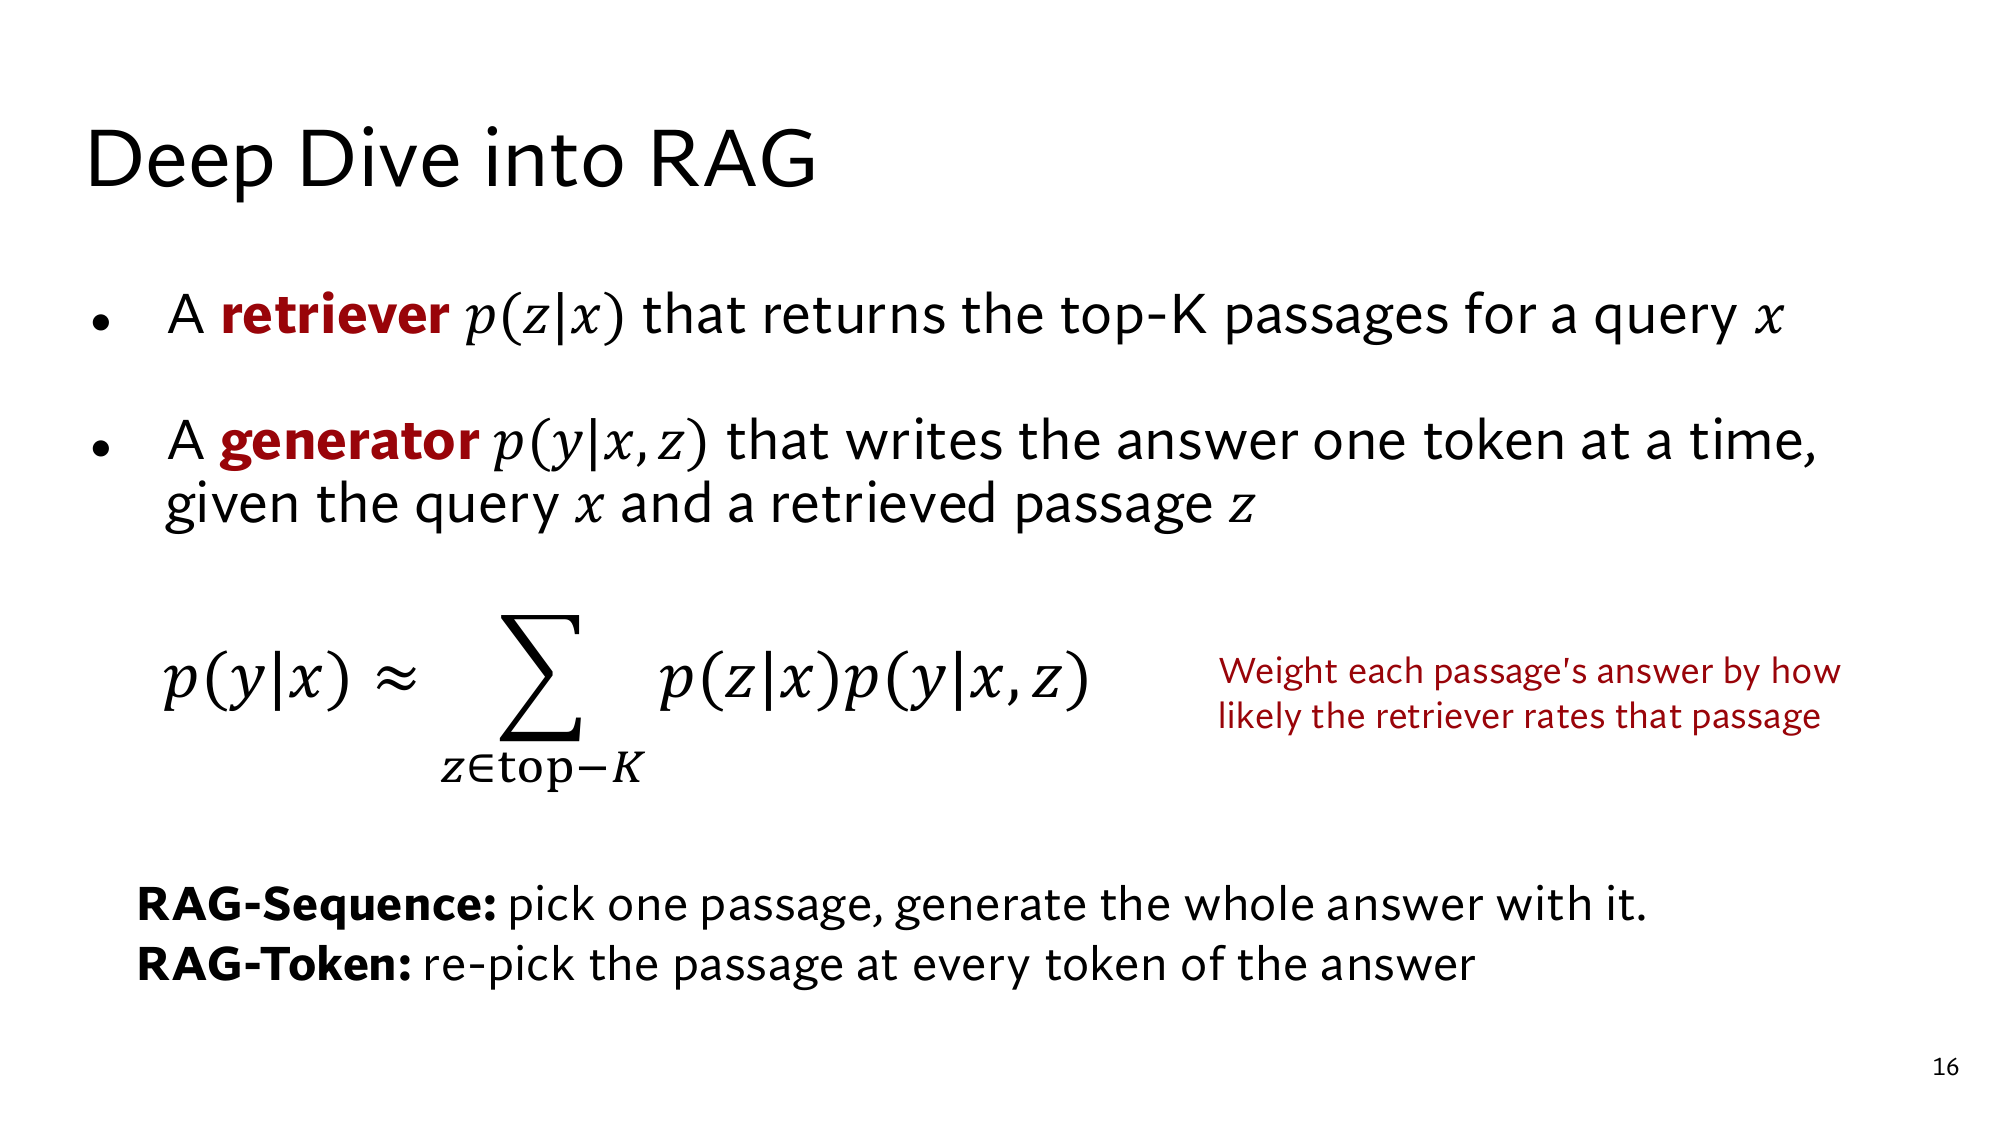
p(y|x) ≈ ∑z ∈ top-K pη(z|x) · pθ(y|x, z)
pη(z|x) वज़न हैं (0.6, 0.3, 0.1), pθ(y|x, z) generator के numbers हैं (0.9, 0.5, 0.1), और ∑ उनके गुणा जोड़ता है (0.70)। जोड़ सिर्फ़ top-K passages पर है, बाकी 2.1 करोड़ पर नहीं, इसलिए “=” की जगह लिखा है।
इस पूरे हिसाब में कहीं नहीं लिखा कि सही passage queue log है। Formula को सिर्फ़ सवाल x और जवाब y चाहिए, और passage जोड़ के अंदर छिपा रहता है। इसलिए RAG को train करने के लिए सवाल-जवाब के जोड़े काफ़ी हैं।
Retriever के scores बदलिए
Sliders retriever के scores हैं, और generator के numbers नहीं बदलते। Widget exact वज़न लेता है, इसलिए नीचे 0.70 की जगह 0.701 दिखता है। आख़िरी column पड़ाव 4 में आता है।
Passage
p(z|x)
“Thu 9am”
“Wed”
Training
अब “बिगड़ा retriever” दबाइए। Retriever अब forum post को 0.69 वज़न देता है, Wednesday afternoon 0.60 पर पहुँचता है, और Thursday 9am सिर्फ़ 0.27 पर रहता है। Generator के numbers वही हैं, इसलिए ये पूरा फ़र्क retriever के वज़नों से आया। मतलब RAG का जवाब retriever के वज़नों पर उतना ही टिका है, जितना generator के numbers पर।
इस जोड़ की एक हद भी है। सही passage top-K में आया ही नहीं, तो वो जोड़ में नहीं है, और training उसका वज़न नहीं बढ़ा सकती। Lesson 2 में इसे कहा था।
3RAG-Sequence और RAG-Token: वज़न वाला जोड़ कब लगे
RAG-Sequence हर passage के साथ पूरा जवाब लिखता है, फिर वज़न वाला जोड़ लगाता है। RAG-Token जवाब के हर token पर अलग से वज़न वाला जोड़ लगाता है। अब तक पूरा जवाब एक टुकड़ा था, लेकिन generator उसे एक-एक token करके लिखता है। जब जवाब के अलग हिस्से अलग passages में हों, तब दोनों तरीकों के नतीजे अलग आते हैं।
पूरे जवाब की probability उसके tokens की probabilities का गुणा है, जो lesson 4 का है। जैसे Thursday की probability 0.9 हो, और उसके बाद Zoom की 0.2, तो पूरे जवाब की 0.9 × 0.2 = 0.18।
अब सवाल लीजिए: Least crowded office hour, and where is it? जवाब के दो tokens हैं: Thursday और Zoom। Queue log बताता है कि Thursday सबसे खाली है, लेकिन जगह नहीं बताता। Office hours page में Thursday 9am on Zoom लिखा है, लेकिन ये नहीं कि कौन सा slot खाली है। numbers मेरे बनाए हैं
Passage
वज़न
p(Thursday | x, z)
p(Zoom | x, z, Thursday)
Queue log
0.6
0.9
0.2
Office hours page
0.4
0.5
0.9
RAG-Sequence पहले हर passage के साथ पूरा जवाब लिखता है, फिर वज़न वाला जोड़ लगाता है:
Queue log के साथ पूरा जवाब: 0.9 × 0.2 = 0.18।
Office hours page के साथ पूरा जवाब: 0.5 × 0.9 = 0.45।
Slide पर इसका मतलब है: re-pick the passage at every token of the answer।
RAG-Token को ज़्यादा probability मिली, 0.355 बनाम 0.288। वो Thursday के लिए queue log पर और Zoom के लिए office hours page पर टिक सकता है। RAG-Sequence को पूरा जवाब एक ही passage से लिखना पड़ता है, और कोई अकेला passage दोनों बातें नहीं जानता।
दोनों formulas में वही चीज़ें हैं, बस ∑ और की जगह बदली है। ∏ का मतलब है नीचे लिखी range पर सबका गुणा, ठीक वैसे जैसे ∑ सबका जोड़ है। यहाँ yi जवाब का i-वाँ token है, और y<i उससे पहले के सारे tokens।
RAG-Sequence में ∏ अंदर है: पहले हर passage पर tokens का गुणा होता है (0.18 और 0.45), फिर ∑। RAG-Token में ∑ अंदर है: पहले हर token पर passages का जोड़ होता है (0.74 और 0.48), फिर ∏। पड़ाव 5 के नतीजों में दोनों तरीके करीब-करीब बराबर निकलते हैं।
Stanford की slide: Deep Dive into RAG। ऊपर retriever और generator हैं, बीच में पड़ाव 2 का formula, और नीचे RAG-Sequence और RAG-Token की दो lines। अब आप इसकी हर line पढ़ सकते हैं।
पहले सोचिए
ऊपर वाले example में दोनों passages का वज़न 0.5-0.5 कर दीजिए। RAG-Sequence और RAG-Token, दोनों की probability निकालिए।
जवाब देखिए
RAG-Sequence: 0.5 × 0.18 + 0.5 × 0.45 = 0.315। RAG-Token: (0.5 × 0.9 + 0.5 × 0.5) × (0.5 × 0.2 + 0.5 × 0.9) = 0.70 × 0.55 = 0.385। RAG-Token फिर आगे है, क्योंकि दोनों tokens अब भी अलग passages से आते हैं।
4एक loss से retriever और generator की training
RAG की training सही जवाब की probability का −ln छोटा करती है, और यही एक loss retriever और generator, दोनों को बदलता है। एक loss से सारे हिस्सों को साथ train करने को end-to-end training कहते हैं। Data में सिर्फ़ सवाल-जवाब के जोड़े हैं, फिर भी इसी loss से retriever सीखता है कि किस passage को ज़्यादा वज़न दे।
lesson 4 वाला है: सही जवाब की probability p का −ln। पड़ाव 2 में Thursday 9am को 0.70 मिला था, तो loss = −ln 0.70 = 0.357। सारे training examples j पर ये losses जुड़ते हैं:
∑j − log p(yj | xj)
Slide इसे कहती है। Marginal इसलिए, क्योंकि p(y|x) खुद passages पर marginalization से बना है, और slide का log यही ln है।
किस passage का score बढ़ने से loss घटता है
नीचे की table में हर row एक score को 0.5 बढ़ाती है, और बाकी दो scores वैसे ही रहते हैं। यहाँ वज़न 3 decimals तक हैं, इसलिए पहली row में loss 0.355 है, 0.357 नहीं। हिसाब मेरा
किसका score 0.5 बढ़ा
वज़न: queue log, office hours, forum
p(“Thu 9am” | x)
Loss
किसी का नहीं
0.602, 0.299, 0.099
0.701
0.355
Queue log, 1.8 से 2.3
0.714, 0.215, 0.072
0.757
0.279
Office hours page, 1.1 से 1.6
0.504, 0.413, 0.083
0.668
0.403
Forum post, 0.0 से 0.5
0.565, 0.281, 0.154
0.664
0.409
Queue log का score बढ़ा, तो कुल chance 0.701 से 0.757 हुआ, और loss घटा। बाकी दोनों में से किसी का score बढ़ा, तो कुल chance घटा और loss बढ़ा, office hours page के 0.5 के बावजूद।
इसकी वजह weighted average में है। p(y|x) generator के numbers 0.9, 0.5 और 0.1 का weighted average है, यानी हर number को उसके वज़न से गुणा करके जोड़। Weighted average हमेशा सबसे छोटे और सबसे बड़े number के बीच रहता है, और जिस number का वज़न बढ़े, average उसी की तरफ़ खिसकता है।
Queue log को अलग रखकर देखिए। Office hours page और forum post के वज़न आपस में 3 : 1 हैं, यानी 0.75 और 0.25। उनका average 0.75 × 0.5 + 0.25 × 0.1 = 0.4 है। तो कुल chance = 0.6 × 0.9 + 0.4 × 0.4 = 0.54 + 0.16 = 0.70। Queue log का score बढ़ने पर भी ये 3 : 1 नहीं बदलता, क्योंकि softmax में बाकी दोनों के exps वही रहते हैं। इसलिए queue log का वज़न w हो, तो कुल chance w × 0.9 + (1 − w) × 0.4 है:
Queue log का वज़न w
कुल chance
0.5
0.65
0.6, अभी
0.70
0.7
0.75
0.8
0.80
1.0
0.90
Office hours page के साथ यही हिसाब उल्टा चलता है, क्योंकि उसका 0.5 बाकी दोनों passages के average 0.79 से कम है।
नियम ये है: जिस passage के साथ generator सही जवाब को कुल chance से ज़्यादा probability देता है, training उसका score बढ़ाती है। जिसके साथ कम देता है, उसका score training घटाती है। यहाँ कुल chance 0.70 है, इसलिए queue log (0.9) का score बढ़ेगा, और office hours page (0.5) और forum post (0.1) के scores घटेंगे। ये नियम slide पर नहीं है, ये गणित से निकलता है
अब बिगड़े retriever पर यही नियम चलाइए। वहाँ कुल chance 0.27 है, इसलिए queue log (0.9) और office hours page (0.5), दोनों के scores बढ़ेंगे, और forum post (0.1) का घटेगा। Data में queue log का नाम कहीं नहीं था, फिर भी training retriever को queue log की तरफ़ ले जाती है। पड़ाव 2 के widget का आख़िरी column यही नियम दिखाता है।
कौन से हिस्से train होते हैं
Training हर parameter को उस दिशा में थोड़ा खिसकाती है, जिसमें loss घटे, और ये दिशा बताता है। Loss से पीछे की तरफ़ चलकर हर parameter का gradient निकालने के तरीके को backpropagation कहते हैं, छोटे में backprop। RAG में ये gradient generator के parameters θ तक, और retriever में query encoder तक पहुँचता है।
Passage encoder और index नहीं बदलते, क्योंकि passage encoder बदलता, तो 2.1 करोड़ passages के vectors दोबारा बनाकर index फिर से बनाना पड़ता। paper से इसलिए training सिर्फ़ सवाल की तरफ़ से सुधार करती है। वो query encoder को ऐसे बदलती है, कि काम के passages से q(x) का dot product बढ़े। किसी passage का vector खराब बना हो, तो training उसे नहीं सुधार सकती।
पड़ाव 1 की slide पर ऊपर वाला dashed arrow यही कहता है: End-to-End Backprop through q and pθ। Arrow q और pθ तक जाता है, document index के d(z) तक नहीं।
पहले सोचिए
Widget में “तीनों बराबर” दबाइए, यानी हर passage का वज़न 1/3। Thursday 9am का कुल chance कितना है? Training किस passage का score बढ़ाएगी, किसका घटाएगी, और office hours page का क्या होगा?
जवाब देखिए
कुल chance (0.9 + 0.5 + 0.1) ÷ 3 = 0.50 है। Queue log (0.9) इससे ऊपर है, तो उसका score बढ़ेगा। Forum post (0.1) नीचे है, तो उसका घटेगा। Office hours page ठीक 0.5 देता है, यानी कुल chance के बराबर, इसलिए उसका score वैसा ही रहेगा।
5NQ पर नतीजे: RAG, T5-11B और DPR
Paper RAG को सवाल-जवाब के datasets पर नापता है। Natural Questions (NQ) में Google search पर लोगों के असली सवाल हैं, और उनके जवाब Wikipedia में हैं। paper से जवाब तभी सही गिनते हैं, जब वो सही जवाब से हूबहू मिले, और इस नाप को Exact Match कहते हैं। Score ऐसे सवालों का % है।
Table में दो किस्म के models हैं। Closed book model के पास कोई document नहीं होता, वो सिर्फ़ अपने parameters से जवाब देता है। Open book model पहले documents में ढूँढता है, फिर जवाब देता है।
Model
किस तरह का
NQ
T5-11B
Closed book, 11 billion parameters
34.5
REALM
Open book, passage में से जवाब का टुकड़ा उठाता है
40.4
DPR
Open book, passage में से जवाब का टुकड़ा उठाता है
41.5
RAG-Token
Open book, जवाब खुद लिखता है
44.1
RAG-Sequence
Open book, जवाब खुद लिखता है
44.5
T5-11B 34.5 पर है, और RAG-Sequence 44.5 पर, यानी 10 points आगे। 1,000 सवालों में ये 345 और 445 हूबहू सही जवाब हैं। मतलब documents वाला RAG, सिर्फ़ parameters वाले T5-11B से 1,000 में 100 सवाल ज़्यादा हूबहू सही करता है।
DPR वाली row का मतलब DPR retriever के ऊपर बना पूरा QA system है, जो passage में से जवाब का टुकड़ा उठाता है। RAG उसी तरह का retriever लेकर जवाब खुद लिखता है, और 41.5 से 44.5 पर पहुँचता है। RAG-Token, RAG-Sequence से सिर्फ़ 0.4 पीछे है।
RAG ने retriever को सवाल-जवाब के जोड़ों से सिखाया, लेकिन इसके लिए generator के parameters भी बदले। आज आप LLM अक्सर किसी company की API से लेते हैं, जैसे GPT या Gemini, और उसके parameters नहीं बदल सकते। Lesson 6 इसी हालत से शुरू होता है।
गहरे version में और क्या है
गहरे version में ये पूरा lesson है, और उसके बाद 5 पड़ाव और, जो Stanford की slides के level तक ले जाते हैं:
पड़ाव 6: training के नियम का गणित। दर, ∂, जवाब देखने के बाद वाला वज़न (posterior), और score पर loss की दर = prior − posterior।
पड़ाव 7: एक loss से generator और query encoder की दरें, passage encoder क्यों नहीं बदलता, और paper के retriever वाले experiments।
पड़ाव 8: RAG-Sequence और RAG-Token गहराई से: हर token पर बदलता posterior, Thorough और Fast decoding, और K का असर।
पड़ाव 9: paper का असली पैमाना और पूरी results table, चारों datasets के साथ।
पड़ाव 10: Stanford की RAG वाली छह slides, जिन्हें आप खुद पढ़ते हैं।
RAG passage को छिपा हुआ choice मानता है, और top-K passages पर वज़न वाला जोड़ लगाता है: p(y|x) ≈ ∑ pη(z|x) · pθ(y|x, z)। इसलिए training को सही passage के labels नहीं चाहिए।
RAG-Sequence पूरा जवाब एक passage से लिखकर जोड़ता है, और RAG-Token हर token पर जोड़ता है। जवाब के हिस्से अलग passages में हों, तो RAG-Token को ज़्यादा probability मिलती है, जैसे 0.355 बनाम 0.288।
एक loss से query encoder और generator, दोनों सीखते हैं, और passage encoder और index वैसे ही रहते हैं। जिस passage के साथ सही जवाब कुल chance से ज़्यादा probability पाता है, training उसका score बढ़ाती है।
इस lesson के नए शब्द
RAG
Retrieval-Augmented Generation: retriever और generator को एक model में जोड़कर एक ही loss से साथ train करना। जैसे queue log लाकर उससे Thursday 9am लिखना।
Latent variable
छिपा हुआ choice, जो data में नहीं लिखा। RAG में ये choice है कि जवाब किस passage से आया। जैसे सवाल-जवाब के जोड़े में ये नहीं लिखा कि जवाब queue log से आया।
η और θ
Retriever (eta) और generator (theta) के parameters के नाम। इसीलिए retriever को pη(z|x) लिखते हैं, और generator को pθ(y|x, z)।
BERT
Google का 2018 का encoder model। RAG के retriever के दोनों encoders, query encoder और passage encoder, इसी से बने हैं।
MIPS
Maximum inner product search: index में सबसे बड़े dot product वाले K passages ढूँढना। जैसे 2.1 करोड़ passages में से सबसे ऊँचे 5 scores वाले passages।
Generator
सवाल और एक passage पढ़कर जवाब लिखने वाला model, pθ(y|x, z)। RAG में ये BART है। जैसे queue log के साथ Thursday 9am को 0.9।
Encoder-decoder
Encoder input के vectors बनाता है, और decoder उन्हें देखकर एक-एक token लिखता है। BART ऐसा model है।
Concatenate
दो texts को आगे-पीछे जोड़कर एक text बनाना। जैसे question: … के बाद passage: … जोड़ना।
RAG-Sequence
हर passage के साथ पूरा जवाब, फिर वज़न वाला जोड़। जैसे 0.6 × 0.18 + 0.4 × 0.45 = 0.288।
RAG-Token
हर token पर वज़न वाला जोड़, फिर tokens का गुणा। जैसे 0.74 × 0.48 = 0.355।
End-to-end training
एक ही loss से सारे हिस्सों को साथ train करना। RAG में query encoder और generator, दोनों उसी −ln p(y|x) से सीखते हैं। जैसे −ln 0.70 = 0.357।
Backpropagation
Loss से पीछे की तरफ़ चलकर हर parameter का gradient निकालने का तरीका, छोटे में backprop। RAG में ये generator और query encoder तक जाता है, passage encoder तक नहीं।
Exact Match
जवाब सही जवाब से हूबहू मिले, तभी सही। Score ऐसे सवालों का % है। जैसे NQ पर RAG-Sequence का 44.5।
Closed book और open book
सिर्फ़ parameters से जवाब, या पहले documents में ढूँढकर जवाब। जैसे NQ पर closed book T5-11B 34.5, और open book RAG-Sequence 44.5।