Retrieval वो step है, जो सवाल आने पर आपके documents में से काम के टुकड़े ढूँढता है, ताकि LLM उन्हें पढ़कर जवाब लिखे। ये काम दो हिस्से करते हैं: retriever टुकड़े ढूँढता है, और reader उन्हें पढ़कर जवाब लिखता है।
इसकी ज़रूरत lesson 1 में दिखी थी। Queue log की एक line में रखते ही Thursday की probability 0.21 से 0.81 हो गई, लेकिन वो line हमने खुद चुनी थी। अब एक company सोचिए, जिसके पास 2,000 documents हैं, और हर document में करीब 30 paragraphs, यानी 2,000 × 30 = 60,000 paragraphs। Lesson 1 वाली में passages के लिए 7,000 tokens की जगह थी। तो 500 tokens वाले 7,000 ÷ 500 = 14 paragraphs ही समाते हैं।
इसलिए किसी program को हर सवाल पर 60,000 में से वो 14 चुनने होंगे, जिनमें जवाब है। ये lesson ऐसा program सबसे सीधे तरीके से बनाता है: शब्द गिनकर। Course के 3 सवालों में से एक पर ये ठीक चलता है। दूसरे पर ये सही और गलत text को बराबर रखता है, और तीसरे पर कुछ नहीं लौटाता।
इस lesson की सीढ़ी
सीढ़ी में 4 पड़ाव हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
पहले से क्या चाहिए: Lesson 1 (token, prompt, context window, parameters, hallucination)। बाकी हर नई चीज़ ये lesson खुद समझाता है। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1Corpus, document और passage: retriever किसमें ढूँढता है
आपके सारे documents के set को corpus कहते हैं, और retriever इसी corpus में ढूँढता है। Corpus की हर एक चीज़ एक document है: एक web page, एक file, या एक email। Corpus का दूसरा नाम collection है।
Retriever पूरा document नहीं लौटाता, क्योंकि prompt में सिर्फ़ 14 टुकड़ों की जगह है, और लंबे document का ज़्यादातर हिस्सा सवाल से जुड़ा नहीं होता। जैसे 40 pages के syllabus में milestone की तारीख 2 lines में होगी। इसलिए retriever एक छोटा टुकड़ा लौटाता है, जैसे एक paragraph, और इसे passage कहते हैं।
जिस सवाल के लिए ढूँढना है, उसे query कहते हैं। इस lesson की पहली query lesson 1 वाली ही है: which office hour is least crowded।
आगे के lessons इसी छोटे corpus पर लौटेंगे। इसमें 6 documents हैं, और हर document से एक passage। हर passage का एक छोटा ID भी है, जैसे P3, ताकि जवाब उसका नाम ले सके। syllabus, queue log, Homework 1 की announcement और project page की बातें slides से हैं, office hours page और पुराना forum post मेरे बनाए
ID
Passage
P1
Grading. The project milestone is due Week 6, Thursday 11:59pm. Late days may not be applied to the milestone. The final report is due Week 10.Syllabus
P2
Office hours: Tuesday 4pm in Room 104 and Thursday 9am on Zoom, run by the TAs.Office hours page
P3
Queue log, last 3 weeks: Tuesday 4pm office hour averaged 14 students waiting; Thursday 9am office hour averaged 3.Queue log
P4
Old forum post (2024): midweek afternoons are usually the least crowded time to visit.पुराना forum post
P5
Homework 1 will be released on Oct 5.Homework 1 की announcement
P6
Project proposal due on Oct 9. Teams of 1-3 people are recommended.Project page
पहले सोचिए
मान लीजिए syllabus और Homework 1 की announcement एक ही document के दो paragraphs होते। तब documents कितने होते, और passages कितने?
जवाब देखिए
Documents 5, लेकिन passages अब भी 6, और retriever इन्हीं 6 में से चुनता है। Company में भी यही फ़र्क है: 2,000 documents, लेकिन 60,000 passages।
2Retrieval: सवाल आने पर सही passage prompt में रखना
Retrieval का मतलब है: query आने पर corpus से सबसे काम के passages ढूँढना, और उन्हें सवाल के साथ prompt में रखना। तब model को सब कुछ पहले से याद नहीं करवाना पड़ता। Stanford की slide इसे just-in-time कहती है, यानी सही text ठीक सवाल आने के वक्त model के सामने आता है।
हमारी query पर retriever queue log ढूँढता है, और LLM को कुछ ऐसा prompt मिलता है: मेरा example
Answer the question using the passage below. Cite the passage ID. [P3] Queue log, last 3 weeks: Tuesday 4pm office hour averaged 14 students waiting; Thursday 9am office hour averaged 3. Question: Which office hour is least crowded?
जवाब आता है: Thursday 9am, about 3 students ahead of you [P3]. आख़िर का [P3] बताता है कि बात किस passage से आई। जवाब के साथ लिखे उसके source को citation कहते हैं। Citation देखकर आप queue log खोलकर check कर सकते हैं कि बात सच में वहाँ लिखी है।
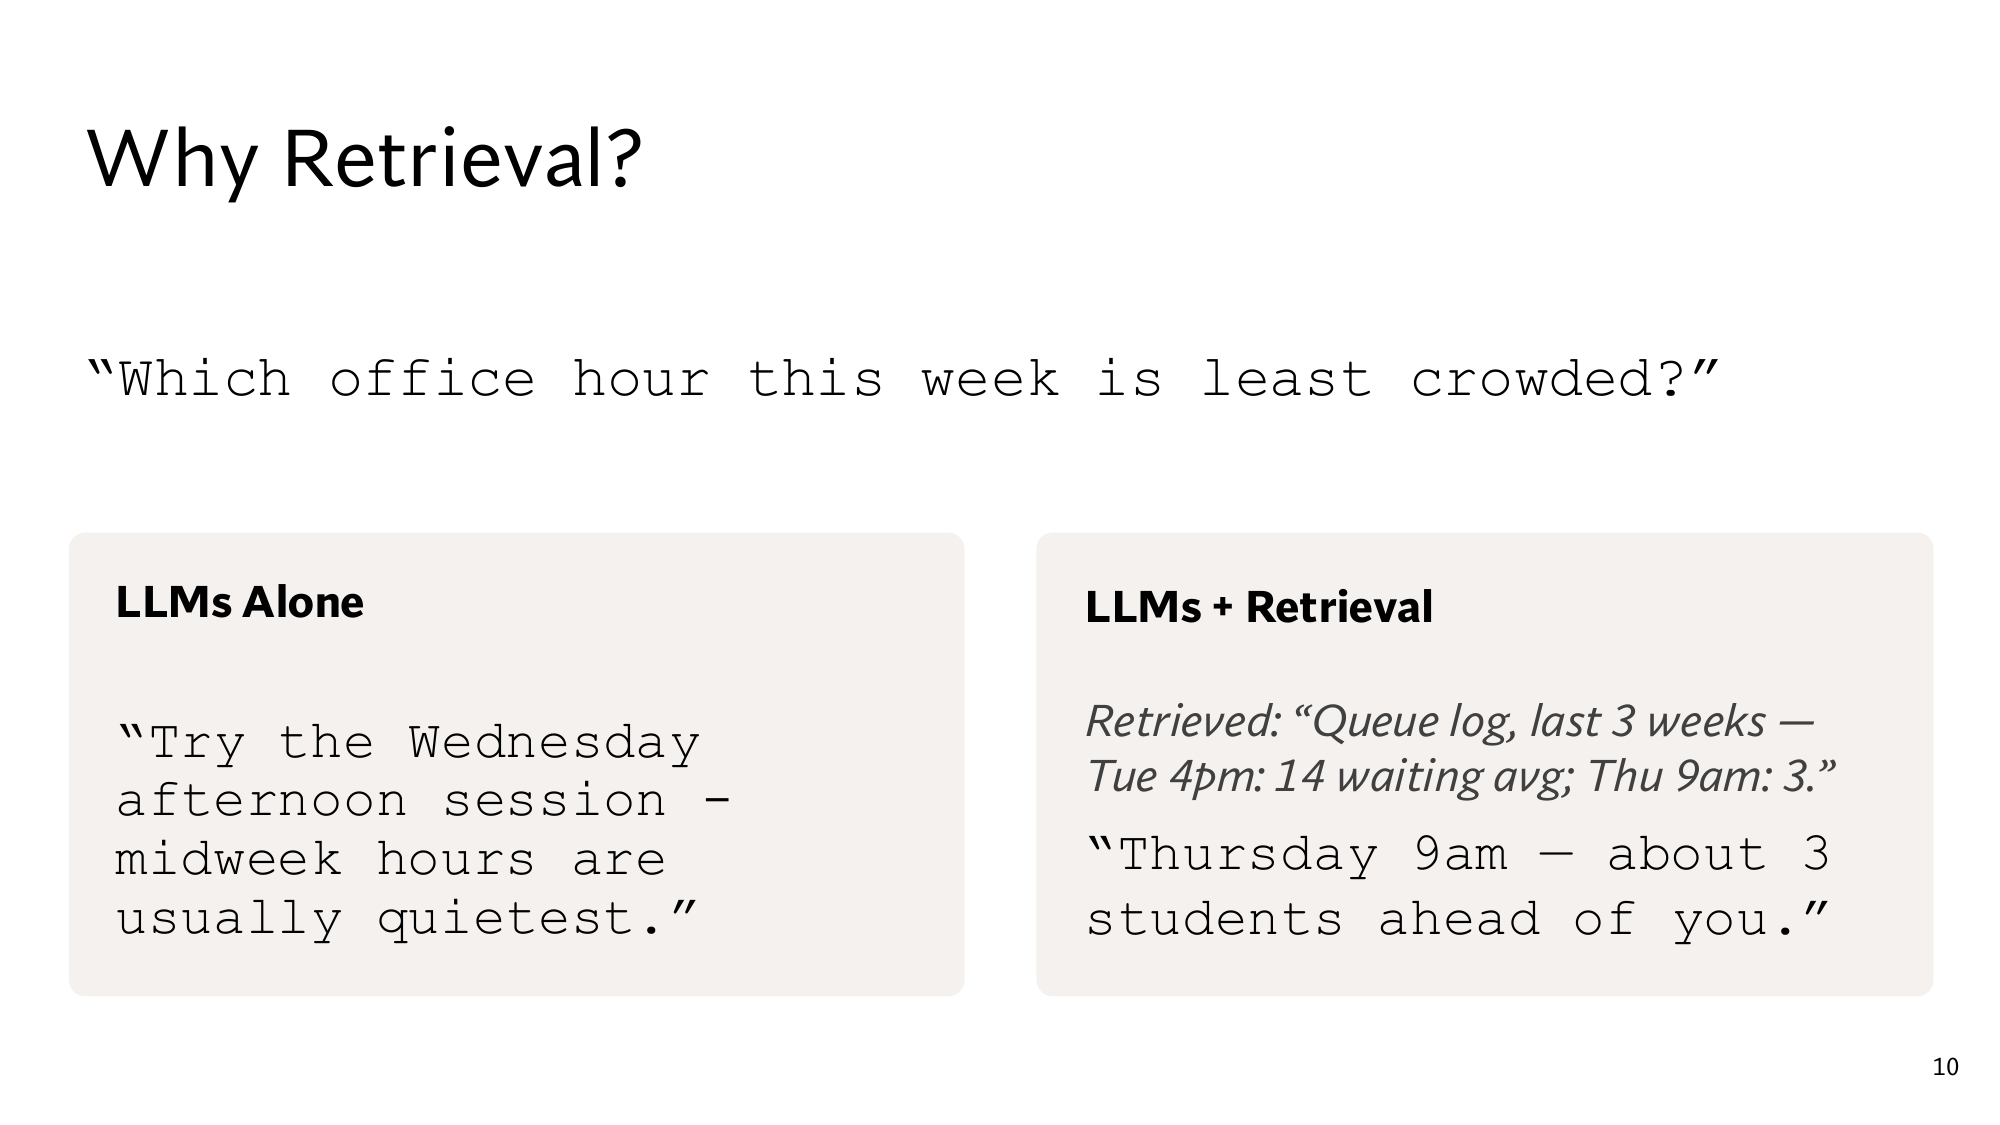
Stanford की Why Retrieval? वाली slide। बाईं तरफ़ अकेले LLM का अंदाज़ा है, और दाईं तरफ़ retriever का लौटाया queue log और उससे लिखा जवाब। Image पर click करने से वो पूरे size में खुलती है।
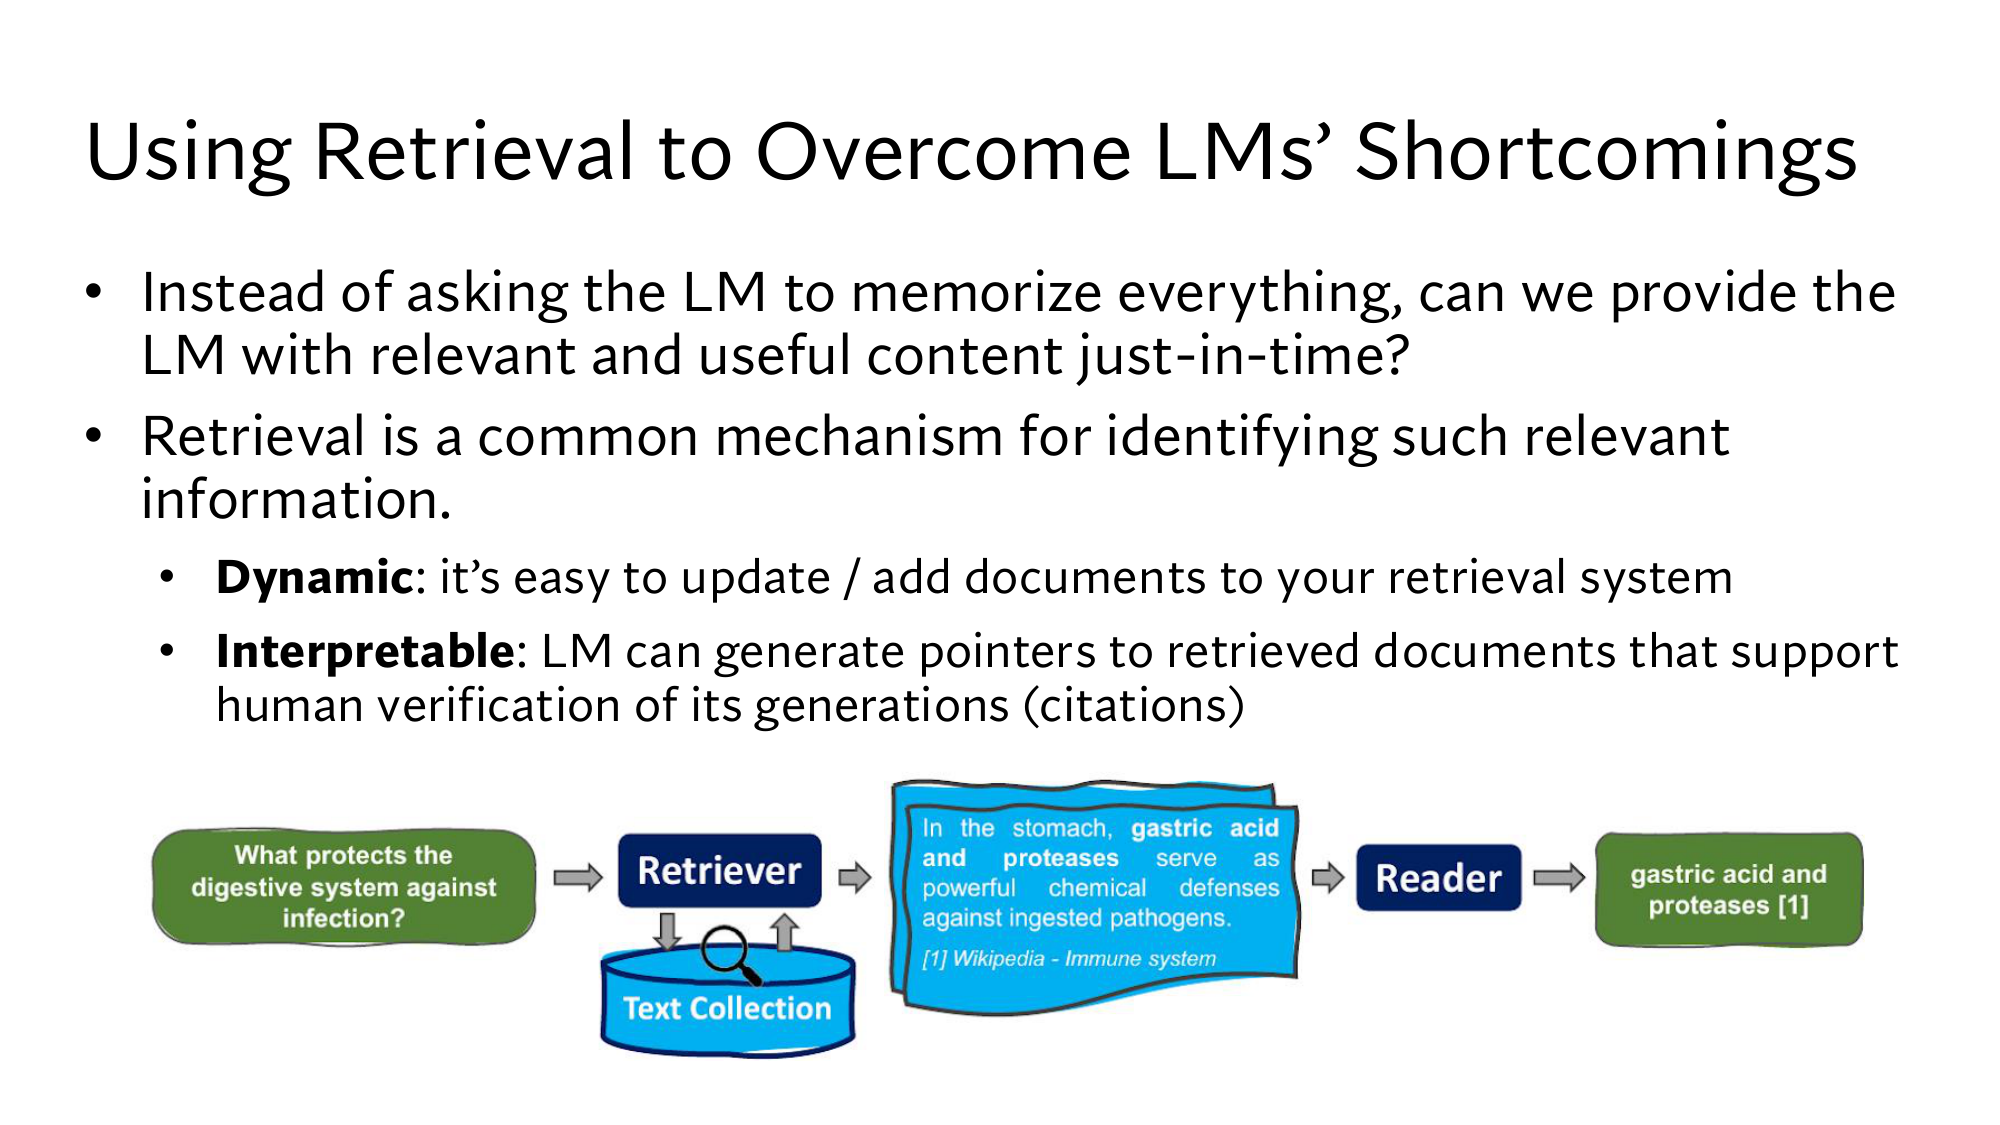
Lesson 1 में model की सारी जानकारी उसके में थी, और इसकी दो दिक्कतें थीं। नई बात डालने के लिए training चाहिए थी, और model अपना source नहीं बता सकता था। Retrieval में नई बात के लिए बस corpus में passage जोड़िए, और source citation से दिखता है। Stanford की slide इन दो फ़ायदों को Dynamic और Interpretable कहती है।
Stanford की slide: just-in-time, Dynamic और Interpretable। नीचे के diagram में reader के जवाब का [1] एक citation है।
Lesson 1 में parameters के अंदर की जानकारी को कहा था। यहाँ जानकारी corpus में है, यानी model के बाहर, और ऐसी जानकारी को non-parametric memory कहते हैं।
लेकिन retrieval उतना ही अच्छा है, जितना ढूँढना। Lesson 1 के आख़िर में दिखा था कि पुराना forum post prompt में हो, तो model फिर Wednesday लिख सकता है। इसलिए अगला पड़ाव ढूँढने का पक्का नियम बनाता है।
3Retriever: हर passage को score, फिर top-K
Retriever हर passage को query के लिए एक score देता है, scores के हिसाब से sort करता है, और ऊपर के K passages लौटाता है। Score एक number है, जो बताता है कि passage query के लिए कितना काम का है।
ऊपर के K passages को top-K कहते हैं। K पहले से तय होता है, जैसे 2 या 100।
सबसे आसान score word overlap है: query के कितने शब्द passage में भी हैं। लेकिन which, is और the जैसे शब्द लगभग हर text में होते हैं, इसलिए उन्हें गिनने से कुछ पता नहीं चलता।
ऐसे बहुत आम शब्दों को stopwords कहते हैं, और retriever गिनने से पहले उन्हें हटा देता है। Query which office hour is least crowded से which और is हटाइए। तब चार शब्द बचते हैं: office, hour, least और crowded।
पहले सोचिए
Queue log में जवाब है, और पुराने forum post में सिर्फ़ 2024 की एक राय। Corpus table में दोनों में ये चार शब्द ढूँढिए। Word overlap किसे ज़्यादा score देगा?
जवाब देखिए
किसी को नहीं, दोनों को 2 मिलता है। Queue log में office और hour हैं, और forum post में least और crowded।
पूरे corpus के scores ये हैं:
Passage
मिले शब्द
Score
Queue log
office, hour
2
पुराना forum post
least, crowded
2
Office hours page
officeRetriever शब्दों को हूबहू मिलाता है, इसलिए hours और hour उसके लिए अलग शब्द हैं।
1
Syllabus, Homework 1 की announcement, project page
कोई नहीं
0
Word overlap सिर्फ़ शब्द गिनता है, इसलिए उसे नहीं दिखता कि queue log तीन हफ़्ते का data है, और forum post 2024 की एक राय। K = 2 पर retriever दोनों लौटाता है। तब prompt में सच्चे data के साथ वो पुरानी राय भी पहुँचती है, जिसके भरोसे model फिर Wednesday लिख सकता है।
Query और top-K passages पढ़कर जवाब लिखने वाले हिस्से को reader कहते हैं। आज reader अक्सर एक LLM होता है, जो इस खास काम पर train नहीं हुआ, बस prompt की instruction पढ़कर काम करता है। ऊपर वाले prompt की पहली line, Answer the question using the passage below, यही instruction है।
Training के बिना, सिर्फ़ instruction से काम करने को zero-shot कहते हैं। Reader अक्सर ऐसा ही LLM रहता है, इसलिए lessons 3 से 15 ज़्यादातर retriever को बेहतर बनाते हैं।
Retriever खुद चलाइए
एक query चुनिए, और K बदलिए। Score 0 वाले passages retriever नहीं लौटाता। Score बराबर हो, तो corpus में पहले लिखा passage ऊपर आता है।
Rank
Passage
Score
खुद निकालिए
Query: when is the project milestone due। Stopwords हटाइए, और syllabus और project page का score निकालिए। K = 1 हो, तो reader को कौन सा passage मिलेगा? Widget में check कीजिए।
जवाब देखिए
बचे शब्द: project, milestone, due। Syllabus में तीनों हैं, इसलिए score 3। Project page में project और due हैं, इसलिए score 2। K = 1 पर reader को syllabus मिलेगा, जिसमें सही तारीख है: Week 6, Thursday 11:59pm।
4Recall ceiling: जो passage नहीं आया, reader उसे नहीं पढ़ता
अब widget में तीसरी query चुनिए: when can I get help from a TA। Stopwords हटाने पर help और ta बचते हैं। जवाब office hours page में है, लेकिन वहाँ TAs लिखा है, ta नहीं, और help किसी passage में नहीं है। इसलिए हर score 0 है, और retriever कुछ नहीं लौटाता। Reader कितना भी अच्छा हो, office hours page उसके prompt तक पहुँचा ही नहीं।
Retriever कितनी बार ज़रूरी passage ढूँढ पाता है, उसे मोटे तौर पर retriever का recall कहते हैं। जैसे 100 सवालों में से 60 पर सही passage top-K में आया, तो recall 60% है। 60% का मतलब है 100 में से 60, यानी 60 ÷ 100 = 0.6। Recall को ठीक-ठीक नापने के तरीके lesson 13 में हैं।
अब reader जोड़िए: सही passage मिलने पर वो 90% सवालों के सही जवाब देता है, यानी हर सवाल पर 0.9। तब 60 सवालों पर 60 × 0.9 = 54 सही जवाब आते हैं। बाकी 100 − 60 = 40 सवालों पर passages से कोई सही जवाब नहीं आता। अब आप reader को बेहतर कर सकते हैं, या retriever को। मेरा example
बदलाव
हिसाब
सही जवाब
अभी
60 × 0.9
54
Reader perfect कर दिया
60 × 1.0
60
Retriever 80 तक ले गए, reader वैसा ही
?
?
तीसरी row आप निकालिए
Retriever अब 80 सवालों पर सही passage लाता है, और reader अब भी 90% सही है। कितने सही जवाब मिलेंगे? Perfect reader से ज़्यादा, या कम?
जवाब देखिए
80 × 0.9 = 72, यानी perfect reader से 72 − 60 = 12 ज़्यादा। Perfect reader भी 60 से आगे नहीं जा सकता, क्योंकि बाकी 40 सवालों पर सही passage उस तक पहुँचा ही नहीं।
Perfect reader 60 पर गुणा के एक नियम की वजह से रुकता है। किसी number को 1 से छोटे number से गुणा करें, तो वो घटता है, जैसे 60 × 0.5 = 30। 1 से गुणा करें, तो वो वैसा ही रहता है, जैसे 60 × 1.0 = 60। Reader का हिस्सा 1 से ज़्यादा नहीं हो सकता, क्योंकि 1 का मतलब है हर सवाल सही।
इसलिए सही जवाब उन 60 सवालों से ज़्यादा नहीं हो सकते, जिन पर retriever सही passage लाया। यानी retriever का recall पूरे system की ऊपरी हद बन जाता है।
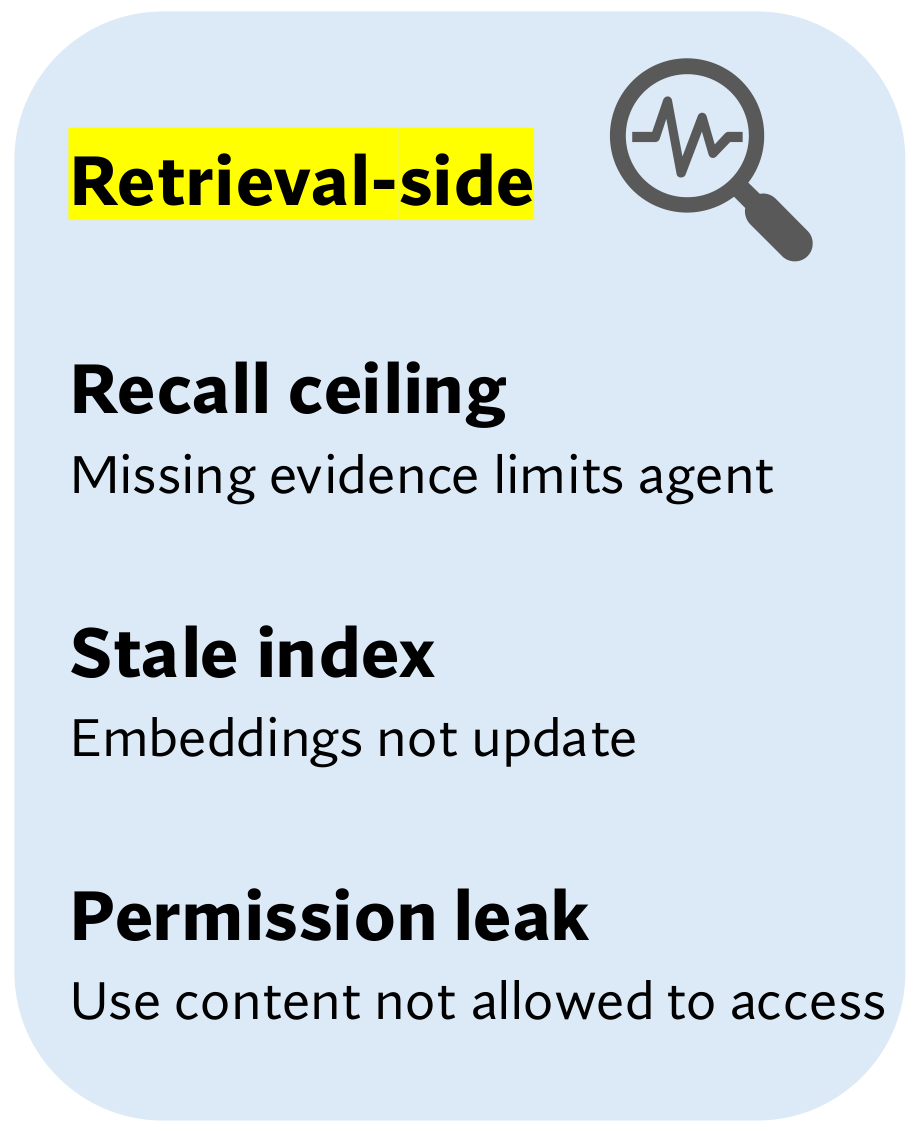
इस हद को recall ceiling कहते हैं, यानी recall की छत। Stanford की slide उसके नीचे लिखती है Missing evidence limits agent, यानी जो सबूत prompt तक नहीं पहुँचा, वो system को रोकता है। Agent lesson 16 में आता है।
Stanford की slide Issues with RAG का retrieval वाला हिस्सा। बाकी दो दिक्कतें lesson 18 में आती हैं।
K बढ़ाने से recall बढ़ता है, लेकिन गलत passages भी साथ आते हैं, जैसे K = 2 पर पुराना forum post। और company वाले prompt में 14 से ज़्यादा passages समाते ही नहीं।
Word overlap 6 passages पर भी दो बार चूका। पहली बार उसने सही और गलत passage को बराबर रखा। दूसरी बार query और passage ने एक बात अलग शब्दों में कही, help from a TA और run by the TAs, और score 0 आया। Lesson 3 यहीं से शुरू होता है: text को ऐसे numbers में बदलना, जिनमें एक जैसी बात कहने वाले texts के numbers पास-पास हों।
गहरे version में और क्या है
गहरे version में ये पूरा lesson है, और उसके बाद 4 पड़ाव और, जो Stanford की slides के level तक ले जाते हैं:
पड़ाव 5: retriever-reader slide के symbols, जैसे f(𝒟, Q), और function का गणित।
पड़ाव 6: DrQA, पूरे Wikipedia पर चलने वाला असली retriever-reader system, और उसका training data।
पड़ाव 7: Recall ceiling, DrQA के असली numbers में, और हमारे corpus पर K बदलने का हिसाब।
पड़ाव 8: इस lesson की Stanford slides, जिन्हें आप खुद पढ़ते हैं।
Retrieval: हर query पर corpus से कुछ passages चुनकर prompt में रखना। इसके लिए training नहीं चाहिए, और जवाब के साथ citation आता है।
Retriever हर passage को score देकर top-K लौटाता है, और reader उन्हें पढ़कर जवाब लिखता है। Word overlap queue log और पुराने forum post को बराबर 2 देता है।
जो passage retriever नहीं लाया, reader उसे कभी नहीं पढ़ता। इसलिए retriever का recall पूरे system की ऊपरी हद है, यानी recall ceiling।
इस lesson के नए शब्द
Corpus (collection)
सारे documents का set। जैसे company के 2,000 documents, या इस course के 6 छोटे texts।
Document
Corpus की एक चीज़: web page, file या email। जैसे course का syllabus।
Passage
Document का छोटा टुकड़ा, जो retriever लौटाता है। जैसे syllabus का वो paragraph, जिसमें milestone की तारीख है।
Query
वो सवाल, जिसके लिए ढूँढना है। जैसे “which office hour is least crowded”।
Retrieval
Query के लिए काम के passages ढूँढकर prompt में रखना। जैसे queue log का passage सवाल के साथ prompt में जाए।
Citation
जवाब के साथ उसका source। जैसे “Thursday 9am [P3]” में [P3], यानी queue log।
Non-parametric memory
Model के बाहर, corpus में रखी जानकारी। जैसे queue log: उसे बदलने के लिए training नहीं चाहिए।
Retriever
हर passage को score देकर top-K लौटाने वाला हिस्सा। जैसे इस lesson का word overlap वाला retriever।
Score
Passage query के लिए कितना काम का है, उसका number। जैसे word overlap में queue log का score 2।
Top-K
सबसे ज़्यादा score वाले K passages। जैसे K = 2 पर queue log और पुराना forum post।
Word overlap
Query के कितने शब्द passage में भी हैं। सबसे आसान score। जैसे queue log में office और hour हैं, तो score 2।
Stopwords
is, the, which जैसे बहुत आम शब्द, जिन्हें गिनती में नहीं लेते। “which office hour is least crowded” से which और is हटते हैं।
Reader
Query और top-K passages पढ़कर जवाब लिखने वाला हिस्सा। आज अक्सर एक LLM। जैसे queue log पढ़कर “Thursday 9am” लिखना।
Zero-shot
उस खास काम पर training के बिना, सिर्फ़ instruction पढ़कर काम करना। जैसे prompt में लिखा “Answer the question using the passage below”।
Recall
Retriever कितनी बार ज़रूरी passage ढूँढ पाता है। जैसे 100 सवालों में 60 पर, तो recall 60%।
Recall ceiling
Retriever का recall पूरे system की ऊपरी हद बन जाता है। Recall 60% है, तो reader कितना भी अच्छा हो, 100 में से 60 से ज़्यादा जवाब passages के दम पर नहीं आते।