Vector numbers की तय लंबाई वाली एक list है। Retriever हर text को vector में बदलता है, और फिर query के vector की हर passage के vector से तुलना करके score देता है। इस तुलना के दो आम तरीके हैं, dot product और cosine similarity, और इस lesson में आप दोनों हाथ से निकालेंगे।
इसकी ज़रूरत lesson 2 के आख़िर में दिखी थी। Query when can I get help from a TA पर ने हर passage को 0 दिया। जवाब office hours page में था: Office hours… run by the TAs। दोनों एक ही बात कहते हैं, लेकिन उनमें एक भी शब्द common नहीं है।
इस lesson की सीढ़ी
सीढ़ी में 4 पड़ाव हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
पहले से क्या चाहिए: Lesson 2 (query, passage, score, top-K, word overlap)। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1Text की numbers वाली list
Vector numbers की तय लंबाई वाली list है, जैसे [0.9, 0.1]। List में कितने numbers हैं, उसे vector का dimension कहते हैं। [0.9, 0.1] का dimension 2 है, और [3, 0, 1, 2] का 4। Retriever को हर passage के लिए एक score चाहिए, और numbers की तुलना आसान है, इसलिए वो हर text को vector में बदलता है।
2 numbers वाले vector को plane पर एक तीर की तरह खींच सकते हैं: पहला number x-axis पर, और दूसरा y-axis पर। Origin (0, 0) से उस point तक का तीर ही vector है, और तीर की दिशा vector की दिशा है।
अब हर passage को हाथ से दो सवालों पर नापिए, और हर जवाब 0 से 2 के बीच दीजिए। पहला number बताता है कि passage मदद या office hours के बारे में कितना है। दूसरा number बताता है कि वो deadlines के बारे में कितना है। Lesson 2 के corpus से तीन passages लीजिए। साथ में एक नया passage जोड़िए: course का लंबा FAQ page, जिसमें office hours और deadlines, दोनों की बहुत बातें हैं। vectors मेरे बनाए हैं
Text
Vector
Office hours page
[0.9, 0.1]
Syllabus: milestone की तारीख
[0.1, 0.9]
Project page: proposal की तारीख
[0.2, 0.8]
Course FAQ, लंबा page
[1.6, 1.4]
Query: when can I get help from a TA
[0.8, 0.2]
Query और office hours page में एक भी common शब्द नहीं है, फिर भी उनके vectors पास-पास हैं: [0.8, 0.2] और [0.9, 0.1]। ये numbers उन दो सवालों के जवाब हैं, और दोनों texts के जवाब लगभग एक जैसे हैं। इसलिए vector वो मेल पकड़ सकता है, जो शब्द गिनने में छूट जाता है।
असली systems में dimensions के ऐसे नाम नहीं होते, और dimension सैकड़ों में होता है, जैसे BERT-base के vectors में 768। paper से यहाँ 2 numbers हैं, ताकि आप vectors को plane पर देख सकें। आगे का हर हिसाब 768 numbers पर भी इसी तरह चलता है।
पहले सोचिए
Passage Extra office hours on Zoom this Friday को इन्हीं दो सवालों पर नापिए। करीब कौन सा vector बनेगा, और वो table के किस passage के पास होगा?
जवाब देखिए
ये passage पूरी तरह office hours के बारे में है, और इसमें कोई deadline नहीं है। तो करीब [0.9, 0.0] जैसा vector बनेगा, जो office hours page [0.9, 0.1] के बिल्कुल पास है।
2Dot product: लंबा vector जीतता है
Dot product दो vectors से एक number बनाता है: एक ही जगह वाले numbers का गुणा कीजिए, फिर सारे गुणा जोड़ दीजिए। Query [0.8, 0.2] और office hours page [0.9, 0.1] के लिए ये 0.8 × 0.9 + 0.2 × 0.1 = 0.72 + 0.02 = 0.74 है। Dot product का दूसरा नाम inner product है, और Stanford की slides यही नाम लेती हैं।
पहले सोचिए
FAQ page [1.6, 1.4] की दिशा query से उतनी नहीं मिलती, जितनी office hours page की। फिर भी उसका dot product 0.74 से कम होगा, या ज़्यादा?
जवाब देखिए
ज़्यादा: 0.8 × 1.6 + 0.2 × 1.4 = 1.28 + 0.28 = 1.56। नीचे की table में बाकी passages भी हैं।
Passage
हिसाब
Dot product
Office hours page[0.9, 0.1]
0.8 × 0.9 + 0.2 × 0.1 = 0.72 + 0.02
0.74
Syllabus[0.1, 0.9]
0.8 × 0.1 + 0.2 × 0.9 = 0.08 + 0.18
0.26
Project page[0.2, 0.8]
0.8 × 0.2 + 0.2 × 0.8 = 0.16 + 0.16
0.32
FAQ page[1.6, 1.4]
0.8 × 1.6 + 0.2 × 1.4 = 1.28 + 0.28
1.56
सबसे ऊपर FAQ page है, क्योंकि उसके दोनों numbers बड़े हैं। FAQ page का vector [0.8, 0.7] का ठीक दोगुना है। [0.8, 0.7] से query का dot product 0.64 + 0.14 = 0.78 है, और FAQ page का 1.56 = 2 × 0.78।
किसी vector को दोगुना करने पर ऐसा हर बार होता है। Dot product के हर गुणा में एक number उसी vector से आता है। वो number दोगुना हुआ, तो हर गुणा दोगुना हुआ, और उनका जोड़ भी। मतलब dot product दिशा के साथ तीर की लंबाई भी नापता है, और लंबा vector सिर्फ़ लंबाई की वजह से ऊपर आ सकता है।
यही हिसाब symbols में ऐसे लिखते हैं:
a · b = ∑i = 1 … daibi
∑ (sigma) का मतलब है कि नीचे लिखी range के हर i के लिए जोड़ते जाइए, यहाँ i = 1 से dimension d = 2 तक। ai query का i-वाँ number है, और bi office hours page का। तो a · b = a1b1 + a2b2 = 0.8 × 0.9 + 0.2 × 0.1 = 0.74।
Dot product तेज़ है, सिर्फ़ d गुणा और d जोड़, और lesson 5 और lesson 12 के retrievers यही score लेते हैं। उसकी हद ऊपर दिख गई: लंबे vector वाला passage ऊपर आ सकता है, चाहे उसकी दिशा उतनी न मिले।
3Cosine similarity: सिर्फ़ दिशा की तुलना
Cosine similarity दो vectors की सिर्फ़ दिशा की तुलना करता है, उनकी लंबाई की नहीं। इसके लिए वो dot product को दोनों vectors की लंबाई के गुणा से भाग देता है। तो पहले लंबाई निकालना सीखिए।
Vector की length
Vector की length उसके तीर की लंबाई है। Plane पर query का तीर एक right triangle की सबसे लंबी side है, जिसकी बाकी दो sides 0.8 और 0.2 लंबी हैं। इसलिए Pythagoras से length √(0.8² + 0.2²) है। मतलब हर number का square लीजिए, सबको जोड़िए, फिर square root लीजिए:
Squares: 0.8 × 0.8 = 0.64, और 0.2 × 0.2 = 0.04।
जोड़: 0.64 + 0.04 = 0.68।
Square root: √0.68 = 0.82। Square root वो number है, जिसे खुद से गुणा करने पर अंदर वाला number मिले। जाँच: 0.8246 × 0.8246 = 0.680।
|a| = √( ∑iai2 )
Office hours page की length इसी तरह √(0.81 + 0.01) = √0.82 = 0.91 है।
Dot product ÷ दोनों lengths
अब dot product को दोनों lengths के गुणा से भाग दीजिए। Query और office hours page के लिए ये 0.74 ÷ (0.82 × 0.91) = 0.99 है। इस number को cosine similarity कहते हैं।
cos(a, b) = a · b|a| × |b|
नाम cosine इसलिए है, क्योंकि ये number दोनों तीरों के बीच के कोण (angle) का cosine है। एक ही दिशा वाले तीरों पर ये 1 है, 90° पर 0, और उल्टी दिशा में −1। Query और office hours page के बीच करीब 8° का कोण है, और cos 8° = 0.99।
वही query, जिसकी length 0.82 है, अब हर passage से:
Passage
Dot product
Length
Cosine
Office hours page[0.9, 0.1]
0.74
0.91
0.990.74 ÷ (0.82 × 0.91)
FAQ page[1.6, 1.4]
1.56
2.13
0.891.56 ÷ (0.82 × 2.13)
Project page[0.2, 0.8]
0.32
0.82
0.470.32 ÷ (0.82 × 0.82)
Syllabus[0.1, 0.9]
0.26
?
?
Lengths 2 decimal तक rounded हैं। Cosine पूरे numbers से निकला है, इसलिए हाथ के हिसाब में आख़िरी अंक थोड़ा अलग आ सकता है।
Syllabus वाली row आप निकालिए
Syllabus = [0.1, 0.9], और query से उसका dot product 0.26 है। Syllabus की length और cosine कितने हैं?
जवाब देखिए
Length = √(0.01 + 0.81) = √0.82 = 0.91। Cosine = 0.26 ÷ (0.82 × 0.91) = 0.35। ये सबसे नीचे है, क्योंकि syllabus deadlines के बारे में है, और query मदद के बारे में।
Cosine में office hours page सबसे ऊपर आया, और FAQ page दूसरी जगह पर गिर गया। FAQ page का vector [0.8, 0.7] का दोगुना है, इसलिए उसकी length भी दोगुनी है: 1.063 की जगह 2.126। Dot product भी दोगुना हुआ था, और भाग में ये 2 कट जाता है। तो cosine पर vector की length का कोई असर नहीं होता, और लंबे page का फ़ायदा चला जाता है।
Normalize: length 1 वाले vectors
एक shortcut भी है। हर vector के हर number को उसकी length से भाग दीजिए, तो उसकी length 1 हो जाती है, और दिशा वही रहती है। इसे normalize करना कहते हैं। Query normalize करने पर [0.8 ÷ 0.8246, 0.2 ÷ 0.8246] = [0.970, 0.243] बनता है, और office hours page [0.994, 0.110]।
Normalize किए vectors का dot product सीधे cosine है, क्योंकि अब नीचे की दोनों lengths 1 हैं: 0.970 × 0.994 + 0.243 × 0.110 = 0.964 + 0.027 = 0.991। इसलिए अगर index के सारे vectors normalize किए हुए हों, तो dot product और cosine एक ही score देते हैं।
Query का तीर खींचिए
Plane पर click कीजिए या खींचिए, तो query का तीर वहाँ चला जाता है। Milestone वाली query पर dot product से FAQ page ऊपर आता है, और cosine से syllabus।
Passage
Vector
Dot product
Cosine
Cosine की भी एक हद है: वो length को पूरी तरह छोड़ देता है, और कभी length में भी काम की बात होती है। दो vectors से similarity का number बनाने के तरीके को similarity metric कहते हैं। कौन सा metric लेना है, ये इस पर टिका है कि vectors बनाने वाले model की training किस metric के साथ हुई।
4Embedding model: हर text का vector अपने आप
ऊपर के vectors हाथ से बने, दो सवाल पूछकर। Lesson 2 की company के 60,000 passages के लिए ये हाथ से नहीं हो सकता, और दो सवाल किसी text की हर बात नहीं पकड़ते। इसलिए ऐसा program चाहिए, जो किसी भी text को अपने आप vector दे।
Embedding किसी text का वो vector है, जो एक trained model बनाता है, ताकि मिलती-जुलती बात वाले texts के vectors की दिशा भी मिलती-जुलती हो। Text पढ़कर embedding बनाने वाले model को embedding model या encoder कहते हैं। Encoder भी lesson 1 वाले से बना है।
Training encoder को ऐसे text जोड़े दिखाती है, जिनकी बात मिलती है, और ऐसे भी, जिनकी नहीं मिलती। फिर वो parameters को इस तरह बदलती है कि पहली तरह के जोड़ों का score बढ़े, और दूसरी तरह के जोड़ों का घटे। ये training पूरी lesson 12 में है।
अब TA वाली query पर लौटिए। Encoder से query का embedding बनाइए, और lesson 2 के passages से cosine निकालिए। नतीजा कुछ ऐसा हो सकता है: numbers मेरे बनाए हैं, किसी असली model के नहीं
Passage
Common शब्द
Cosine
Office hours pageOffice hours: Tuesday 4pm in Room 104 and Thursday 9am on Zoom, run by the TAs.
Homework 1 की announcementHomework 1 will be released on Oct 5.
0
0.22
SyllabusGrading. The project milestone is due Week 6 …
0
0.15
Query और office hours page में एक भी common शब्द नहीं है, फिर भी office hours page 0.78 के साथ सबसे ऊपर है। Lesson 2 का retriever जहाँ हर passage को 0 देता था, embedding वाला retriever वहाँ सही passage ऊपर लाता है।
Offline और online
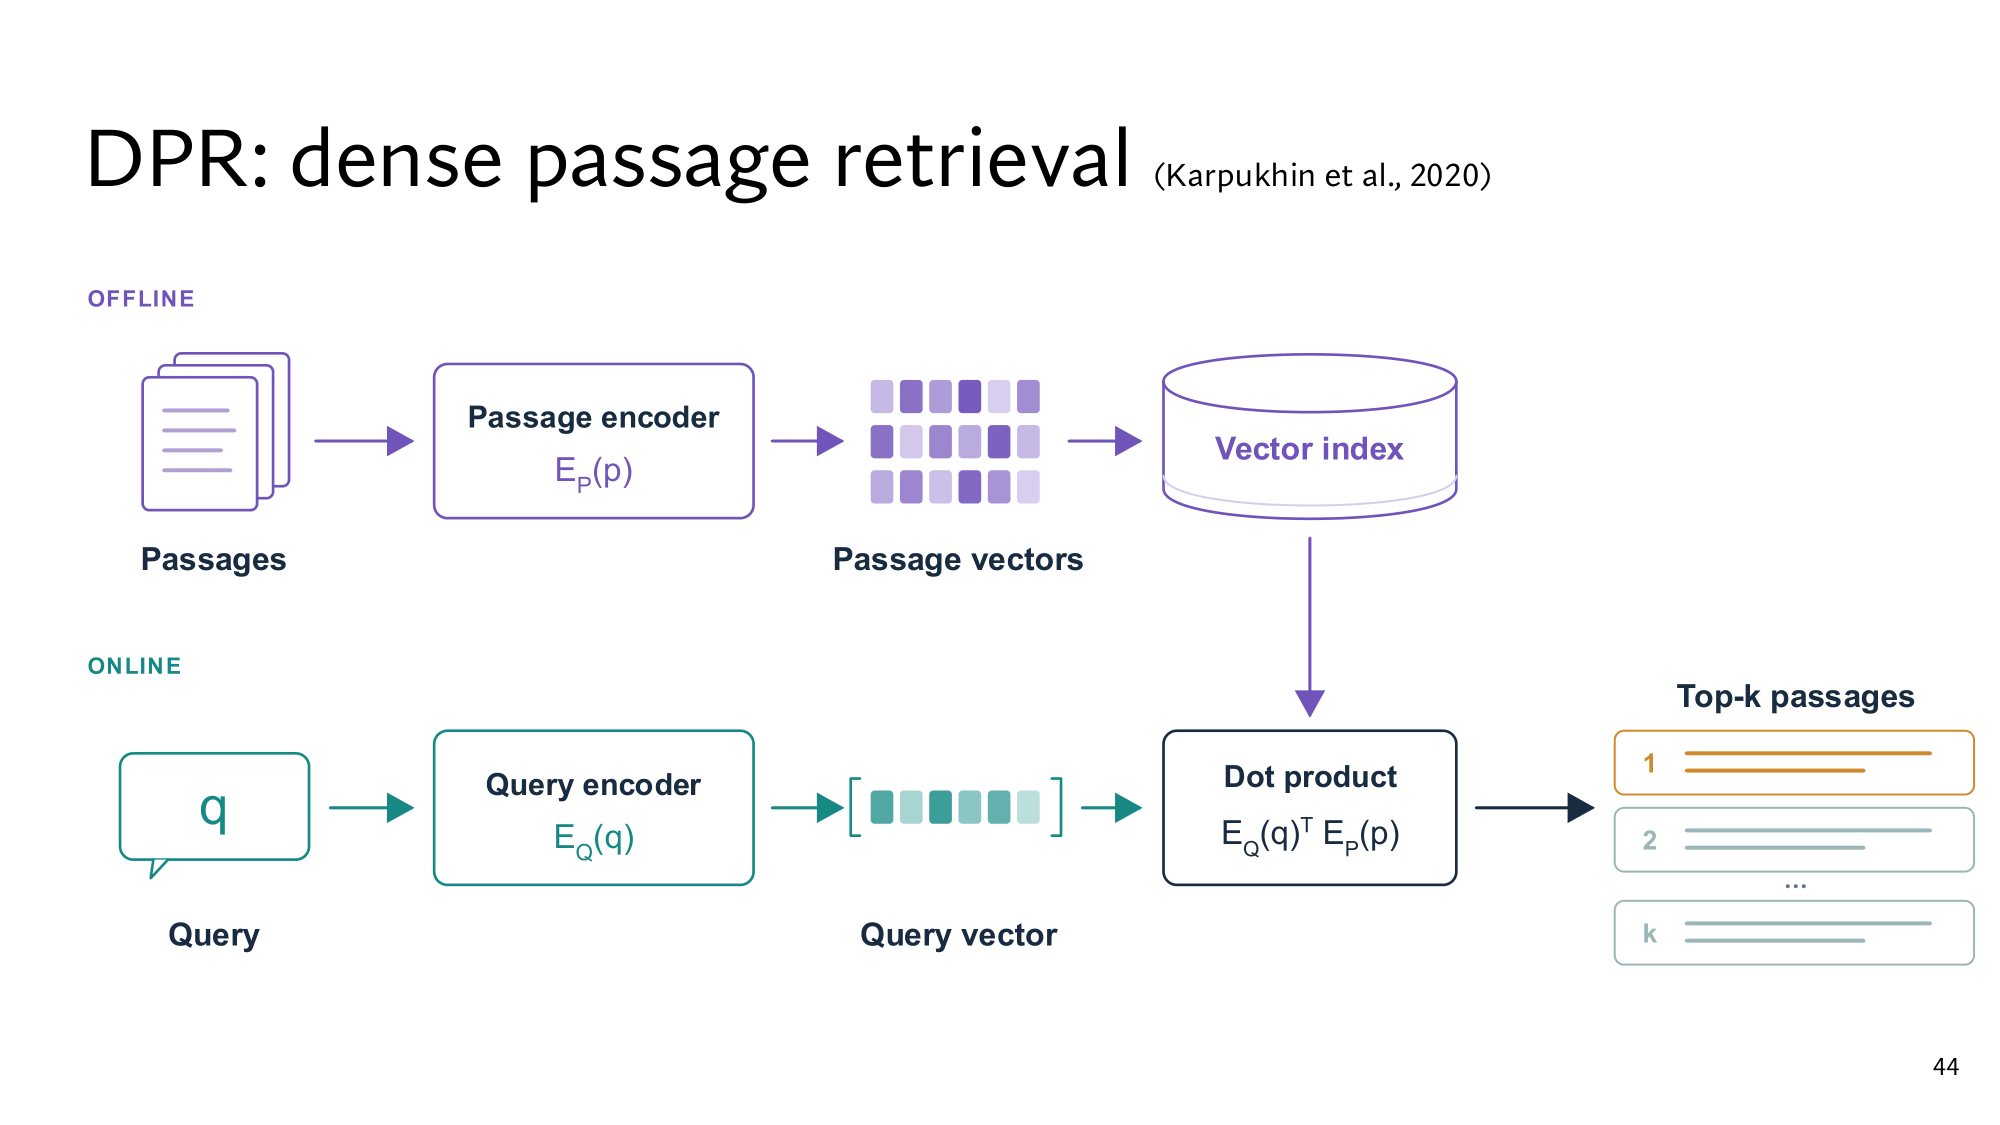
Embedding वाला retriever दो हिस्सों में चलता है। Offline, यानी query आने से पहले, encoder हर passage का embedding एक बार बनाता है। पहले से बनाकर रखे इन embeddings की list को index कहते हैं। Online, यानी हर query पर, encoder सिर्फ़ query का embedding बनाता है। फिर index के हर embedding से उसका cosine या dot product निकलता है, और सबसे ऊँचे scores वाले K passages लौटते हैं।
Stanford की DPR वाली slide यही दो हिस्से दिखाती है। Lesson 12 के DPR में दो अलग encoders हैं: EP passages के लिए, और EQ query के लिए। Slide के box में लिखा EQ(q)⊤ EP(p) दोनों vectors का dot product है, और उसे लिखने का एक तरीका है।
Stanford की slide: DPR का offline हिस्सा ऊपर, और online हिस्सा नीचे। Image पर click करने से वो पूरे size में खुलती है।
Embedding वाले retriever की दो हदें आगे आएँगी। पहली, वो हूबहू मिलने वाली चीज़ें चूक सकता है: error code E-4012 और E-4021 वाले passages के embeddings लगभग एक जैसे हो सकते हैं। इसका हल lesson 14 में है। दूसरी, हर query पर index के हर embedding से तुलना होती है, यानी 60,000 passages पर 60,000 cosine। करोड़ों passages पर ये धीमा है, और इसका हल lesson 10 में है।
पहले सोचिए
Corpus में नया passage जुड़े, तो embedding वाले retriever में क्या करना होगा?
जवाब देखिए
Encoder सिर्फ़ उस passage का embedding बनाता है, और आप उसे index में जोड़ देते हैं। बाकी index वैसा ही रहता है। हर query पर तब भी सिर्फ़ query का embedding नया बनता है।
गहरे version में और क्या है
गहरे version में ये पूरा lesson है, और उसके बाद 5 पड़ाव और, जो Stanford की slides के level तक ले जाते हैं:
पड़ाव 5: cosine कोण का cosine क्यों है, और −1 से 1 के बीच ही क्यों रहता है।
पड़ाव 6: dot product, cosine और दूरी का रिश्ता, और DPR paper ने dot product क्यों चुना।
पड़ाव 7: matrix और transpose, यानी पूरे index के scores एक गुणा में।
पड़ाव 8: Stanford की table के पाँच तरह के embeddings, और एक vector में rare error code क्यों दब जाता है।
पड़ाव 9: Stanford की तीनों slides, जिन्हें आप खुद पढ़ते हैं।
Vector numbers की तय लंबाई वाली list है। दो vectors की तुलना dot product या cosine similarity से होती है।
Dot product दिशा के साथ length भी नापता है, इसलिए लंबा FAQ page 1.56 के साथ ऊपर आया। Cosine सिर्फ़ दिशा देखता है, और normalize किए vectors पर दोनों एक ही score देते हैं।
Embedding model हर text का vector अपने आप बनाता है, ताकि मिलती-जुलती बात वाले texts की दिशा मिलती-जुलती हो। Passages के embeddings offline index में रहते हैं, और हर query पर सिर्फ़ query का embedding बनता है।
इस lesson के नए शब्द
Vector
तय लंबाई वाली numbers की list, जैसे [0.9, 0.1]। 2 numbers हों, तो plane पर एक तीर।
Dimension
Vector में कितने numbers हैं। जैसे [0.9, 0.1] का dimension 2 है, और BERT-base के vectors का 768।
Dot product (inner product)
एक ही जगह वाले numbers का गुणा, फिर सबका जोड़। जैसे [0.8, 0.2] और [0.9, 0.1]: 0.72 + 0.02 = 0.74।
∑ (sigma)
नीचे लिखी range पर जोड़ते जाइए। जैसे i = 1 से 2 तक aibi का जोड़, यानी a1b1 + a2b2।
Length
तीर की लंबाई: हर number का square, उनका जोड़, फिर square root। जैसे [0.8, 0.2] की length √(0.64 + 0.04) = 0.82।
Cosine similarity
Dot product ÷ दोनों lengths का गुणा। सिर्फ़ दिशा देखता है, −1 से 1 के बीच। जैसे 0.74 ÷ (0.82 × 0.91) = 0.99।
Normalize
Vector के हर number को उसकी length से भाग देकर length 1 बनाना। दिशा वही रहती है। जैसे [0.8, 0.2] ÷ 0.82 = [0.97, 0.24]।
Embedding
Trained model से बना text का vector। मिलती-जुलती बात वाले texts की दिशा मिलती-जुलती होती है, जैसे “help from a TA” और “run by the TAs”।
Embedding model (encoder)
Text पढ़कर तय लंबाई का embedding बनाने वाला model। जैसे query को [0.8, 0.2] जैसा vector देना।
Index
Passages के पहले से बनाकर रखे embeddings की list। जैसे 60,000 passages के 60,000 vectors।
Offline और online
Offline: query आने से पहले, एक बार, जैसे passages के embeddings बनाना। Online: हर query पर, जैसे query का embedding।