Hybrid search दो retrievers की ranked lists को मिलाकर एक list बनाता है। Reranking उस list के ऊपर वाले passages को एक धीमे लेकिन ज़्यादा सटीक model से दोबारा sort करता है।
BM25 ने E2 को तीसरे rank पर रखा, dense ने पहले। Query थी E-4012 upload failed, और उसके दो सही passages हैं। E1 में यही error code हूबहू लिखा है, और E2 में वही बात अलग शब्दों में। Lesson 12 इसी बात पर ख़त्म हुआ था कि की ताकत और कमज़ोरी dense retriever से उल्टी है।
इस lesson की सीढ़ी
सीढ़ी में 5 पड़ाव हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
Shortlist पर rerankingReranking का समय निकाल पाएँगे, और बता पाएँगे कि reranker recall क्यों नहीं बढ़ा सकता।
पहले से क्या चाहिए: Lesson 3 (embedding, cosine), Lesson 6 (fusion, rerank), Lesson 11 (BM25), Lesson 12 (bi-encoder, DPR) और Lesson 13 (MRR)। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1BM25 और dense retriever अलग-अलग passages चूकते हैं
BM25 और dense retriever अलग तरह के text पर चूकते हैं, इसलिए एक ही query पर दोनों अलग सही passages छोड़ते हैं। BM25 एक जैसे शब्द गिनता है, और dense retriever, जैसे , दोनों के की तुलना करता है।
BM25 तब चूकता है, जब passage वही बात दूसरे शब्दों में कहे, और इसे paraphrase कहते हैं। जैसे query में upload failed है, और passage में upload keeps failing। BM25 के लिए failing और failed अलग शब्द हैं, इसलिए उसे सिर्फ़ upload मिलता है।
Dense retriever तब चूकता है, जब कोई चीज़ हूबहू मिलनी चाहिए, जैसे error code या order ID। ऐसे text को literal कहते हैं। Lesson 3 में दिखा था कि E-4012 और E-4021 वाले passages के embeddings लगभग एक जैसे हो सकते हैं। BM25 के लिए 4012 एक rare शब्द है, जिसका IDF ऊँचा है, इसलिए वो सही passage पकड़ लेता है।
अब तीन passages पर दोनों retrievers का क्रम देखिए: मेरा example
Passage
सही?
BM25
Dense
E1, error code वालाError E-4012: file larger than 50 MB. Compress the file and upload again.
हाँ
Rank 14012 हूबहू मिला
Rank 2
E2, अलग शब्दों वालाIf your upload keeps failing on Gradescope, make the file smaller before submitting.
हाँ
Rank 3सिर्फ़ upload मिला
Rank 1vector सबसे पास
E3, दूसरे error वालाError E-4021: submission locked after the deadline.
नहीं
Rank 2E- वाला code, छोटा passage
Rank 3
Top-1 पर BM25 सिर्फ़ E1 लाता है, और dense सिर्फ़ E2। दोनों अलग-अलग सही passage चूकते हैं, इसलिए दोनों की lists मिलाने पर दोनों सही passages ऊपर आ सकते हैं।
असली data पर भी यही दिखता है। Lesson 12 में SQuAD पर top-20 accuracy BM25 की 68.8% थी, और DPR की 63.2%। उसी Stanford slide पर दोनों को मिलाकर बना retriever 71.5% पर है, यानी दोनों से आगे।
पहले सोचिए
Query है refund policy for order #A77-310। इसका कौन सा हिस्सा BM25 पकड़ेगा, और कौन सा dense retriever?
जवाब देखिए
BM25 rare literal A77-310 को हूबहू पकड़ेगा। Dense retriever refund policy को money back rules वाले passage से भी मिला सकता है, जिसमें एक भी शब्द एक जैसा नहीं है।
2Hybrid search, और scores का सीधा जोड़
Hybrid search दोनों retrievers चलाता है, और उनकी दो ranked lists को मिलाकर एक list बनाता है। Lists मिलाने को lesson 6 में कहा था। सबसे सीधा तरीका ये है कि हर passage के दोनों scores जोड़ दें: BM25 का score, और dense retriever का । scores मेरे बनाए हैं
पहले सोचिए
E1, E3 और E2 के BM25 scores 7.2, 3.1 और 1.0 हैं, और cosine 0.79, 0.75 और 0.82। दोनों जोड़ें, तो dense का पहला passage E2 किस rank पर आएगा?
जवाब देखिए
तीसरे rank पर, सबसे नीचे। हिसाब नीचे की table में है।
Passage
BM25 score
Cosine
सीधा जोड़
E1
7.2
0.79
7.99
E3 (गलत)
3.1
0.75
3.85
E2
1.0
0.82
1.82
जोड़ के बाद क्रम E1, E3, E2 है, यानी ठीक BM25 वाला। इसकी वजह दोनों scores का पैमाना है। Cosine 0.75 से 0.82 तक फैला है, यानी सिर्फ़ 0.07, और BM25 1.0 से 7.2 तक, यानी 6.2।
BM25 का फैलाव cosine से करीब 90 गुना है, इसलिए जोड़ में cosine का असर लगभग गायब हो जाता है। Cosine हमेशा −1 और 1 के बीच रहता है, जबकि BM25 की कोई ऊपरी हद नहीं है। BM25 को किसी number से भाग दे सकते हैं, लेकिन वो number हर corpus पर अलग होगा, और उसे हर बार ढूँढना पड़ेगा।
3Reciprocal rank fusion: scores की जगह ranks मिलाना
Scores के पैमाने अलग हैं, लेकिन ranks का पैमाना हर retriever में एक है: पहला, दूसरा, तीसरा। Reciprocal rank fusion, यानी RRF, हर list में passage के rank से 1 ÷ (60 + rank) बनाता है, और सारी lists के ये numbers जोड़ता है। फिर passages इसी जोड़ के क्रम में लगते हैं।
E1 BM25 की list में rank 1 पर है, तो उसे 1 ÷ (60 + 1) = 1 ÷ 61 = 0.01639 मिलता है, यानी करीब 0.0164। Dense की list में वो rank 2 पर है, तो 1 ÷ 62 = 0.01613। E1 का RRF इनका जोड़ है: 0.01639 + 0.01613 = 0.03252।
Passage
BM25 से
Dense से
जोड़
E1
1 ÷ (60 + 1) = 0.01639
1 ÷ (60 + 2) = 0.01613
0.03252
E2
1 ÷ (60 + 3) = 0.01587
1 ÷ (60 + 1) = 0.01639
0.03227
E3 (गलत)
1 ÷ (60 + 2) = 0.01613
1 ÷ (60 + 3) = 0.01587
0.03200
नया क्रम E1, E2, E3 है। दोनों सही passages ऊपर आ गए, और E3 नीचे गया, क्योंकि वो किसी list में सबसे ऊपर नहीं था।
तीनों जोड़ पास-पास हैं, और इसकी वजह fraction का बर्ताव है। 1 ÷ (60 + rank) का नीचे वाला हिस्सा बढ़े, तो fraction घटता है। लेकिन 61 से 62 होने पर नीचे वाला हिस्सा सिर्फ़ 1.6% बढ़ता है, इसलिए fraction भी करीब 1.6% ही घटता है। इसलिए RRF के numbers पास-पास रहते हैं, और उनमें सिर्फ़ क्रम काम का है।
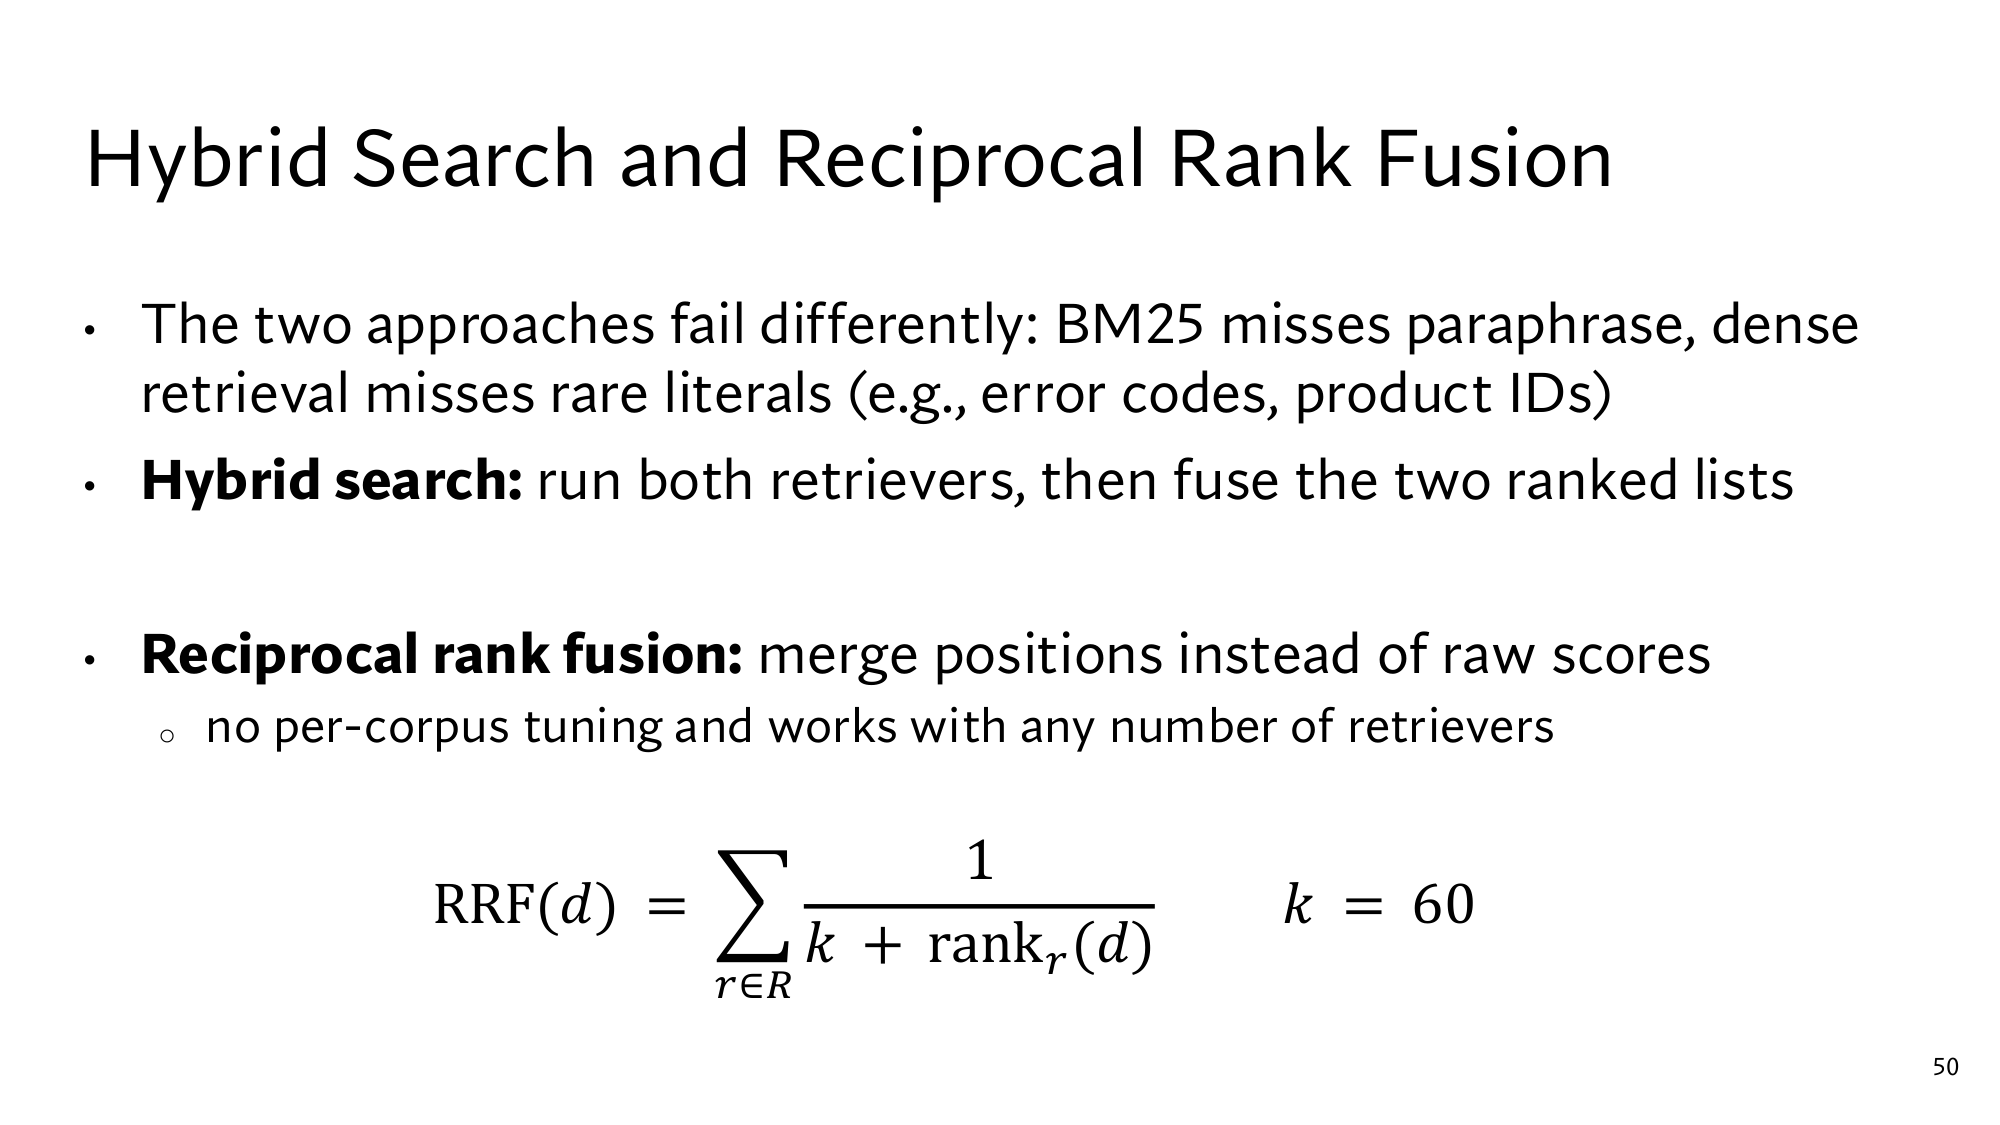
Stanford की slide यही हिसाब एक formula में लिखती है:
RRF(d) = ∑r ∈ R1k + rankr(d), k = 60
d
एक passage, जैसे E1।
R
Retrievers का set, यहाँ {BM25, dense}। के नीचे r ∈ R का मतलब है: R के हर retriever r का जोड़।
rankr(d)
Retriever r की list में d का rank। E1 के लिए BM25 में 1, और dense में 2। जिस list में d नहीं है, वहाँ से कुछ नहीं जुड़ता।
k
एक तय number, 60। ये top-k वाला k नहीं है।
Stanford की slide: Hybrid Search and Reciprocal Rank Fusion। पहली line पड़ाव 1 है, दूसरी पड़ाव 2, और नीचे RRF का formula। छोटी line कहती है कि RRF को हर corpus पर tuning नहीं चाहिए, और वो कितने भी retrievers के साथ चलता है। Image पर click करने से वो पूरे size में खुलती है।
k = 60 का काम
k = 60 rank 1 और rank 2 का फ़र्क छोटा कर देता है, इसलिए किसी एक list का rank 1 अकेले फ़ैसला नहीं करता। k = 0 पर rank 1 को 1 मिलता, और rank 2 को 0.5, यानी आधा। k = 60 पर दोनों को 0.01639 और 0.01613 मिलते हैं।
मान लीजिए passage A सिर्फ़ BM25 की list में है, rank 1 पर, और B दोनों lists में rank 3 पर: मेरा example
k = 0 पर A को 1 ÷ 1 = 1 मिलता है, और B को 1 ÷ 3 + 1 ÷ 3 = 0.667। A जीतता है।
k = 60 पर A को 1 ÷ 61 = 0.0164 मिलता है, और B को 1 ÷ 63 + 1 ÷ 63 = 0.0317। B जीतता है।
मतलब k = 60 पर वो passage जीतता है, जिसे दोनों retrievers ऊपर के आस-पास रखते हैं।
k खुद बदलिए
A एक list में rank 1 पर है, और B दोनों lists में rank r पर। k और r बदलकर देखिए कि B कब तक आगे रहता है।
Passage
हिसाब
RRF
पहले सोचिए
Lesson 6 में original query की list थी: queue log, forum post, office hours page। Rewrite की हुई query की list थी: office hours page, queue log। RRF से क्रम क्या बनता है?
जवाब देखिए
Queue log: 1 ÷ 61 + 1 ÷ 62 = 0.03252। Office hours page: 1 ÷ 63 + 1 ÷ 61 = 0.03227। Forum post सिर्फ़ पहली list में है: 1 ÷ 62 = 0.01613। क्रम queue log, office hours page, forum post है।
RRF की कीमत ये है कि वो score की ताकत भूल जाता है। E1 का BM25 score 7.2 हो या 70, rank 1 दोनों बार 1 ÷ 61 ही देता है।
4Cross-encoder: query और passage को साथ पढ़ना
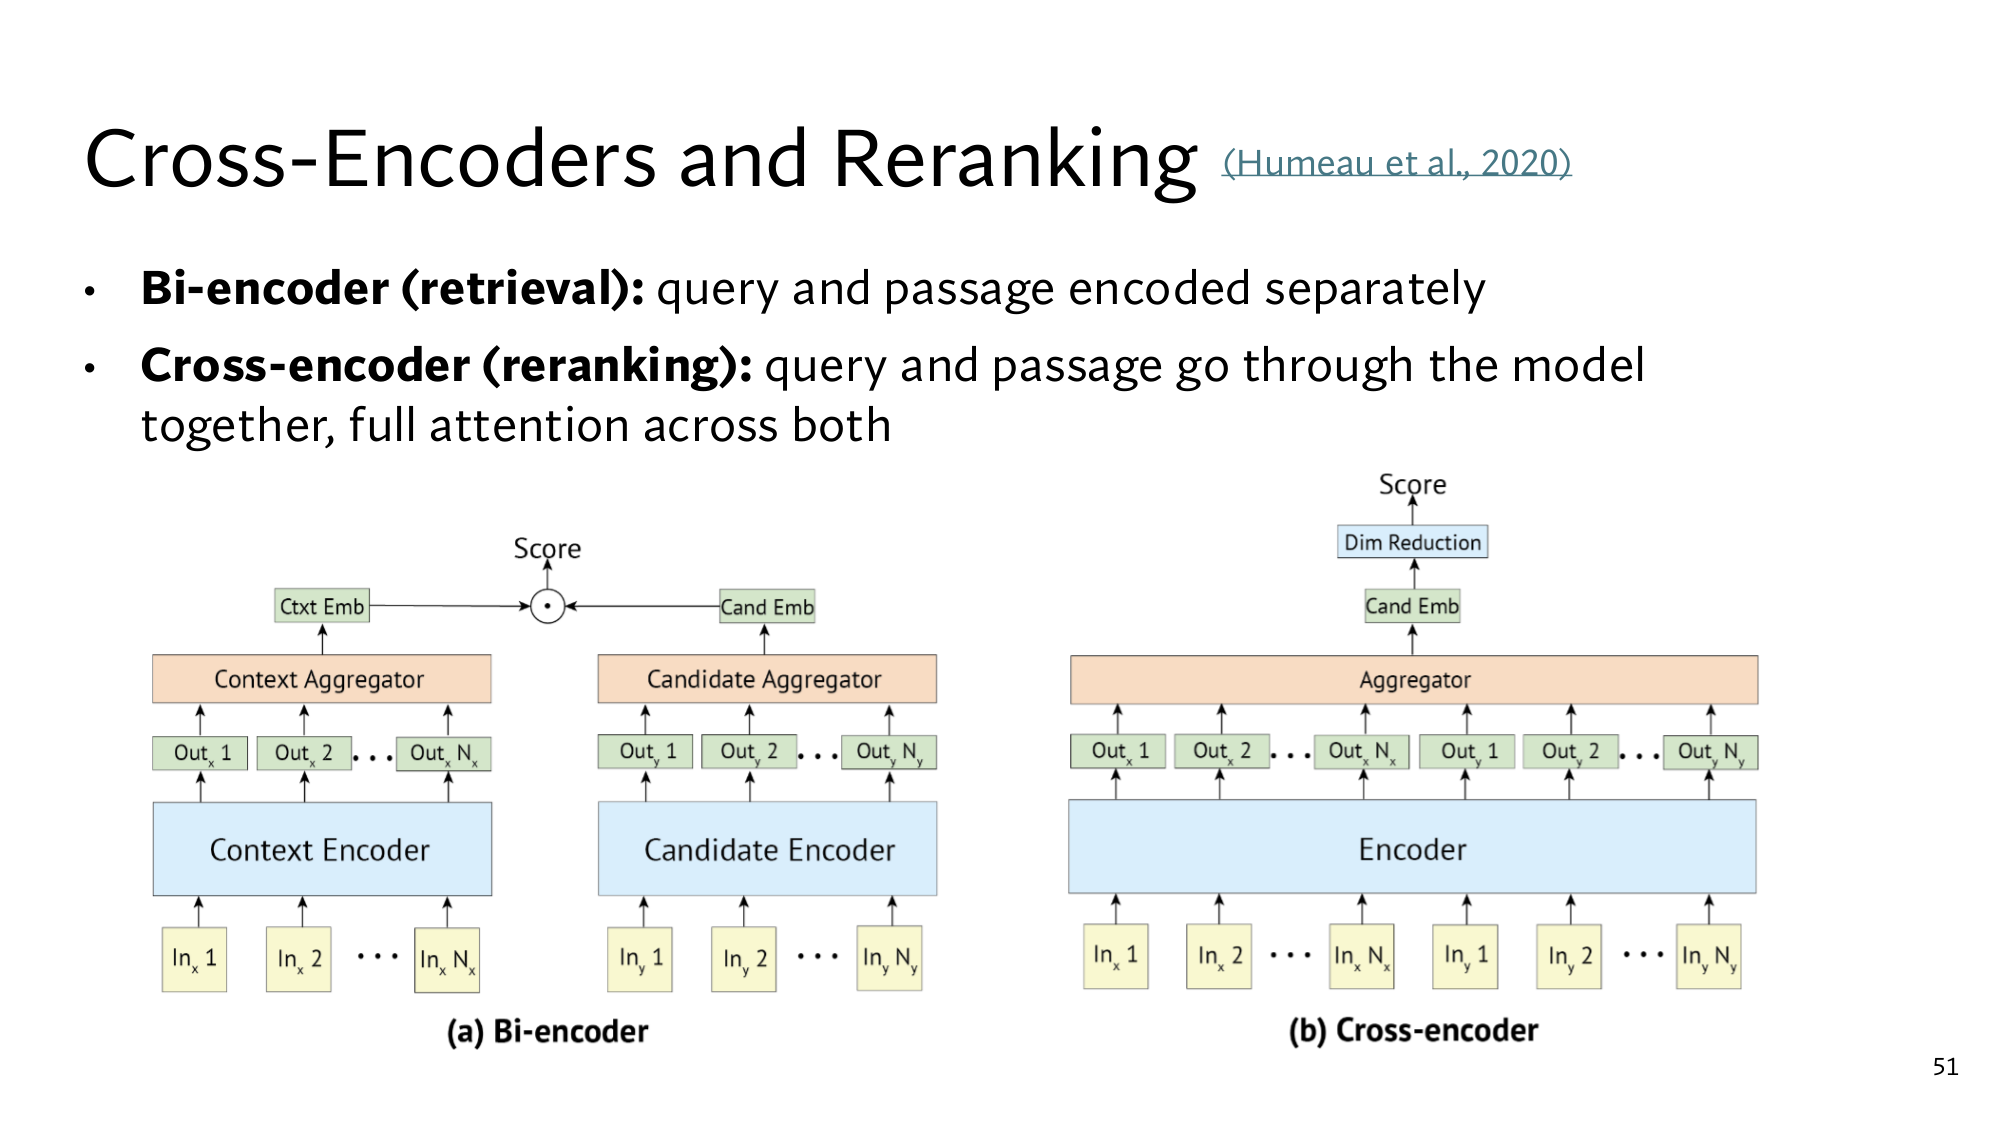
RRF की list में E1 और E2 सिर्फ़ इसलिए ऊपर हैं कि दोनों retrievers सहमत थे। किसी ने query और passage को साथ नहीं पढ़ा। में passage का vector सवाल आने से पहले बन जाता है, और दोनों सिर्फ़ आख़िरी dot product पर मिलते हैं।
Cross-encoder query और passage को जोड़कर एक ही text की तरह एक model में डालता है, और उस जोड़ी का सीधा एक score देता है। ये model आम तौर पर जैसा encoder होता है।
Attention: हर token दूसरे tokens से अपना vector बदलता है
Encoder हर का एक vector बनाता है, और फिर उसे कई बार बदलता है। Attention में हर token बाकी tokens के vectors का वज़न वाला औसत लेकर अपना नया vector बनाता है। वज़न वाले औसत में हर vector को उसके वज़न से गुणा करके जोड़ते हैं, और वज़नों का जोड़ 1 होता है।
Cross-encoder में query के tokens passage के tokens को भी देखते हैं, और Stanford की slide इसे full attention across both कहती है। नीचे हर vector में 2 numbers हैं: पहला बताता है कि token गिनती वाले data की तरफ़ कितना है, और दूसरा राय की तरफ़ कितना। numbers मेरे बनाए हैं
Query का token crowded शुरू में [0.5, 0.5] है। Query को queue log के साथ जोड़ें, तो crowded 0.6 वज़न queue log के averaged [1.0, 0.0] को देता है, और 0.4 खुद को:
Forum post के साथ वही 0.6 वज़न usually [0.0, 1.0] को जाता है, और crowded [0.2, 0.8] बनता है। मतलब query के उसी token का vector हर passage के साथ अलग बनता है। Bi-encoder में attention सिर्फ़ query के अंदर चलता है, इसलिए वहाँ crowded का vector हर passage के लिए एक ही रहता है।
आख़िर में model पूरी जोड़ी की बात एक vector में समेटकर एक score बनाता है। Lesson 6 के reranker ने least crowded वाले सवाल पर queue log को 0.92 दिया, office hours page को 0.41, और forum post को 0.35। Retriever ने queue log और forum post को बराबर 2 दिया था। lesson 6 के मेरे बनाए scores
Stanford की slide: Cross-Encoders and Reranking। बाईं तरफ़ bi-encoder में query (Inx) और passage (Iny) अलग encoders से गुज़रते हैं। दाईं तरफ़ cross-encoder में दोनों एक ही Encoder में साथ जाते हैं।
कीमत: पहले से कुछ नहीं बन सकता
Cross-encoder का हर vector query पर टिका है, इसलिए passage का कुछ भी सवाल आने से पहले नहीं बन सकता। हर query पर उसे हर passage के साथ पूरा model चलाना पड़ता है, जबकि bi-encoder में model हर query पर 1 बार चलता था।
Stanford की slide के मुताबिक BERT-base वाला cross-encoder 1,000 passages पर 10,700 ms लेता है, यानी एक passage पर 10.7 ms। BERT-base, BERT का छोटा version है। Lesson 2 की company के 60,000 passages पर एक query के 60,000 × 10.7 ms = 642 seconds लगेंगे, यानी करीब 11 minute।
5Shortlist पर reranking
Retriever तेज़ है लेकिन passage को मोटे तौर पर देखता है, और cross-encoder सटीक है लेकिन धीमा। इसलिए पहले तेज़ retriever ऊपर के कुछ passages निकालता है, जैसे top-100, और फिर cross-encoder सिर्फ़ उन्हीं को दोबारा score देकर sort करता है। इस छोटी list को shortlist कहते हैं, और दूसरे step को reranking।
Step
किस पर
समय
1. BM25 और dense, फिर RRF
पूरा corpus
BM25 62 msdense दसियों ms, Stanford की slide से
2. Cross-encoder से reranking
Top-100 shortlist
100 × 10.7 = 1,070 ms
3. LLM के prompt में
Rerank के बाद top-5
–
पूरे corpus पर 642 seconds लगते, और shortlist पर करीब 1 second। Accuracy का फ़ायदा Stanford की एक table दिखाती है। उसका data MS MARCO है: Bing search के असली सवाल, और करीब 88 लाख passages। MS MARCO का परिचय paper से
वहाँ BM25 अकेला 16.7 देता है। Lesson 13 में ये पहले सही passage के rank का उल्टा था, जैसे rank 2 पर 0.5। Table इसे 100 से गुणा करके लिखती है। BM25 के top-1,000 को BERT-base cross-encoder से rerank करें, तो MRR@10 34.7 हो जाता है। यानी reranking से MRR@10 करीब दोगुना होता है: 34.7 ÷ 16.7 = 2.08।BM25 के top-1,000 वाली बात paper से
Reranker की एक हद है: वो सिर्फ़ shortlist का क्रम बदलता है, और जो passage उसमें नहीं है, उसे नहीं ला सकता। ये lesson 2 वाली है। 100 में से 60 सवालों की shortlist में सही passage हो, तो reranker भी 60 से ऊपर नहीं जाता।
इसलिए पहले step का recall ऊँचा होना चाहिए, और hybrid search यही करता है: E1 और E2, दोनों shortlist में पहुँचते हैं।
पहले सोचिए
हर query के लिए 500 ms का budget है। Retriever 50 ms लेता है, और cross-encoder एक passage पर 10.7 ms। Shortlist में ज़्यादा से ज़्यादा कितने passages रख सकते हैं?
जवाब देखिए
Reranking के लिए 500 − 50 = 450 ms बचते हैं। 450 ÷ 10.7 = 42.06, यानी 42 passages।
गहरे version में और क्या है
गहरे version में ये पूरा lesson है, और उसके बाद Stanford के level वाले 5 पड़ाव:
पड़ाव 6: RRF का गणित: अलग k पर 1 ÷ (k + rank), और RRF paper का k वाला experiment।
पड़ाव 7: Min-max normalisation, उसकी कमज़ोरी, और DPR paper का BM25 + DPR जोड़।
पड़ाव 8: Cross-encoder अंदर से: attention के वज़न, score से probability, और training का loss।
पड़ाव 9: कीमत का हिसाब: N बार model बनाम एक बार, FLOPs, और असली recall ceiling।
पड़ाव 10: Stanford की पाँच slides, जिन्हें आप खुद पढ़ते हैं।
BM25 paraphrase चूकता है, और dense retriever rare literals। Hybrid search दोनों चलाकर उनकी lists मिलाता है।
Scores के पैमाने अलग हैं, इसलिए RRF सिर्फ़ ranks मिलाता है: हर list से 1 ÷ (60 + rank), फिर जोड़। k = 60 पर वो passage जीतता है, जिसे दोनों lists ऊपर रखती हैं।
Cross-encoder query और passage को साथ पढ़ता है, इसलिए सटीक है, लेकिन हर passage पर पूरा चलता है। इसलिए वो सिर्फ़ shortlist को rerank करता है।
इस lesson के नए शब्द
Paraphrase
वही बात अलग शब्दों में। जैसे upload failed और upload keeps failing। BM25 इसे चूकता है, क्योंकि वो एक जैसे शब्द गिनता है।
Literal
ऐसा text, जो हूबहू मिलना चाहिए, जैसे error code E-4012 या order ID A77-310। Dense retriever इसे चूक सकता है, और BM25 इसे rare शब्द मानकर पकड़ता है।
Hybrid search
दोनों retrievers, शब्दों वाला और dense, चलाकर उनकी lists मिलाना। जैसे BM25 की E1, E3, E2 और dense की E2, E1, E3 से एक list बनाना।
Reciprocal rank fusion (RRF)
हर list में passage के rank से 1 ÷ (k + rank), फिर सारी lists का जोड़, जहाँ k = 60। जैसे E1: 1 ÷ 61 + 1 ÷ 62 = 0.03252।
Attention
हर token बाकी tokens के vectors का वज़न वाला औसत लेकर अपना नया vector बनाता है, और वज़नों का जोड़ 1 होता है। जैसे crowded [0.5, 0.5] averaged [1.0, 0.0] को 0.6 वज़न दे, तो [0.8, 0.2] बनता है।
Cross-encoder
Query और passage को जोड़कर एक model में डालने वाला reranker, जो जोड़ी का सीधा score देता है। ये हर passage पर पूरा चलता है, जैसे BERT-base में 10.7 ms per passage।
Reranking
तेज़ retriever की shortlist को सटीक model से दोबारा score देकर sort करना। जैसे MS MARCO पर MRR@10 BM25 अकेले 16.7, और BERT-base से rerank के बाद 34.7।
Shortlist
Retriever के ऊपर के कुछ passages, जिन पर reranker चलता है। जैसे 60,000 passages में से top-100, जिन पर cross-encoder 1,070 ms लेता है।