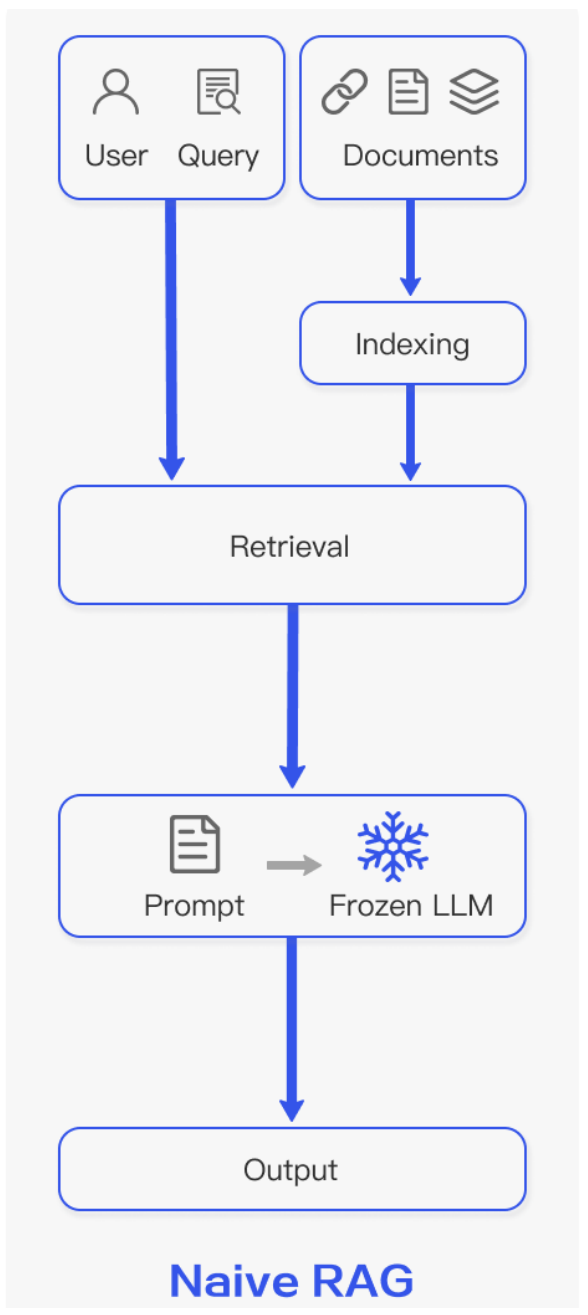
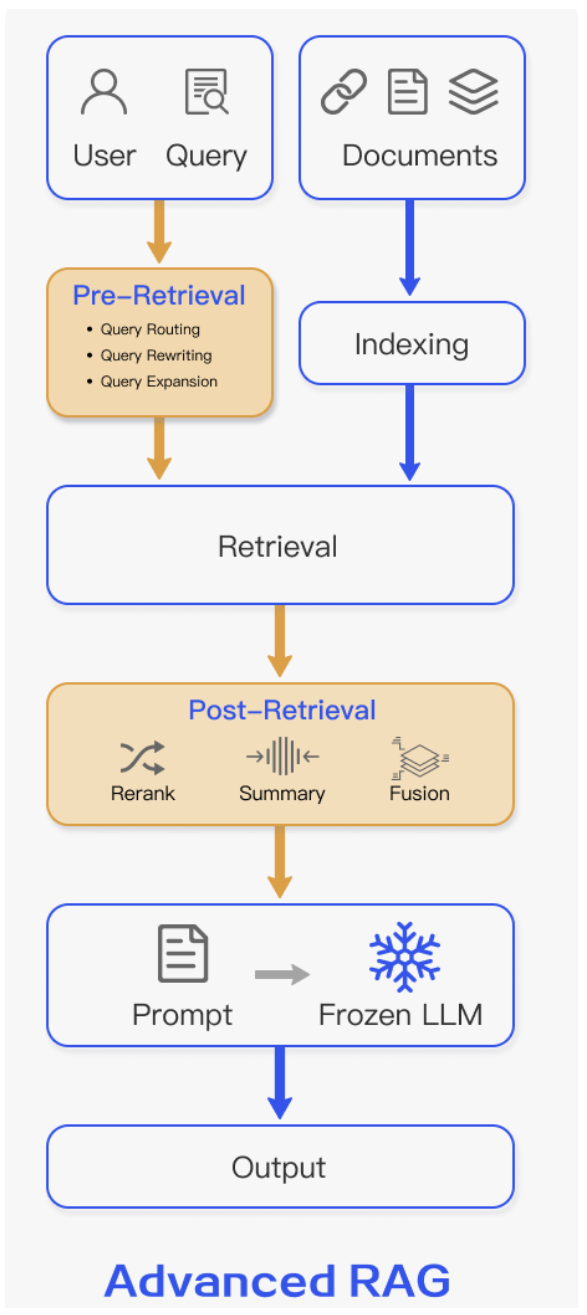
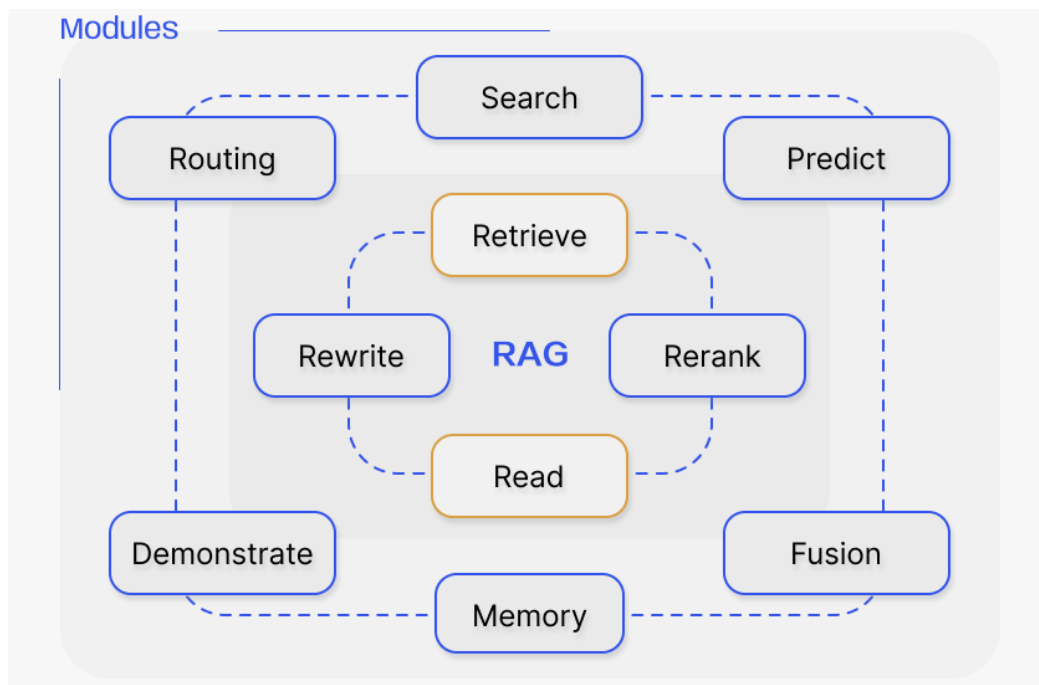
RAG pipeline steps की एक line है: query से retrieval, retrieval से prompt, और prompt से LLM का जवाब। LLM को आप बदल नहीं सकते, इसलिए जवाब सुधारने के लिए आप उससे पहले के steps बदलते हैं। Stanford की slide ऐसी pipeline के तीन रूप दिखाती है: Naive, Advanced और Modular RAG।
इसकी ज़रूरत lesson 5 के आख़िर में दिखी थी। वहाँ retriever और generator साथ में train होते थे। लेकिन API से लिए LLM के parameters आप नहीं बदल सकते, जैसे GPT या Gemini के। तब lesson 2 की दोनों गलतियाँ लौट आती हैं। when can I get help from a TA पर retriever एक भी passage नहीं लौटाता। which office hour is least crowded पर पुराना forum post queue log के बराबर score पाता है।
इस lesson की सीढ़ी
सीढ़ी में 5 पड़ाव हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
Frozen LLM और pipelineबता पाएँगे कि API वाले LLM के साथ lesson 5 की training क्यों नहीं चलती।
Post-retrieval: लौटी list सुधारनाबता पाएँगे कि rerank छूटा passage क्यों नहीं लाता, और slide का Advanced RAG वाला हिस्सा पढ़ पाएँगे।
Modular RAG: modules और patternsदो बार ढूँढने वाले pattern का हिसाब हाथ से कर पाएँगे, और slide का Modular RAG वाला हिस्सा पढ़ पाएँगे।
पहले से क्या चाहिए: Lesson 2 (retriever, word overlap, stopwords, recall ceiling), Lesson 3 (embedding, index) और Lesson 5 (RAG model)। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1Frozen LLM: आप सिर्फ़ prompt बदल सकते हैं
Frozen LLM वो LLM है, जिसके parameters आप नहीं बदल सकते। आप उसे सिर्फ़ prompt भेजते हैं, और जवाब पाते हैं। API वाले LLM के company के server पर हैं, इसलिए आपके लिए वो frozen है।
Lesson 5 का RAG इस हालत में train नहीं हो सकता। वहाँ एक ही loss से retriever और generator, दोनों के parameters बदलती थी। Frozen LLM के parameters बदल ही नहीं सकते, इसलिए ये रास्ता बंद है।
तो बदलने को वो सब बचता है, जो LLM तक पहुँचने से पहले होता है: query, retriever और prompt। Pipeline steps की ऐसी line है, जिसमें हर step का output अगले step का input बनता है। जैसे retriever का output top-K passages हैं, और वही passages prompt का input बनते हैं।
Pipeline में top-K passages एक ही prompt में जाते हैं। Lesson 5 में हर passage के साथ generator अलग से चलता था, और फिर वज़न वाला जोड़ होता था। यहाँ LLM को कुछ ऐसा prompt मिलता है: मेरा example
Answer using only the passages below. Cite passage IDs. [P3] Queue log, last 3 weeks: Tuesday 4pm office hour averaged 14 students waiting; Thursday 9am office hour averaged 3. [P2] Office hours: Tuesday 4pm in Room 104 and Thursday 9am on Zoom, run by the TAs. Question: Which office hour is least crowded, and where is it?
LLM खुद तय करता है कि कौन सी बात किस passage से ले: Thursday 9am queue log से, और Zoom office hours page से। [P3] और [P2] lesson 2 के corpus वाले ID हैं, ताकि जवाब citation दे सके।
इस आज़ादी की कीमत ये है कि LLM अपनी गलती से कुछ नहीं सीखता, और retriever को उस गलती का पता ही नहीं चलता। यानी lesson 2 वाली हालत लौट आई, जिसमें retriever और reader अलग-अलग बने थे। इसलिए हर step को अलग से अच्छा बनाना पड़ता है, और बाकी lesson यही steps दिखाता है।
2Naive RAG: indexing time और query time
Naive RAG सबसे सीधी pipeline है: पहले से बना index, और फिर हर query पर retrieval, prompt और frozen LLM। बीच में कोई extra step नहीं है, इसलिए इसे naive, यानी सीधा-सादा, कहते हैं। इसके steps उन्हीं दो हिस्सों में बँटते हैं, जो lesson 3 में थे।
Pipeline की भाषा में इन दो हिस्सों को indexing time और query time कहते हैं। Indexing time के steps एक बार चलते हैं: documents को passages में तोड़िए, हर passage का बनाइए, और सबको में रखिए। Embedding वो vector है, जो encoder किसी text से बनाता है।
Documents2,000 documents
Passages में तोड़िए60,000 passages
Index60,000 embeddings, एक बार
Indexing time: ये line एक बार चलती है। Numbers lesson 2 की company से हैं: 2,000 documents × 30 paragraphs = 60,000 passages। मेरा example
Query time के steps हर query पर चलते हैं:
Query1 embedding
Retrieve60,000 dot products, top-5
Prompt5 × 500 tokens + सवाल
Frozen LLMRead, 1 call
Query time: ये line हर query पर चलती है। मेरा example
यानी हर query पर 1 embedding, 60,000 और 1 LLM call लगती है। Prompt में passages के 5 × 500 = 2,500 tokens जाते हैं। Query time के दो मुख्य steps के नाम Retrieve और Read हैं। Read में LLM passages पढ़कर जवाब लिखता है, lesson 2 के की तरह।
Stanford की slide का बायाँ हिस्सा: Naive RAG। Documents से Indexing तक indexing time है, और Query से Output तक query time। Frozen LLM के आगे बर्फ़ का निशान है। Image पर click करने से वो पूरे size में खुलती है।
अब शुरू वाले दोनों सवाल इस pipeline पर चलाइए। Retriever के लिए lesson 2 का लेते हैं, क्योंकि उसका हर score आप हाथ से गिन सकते हैं। Word overlap गिनता है कि query के कितने शब्द passage में भी हैं, और गिनने से पहले which और is जैसे हटाता है।
Query
Retriever ने क्या लौटाया
K = 2 पर LLM को क्या मिला
when can I get help from a TA
कुछ नहीं, हर passage का score 0।
कुछ नहीं। Office hours page, जिसमें जवाब है, LLM तक नहीं पहुँचा।
which office hour is least crowded
Queue log (2), पुराना forum post (2), office hours page (1)।
Queue log और forum post, यानी सही data के साथ 2024 की पुरानी राय।
दोनों गलतियाँ अलग किस्म की हैं। TA वाले सवाल पर सही passage आया ही नहीं, और यही lesson 2 की है। Least crowded वाले सवाल पर सही passage आया, लेकिन गलत passage भी बराबर score लेकर साथ आया, यानी ये क्रम की गलती है। दोनों गलतियाँ LLM तक पहुँचने से पहले हो चुकी हैं, इसलिए LLM कितना भी अच्छा हो, वो इन्हें ठीक नहीं कर सकता।
पहले सोचिए
Corpus में 500 नए passages जुड़े, और एक पुराना document बदल गया। Naive RAG में कौन से steps दोबारा चलाने होंगे, और कौन से नहीं?
जवाब देखिए
सिर्फ़ indexing time के steps, और वो भी सिर्फ़ बदले हुए text के लिए। 500 नए passages के embeddings बनाकर index में जोड़िए, और बदले document के passages के embeddings दोबारा बनाइए। ऐसा न करें, तो index पुराना text लौटाता रहेगा। Query time के steps वैसे ही चलते हैं, और LLM में कुछ नहीं बदलता।
3Pre-retrieval: retrieval से पहले query सुधारना
Pre-retrieval वो steps हैं, जो query को retriever तक भेजने से पहले सुधारते हैं। Slide पर इनके तीन नाम हैं: query routing, query rewriting और query expansion। पहले TA वाले सवाल पर expansion देखिए, क्योंकि ये सवाल query के शब्दों की वजह से हारा।
Stopwords हटाने के बाद इस query में help और ta बचते हैं। Office hours page में TAs लिखा है, ta नहीं, और word overlap शब्दों को हूबहू मिलाता है। help किसी passage में नहीं है। यानी जवाब वाला passage corpus में है, बस query के शब्द उससे नहीं मिलते।
Query expansion query में उससे जुड़े शब्द जोड़ता है, ताकि वो passages के शब्दों से मिल सके। TA वाली query में office hours जोड़िए, तो retriever के पास चार शब्द हैं: help, ta, office और hours। मेरा example
Passage
मिले शब्द
Expansion से पहले
Expansion के बाद
Office hours page
office, hours
0
2
Queue log
office इसमें hour लिखा है, hours नहीं।
0
1
बाकी चार passages
कोई नहीं
0
0
अब office hours page सबसे ऊपर है, और LLM तक पहुँचता है। ये शब्द अक्सर एक LLM जोड़ता है, जिसे छोटा prompt मिलता है: इस सवाल से जुड़े search शब्द लिखिए।
बाकी दो steps भी query पर काम करते हैं। Query rewriting पूरी query दोबारा लिखता है। जैसे user छोटे रूप में पूछे OH timings?, तो एक LLM उसे CS 329Z office hours schedule बना देता है। Query routing तय करता है कि किस index में ढूँढना है। जैसे when is the project milestone due syllabus वाले index में जाए।
Pipeline के steps चालू-बंद कीजिए
Retriever lesson 2 वाला word overlap है। Expansion query में शब्द जोड़ता है। Rerank लौटे हुए passages को दूसरे score से दोबारा sort करता है, और वो अगले पड़ाव में आता है। rerank scores मेरे बनाए हैं
#
Passage
Overlap
Rerank
इन steps की कीमत है। Rewriting और expansion के लिए अक्सर हर query पर एक extra LLM call लगती है, इसलिए जवाब धीमा और महँगा होता है। ये query का मतलब भी बदल सकते हैं: model OH को Ohio समझ ले, तो search गलत जगह जाएगी।
पहले सोचिए
Widget में which office hour is least crowded चुनिए। Expansion इस query में waiting जोड़ता है। Queue log और पुराने forum post का नया score क्या होगा? फिर widget में check कीजिए।
जवाब देखिए
Query के शब्द अब office, hour, least, crowded और waiting हैं। Queue log में office, hour और waiting हैं, इसलिए score 3। Forum post में least और crowded हैं, इसलिए score 2। अब queue log अकेला सबसे ऊपर है, लेकिन K = 2 पर forum post अब भी prompt में जाता है।
4Post-retrieval: लौटी list सुधारना
Post-retrieval वो steps हैं, जो retriever की लौटाई list को prompt में जाने से पहले सुधारते हैं। Slide पर इनके तीन नाम हैं: rerank, summary और fusion। पहले least crowded वाले सवाल पर rerank देखिए, क्योंकि वहाँ गलती क्रम की थी।
Retriever ने queue log और forum post को बराबर 2 दिया। उसे नहीं दिखता कि queue log तीन हफ़्ते का data है, और forum post 2024 की एक राय।
Retriever तेज़ है, क्योंकि वो हर passage को मोटे तौर पर देखता है। लौटे हुए passages गिनती में कम हैं, इसलिए उन पर एक धीमा लेकिन ज़्यादा सटीक model चल सकता है। ये model query और passage को साथ पढ़कर नया score देता है, और list दोबारा sort करता है। इसे rerank कहते हैं, और इस model को reranker। Reranker कैसे बनता है, ये lesson 14 में है।
Retriever ने तीन passages लौटाए थे, और reranker उनमें से forum post को सबसे नीचे रखता है: rerank scores मेरे बनाए हैं
Passage
Retriever score
Reranker score
K = 2 पर LLM तक?
Queue log
2
0.92
हाँ
Office hours page
1
0.41
हाँ
पुराना forum post
2
0.35
नहीं
K = 2 पर अब queue log और office hours page जाते हैं, और ये जोड़ी पूरा जवाब देती है। Queue log बताता है कि Thursday 9am में भीड़ कम है, और office hours page बताता है कि वो Zoom पर है। यही वो prompt है, जो पड़ाव 1 में दिखा था।
पहले सोचिए
Widget में TA वाली query चुनिए। Expansion बंद रखिए, और Rerank चालू कीजिए। क्या office hours page अब LLM तक पहुँचेगा?
जवाब देखिए
नहीं। Retriever ने एक भी passage नहीं लौटाया, तो reranker के पास sort करने को कुछ है ही नहीं। अब Expansion भी चालू कीजिए: office hours page list में आता है, और rerank उसे सबसे ऊपर रखता है।
Reranker सिर्फ़ उन्हीं passages का क्रम बदलता है, जो retriever ने लौटाए। इसलिए दोनों तरह के steps अलग गलती ठीक करते हैं। Pre-retrieval छूटे हुए passage को list में लाता है, और post-retrieval list का क्रम सुधारता है।
Retrieval के बाद दो और steps आते हैं। पहला summary है: passages को prompt में डालने से पहले छोटा करना। Lesson 1 की context window में passages के लिए 7,000 tokens की जगह थी, यानी 500 tokens वाले 14 passages। हर passage 100 tokens का हो जाए, तो वही 14 passages 14 × 100 = 1,400 tokens लेते हैं। मेरा example खतरा ये है कि summary कोई ज़रूरी detail गिरा दे, जैसे Room 104।
दूसरा fusion है: कई ranked lists को मिलाकर एक list बनाना। मान लीजिए आपने original query से भी ढूँढा, और rewrite की हुई query office hours schedule से भी। पहली list है queue log, forum post, office hours page। दूसरी में सिर्फ़ office hours page (2) और queue log (1) हैं। ये दोनों passages दोनों lists में हैं, इसलिए मिली हुई list में उन्हें ऊपर आना चाहिए। मिलाने का पक्का हिसाब lesson 14 में है।
Naive RAG में pre-retrieval और post-retrieval steps जोड़ने से जो pipeline बनती है, उसे Advanced RAG कहते हैं।
Stanford की slide का बीच वाला हिस्सा: Advanced RAG। नारंगी boxes नए steps हैं: Retrieval से ऊपर Pre-Retrieval के तीन steps, और नीचे Post-Retrieval के तीन।
5Modular RAG: modules और patterns
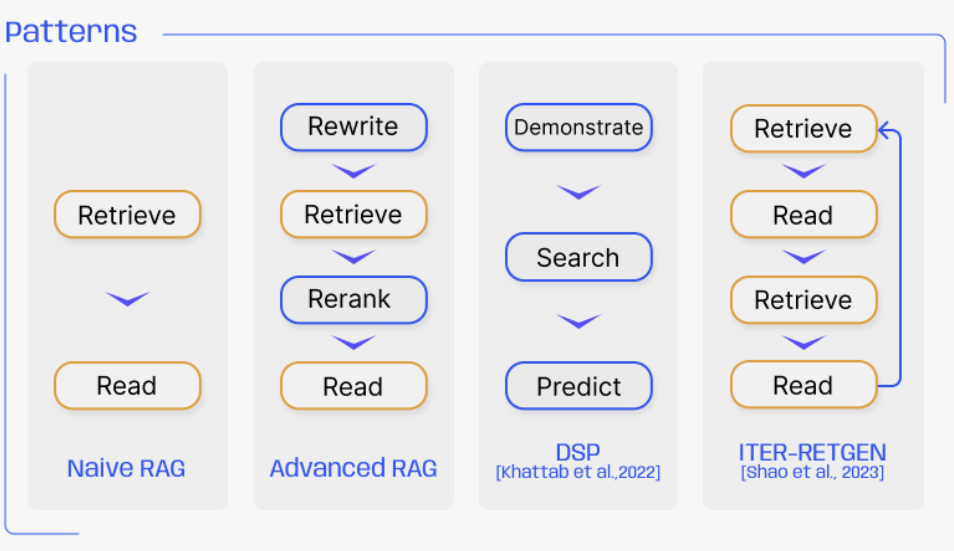
Modular RAG pipeline को modules में देखता है, जिन्हें आप किसी भी क्रम में जोड़ सकते हैं। Module pipeline का एक हिस्सा है, जो एक काम करता है, जैसे Retrieve, Rerank या Read। Modules के एक तय क्रम को pattern कहते हैं। जैसे Naive RAG का pattern है: Retrieve, फिर Read।
इसकी ज़रूरत उन सवालों पर पड़ती है, जिनके जवाब के हिस्से अलग-अलग passages में हैं। Advanced RAG भी हर सवाल पर एक ही बार ढूँढता है, इसलिए जो पहली search में नहीं आया, वो कभी नहीं आता। जिस सवाल के लिए कई बार ढूँढना पड़े, उसे multi-hop question कहते हैं।
हमारे corpus में भी ऐसा सवाल है: पड़ाव 1 के prompt वाला Which office hour is least crowded, and where is it? इसका पहला हिस्सा queue log में है, और दूसरा office hours page में। Office hours page में जगह Thursday 9am के आगे लिखी है, इसलिए उसे ढूँढने के लिए पहले Thursday 9am पता होना चाहिए।
अब Retrieve, Read, Retrieve, Read वाला pattern चलाइए, जिसमें पहली Read का जवाब दूसरी search की query में जुड़ता है। K = 2 है, और retriever वही word overlap। मेरा example
पहली Retrieve: query में office, hour, least, crowded और where बचते हैं, और where किसी passage में नहीं है। Queue log और forum post को 2-2 मिलता है, इसलिए यही दोनों लौटते हैं।
पहली Read: मान लीजिए LLM queue log का data चुनकर लिखता है: Thursday 9am। जगह इन दोनों passages में नहीं है।
दूसरी Retrieve: query के आगे पहला जवाब, Thursday 9am, जोड़िए। अब thursday और 9am भी गिनती में आते हैं।
दूसरी Read: K = 2 पर queue log और office hours page मिलते हैं, यानी पड़ाव 1 वाला prompt। LLM लिखता है: Thursday 9am, Zoom पर।
Passage
पहली search
दूसरी search
Queue logoffice, hour, फिर thursday, 9am भी
2
4
Office hours pageoffice, फिर thursday, 9am भी
1
3
पुराना forum postleast, crowded
2
2
Syllabusदूसरी बार thursday
0
1
इस pattern का नाम ITER-RETGEN है। इसका paper भी पिछले जवाब और सवाल को मिलाकर अगली query बनाता है। paper सेRerank सिर्फ़ लौटी list का क्रम बदलता है, जबकि ITER-RETGEN नई query से दोबारा ढूँढता है।
इसकी एक हद भी है। पहली Read का जवाब गलत हो, तो दूसरी search भी गलत दिशा में जाती है। जैसे LLM forum post पर भरोसा करके Wednesday लिखे, तो दूसरी query में Thursday 9am आएगा ही नहीं।
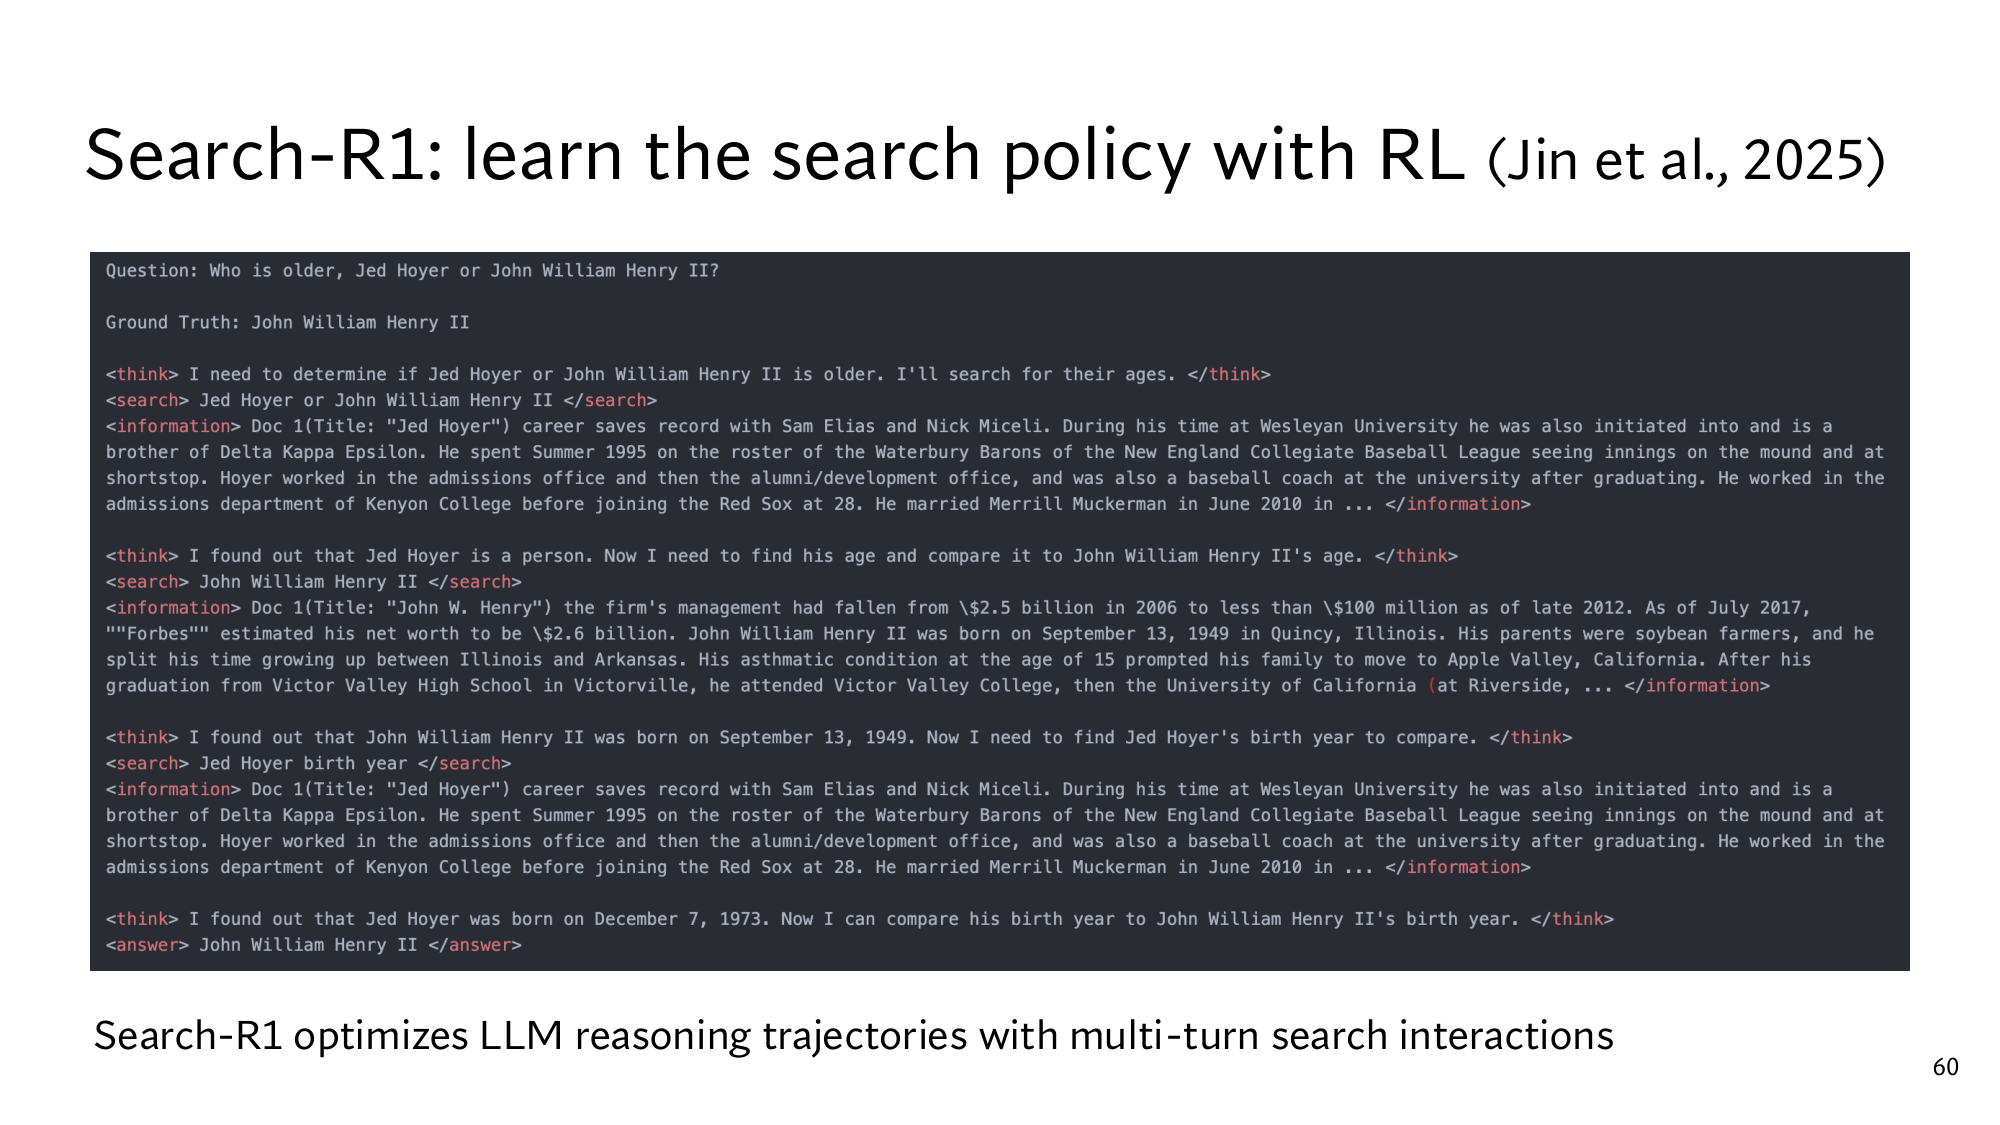
Lecture में एक असली multi-hop सवाल भी है: Who is older, Jed Hoyer or John William Henry II? Slide पर इस सवाल पर एक model का trace है, जो lesson 17 में पूरा आएगा। पहली search Jed Hoyer के career वाला passage लाती है, जिसमें जन्म-तारीख नहीं है। अगली search John William Henry II की है, और उसका passage बताता है: born September 13, 1949। तीसरी search Jed Hoyer birth year की है, यानी हर search इस पर टिकी है कि पिछली बार पढ़कर क्या मिला।
Stanford की slide: Search-R1 नाम के model का trace। <search> वाली lines model की searches हैं, और <information> वाली lines लौटे passages।
Stanford की slide चार patterns दिखाती है, जो Gao और साथियों के survey (2024) से हैं:
DSP का Demonstrate module prompt में सवाल से पहले हल किए हुए examples रखता है, जैसे Q: When is the milestone due? A: Week 6, Thursday [P1]। मेरा example ऐसे examples को demonstrations कहते हैं, और इस तरीके को few-shot prompting। ये lesson 2 के से अलग है, जहाँ prompt में सिर्फ़ instruction थी।
Slide के modules वाले हिस्से में 10 modules हैं, और उनमें से 7 आप देख चुके हैं। बाकी तीन, यानी Search, Predict और Memory, गहरे version में आते हैं।
Stanford की slide का दायाँ हिस्सा: Modular RAG। ऊपर modules हैं, और नीचे चार patterns। ITER-RETGEN में आख़िरी Read से पहली Retrieve तक का तीर बताता है कि ये क्रम दोबारा चलता है।
Pattern इंसान पहले से लिखता है, इसलिए ITER-RETGEN में searches की गिनती तय होती है, चाहे सवाल को 1 search चाहिए या 3। Loop कब रुके और अगली query क्या हो, ये फ़ैसले lesson 16 और 17 में model खुद लेता है। हर extra loop एक LLM call और जोड़ता है।
गहरे version में और क्या है
गहरे version में ये पूरा lesson है, और उसके बाद 5 पड़ाव और, जो Stanford की slides के level तक ले जाते हैं:
पड़ाव 6: survey में Naive RAG की तीन दिक्कतें, precision, और sets की भाषा में expansion और rerank की हद।
पड़ाव 7: slide के बाकी modules, जैसे Search, Predict और Memory, और survey के नए patterns।
पड़ाव 8: DSP का paper, और relative gain का गणित।
पड़ाव 9: ITER-RETGEN का formula और paper के नतीजे, और कई searches में chances का गुणा।
पड़ाव 10: इस lesson की दोनों Stanford slides, जिन्हें आप खुद पढ़ते हैं।
API वाला LLM frozen है, इसलिए lesson 5 वाली training नहीं चलती। RAG pipeline LLM से पहले के steps सुधारती है: query, retrieval और prompt।
Naive RAG एक बार index बनाता है, और हर query पर Retrieve और Read चलाता है। Pre-retrieval query सुधारकर छूटा passage लाता है। Post-retrieval list का क्रम सुधारता है, लेकिन छूटा passage नहीं लाता।
Modular RAG modules को अलग-अलग क्रम में जोड़ता है। Multi-hop सवाल पर ITER-RETGEN पहली Read के जवाब से दोबारा ढूँढता है।
इस lesson के नए शब्द
Frozen LLM
जिसके parameters आप नहीं बदल सकते, सिर्फ़ prompt भेज सकते हैं। जैसे GPT या Gemini, जो आप API से लेते हैं।
Pipeline
Steps की line, जिसमें हर step का output अगले का input है। जैसे Retrieve का output top-K passages हैं, और वही Read का input।
Naive RAG
सबसे सीधी pipeline: index, फिर हर query पर Retrieve और Read। बीच में कोई extra step नहीं।
Indexing time और query time
एक बार चलने वाले steps, और हर query पर चलने वाले steps। जैसे 60,000 passages के embeddings एक बार बनते हैं, और query का embedding हर बार।
Pre-retrieval
Retrieval से पहले query सुधारने वाले steps: routing, rewriting और expansion।
Query routing
तय करना कि किस index या source में ढूँढना है। जैसे “when is the project milestone due” syllabus वाले index में जाए।
Query rewriting
LLM से query को साफ़ search query में बदलवाना। जैसे “OH timings?” से “CS 329Z office hours schedule”।
Query expansion
Query में जुड़े हुए शब्द या दूसरे रूप जोड़ना। जैसे “help ta” में “office hours” जोड़ने से office hours page का score 0 से 2 होता है।
Post-retrieval
Retrieval के बाद लौटी list सुधारने वाले steps: rerank, summary और fusion।
Rerank और reranker
धीमा लेकिन सटीक model, जो लौटाए गए passages को दोबारा sort करता है। जैसे queue log और forum post के बराबर score में से forum post को नीचे भेजना।
Summary
Passages को prompt से पहले छोटा करना। जैसे 500 tokens का passage 100 का हो, तो 14 passages 7,000 की जगह 1,400 tokens लेते हैं। खतरा: Room 104 जैसी detail छूट सकती है।
Fusion
कई ranked lists को मिलाकर एक list बनाना। जैसे पहली list queue log, forum post, office hours page है, और दूसरी office hours page, queue log। जो दोनों में हैं, वो ऊपर आते हैं।
Advanced RAG
Naive RAG में pre-retrieval और post-retrieval steps जोड़कर बनी pipeline। जैसे Rewrite, Retrieve, Rerank, Read।
Modular RAG
Pipeline को modules में बाँटकर, उन्हें अलग-अलग क्रम में जोड़ना। जैसे Retrieve, Read, Retrieve, Read।
Pattern
Modules का एक तय क्रम, जैसे Retrieve, Read।
Demonstrations (few-shot)
Prompt में सवाल से पहले दिए गए हल किए हुए examples। जैसे “Q: When is the milestone due? A: Week 6, Thursday [P1]”।
Multi-hop question
ऐसा सवाल, जिसके लिए कई बार ढूँढना पड़े, क्योंकि जवाब के हिस्से अलग passages में हैं। जैसे least crowded office hour कहाँ है: पहले queue log, फिर office hours page।