Chunking: document को retrieval के टुकड़ों में काटना
Chunking का मतलब है लंबे document को छोटे टुकड़ों में काटना, ताकि retriever हर टुकड़े का एक vector बनाकर index में रख सके। इन टुकड़ों को chunk कहते हैं। Retriever यही chunks ढूँढता और लौटाता है, इसलिए Stanford की slide chunk को retrieval की basic unit कहती है।
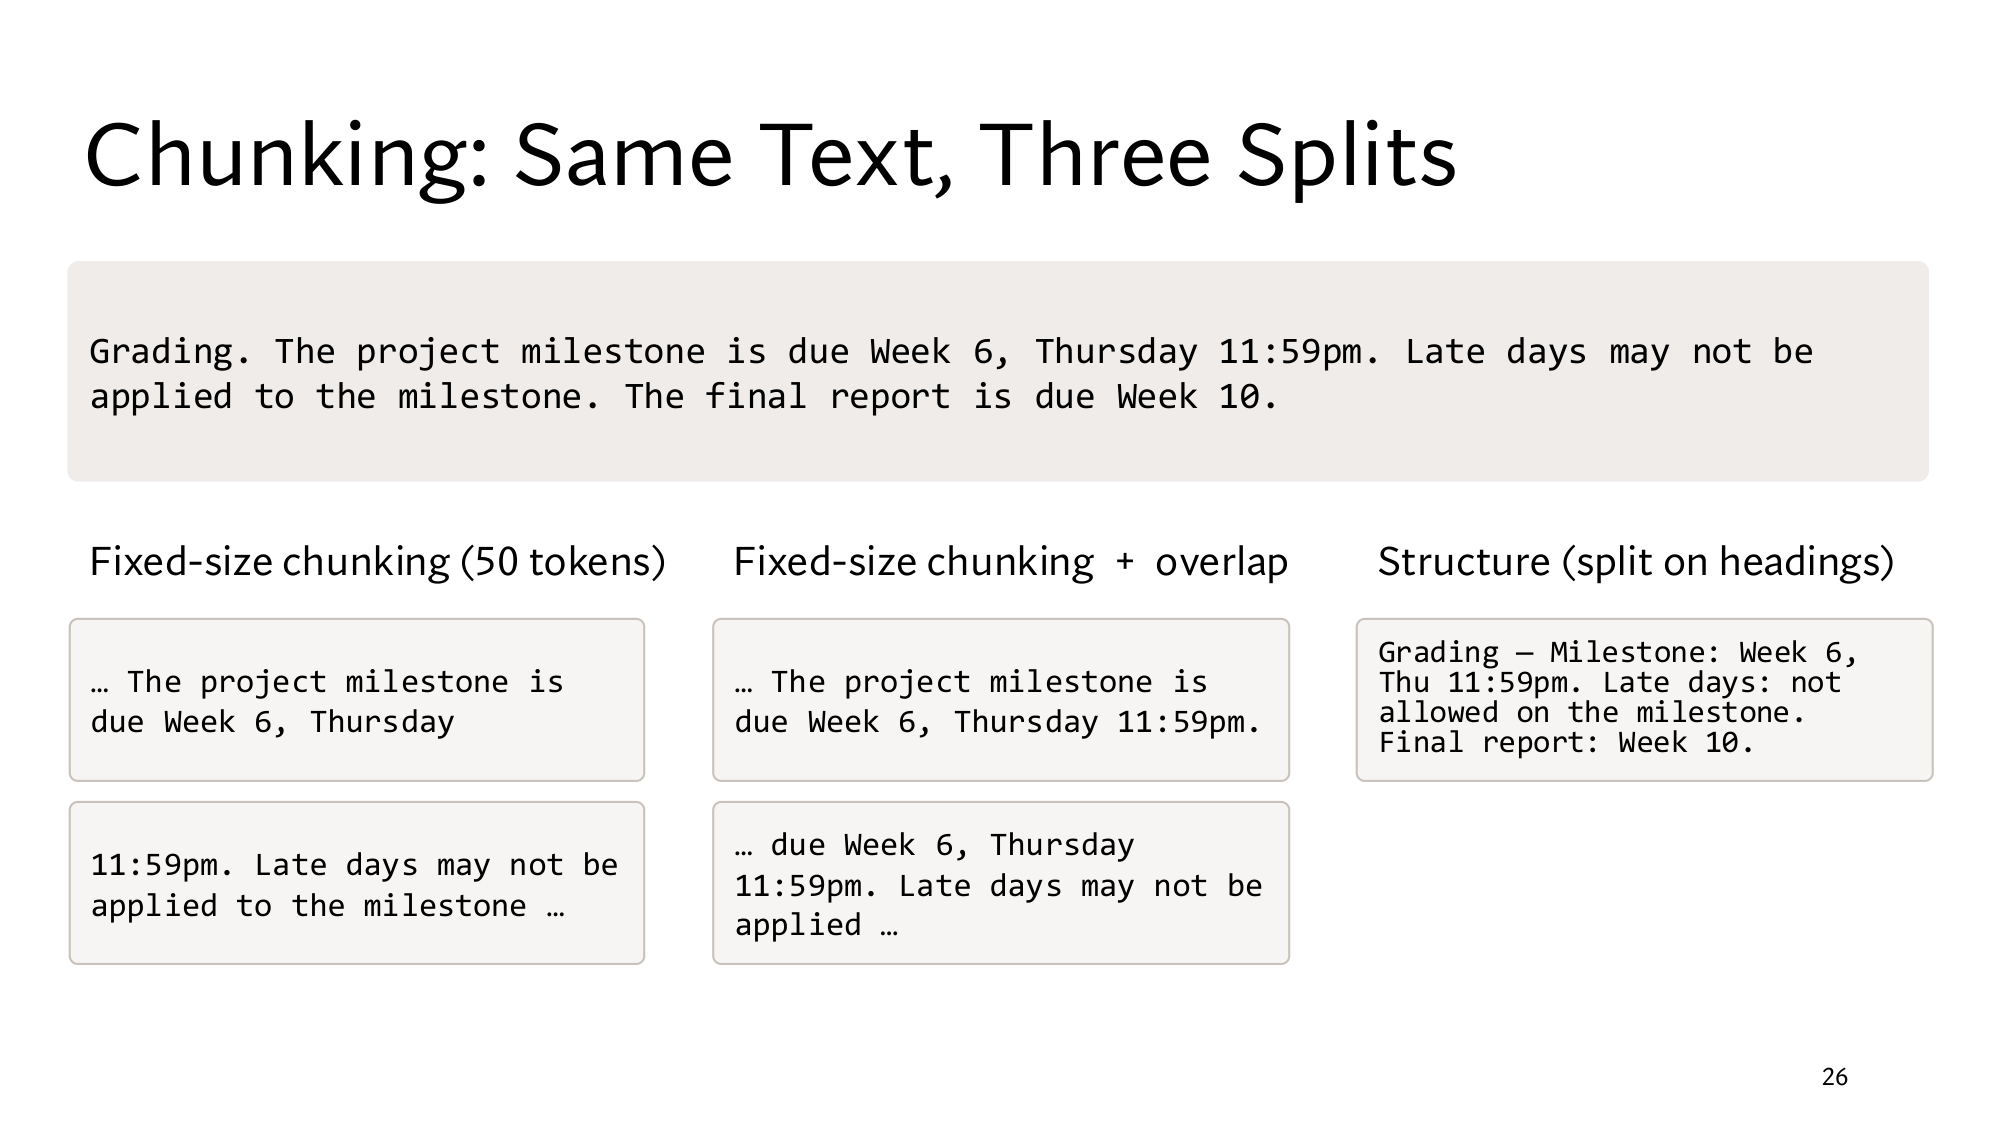
Lesson 2 में सवाल when is the project milestone due का जवाब syllabus वाले passage में था: Week 6, Thursday 11:59pm। वो passage हमें पहले से कटा हुआ मिला था, लेकिन असली syllabus 40 pages का है। Lesson 6 की pipeline में index बनाने का पहला step उसे काटना है। हर 50 tokens पर काटिए, तो एक chunk …due Week 6, Thursday पर ख़त्म होता है, और 11:59pm. अगले chunk में चला जाता है। काटें ही नहीं, तो 40 pages के एक vector में milestone की 2 lines घुल जाती हैं।
इस lesson की सीढ़ी
सीढ़ी में 4 पड़ाव हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
पहले से क्या चाहिए: Lesson 1 (token), Lesson 3 (vector, embedding, cosine) और Lesson 6 (indexing time)। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1Chunk का vector: tokens के vectors का औसत
Retrieval को हर chunk का एक vector चाहिए, और ये vector अक्सर chunk के सारे tokens के vectors का औसत होता है। Index हर chunk का यही एक vector रखता है। सवाल आने पर retriever सवाल के vector का हर chunk के vector से निकालता है, और सबसे बड़े cosine वाले chunks लौटाता है। Lesson 2 के छहों passages भी असल में chunks ही थे।
पहले देखिए कि tokens के vectors कहाँ से आते हैं। हर का अलग vector बनाता है, और उस vector पर आस-पास के शब्दों का भी असर होता है। इसे contextual embedding कहते हैं।
जैसे late शब्द दो sentences में आता है: Late days may not be applied और late afternoon office hours। मान लीजिए vector का पहला number office hours वाली बात दिखाता है, और दूसरा deadline वाली बात। तब contextual embedding में late के दो अलग vectors बनते हैं। पुराने static word embeddings, जैसे word2vec, हर word type का एक ही vector रखते थे। Word type यानी dictionary का एक शब्द, sentence कोई भी हो। numbers मेरे बनाए हैं
Sentence
Static: late का vector
Contextual: late का vector
Late days may not be applied
[0.5, 0.5]
[0.1, 0.9]
late afternoon office hours
[0.5, 0.5]
[0.9, 0.1]
अब पूरे chunk का एक vector चाहिए, जिसे passage embedding कहते हैं। सबसे आम तरीका है chunk के सारे token vectors का औसत लेना: हर column के numbers जोड़िए, और tokens की गिनती से भाग दीजिए। इसे mean pooling कहते हैं। तीन tokens वाला एक छोटा chunk लीजिए: मेरा example
Token
Vector
Office
[0.9, 0.1]
hours
[0.7, 0.3]
Tuesday
[0.8, 0.2]
Mean pooling: हर column का औसत
[0.8, 0.2]
पहला column: 0.9 + 0.7 + 0.8 = 2.4, और 2.4 ÷ 3 = 0.8।
तीनों tokens office hours की तरफ़ थे, इसलिए chunk का vector [0.8, 0.2] भी उसी तरफ़ है। Mean pooling हर token को बराबर वज़न देती है, और पड़ाव 2 में यही बात बड़े chunk को नुकसान पहुँचाती है।
पहले सोचिए
Chunk में एक token और जोड़िए: 4pm, जिसका vector [0.8, 0.2] है। अब chunk का vector क्या होगा, और उसमें कितने numbers होंगे?
जवाब देखिए
[0.8, 0.2], और उसमें अब भी 2 numbers हैं। पहला column: (0.9 + 0.7 + 0.8 + 0.8) ÷ 4 = 3.2 ÷ 4 = 0.8। दूसरा: (0.1 + 0.3 + 0.2 + 0.2) ÷ 4 = 0.8 ÷ 4 = 0.2। Tokens 3 हों या 300, औसत में numbers उतने ही रहते हैं, जितने हर token के vector में हैं। इसलिए हर chunk के vector में numbers की गिनती बराबर रहती है, और index सबकी तुलना कर पाता है।
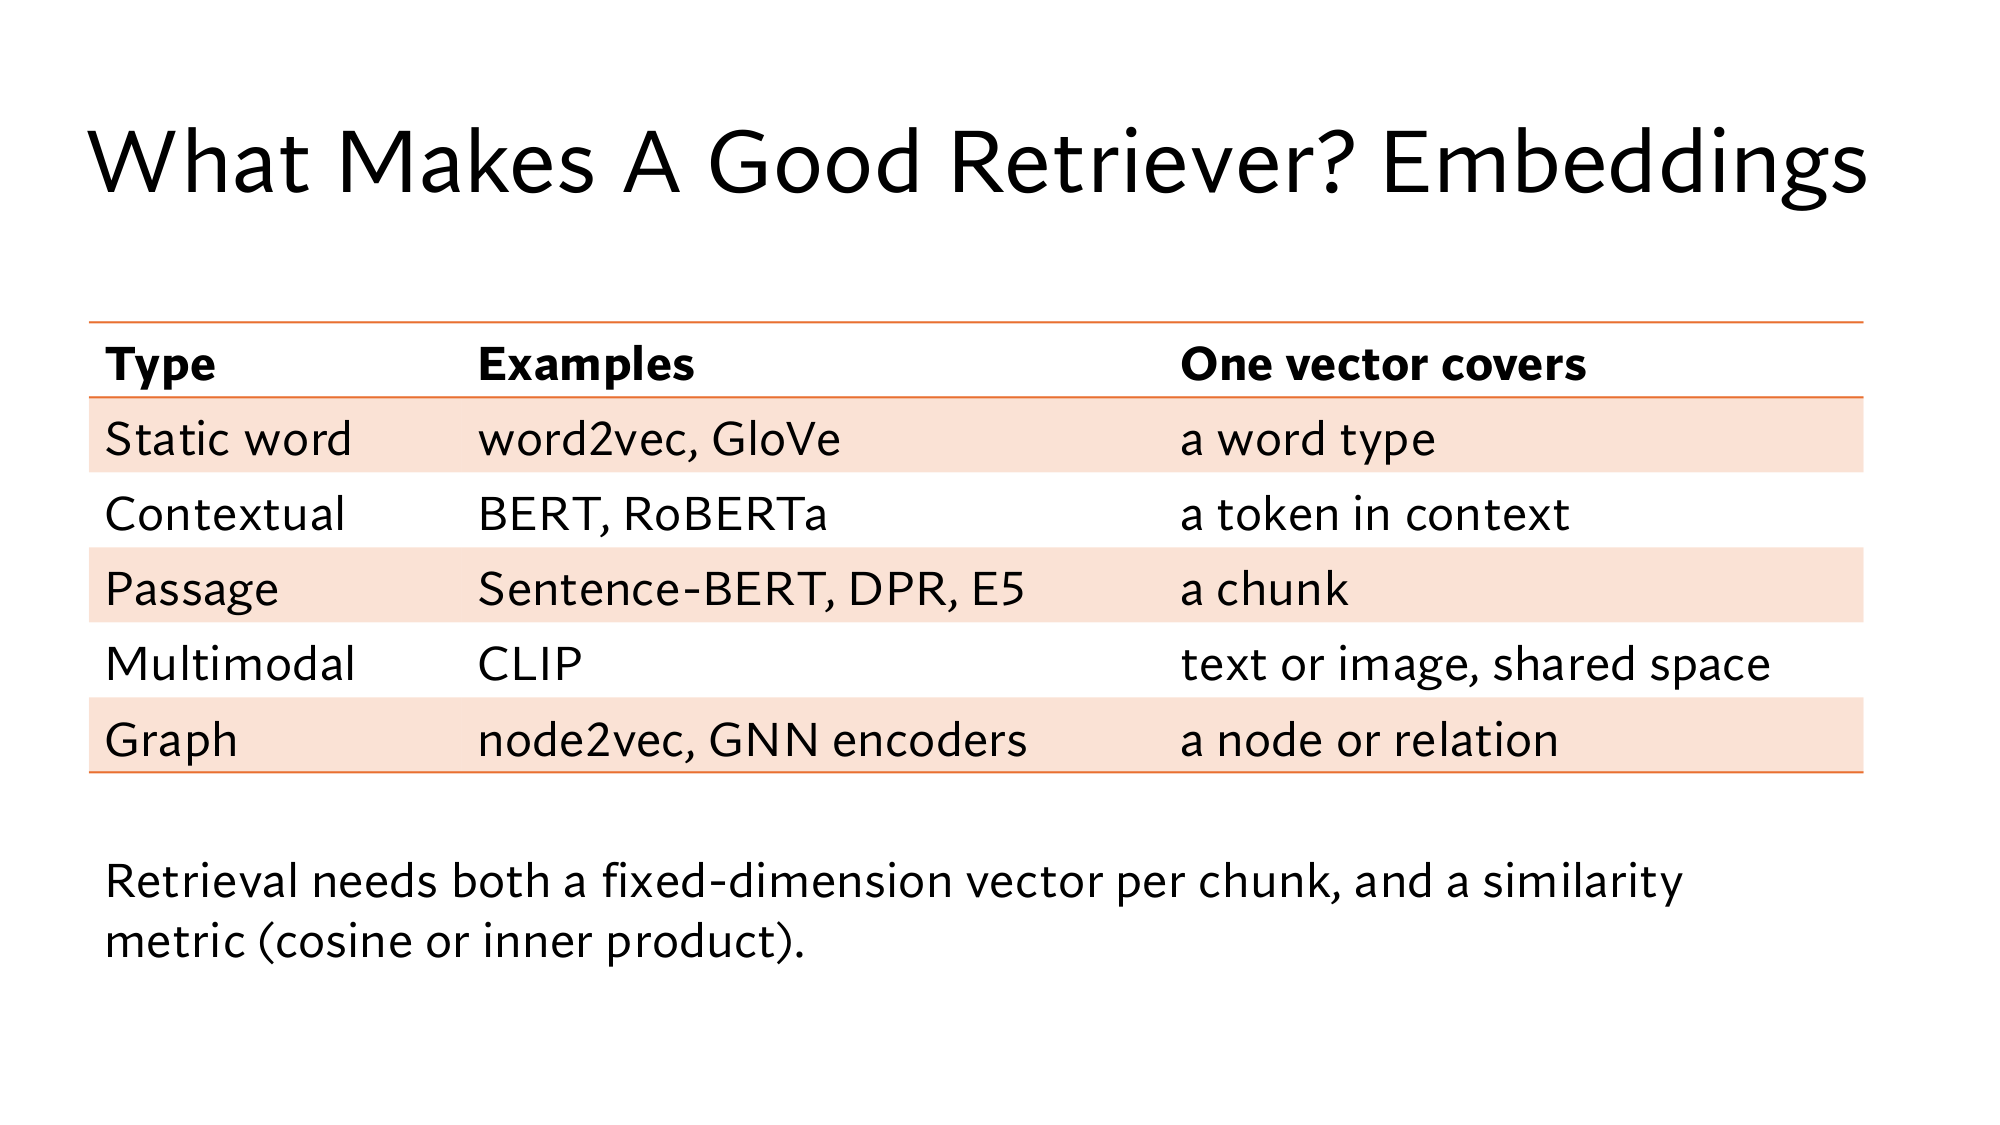
Stanford की embeddings वाली slide यही बात कहती है। उसकी table में पाँच तरह के embeddings हैं, और ऊपर के तीन आपने अभी देखे: static word, contextual और passage। बाकी दो, और , image और network के vectors हैं। Slide की आख़िरी line retrieval की दो ज़रूरतें बताती है। पहली, हर chunk का एक vector, जिसकी तय हो। दूसरी, तुलना का एक तरीका, cosine या inner product।
Stanford की slide: What Makes A Good Retriever? Embeddings। Passage वाली row में एक vector एक chunk का है, और ये lesson उसी chunk के बारे में है। Image पर click करने से वो पूरे size में खुलती है।
2Chunk का size: छोटा context खोता है, बड़ा औसत में घुलता है
बड़ा chunk कई विषयों का औसत बन जाता है, और छोटा chunk अपना context खो देता है। इसलिए chunk का size इन दो उल्टी दिक्कतों के बीच का फ़ैसला है, और Stanford की slide दोनों गिनाती है।
बड़ा chunk: विषय औसत में घुल जाते हैं
मान लीजिए office hours वाली बात का vector [1, 0] है, और deadline वाली बात का [0, 1]। एक बड़े chunk में दोनों बातें बराबर हों, तो mean pooling का औसत [0.5, 0.5] बनता है। Query office hours का vector [1, 0] है। मेरा example
Lesson 3 वाला cosine दो vectors का dot product है, जिसे दोनों की के गुणा से भाग देते हैं। सिर्फ़ office hours वाले छोटे chunk [1, 0] का query से cosine 1 है, क्योंकि दोनों एक ही दिशा में हैं। बड़े chunk का cosine तीन steps में निकलता है:
Dot product: 1 × 0.5 + 0 × 0.5 = 0.5।
Length: query की length 1 है, और [0.5, 0.5] की √(0.5² + 0.5²) = √0.5 = 0.707। √ यानी square root, वो number जिसे खुद से गुणा करने पर अंदर वाला number मिले। जाँच: 0.707 × 0.707 = 0.5।
Cosine: 0.5 ÷ (1 × 0.707) = 0.71।
Chunk
Vector
Query से cosine
सिर्फ़ office hours वाला छोटा chunk
[1, 0]
1.00
Office hours और deadlines, दोनों वाला बड़ा chunk
[0.5, 0.5]
0.71
बड़े chunk में सही बात मौजूद है, फिर भी उसका cosine 1.00 से 0.71 पर गिर गया, क्योंकि deadline वाला विषय औसत में मिल गया। अब कोई दूसरा chunk, जिसका cosine 0.8 है, इससे ऊपर आ जाएगा। 40 pages के syllabus में office hours, deadlines, grading और project, सब हैं, इसलिए वहाँ cosine और गिरता है।
पहले सोचिए
एक chunk में तीन विषय बराबर हैं: [1, 0, 0], [0, 1, 0] और [0, 0, 1]। Mean pooling का vector क्या होगा, और query [1, 0, 0] से उसका cosine कितना होगा?
जवाब देखिए
औसत [1/3, 1/3, 1/3] है, और query से dot product 1/3। Length √(3 × 1/9) = √(1/3) = 0.577 है। Cosine = (1/3) ÷ (1 × 0.577) = 0.58। दो विषयों पर 0.71 था, और तीन पर 0.58, यानी विषय जितने ज़्यादा, cosine उतना नीचे।
छोटा chunk: context छूट जाता है
अब उल्टा कीजिए, और बहुत छोटे chunks बनाइए। Queue log में 19 शब्द हैं, और उसे 5-5 शब्दों के chunks में काटने पर ये 4 chunks बनते हैं:
Chunk 1 · 5 शब्द
Queue log, last 3 weeks:
Chunk 2 · 5 शब्द
Tuesday 4pm office hour averaged
Chunk 3 · 5 शब्द
14 students waiting; Thursday 9am
Chunk 4 · 4 शब्द
office hour averaged 3.
चौथे chunk में 3 तो है, लेकिन ये नहीं लिखा कि ये किस दिन का office hour है। Thursday 9am तीसरे chunk में चला गया, इसलिए चौथे chunk का vector भी ये नहीं जानता। Lesson 2 वाले सवाल which office hour is least crowded का जवाब अब किसी एक chunk में पूरा नहीं है।
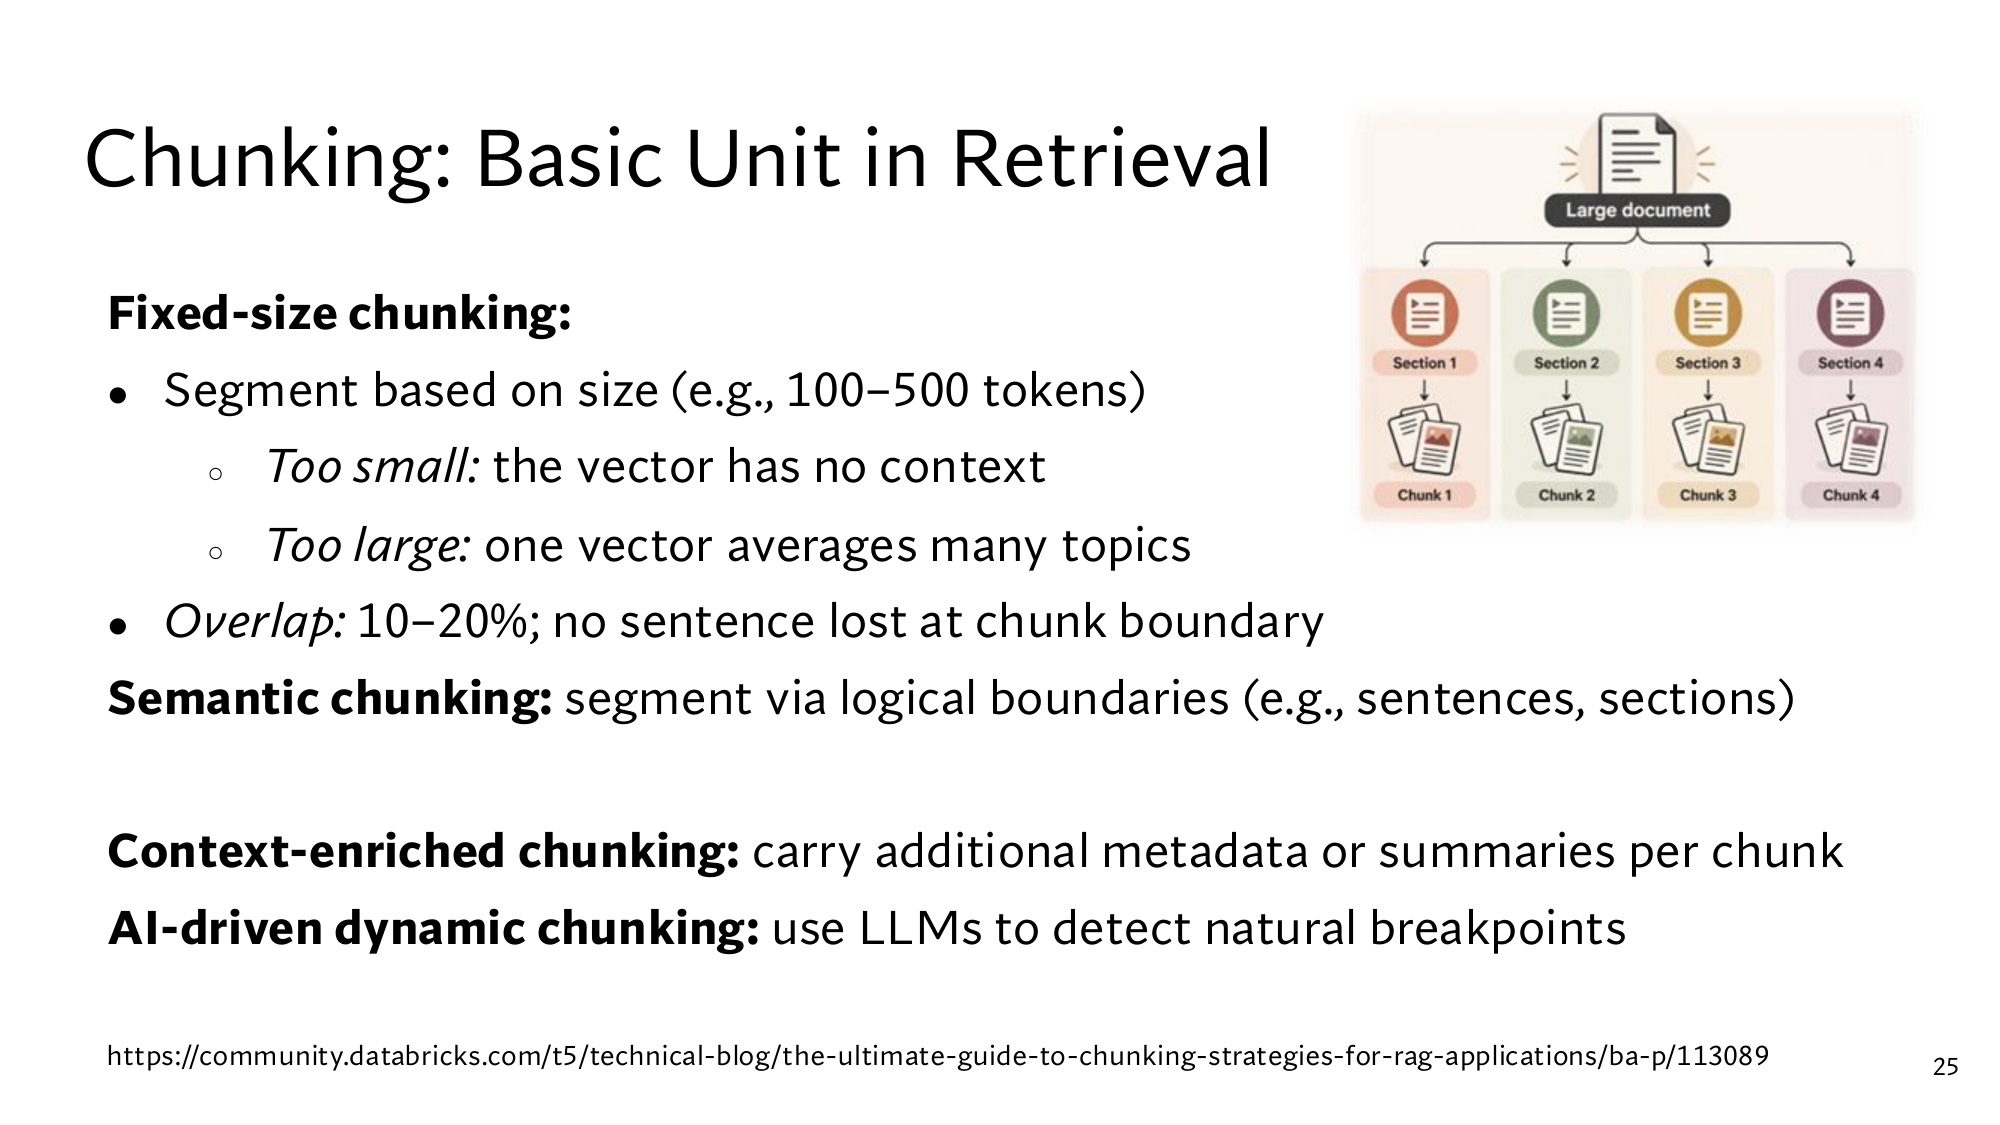
Fixed-size chunking इन दोनों के बीच का रास्ता लेता है: हर chunk में tokens की एक तय गिनती। Stanford की slide इसके लिए 100 से 500 tokens का example देती है।
छोटे chunks बारीक सवालों के लिए अच्छे हैं, लेकिन अपना context खो देते हैं। बड़े chunks को ज़्यादा context मिलता है, लेकिन उनका एक vector कई विषयों का औसत बन जाता है। Lesson 8 छोटे chunk का खोया context लौटाता है, और lesson 9 बड़े सवालों के लिए chunks के ऊपर summaries का ढाँचा बनाता है।
3Overlap और stride: boundary पर कटी बात बचाना
Overlap में हर नया chunk पिछले chunk के आख़िरी कुछ tokens दोहराकर शुरू होता है, ताकि boundary पर कटी बात पूरी बचे। इसकी ज़रूरत इसलिए है, क्योंकि size कुछ भी चुनिए, कोई न कोई बात किसी boundary पर कटेगी। शुरू में 50 tokens पर milestone की तारीख ऐसे ही कटी थी। Stanford की slide 10 से 20% overlap की सलाह देती है।
दो लगातार chunks की शुरुआत के बीच की दूरी को stride कहते हैं: stride = chunk size − overlap। Chunk size 9 और overlap 6 हो, तो stride 3 है, और chunks शब्द 0, 3, 6, 9, … पर शुरू होते हैं।
अब नीचे के widget में syllabus का शुरू वाला हिस्सा काटिए। यहाँ हर शब्द को एक token मानिए, और गिनती 0 से कीजिए। Milestone वाली बात, milestone is due Week 6, Thursday 11:59pm., 7 शब्दों की है, और syllabus में शब्द 3 से शब्द 9 तक है। Chunk size 9 और overlap 0 पर पहला chunk शब्द 0 से 8 तक है, इसलिए 11:59pm. उससे छूट जाता है।
पहले सोचिए
Chunk size 9 ही रखिए, और overlap 0 से 6 तक बढ़ाइए। किस overlap पर तारीख पहली बार किसी एक chunk में पूरी आएगी? पहले अंदाज़ा लगाइए, फिर widget में देखिए।
जवाब देखिए
सिर्फ़ overlap 6 पर। तब stride 3 है, और दूसरा chunk शब्द 3 से 11 तक चलता है, जिसमें पूरी तारीख है। Overlap 1 से 5 तक कोई chunk शब्द 3 पर या उससे पहले शुरू होकर शब्द 9 तक नहीं पहुँचता।
Syllabus को chunks में काटिए
Underline वाली बात, milestone की तारीख, किसी एक chunk में पूरी होनी चाहिए। हल्के background वाले शब्द overlap हैं।
कितना overlap काफ़ी है
Overlap 6 ही क्यों चाहिए, ये आप गिनकर देख सकते हैं। 9 शब्दों का chunk शब्द 3 से 9 तक की बात तभी पूरी रखता है, जब वो शब्द 1, 2 या 3 पर शुरू हो। Chunks 0, stride, 2 × stride, … पर शुरू होते हैं। इन 3 जगहों में कोई शुरुआत तभी पक्की गिरती है, जब stride 3 या कम हो। Stride 4 पर शुरुआतें 0, 4, 8 हैं, और 1, 2, 3 तीनों छूट जाते हैं। Stride = 9 − overlap है, इसलिए overlap कम से कम 6 चाहिए।
यही गिनती हर size पर चलती है। Chunk size C हो और बात L शब्दों की, तो chunk के शुरू होने की C − L + 1 सही जगहें होती हैं। यहाँ ये 9 − 7 + 1 = 3 थीं। Stride, यानी C − overlap, इससे ज़्यादा न हो, तो यही नियम निकलता है: ये नियम slide पर नहीं है, गिनती से निकलता है
overlap ≥ L − 1, और chunk size ≥ L
यहाँ L = 7, तो overlap कम से कम 6 चाहिए। Chunk ही बात से छोटा हो, तो कोई overlap बात को एक chunk में नहीं ला सकता।
पहले सोचिए
Widget में chunk size 10 और overlap 0 कीजिए। तारीख पूरी दिखती है। क्या ये पक्का बचाव है?
जवाब देखिए
नहीं, ये किस्मत है। पहला chunk शब्द 0 से 9 तक है, और तारीख ठीक शब्द 9 पर ख़त्म होती है। Syllabus की शुरुआत में एक शब्द और होता, तो 11:59pm. शब्द 10 पर जाता, और अगले chunk में चला जाता। L − 1 वाला overlap बात की जगह कहीं भी हो, उसे बचाता है।
Overlap की कीमत
Overlap मुफ़्त नहीं है, क्योंकि दोहराए गए tokens दो chunks में जाते हैं। 1,000 tokens के document को 50 tokens के chunks में काटिए, तो बिना overlap 1,000 ÷ 50 = 20 chunks बनते हैं। 10 tokens के overlap पर, यानी 20% पर, stride 40 है। तब chunks token 0, 40, …, 960 पर शुरू होते हैं, क्योंकि 960 वाला chunk document के अंत तक पहुँच जाता है। ये 960 ÷ 40 + 1 = 25 chunks हैं।
यानी 20% overlap पर 25% ज़्यादा embeddings बनाने और index में रखने पड़ते हैं।
4मतलब से काटना: headings, metadata और LLM
Semantic chunking text को वहाँ काटता है, जहाँ text खुद बँटा है, जैसे sentence या section के आख़िर में। इसकी ज़रूरत इसलिए है, क्योंकि fixed-size chunking गिनती से काटता है, और text का ढाँचा नहीं देखता। Widget में chunk size 20 और overlap 0 कीजिए। दूसरा chunk final report is due Week 10. से शुरू होकर office hours वाली बात में चला जाता है, यानी एक chunk में दो विषय।
Syllabus के हर हिस्से की अपनी heading है: Grading, Office hours और Project। Headings पर काटना semantic chunking का सबसे सीधा रूप है। Widget में Headings पर काटिए दबाइए। Syllabus 3 chunks में बँटता है, जिनमें 26, 16 और 12 शब्द हैं, और हर chunk एक ही विषय का है। Chunks का size अब बराबर नहीं है, और यही इस तरीके की कीमत है।
छोटा chunk फिर भी अपना context खो सकता है। Late days may not be applied to the milestone. अकेले ये नहीं बताता कि बात किस course की है। Context-enriched chunking इसके लिए हर chunk के साथ extra जानकारी रखता है, जैसे metadata या एक छोटी summary।
Metadata यानी data के बारे में data: document का नाम, section और तारीख। Context-enriched chunk कुछ ऐसा दिख सकता है: मेरा example
[Source: CS 329Z syllabus, section: Grading, updated: 30 Sep 2026] Late days may not be applied to the milestone.
अब छोटा chunk भी बताता है कि वो किस course और किस section का है। Lesson 8 इसी idea का सबसे असरदार रूप दिखाता है, जिसमें LLM हर chunk के लिए context लिखता है।
आख़िरी तरीका AI-driven dynamic chunking है। ये LLM से पूछता है कि text में बात कहाँ बदलती है, और वहीं काटता है। ये headings न होने पर भी चलता है। लेकिन हर document को एक बार LLM से गुज़ारना पड़ता है, और उसमें समय और पैसा लगता है।
तरीका
फ़ायदा
कीमत
Fixed-size
आसान, हर chunk बराबर
बात बीच से टूट सकती है
Fixed-size + overlap
टूटी बात दूसरे chunk में पूरी
ज़्यादा chunks, दोहराई हुई बातें
Semantic, जैसे headings
हर chunk एक विषय का
Chunks का size ऊपर-नीचे होता है
Context-enriched
छोटे chunk को भी context मिलता है
Metadata या summary बनानी पड़ती है
AI-driven
बिना headings के भी मतलब वाली boundaries
हर document पर LLM calls, धीमा और महँगा
अब शुरू वाले सवाल पर लौटिए। Headings पर काटने से Grading वाले chunk में milestone की पूरी तारीख है, और उसमें एक ही विषय है। यानी टूटी तारीख और घुला हुआ vector, दोनों दिक्कतें इस document पर एक साथ हल हो जाती हैं। हर document में साफ़ headings नहीं होतीं, इसलिए बाकी तरीके भी काम आते हैं।
अब आप Stanford की दोनों chunking slides पढ़ सकते हैं। पहली slide चारों तरीके गिनाती है, और दूसरी हमारे syllabus को तीन तरह से काटती है।
Stanford की slide: Chunking: Basic Unit in Retrieval। ऊपर fixed-size chunking और overlap हैं (पड़ाव 2 और 3), और नीचे बाकी तीन तरीके (पड़ाव 4)।Stanford की slide: Chunking: Same Text, Three Splits। ऊपर हमारा syllabus है। नीचे बाएँ 50 tokens पर टूटी तारीख है, बीच में overlap से बची तारीख, और दाएँ headings पर कटा और साफ़ करके दोबारा लिखा chunk।
गहरे version में और क्या है
गहरे version में ये पूरा lesson है, और उसके बाद 4 पड़ाव और, जो Stanford की slides के level तक ले जाते हैं:
पड़ाव 5: mean pooling का गणित। k बराबर विषयों पर cosine 1/√k, और थोड़े हिस्से वाली बात का घुलना।
पड़ाव 6: overlap का पूरा हिसाब। कम overlap पर बात बचने का chance, slide की 10 से 20% वाली सलाह, और chunks गिनने का formula।
पड़ाव 7: तरीके अंदर से। Databricks guide की sizes, recursive splitting, sentence vectors से boundary, और LLM chunking की कीमत।
पड़ाव 8: Stanford की तीनों slides, जिन्हें आप खुद पढ़ते हैं।
Retrieval को हर chunk का एक vector चाहिए, और ये अक्सर contextual token vectors का औसत होता है, यानी mean pooling। Tokens कितने भी हों, vector में numbers उतने ही रहते हैं।
छोटा chunk context खोता है, और बड़ा chunk कई विषयों का औसत बनकर cosine गिराता है, जैसे 1.00 से 0.71।
L tokens की बात बचाने के लिए overlap कम से कम L − 1 चाहिए, जैसे 7 शब्दों की तारीख के लिए 6। Headings पर काटने से बात टूटती ही नहीं, और metadata छोटे chunk को उसका context देता है।
इस lesson के नए शब्द
Word type और token in context
Dictionary का एक शब्द, और किसी sentence में उसका एक इस्तेमाल। जैसे late एक word type है, और Late days may not be applied में उसका इस्तेमाल एक token in context।
Static word embedding
हर word type का एक ही vector, context कुछ भी हो। जैसे word2vec और GloVe। Late का vector दोनों sentences में [0.5, 0.5] रहता है। मेरे numbers
Contextual embedding
हर token का अपने sentence के हिसाब से अलग vector। जैसे BERT। Late days may not be applied में late [0.1, 0.9] है, और late afternoon office hours में [0.9, 0.1]। मेरे numbers
Passage embedding
पूरे chunk का एक vector, जिसे retrieval का index रखता है। जैसे Sentence-BERT, DPR और E5 के vectors।
Multimodal embedding
Text और image, दोनों के vectors एक ही space में। जैसे CLIP। Whiteboard पर लिखे office hours की photo और text office hours schedule के vectors पास आ सकते हैं।
Graph embedding
किसी network के node या relation का vector। जैसे node2vec। Course के graph में TA, office hours, और उनके बीच का runs वाला relation।
Mean pooling
कई token vectors का औसत लेकर एक vector बनाना। जैसे [0.9, 0.1], [0.7, 0.3] और [0.8, 0.2] का औसत [0.8, 0.2]।
Chunk
Retrieval के लिए document का एक टुकड़ा, और retrieval की basic unit। जैसे 40 pages के syllabus का Grading वाला हिस्सा।
Fixed-size chunking
तय गिनती के tokens पर काटना, चाहे बात बीच में टूटे। जैसे हर 50 tokens पर।
Overlap
नया chunk पिछले chunk के आख़िरी कुछ tokens दोहराकर शुरू हो। L tokens की बात बचाने के लिए कम से कम L − 1। जैसे 7 शब्दों की तारीख के लिए 6।
Stride
दो लगातार chunks की शुरुआत के बीच की दूरी: chunk size − overlap। जैसे 9 − 6 = 3।
Semantic chunking
Sentence या section जैसी logical boundaries पर काटना। जैसे syllabus को Grading, Office hours और Project वाली headings पर।
Context-enriched chunking
हर chunk के साथ metadata या summary रखना। जैसे हर chunk के ऊपर Source: CS 329Z syllabus, section: Grading।
Metadata
Data के बारे में data: नाम, section, तारीख। जैसे CS 329Z syllabus, Grading, 30 Sep 2026।
AI-driven dynamic chunking
LLM से पूछकर काटना कि text में बात कहाँ बदलती है। हर document पर LLM calls लगती हैं।