Document को chunks में काटते ही हर chunk अपने आस-पास का text खो देता है, और अक्सर वही text बताता था कि बात किसकी है। ये lesson ये context लौटाने के दो तरीके सिखाता है। Contextual retrieval में एक LLM हर chunk का context लिखता है, और late chunking में encoder पहले पूरा document पढ़ता है।
Lesson 7 में queue log का chunk office hour averaged 3. नहीं बताता था कि किस दिन की बात है। ये lesson यही दिक्कत 50 companies की filings पर देखता है।
इस lesson की सीढ़ी
सीढ़ी में 4 पड़ाव हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
Context lossगिनकर दिखा पाएँगे कि ACME वाला chunk top-20 में सिर्फ़ 40% बार क्यों आता है।
Contextual retrievalScore के 1 से 5 होने का हिसाब, और failures के 5.7% से 2.9% पर आने का मतलब समझा पाएँगे।
Late chunkingNaive और late chunking के vectors हाथ से निकाल पाएँगे, और cosine से उनका फ़र्क दिखा पाएँगे।
पहले से क्या चाहिए: Lesson 2 (word overlap), Lesson 3 (embedding, cosine) और Lesson 7 (chunk, contextual embedding, mean pooling)। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1Context loss: काटने के बाद chunk नहीं बताता कि बात किसकी है
Context loss का मतलब है: काटने के बाद chunk में वो शब्द नहीं बचते, जो बताते कि बात किसकी है। document का वो टुकड़ा है, जिसे retriever लौटाता है। नाम अक्सर document में सबसे ऊपर एक बार आता है, इसलिए नीचे वाले chunks नाम के बिना रह जाते हैं।
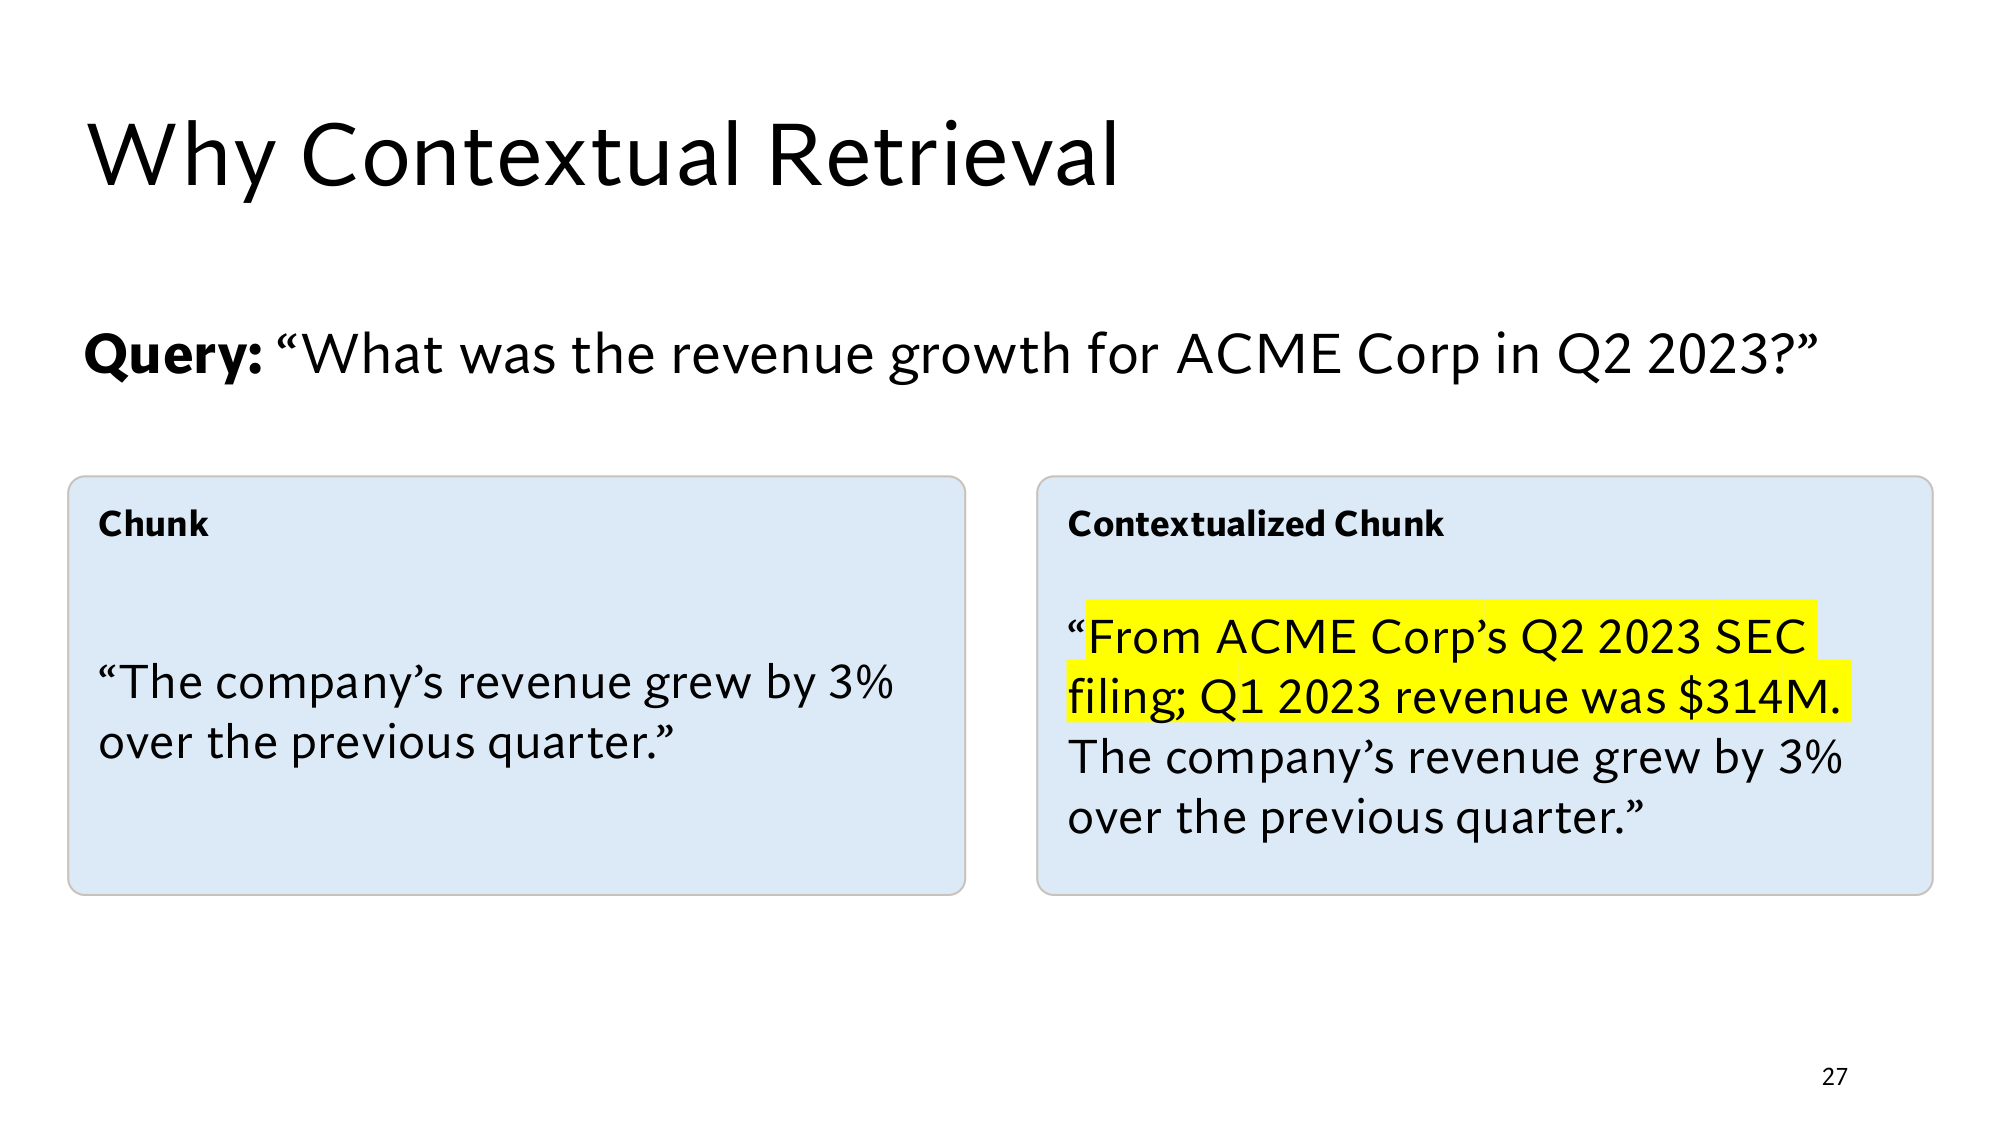
Slides का example लीजिए। Corpus में 50 companies की Q2 2023 वाली filings हैं, हर company की एक। 50 companies मेरा example है हर filing में लगभग यही line है: The company’s revenue grew by X% over the previous quarter. Query है: What was the revenue growth for ACME Corp in Q2 2023? ACME की filing में नाम और quarter सबसे ऊपर लिखे हैं, इसलिए जवाब वाले chunk में न ACME है, न Q2 2023।
अब lesson 2 के से गिनिए, यानी query के कितने शब्द chunk में भी हैं। वहाँ queue log का score 2 था, क्योंकि उसमें office और hour थे। What, was, the, for और in जैसे हटाने पर query के 6 शब्द बचते हैं: revenue, growth, ACME, Corp, Q2 और 2023। ACME वाले chunk में सिर्फ़ revenue है, क्योंकि उसमें growth नहीं, grew लिखा है। इसलिए उसका score 1 है, और बाकी 49 chunks का भी 1। ये गिनती मेरी है
पहले सोचिए
पचासों chunks का score 1 है, और बराबर score वाले chunks का क्रम random है। Retriever top-20 लौटाता है। ACME वाला chunk कितने % बार top-20 में आएगा?
जवाब देखिए
बराबरी में ACME वाला chunk 50 में से हर जगह पर बराबर मौके से आ सकता है। इनमें से 20 जगहें top-20 में हैं, इसलिए मौका 20 ÷ 50 = 0.4, यानी 40% है। बाकी 60% बार सही chunk top-20 से बाहर रहता है।
यानी जवाब corpus में है, फिर भी retriever उसे 60% बार नहीं लौटाता। Embedding भी नहीं बचाता, क्योंकि embedding model सिर्फ़ chunk का text पढ़ता है। उस text में ACME लिखा ही नहीं, इसलिए vector में ACME की कोई जानकारी नहीं आ सकती।
Lesson 7 का हर chunk के साथ metadata रखता है, लेकिन 60,000 chunks का metadata हाथ से कोई नहीं लिखेगा।
2Contextual retrieval: LLM हर chunk के आगे उसका context लिखता है
Contextual retrieval हर chunk के आगे एक छोटा context जोड़ता है, जिसे एक LLM पूरा document पढ़कर लिखता है। Anthropic ने ये तरीका 2024 में publish किया। ये पर, यानी queries आने से पहले, चार steps चलाता है:
हर chunk के लिए LLM को पूरा document और वो chunk दीजिए।
LLM उस chunk का 50 से 100 tokens का छोटा context लिखता है।
उस context को chunk के आगे जोड़िए। इस नए text को contextualized chunk कहते हैं।
Contextualized chunk का embedding बनाइए, और उसे शब्दों वाले index में भी डालिए, जो lesson 11 में आता है।
ACME वाले chunk के आगे LLM ये context लिखता है। रंगीन हिस्सा LLM का लिखा है, और बाकी पुराना chunk:
From ACME Corp’s Q2 2023 SEC filing; Q1 2023 revenue was $314M. The company’s revenue grew by 3% over the previous quarter.
Stanford की slide: ऊपर query, बाएँ अकेला chunk, और दाएँ वही chunk, पीले context के साथ। Image पर click करने से वो पूरे size में खुलती है।
पहले सोचिए
Query के 6 शब्द revenue, growth, ACME, Corp, Q2 और 2023 हैं। Contextualized chunk का word overlap score अब कितना है? दूसरी companies के contextualized chunks का कितना होगा?
जवाब देखिए
ACME वाले chunk का score 5 है: revenue, ACME, Corp, Q2 और 2023। Growth अब भी नहीं है। दूसरी companies के context में उनका अपना नाम होगा, इसलिए उनका score ज़्यादा से ज़्यादा 3 है: revenue, Q2 और 2023। ये गिनती मेरी है
Context जुड़ने पर ACME वाला chunk 49 chunks की बराबरी से निकलकर सबसे ऊपर आ गया। Embedding model को भी अब ऐसा text मिलता है, जिसमें ACME और Q2 2023 लिखे हैं।
Anthropic के नतीजे: failed retrievals@20
Anthropic ने ये तरीका असली data पर नापा। मानिए कि हर query का एक सही chunk है। तब failed retrievals@20 बताता है कि कितने % queries में वो chunk top-20 में नहीं आया। ये number जितना छोटा, उतना अच्छा।
तरीका
Failed retrievals@20
5.7% से कितनी कमी
Embedding, आम chunks
5.7%
शुरुआत
Embedding + शब्दों वाला index, आम chunks
5.0%
12%
Embedding, contextualized chunks
3.7%
35%
Embedding + शब्दों वाला index, contextualized chunks
2.9%
49%
तीसरी row की कमी 1,000 queries पर साफ़ दिखती है:
आम chunks पर 5.7% × 1,000 = 57 queries fail होती हैं।
Contextualized chunks पर 3.7% × 1,000 = 37 queries fail होती हैं।
57 − 37 = 20 queries बचीं, और 20 ÷ 57 = 0.35। यानी failures 35% कम हुईं।
Failure rate सिर्फ़ 2 points गिरा, 5.7 से 3.7, लेकिन failures 35% घटीं। Points वाली कमी 5.7 − 3.7 है, और % वाली कमी उसी को शुरुआत वाले 5.7 से भाग देती है। शब्दों वाला index भी साथ हो, तो failures 2.9% पर आती हैं, यानी (5.7 − 2.9) ÷ 5.7 = 0.49, करीब आधी। दोनों index की lists मिलाने का तरीका lesson 14 में है।
इसकी कीमत indexing time पर है: हर chunk पर एक LLM call, और हर call में पूरा document। 60,000 chunks हों, तो 60,000 calls लगती हैं। Query time पर कोई extra खर्च नहीं है, क्योंकि context पहले से index में है। एक खतरा भी है: LLM का लिखा context गलत हो, तो वो गलती index में बैठी रहती है।
3Late chunking: पहले पूरा document encode, फिर chunk का औसत
LLM calls महँगी हैं, इसलिए अगला सवाल ये है कि क्या encoder खुद chunk को context दे सकता है। Lesson 7 का हर token का vector आस-पास के शब्दों से बनाता है। जैसे वहाँ late का vector एक sentence में [0.1, 0.9] था, और दूसरे में [0.9, 0.1]। लेकिन encoder सिर्फ़ उतना text देखता है, जितना उसे मिला।
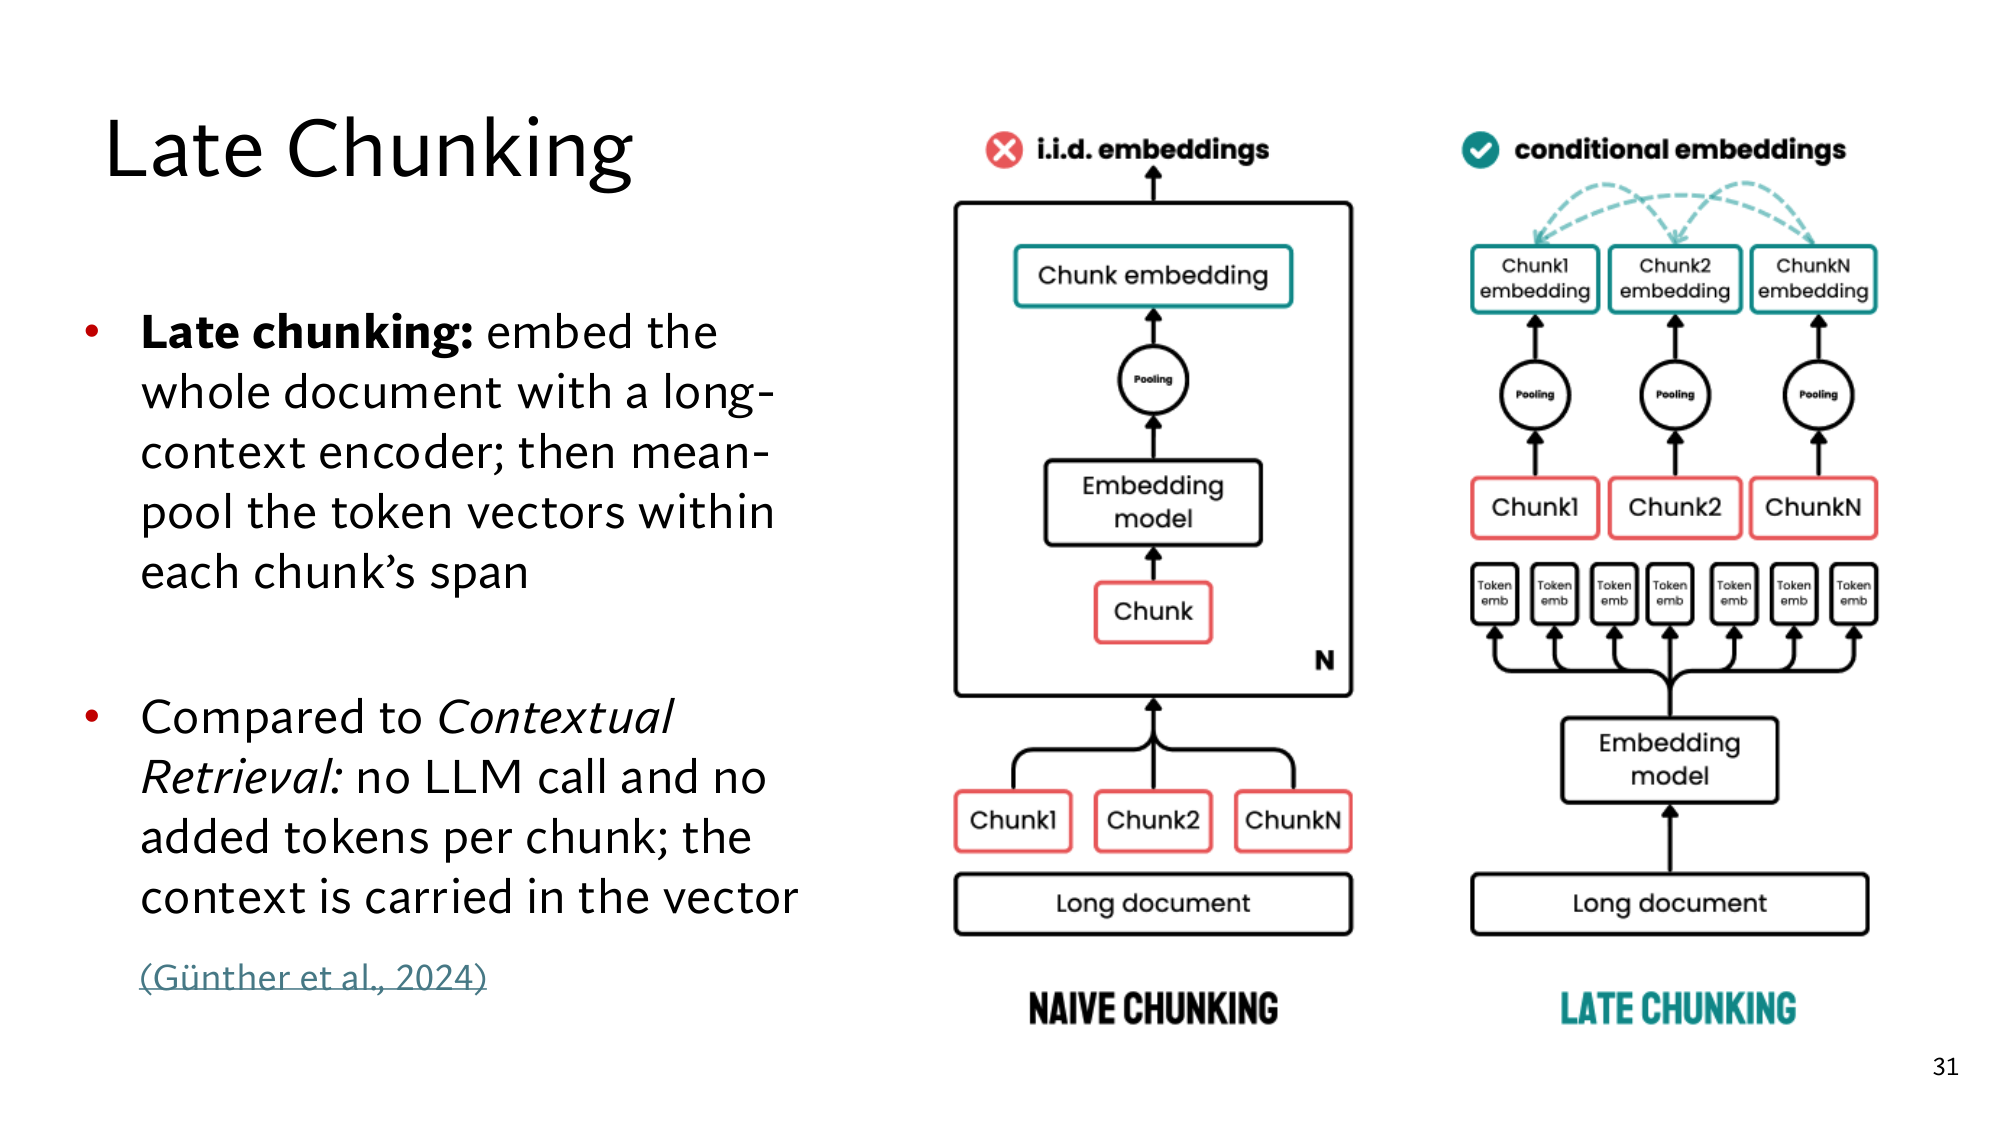
आम तरीका encoder को सिर्फ़ chunk देता है: पहले काटिए, फिर हर chunk को अलग से encode कीजिए। इसे naive chunking कहते हैं। इसमें chunk के tokens को बाकी document की कोई खबर नहीं होती।
Late chunking ये क्रम उल्टा कर देता है: encoder पहले पूरा document पढ़ता है, और काटना उसके बाद होता है।
पूरा document एक long-context encoder में डालिए, यानी ऐसे encoder में, जो एक बार में बहुत लंबा text पढ़ सके। जैसे 8,192 tokens, करीब 10 pages। paper से
Encoder हर token का vector देता है, और हर vector पूरे document को देखकर बनता है।
हर chunk के tokens के vectors का औसत लीजिए। ये उस chunk का vector है।
ये औसत lesson 7 वाली है, जैसे [0.9, 0.1], [0.7, 0.3] और [0.8, 0.2] से [0.8, 0.2]। काटना encoding के बाद, यानी देर से होता है, इसलिए नाम late है।
एक छोटा document लीजिए: CS 329Z project milestone policy. It is due Week 6. दूसरा chunk It is due Week 6 है। हर vector का पहला number बताता है कि बात milestone की कितनी है, और दूसरा कि homework की कितनी। numbers मेरे बनाए हैं
Token
Naive: chunk अकेला
Late: पूरा document
It
[0.5, 0.5]
[0.9, 0.1]
is
[0.5, 0.5]
[0.8, 0.2]
due
[0.6, 0.4]
[0.9, 0.1]
Week
[0.4, 0.6]
[0.9, 0.1]
6
[0.5, 0.5]
[1.0, 0.0]
Mean pooling
[0.5, 0.5]
[0.9, 0.1]
आख़िरी row ऐसे निकली:
Naive का पहला number: (0.5 + 0.5 + 0.6 + 0.4 + 0.5) ÷ 5 = 2.5 ÷ 5 = 0.5। दूसरा भी 0.5 आता है।
Naive में It को नहीं पता कि बात milestone की है या homework की, इसलिए vector बीच में है। Late में encoder ने पहला sentence भी पढ़ा था, इसलिए सारे tokens milestone की तरफ़ झुके।
Query When is the project milestone due? का vector [0.95, 0.05] मानिए। Lesson 3 की dot product को दोनों lengths के गुणा से भाग देती है, जैसे 0.74 ÷ (0.82 × 0.91) = 0.99। Naive chunk से cosine तीन steps में निकलता है:
Lengths: query की √(0.95² + 0.05²) = √0.905 = 0.951, और chunk की √(0.5² + 0.5²) = √0.5 = 0.707।
भाग: 0.5 ÷ (0.951 × 0.707) = 0.5 ÷ 0.672 = 0.74।
Late chunk [0.9, 0.1] पर यही हिसाब 0.86 ÷ (0.951 × 0.906) = 1.00 देता है। Late chunk की दिशा query से लगभग पूरी मिलती है, जबकि naive chunk 0.74 पर रह जाता है।
पहले सोचिए
अब homework वाली query लीजिए, vector [0.05, 0.95]। Naive chunk [0.5, 0.5] और late chunk [0.9, 0.1], दोनों से इसका cosine निकालिए। Naive chunk की कमज़ोरी क्या दिखी?
Naive chunk दोनों queries पर 0.74 देता है, यानी milestone वाला chunk homework के सवाल पर भी उतना ही ऊपर आता है। ये query मेरी है
Stanford की slide: बीच में naive chunking, और दाएँ late chunking।
Paper में 256 tokens वाले chunks पर late chunking का औसत score 52.2 से 54.0 हुआ। ये 0 से 100 तक का ranking score है, जिसे lesson 13 खोलता है। फ़ायदा सबसे छोटे chunks पर सबसे बड़ा है, क्योंकि छोटा chunk सबसे ज़्यादा context खोता है।
4दोनों तरीकों की तुलना: context text में या vector में
दोनों तरीके context अलग जगह रखते हैं: contextual retrieval उसे chunk के text में लिखता है, और late chunking सिर्फ़ vector में। बाकी फ़र्क इसी से निकलते हैं:
Contextual retrieval
Late chunking
Context कौन देता है
LLM, text लिखकर
Encoder, vectors में
Indexing का खर्च
हर chunk पर एक LLM call
हर document पर एक encoder run
Chunk लंबा होता है?
हाँ, 50–100 tokens
नहीं
शब्दों वाले index को फ़ायदा
हाँ, नए शब्द text में हैं
नहीं
ACME वाली query पर ये फ़र्क सीधा दिखता है। Late chunking के बाद भी chunk के text में ACME नहीं है, इसलिए word overlap का score 1 ही रहता है। यानी शब्दों वाले index पर सिर्फ़ contextual retrieval मदद करता है, और embedding पर दोनों। Late chunking की एक हद भी है: पूरा document encoder की लंबाई की limit में आना चाहिए, नहीं तो context फिर कटता है।
पहले सोचिए
Corpus बहुत बड़ा है, LLM calls का budget कम है, chunks 64 tokens के हैं, और retriever सिर्फ़ embeddings पर चलता है। आप कौन सा तरीका लेंगे? Retriever सिर्फ़ शब्दों वाला index हो, तो?
जवाब देखिए
Late chunking। उसमें LLM call नहीं लगती, और छोटे chunks पर उसका फ़ायदा सबसे ज़्यादा है। सिर्फ़ शब्दों वाले index पर late chunking कुछ नहीं करता, क्योंकि उसका context text में नहीं जाता। तब contextual retrieval लीजिए।
गहरे version में और क्या है
गहरे version में ये पूरा lesson है, और उसके बाद 5 पड़ाव और, जो Stanford की slides के level तक ले जाते हैं:
पड़ाव 5: Anthropic की पूरी pipeline, prompt, metric, खर्च, और reranking के साथ 1.9%।
पड़ाव 6: Late chunking अंदर से: i.i.d. और conditional embeddings, attention, और paper का pooling formula।
पड़ाव 7: Paper के नतीजे, chunk size वाले charts, और long late chunking।
पड़ाव 8: दोनों तरीके एक ही ACME example पर, paper के cosine numbers के साथ।
पड़ाव 9: इस हिस्से की छहों Stanford slides, जिन्हें आप खुद पढ़ते हैं।
काटने से chunk अपना context खोता है। ACME वाला chunk 49 chunks के बराबर रह गया, और top-20 में सिर्फ़ 40% बार आता है।
Contextual retrieval हर chunk के आगे LLM से context लिखवाता है। Failed retrievals@20 5.7% से 3.7% पर आया, और शब्दों वाले index के साथ 2.9% पर।
Late chunking पहले पूरा document encode करता है, फिर हर chunk के token vectors का औसत लेता है। LLM call नहीं लगती, लेकिन context सिर्फ़ vector में रहता है।
इस lesson के नए शब्द
Context loss
काटने के बाद chunk ये न बता पाए कि वो किस document या विषय की बात है। जैसे The company’s revenue grew by 3% में company का नाम नहीं है।
Contextual retrieval
हर chunk के आगे LLM का लिखा 50–100 tokens का context जोड़कर index करना। जैसे From ACME Corp’s Q2 2023 SEC filing।
Failed retrievals@20
हर query का एक सही chunk हो, तो कितने % queries में वो top-20 में नहीं आया। छोटा बेहतर। जैसे 1,000 queries में 29 fail हों, तो 2.9%।
Naive chunking
पहले काटना, फिर हर chunk को अकेले encode करना। तब It is due Week 6 का vector [0.5, 0.5] रहता है।
Late chunking
पहले पूरा document encode करना, फिर हर chunk के token vectors पर mean pooling। तब It is due Week 6 का vector [0.9, 0.1] बनता है।
Long-context encoder
ऐसा encoder, जो एक बार में बहुत लंबा text पढ़ सके। जैसे 8,192 tokens, यानी करीब 10 pages।