BM25 एक retriever है, जो query के हर शब्द पर passage को एक वज़न देता है। इन वज़नों का जोड़ passage का score है। ये वज़न तीन बातों से बनता है: शब्द पूरे corpus में कितना rare है, passage में कितनी बार आया, और passage कितना लंबा है। Stanford की slide इसे आज भी सबसे ज़्यादा इस्तेमाल होने वाला retriever बताती है।
इसकी ज़रूरत lesson 2 में दिखी थी। गिनता है कि query के कितने शब्द passage में भी हैं। Query which office hour is least crowded पर उसने दो passages को बराबर 2 दिया। एक queue log है, जिसमें भीड़ का data और जवाब है। दूसरा 2024 का एक पुराना forum post है, जिसमें सिर्फ़ एक राय है। ये lesson BM25 के तीनों हिस्से एक-एक करके जोड़ता है, और हर बार tie देखता है।
इस lesson की सीढ़ी
सीढ़ी में 5 पड़ाव हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
पहले से क्या चाहिए: Lesson 2 (corpus, word overlap, stopwords, score), Lesson 3 (vector, embedding) और Lesson 4 (e और ln)। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1IDF: rare term को ज़्यादा वज़न
IDF हर शब्द को एक वज़न देता है, और शब्द जितने कम passages में आता है, उसका वज़न उतना बड़ा होता है। Search में query के ऐसे हर शब्द को term कहते हैं। यानी which और is जैसे बहुत आम शब्द, जिन्हें गिनती से पहले हटा देते हैं। इन्हें हटाने पर हमारी query में चार terms बचते हैं: office, hour, least और crowded।
office दो passages में है, और least और crowded सिर्फ़ forum post में, जबकि word overlap चारों को बराबर गिनता है। Term कितने passages में है, उस गिनती को document frequency कहते हैं, और उसे n लिखते हैं। हमारे corpus में N = 6 passages हैं, और milestone सिर्फ़ syllabus में है, यानी n = 1। उसका IDF तीन steps में निकलता है:
जिन passages में term नहीं है, उनकी गिनती में 0.5 जोड़िए: 6 − 1 + 0.5 = 5.5।
जिन passages में term है, उनकी गिनती में भी 0.5 जोड़िए: 1 + 0.5 = 1.5।
पहले number को दूसरे से भाग दीजिए, 5.5 ÷ 1.5 = 3.667, और उसका ln लीजिए: ln 3.667 = 1.299।
Step 3 का भाग बताता है कि term वाले हर एक passage के मुकाबले कितने passages में term नहीं है। 0.5 इसलिए जुड़ता है, ताकि कोई गिनती 0 हो, तब भी भाग बन सके।
Step 3 का lesson 4 से है। ln x वो number है, जिसे e = 2.718 की power बनाने से x मिलता है। जाँच: e1.2993 = 3.667, इसलिए ln 3.667 = 1.299। आगे एक नियम काम आएगा: ln 1 = 0, क्योंकि e0 = 1।
इस वज़न को IDF कहते हैं, यानी inverse document frequency: n जितना छोटा, IDF उतना बड़ा। Formula में यही तीन steps हैं:
IDF = ln N − n + 0.5n + 0.5
Term, और किन passages में
n
हिसाब
IDF
milestonesyllabus
1
ln(5.5 ÷ 1.5)
1.299
officeoffice hours page, queue log
2
ln(4.5 ÷ 2.5)
0.588
thursdaysyllabus, office hours page, queue log
3
ln(3.5 ÷ 3.5)
0
thursday आधे passages में है, उसका भाग 1 है, और ln 1 = 0, इसलिए उसका वज़न 0 है।
अब हमारी query के terms लीजिए। office का IDF 0.588 है। hour सिर्फ़ queue log में है, क्योंकि office hours page पर hours लिखा है, hour नहीं, और retriever इन्हें अलग शब्द मानता है। इसलिए hour, least और crowded, तीनों का n = 1 है, और IDF 1.299।
पहले सोचिए
हर term को अभी एक ही बार गिनिए, और सिर्फ़ उसका IDF जोड़िए। Forum post और queue log का score कितना होगा, और tie किस तरफ़ टूटेगा?
जवाब देखिए
4 decimal तक IDF लेकर forum post को 1.2993 + 1.2993 = 2.599 मिलता है, और queue log को 0.5878 + 1.2993 = 1.887। Tie टूट गया, लेकिन forum post की तरफ़, क्योंकि उसके दोनों terms rare हैं, और queue log का office आम है।
लेकिन queue log में office hour दो बार आता है, Tuesday और Thursday के लिए, और IDF उसे एक ही बार गिनता है। अगला पड़ाव यही गिनती जोड़ता है।
2Term frequency और saturation: गिनती का फ़ायदा एक छत तक
Term frequency f बताती है कि term एक passage में कितनी बार आया। Queue log में office और hour, दोनों की f = 2 है। लेकिन term का पहली बार आना बताता है कि passage उस बारे में है, और दसवीं बार आना उसमें बहुत कम जोड़ता है। इसलिए BM25 सीधे f से गुणा नहीं करता।
वो f से एक नया number बनाता है, जिसे ये lesson TF हिस्सा कहेगा। अभी passage की length को छोड़िए, वो पड़ाव 3 में आती है:
TF हिस्सा = f × 2.2f + 1.2
f = 2 पर इसका हिसाब तीन steps में है:
ऊपर का हिस्सा: 2 × 2.2 = 4.4।
नीचे का हिस्सा: 2 + 1.2 = 3.2।
भाग: 4.4 ÷ 3.2 = 1.375।
जाँच: f = 1 पर ऊपर 2.2 और नीचे 2.2 है, तो हिस्सा ठीक 1। अब f बढ़ाकर देखिए:
f
TF हिस्सा
1
1.000
2
1.375
5
1.774
10
1.964
1 से 2 बार होने पर हिस्सा 0.375 बढ़ा, और 5 से 10 बार होने पर सिर्फ़ 0.190। f बड़ा होने पर नीचे का 1.2 उसके मुकाबले छोटा पड़ जाता है, इसलिए हिस्सा 2.2 के पास पहुँचता है, पर उसे छूता नहीं। इसे saturation कहते हैं: हर अगली गिनती पिछली से कम जोड़ती है, और हिस्सा एक छत से ऊपर नहीं जाता।
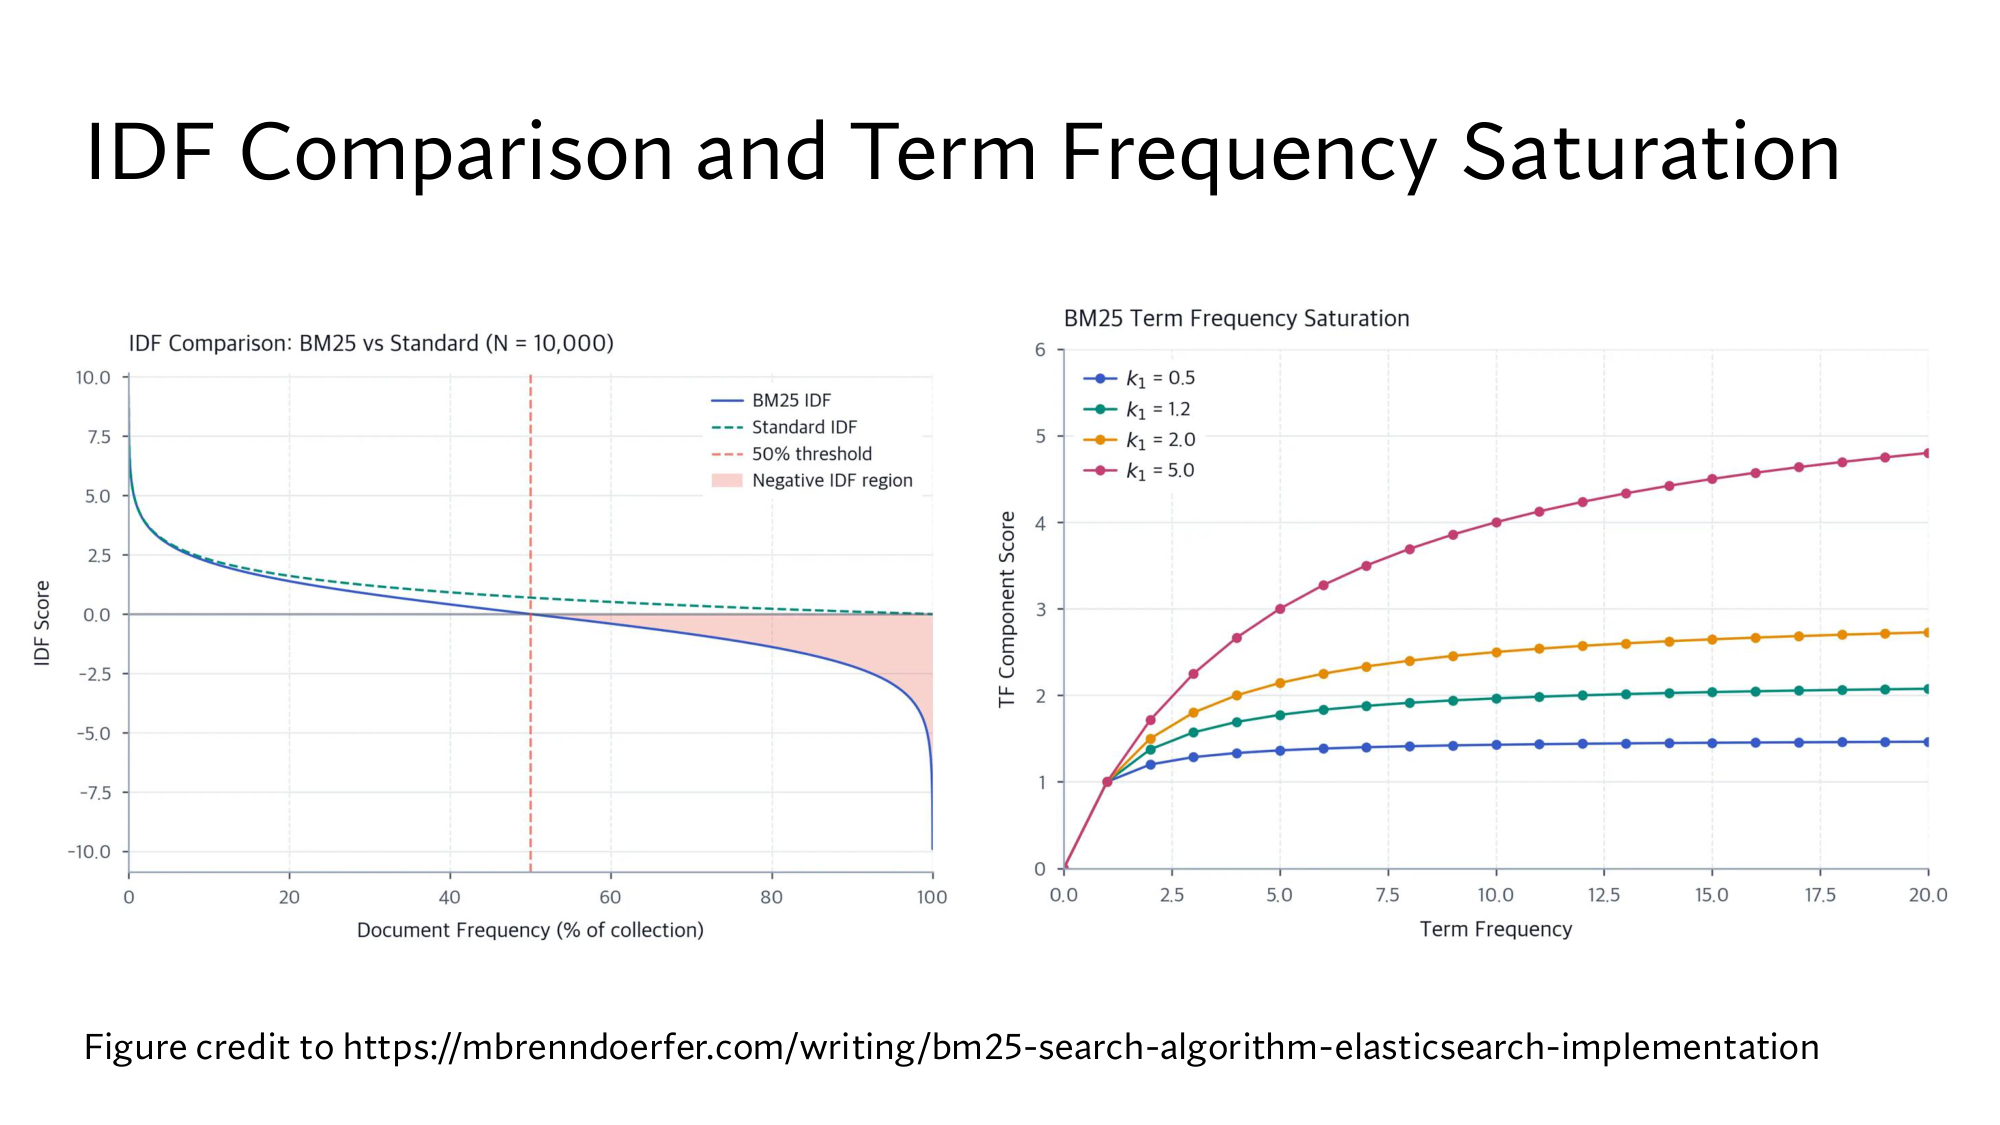
Formula का 1.2 एक knob है, जिसका नाम k1 है, और छत 2.2 असल में k1 + 1 है। k1 छोटा हो, तो छत नीची है और हिस्सा जल्दी भरता है। k1 = 1.2 मेरा चुना है, slide के graph में भी ये line है
अब queue log पर लौटिए। उसमें office और hour दो-दो बार हैं, तो दोनों का TF हिस्सा 1.375 है, और score = 0.588 × 1.375 + 1.299 × 1.375 = 2.595। Forum post के दोनों terms एक-एक बार हैं, तो उसका score 2.599 ही रहा। गिनती जोड़ने से queue log लगभग बराबर आ गया, और फ़र्क सिर्फ़ 0.004 बचा।
पहले सोचिए
k1 = 0 हो, तो TF हिस्सा क्या बन जाता है? पड़ाव 1 के scores से इसका क्या रिश्ता है?
जवाब देखिए
Formula f × 1 ÷ (f + 0) बन जाता है, यानी f ÷ f = 1, अगर f कम से कम 1 है। ये lesson 2 वाला word overlap है, बस IDF के वज़न के साथ। पड़ाव 1 के 2.599 और 1.887 यही k1 = 0 वाले scores थे।
Stanford की slide: दाएँ चार k1 के लिए TF हिस्सा, और बाएँ IDF।
3Length normalization: लंबे passage में term का वज़न घटाना
Length normalization लंबे passage में आए term का TF हिस्सा घटाती है, और छोटे passage में आए term का बढ़ाती है। 1,000 शब्दों के document में office एक बार आना, 20 शब्दों के passage में एक बार आने से कम बताता है।
इसके लिए BM25 हर passage की length को corpus की औसत length से मिलाता है। Passage की length शब्दों में |D| लिखते हैं, और औसत length को avgdl। औसत यानी सारी lengths का जोड़, passages की गिनती से भाग:
जाँच: 16.17 × 6 = 97.02, यानी करीब 97। अब BM25 TF हिस्से के नीचे वाले k1 को इस factor से गुणा करता है:
factor = 1 − b + b × |D|avgdl
|D| ÷ avgdl बताता है कि passage औसत का कितना गुना है। b एक दूसरा knob है, 0 से 1 के बीच, जो तय करता है कि length का कितना असर हो। Queue log के लिए, b = 0.75 पर, factor तीन steps में निकलता है: b = 0.75 मेरा चुना है
|D| ÷ avgdl = 19 ÷ 16.17 = 1.175।
b से गुणा: 0.75 × 1.175 = 0.881।
1 − b जोड़िए: 0.25 + 0.881 = 1.131।
जाँच: औसत length पर factor 0.25 + 0.75 = 1 है, यानी कोई बदलाव नहीं। औसत से लंबे passage का factor 1 से बड़ा है, इसलिए उसका TF हिस्सा छोटा है। जैसे f = 1 पर दोगुनी length वाले passage का हिस्सा 1.000 से घटकर 0.710 रह जाता है।
इसे length normalization कहते हैं। b = 0 पर factor हमेशा 1 है, यानी length का कोई असर नहीं, और b = 1 पर पूरा असर। हमारे passages में queue log 19 शब्दों का है, औसत से लंबा, तो उसका factor 1.131 है। Forum post 14 शब्दों का है, तो उसका factor 0.25 + 0.75 × 14 ÷ 16.17 = 0.899 है।
पहले सोचिए
b = 1 है, और passage औसत से दोगुना लंबा। f = 1 और k1 = 1.2 पर TF हिस्सा कितना होगा?
जवाब देखिए
Factor = 1 − 1 + 1 × 2 = 2। हिस्सा = 2.2 ÷ (1 + 1.2 × 2) = 2.2 ÷ 3.4 = 0.647। ये b = 0.75 वाले 0.710 से भी कम है, क्योंकि length का पूरा असर लगा।
4तीनों हिस्से एक formula में: BM25
BM25 score हर query term के IDF और TF हिस्से का गुणा है, सारे terms पर जोड़कर। जो term passage में नहीं है, उसका हिस्सा 0 है। पूरा हिसाब queue log के office पर कीजिए: f = 2, और पड़ाव 3 का factor, 4 decimal तक 1.1314।
Forum post के least पर factor 0.8995 है, तो TF हिस्सा 2.2 ÷ (1 + 1.2 × 0.8995) = 2.2 ÷ 2.0794 = 1.0580 है। Query which office hour is least crowded, k1 = 1.2 और b = 0.75 पर पूरा हिसाब ये है:
BM25 पुराने forum post को queue log से ऊपर रखता है, 2.749 बनाम 2.473। Length ने पड़ाव 2 का 0.004 का फ़र्क बढ़ाकर 0.276 कर दिया। Formula सिर्फ़ शब्द गिनता है, और उसका कोई हिस्सा ये नहीं देखता कि forum post 2024 की राय है और queue log ताज़ा data।
Stanford की slide यही हिसाब एक formula में लिखती है:
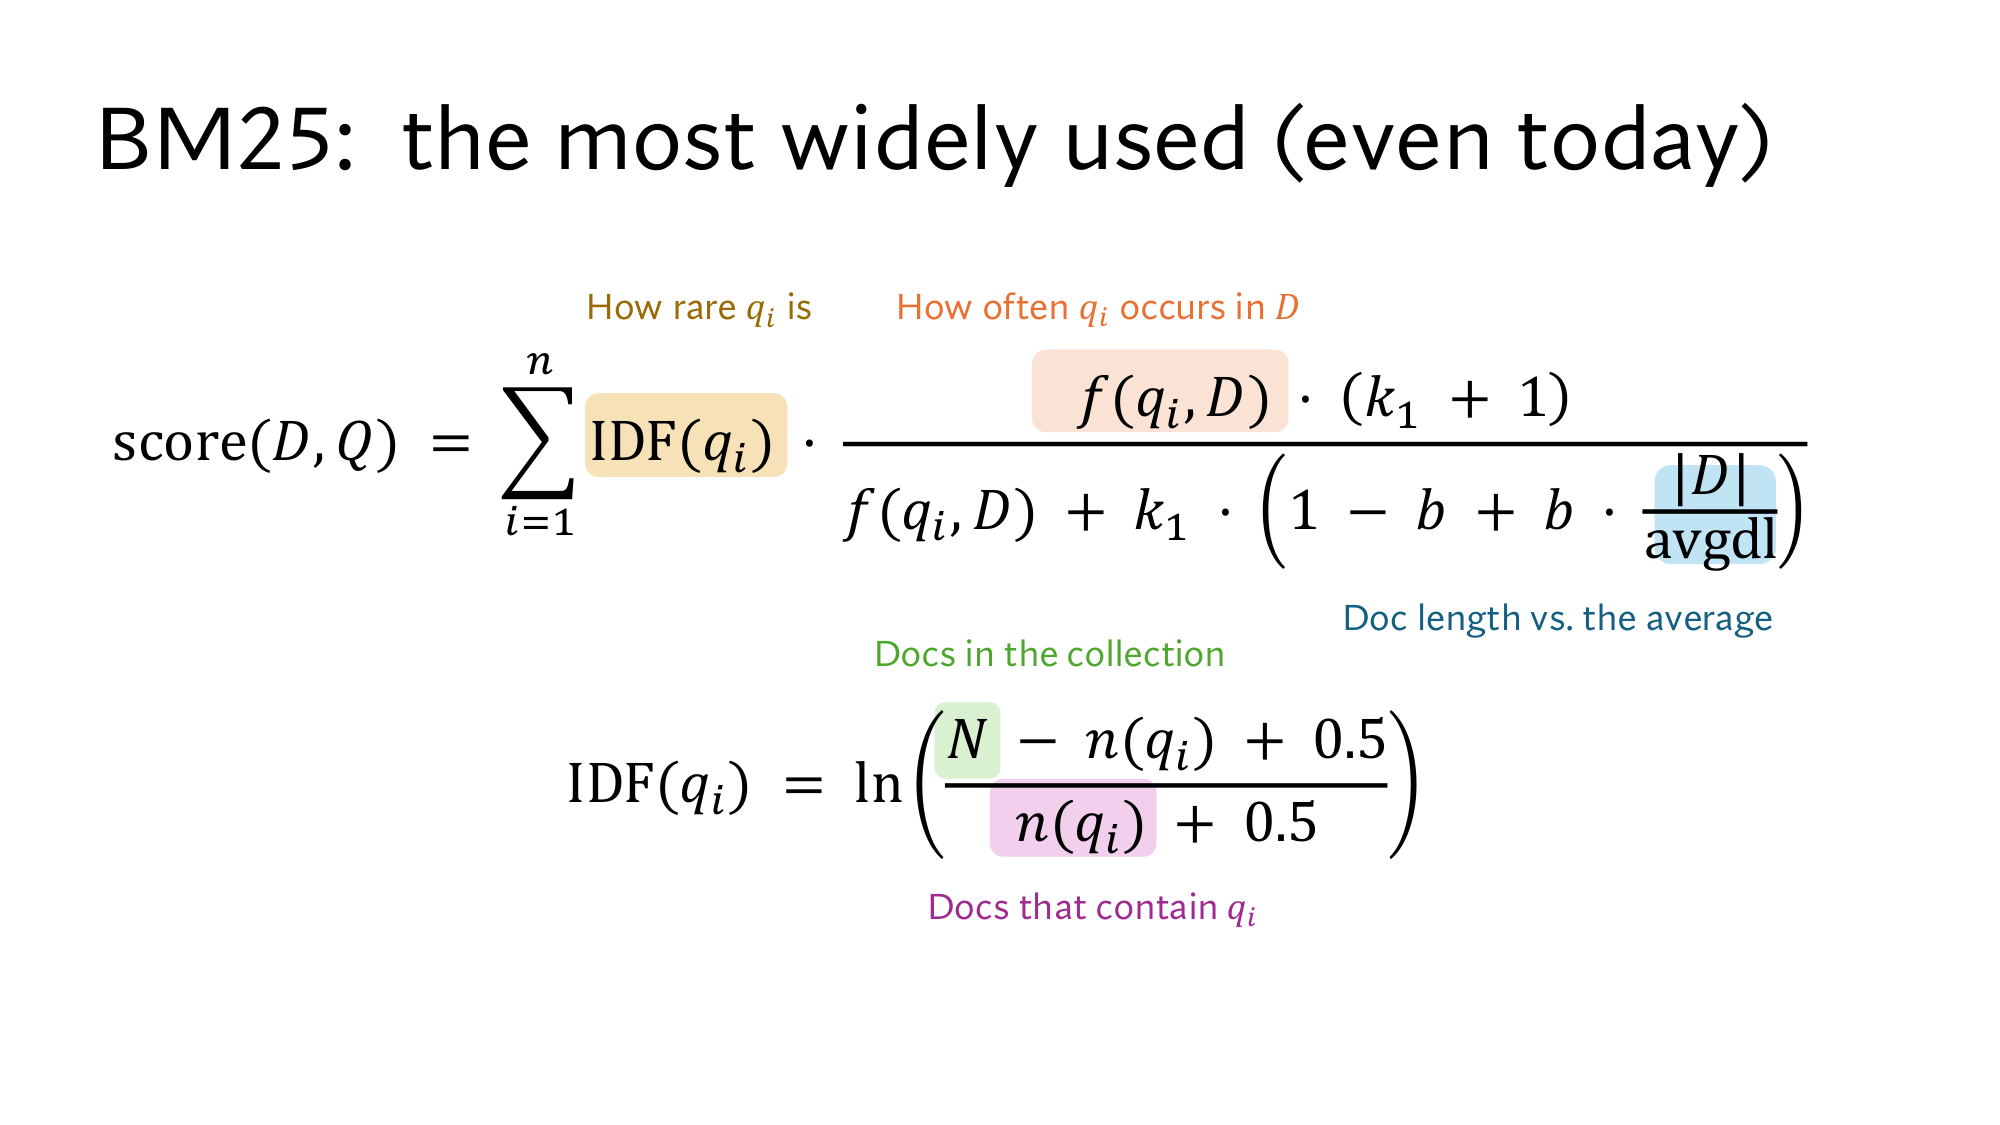
score(D, Q) = ∑i = 1 … n IDF(qi) · f(qi, D) · (k1 + 1)f(qi, D) + k1 · (1 − b + b · |D| ÷ avgdl)
lesson 3 से है। इसका मतलब है: नीचे लिखे i से ऊपर लिखे n तक, हर i के लिए आगे वाली चीज़ निकालिए, और सब जोड़ दीजिए। यहाँ i = 1 से 4 तक: 0.7703 + 1.7026 + 0 + 0 = 2.473। Formula में “·” गुणा का निशान है, D वो passage है जिसका score चाहिए, और qi query का i-वाँ term। बाकी हिस्से पड़ाव 1 से 3 के हैं।
Stanford की slide: BM25, the most widely used। रंग वाले हिस्से IDF, f और |D| ÷ avgdl हैं, और नीचे पड़ाव 1 का IDF formula है।
Office hours page वाली row आप निकालिए
Office hours page 16 शब्दों का है, और उसमें office एक बार है। उसका factor, TF हिस्सा और score कितना है?
Query चुनिए, और k1 और b बदलिए। तीन buttons पहले तीन पड़ाव हैं, और हर cell में term की f और उसका वज़न है।
Passage
|D|
Terms
Score
तीसरी query when can I get help from a TA पर हर score 0 है, और इसकी वजह पड़ाव 5 में आती है।
5Inverted index: BM25 तेज़ क्यों है, और कहाँ हारता है
Inverted index हर term के लिए उन passages की list है, जिनमें वो term आता है। BM25 ये lists , यानी सवाल आने से पहले, एक बार बनाता है। हमारी query के terms की lists ऐसी दिखती हैं:
office → office hours page, queue log
hour → queue log
least → पुराना forum post
crowded → पुराना forum post
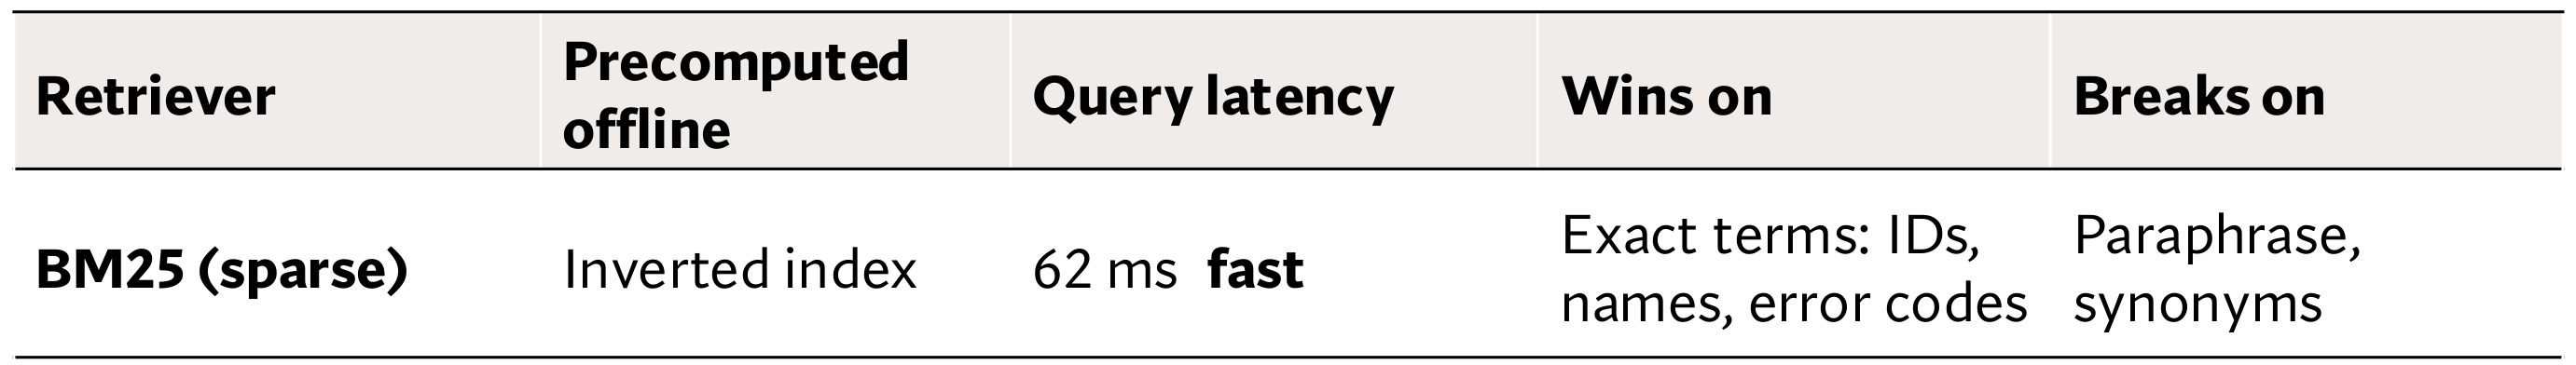
सवाल आने पर BM25 सिर्फ़ ये 4 lists खोलता है, और बाकी 3 passages को छूता भी नहीं। इसलिए वो तेज़ है, और Stanford की तुलना वाली slide में एक बड़े dataset पर 62 ms में जवाब देता है।
BM25 की नज़र में हर passage एक लंबा vector है, जिसमें vocabulary के हर शब्द की एक जगह है। हमारे 69 शब्दों में से forum post में 14 हैं, तो उसकी 55 जगहें 0 हैं, और ऐसे vector को sparse कहते हैं। Lesson 3 के dense हैं: 768 numbers, और लगभग कोई 0 नहीं।
Stanford की slide: Fast vs Slow Retrievers, उसकी BM25 वाली row। बाकी rows lesson 12, 14 और 15 में आती हैं।
उसी row के मुताबिक BM25 exact terms पर जीतता है, जैसे IDs, नाम और error codes। E-4012 जैसा code या तो passage में है या नहीं, और rare होने की वजह से उसका IDF ऊँचा है।
BM25 paraphrase और synonyms पर हारता है, यानी वही बात दूसरे शब्दों में। Widget की तीसरी query का जवाब office hours page में है, लेकिन वहाँ TAs लिखा है, ta नहीं, और help कहीं नहीं है। इसलिए हर score 0 आता है।
Forum post वाली गलती भी यहीं से आती है, क्योंकि BM25 सिर्फ़ शब्द गिनता है। Lesson 12 सवाल-passage जोड़ों से सीखने वाला retriever बनाता है, और lesson 14 दोनों की lists मिलाता है।
गहरे version में और क्या है
6. Slide के symbols, n के दो मतलब, k1 + 1, और length की पूरी table।
7. ln के दो और नियम, negative IDF, TF-IDF, 0.5 की वजह, और दोनों graphs।
8. k1 और b कौन चुनता है, और किन values पर queue log ऊपर आता है।
9. Index में क्या रहता है, sparse dot product, 62 ms का data, और papers के examples।
10. चारों Stanford slides, जिन्हें आप खुद पढ़ते हैं।