Vector search का काम है: query के vector के सबसे पास वाले k vectors ढूँढना। ये lesson ऐसे तरीके सिखाता है, जो हर vector देखे बिना ज़्यादातर बार वही k vectors ढूँढ लेते हैं।Lesson 3 का retriever हर query पर index के हर vector से तुलना करता था। Lesson 2 की company के 60,000 passages पर ये पल भर का काम है, लेकिन 10 करोड़ passages पर हर query करीब 7.7 seconds लेगी। मेरा अंदाज़ा
Lesson 5 की search सबसे बड़े dot product वाले k passages ढूँढती है। उसे तेज़ करने का रास्ता भी यही है: हर vector मत देखिए। तब कभी-कभी सबसे पास वाला passage छूटता है, और ये lesson उस चूक को नापना भी सिखाता है।
इस lesson की सीढ़ी
सीढ़ी में 5 पड़ाव हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
पहले से क्या चाहिए: Lesson 3 (vector, dot product, length) और Lesson 9 (cluster, centroid, graph)। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1हर vector से तुलना: exact search और उसका खर्च
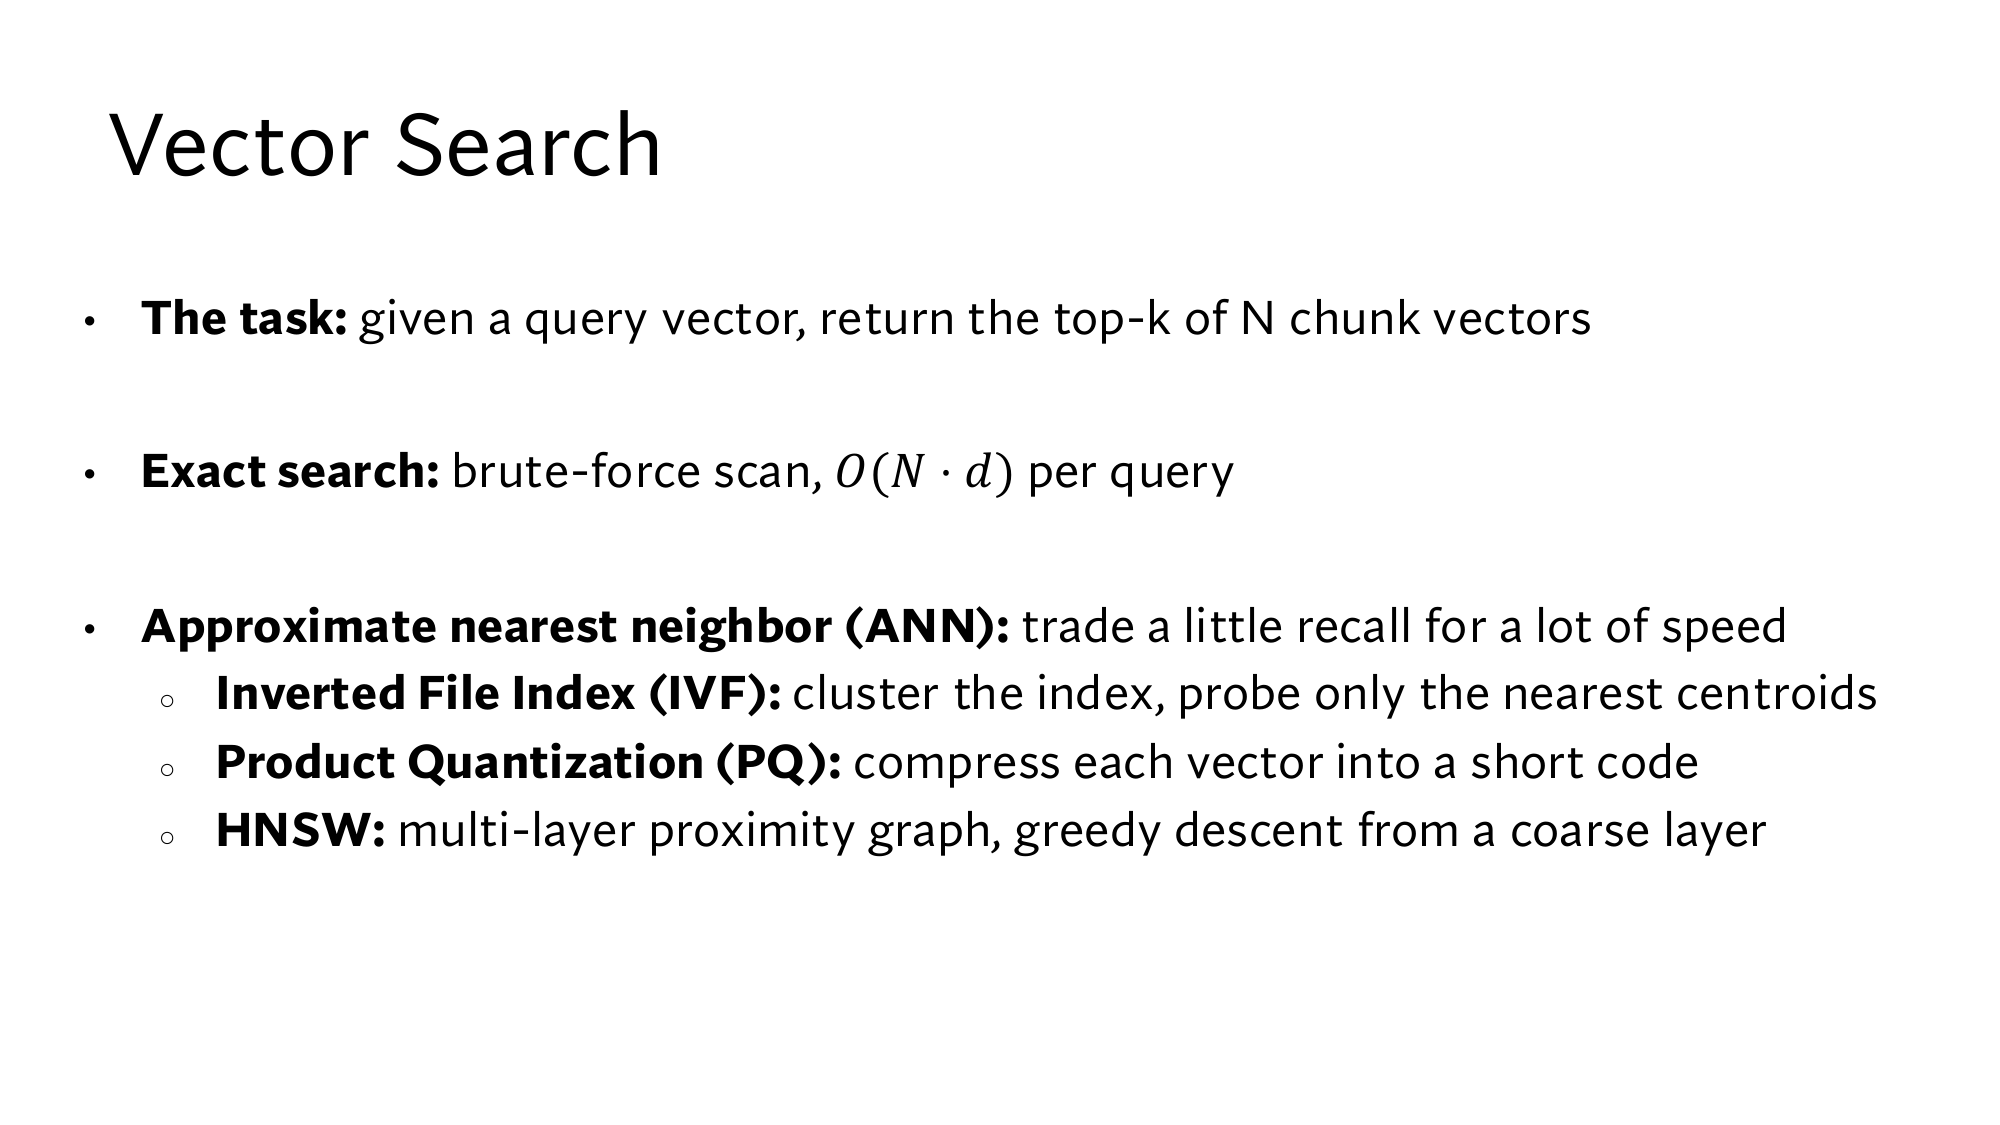
Stanford की slide पर vector search का काम ये है: query के vector के लिए index के N vectors में से top-k लौटाने हैं। सबसे सीधा तरीका हर vector से score निकालता है, और सबसे ऊँचे k scores वाले vectors लौटाता है। इसे exact search या brute force कहते हैं, क्योंकि ये बिना किसी तरकीब के सब कुछ देखता है।
इसका खर्च गिनना आसान है। Lesson 3 की query [0.8, 0.2] और office hours page [0.9, 0.1] का 0.8 × 0.9 + 0.2 × 0.1 = 0.74 है। इसमें 2 गुणा लगे। d numbers वाले vectors में d गुणा लगते हैं, इसलिए N vectors से तुलना में N × d गुणा लगते हैं।
असली vectors में d बड़ा है: BERT-base के vector में 768 numbers हैं, यानी d = 768। Speed के लिए एक मोटा अंदाज़ा लीजिए कि computer एक second में 1,000 करोड़ गुणा करता है। speed मेरा अंदाज़ा है
Corpus
एक query पर गुणा
एक query का समय
Lesson 2 की company60,000 passages
4.6 करोड़60,000 × 768
0.005 second
Lesson 5 का Wikipedia2.1 करोड़ passages
1,613 करोड़2.1 करोड़ × 768
1.6 seconds
बड़ा corpus10 करोड़ passages
7,680 करोड़10 करोड़ × 768
7.7 seconds
आख़िरी row दो steps में निकली:
एक query पर गुणा: 10 करोड़ × 768 = 7,680 करोड़।
समय: 7,680 करोड़ ÷ 1,000 करोड़ per second = 7.68 seconds, यानी करीब 7.7 seconds।
Slide इस खर्च को O(N·d) लिखती है, और इस लिखावट को Big-O कहते हैं। Big-O सही गिनती नहीं बताता। वो बताता है कि N या d बढ़ने पर खर्च किस हिसाब से बढ़ता है। O(N·d) का मतलब है कि N दोगुना हो, तो खर्च दोगुना, और d दोगुना हो, तब भी दोगुना। Table में N 60,000 से 10 करोड़ हुआ, यानी करीब 1,667 गुना, और समय भी 0.005 से 7.7 seconds, उतने ही गुना बढ़ा।
Brute force हमेशा असली top-k देता है, इसलिए छोटे corpus पर यही सबसे अच्छा तरीका है। दिक्कत सिर्फ़ बड़े corpus पर है, जहाँ हर query seconds लेती है।
2ANN: थोड़ा recall देकर बहुत speed
हर vector देखे बिना पक्का top-k नहीं मिल सकता, क्योंकि जो vector नहीं देखा, वही सबसे पास हो सकता है। इसलिए बड़े corpus पर एक सौदा करना पड़ता है: कम vectors देखिए, और ज़्यादातर बार सही जवाब पाइए। Query के सबसे पास वाले vectors को उसके nearest neighbors कहते हैं।
ANN, यानी approximate nearest neighbor search, वो तरीके हैं जो कुछ ही vectors देखकर ज़्यादातर बार असली nearest neighbors लौटाते हैं। Approximate का मतलब है लगभग। Slide इसे एक सौदा कहती है: trade a little recall for a lot of speed, यानी थोड़ा recall दीजिए, और बहुत speed लीजिए।
यहाँ का मतलब है: brute force जो असली top-10 देता, उनमें से ANN ने कितने लौटाए। ANN ने 10 में से 9 लौटाए, तो recall 9 ÷ 10 = 0.9 है। ANN जो passage छोड़ता है, वो reader तक कभी नहीं पहुँचता। इसलिए ये चूक lesson 2 वाली को नीचे लाती है।
Lesson 13 का Recall@k इससे अलग है। वहाँ सही जवाब इंसानों के labels से आता है, और यहाँ brute force के top-10 से।
दूरी: “पास” कैसे नापें
“पास” नापने के लिए इस lesson के तरीके दूरी लेते हैं। दो vectors की दूरी निकालने के लिए पहले एक ही जगह वाले numbers घटाइए, जिससे फ़र्क वाला vector बनता है। फिर उसकी लीजिए, यानी lesson 3 वाला हिसाब: हर number का square, सबका जोड़, फिर square root।
Lesson 3 की query [0.8, 0.2] और office hours page [0.9, 0.1] पर ये तीन steps में होता है:
फ़र्क: [0.9 − 0.8, 0.1 − 0.2] = [0.1, −0.1]।
Squares का जोड़: 0.1 × 0.1 + (−0.1) × (−0.1) = 0.01 + 0.01 = 0.02। Minus वाले number का square भी plus होता है।
Syllabus [0.1, 0.9] का फ़र्क [−0.7, 0.7] है, और उसकी दूरी √(0.49 + 0.49) = √0.98 = 0.99 है। दूरी जितनी छोटी, vector उतना पास, इसलिए office hours page query के ज़्यादा पास है।
Stanford की slide: vector search। पहली तीन lines अब आप पढ़ सकते हैं: काम, exact search का खर्च O(N·d), और ANN का सौदा। नीचे के तीन ANN तरीके, IVF, PQ और HNSW, अगले तीन पड़ावों में आते हैं। Image पर click करने से वो पूरे size में खुलती है।
3IVF: सिर्फ़ query के पास वाले clusters देखना
Query के nearest neighbors उसके आस-पास होंगे, इसलिए दूर के vectors देखना बेकार है। मुश्किल ये है कि किसी vector को देखे बिना पता नहीं चलता कि वो दूर है। इसमें lesson 9 का काम आता है, यानी किसी cluster के vectors का औसत। जैसे [0.1, 0.9], [0.2, 0.8] और [0.15, 0.85] का centroid [0.15, 0.85] है। Query किसी centroid से दूर है, तो उसके cluster के vectors भी ज़्यादातर दूर होंगे।
IVF (inverted file index) vectors को clusters में बाँटता है, और search के वक्त सिर्फ़ query के पास वाले clusters के vectors देखता है। इसका काम दो हिस्सों में बँटता है:
: हर vector अपने सबसे पास वाले centroid के cluster में जाता है, और हर centroid के साथ उसके vectors की एक list रहती है। इन lists का नाम inverted file है।
Online: query पहले सिर्फ़ centroids से मिलती है। फिर IVF सबसे पास वाले कुछ centroids चुनता है, और सिर्फ़ उनकी lists के vectors से दूरी निकालता है।
कितने clusters देखने हैं, उस number को nprobe कहते हैं। nprobe नाम slide पर नहीं है मान लीजिए 10 लाख vectors 1,000 clusters में बँटे हैं, यानी हर cluster में करीब 1,000 vectors। nprobe = 10 पर तुलनाएँ ऐसे गिनिए:
Centroids से: 1,000 तुलनाएँ।
चुने हुए 10 clusters के vectors से: 10 × 1,000 = 10,000 तुलनाएँ।
कुल 11,000, जबकि brute force में 10,00,000। 10,00,000 ÷ 11,000 = 91, यानी करीब 91 गुना कम काम।
पहले सोचिए
Query दो clusters के किनारे पर है, और nprobe = 1 है। क्या IVF असली सबसे पास वाला point ढूँढ लेगा?
जवाब देखिए
हमेशा नहीं। IVF सिर्फ़ उस cluster को देखता है, जिसका centroid query के सबसे पास है। किनारे वाली query का सबसे पास वाला point पड़ोसी cluster में भी हो सकता है। Widget में “Query किनारे पर” चुनकर देखिए।
IVF खुद चलाइए
40 points, 4 clusters। चौकोर boxes centroids हैं। Plane पर click करके query रखिए, और nprobe बदलिए। गहरे points वो हैं, जिन्हें IVF ने देखा। घेरे वाला point असली सबसे पास वाला है।
“Query किनारे पर” चुनिए। Query का सबसे पास वाला centroid दाईं तरफ़ का है, इसलिए nprobe = 1 पर IVF सिर्फ़ वही cluster देखता है। तुलनाएँ हैं 4 centroids और 11 points, कुल 15, जबकि brute force में 40। लेकिन असली सबसे पास वाला point बाईं तरफ़ के cluster में है, और वो छूट गया। nprobe = 2 करते ही वो मिल जाता है, और तुलनाएँ 25 हो जाती हैं।
यही IVF की हद है: query किनारे पर हो, तो उसके nearest neighbors पड़ोसी cluster में हो सकते हैं। “Query बीचोंबीच” में तो nprobe = 3 तक चाहिए। nprobe बढ़ाने से recall बढ़ता है और speed घटती है, यानी ANN वाला सौदा अब एक setting से तय होता है।
4PQ: हर vector को छोटे code में बदलना
IVF ने तुलनाएँ घटाईं, लेकिन सारे vectors अब भी memory में रखने हैं। एक आम number 4 bytes लेता है, तो 768 numbers का vector 768 × 4 = 3,072 bytes का है। 10 करोड़ vectors के लिए 10 करोड़ × 3,072 = 30,720 करोड़ bytes चाहिए। 1 GB में 100 करोड़ bytes होते हैं, इसलिए ये 307 GB है, यानी करीब 300 GB। slide के बाहर
Product quantization (PQ) हर vector को टुकड़ों में काटता है। फिर हर टुकड़े की जगह वो एक तय list के सबसे पास वाले vector का number लिख देता है। इस list को codebook कहते हैं, और उसके हर vector को codeword। ये numbers मिलकर vector का code बनाते हैं, और index में असली numbers की जगह यही code रहता है। Quantization का मतलब यही है: किसी value को तय list की सबसे पास वाली value से बदलना।
4 numbers का vector [0.9, 0.1, 0.2, 0.8] लीजिए, और उसे दो टुकड़ों में काटिए: [0.9, 0.1] और [0.2, 0.8]। Codebook में 4 codewords हैं: #0 [1, 0], #1 [0, 1], #2 [0.5, 0.5] और #3 [0.7, 0.7]। यहाँ दोनों टुकड़े एक ही codebook से काम चलाते हैं, जबकि असली PQ में हर टुकड़े की जगह का अपना codebook होता है। मेरा example
Codeword
[0.9, 0.1] से दूरी
[0.2, 0.8] से दूरी
#0 [1, 0]
0.14
1.13
#1 [0, 1]
1.27
0.28
#2 [0.5, 0.5]
0.57
0.42
#3 [0.7, 0.7]
0.63
0.51
पहली दूरी ऐसे निकली: [1 − 0.9, 0 − 0.1] = [0.1, −0.1], और √(0.01 + 0.01) = 0.14। पहले टुकड़े के सबसे पास #0 है, और दूसरे के सबसे पास #1। इसलिए पूरा vector बस code (0, 1) बन गया।
Code से vector लगभग वापस बनता है: #0 और #1 को साथ रखकर [1, 0, 0, 1]। अब query [1, 0, 0, 1] से dot product देखिए। असली vector से ये 1 × 0.9 + 0 × 0.1 + 0 × 0.2 + 1 × 0.8 = 1.7 है, और code वाले vector से 1 + 1 = 2.0।
असली पैमाने पर 768 numbers को 8-8 के 96 टुकड़ों में काटिए, और हर codebook में 256 codewords रखिए। 1 byte में 8 bits हैं, और 8 bits से 2 × 2 × 2 × 2 × 2 × 2 × 2 × 2 = 256 अलग numbers बनते हैं। इसलिए 0 से 255 तक का हर code 1 byte में आता है, और पूरा vector 96 bytes का बनता है। ये settings आम हैं, slide पर नहीं
Vector 3,072 ÷ 96 = 32 गुना छोटा हुआ, और 10 करोड़ vectors 300 GB से घटकर करीब 9.6 GB रह गए। हिसाब: 10 करोड़ × 96 = 960 करोड़ bytes, यानी 9.6 GB।
इसकी हद ऊपर के 1.7 और 2.0 में दिखती है: code से निकला score अंदाज़न है, और पास-पास scores का क्रम उलट सकता है। इसलिए कई systems आख़िरी कुछ candidates को असली vectors से दोबारा score करते हैं।
पहले सोचिए
ऊपर वाले codebook से vector [0.65, 0.65, 0.95, 0.05] का code क्या होगा?
जवाब देखिए
[0.65, 0.65] के सबसे पास #3 [0.7, 0.7] है, दूरी 0.07। #2 [0.5, 0.5] की दूरी 0.21 है। [0.95, 0.05] के सबसे पास #0 [1, 0] है, दूरी 0.07। Code = (3, 0)।
5HNSW: layers वाले graph पर greedy चाल
IVF किनारे पर इसलिए चूकता है, क्योंकि वो बाकी clusters के vectors देखता ही नहीं। दूसरा idea clusters बनाता ही नहीं, वो हर vector को उसके कुछ पास वाले vectors से जोड़ देता है। ऐसे graph को proximity graph कहते हैं, जिसमें हर vector एक node है, जैसे lesson 9 के graph में।
Proximity graph पर search एक node से शुरू होती है, और हर कदम पर उस neighbor पर जाती है जो query के सबसे पास है। जब कोई neighbor अभी वाले node से ज़्यादा पास न हो, तो search अटक जाती है, और वही node जवाब है। इस चाल को greedy search कहते हैं।
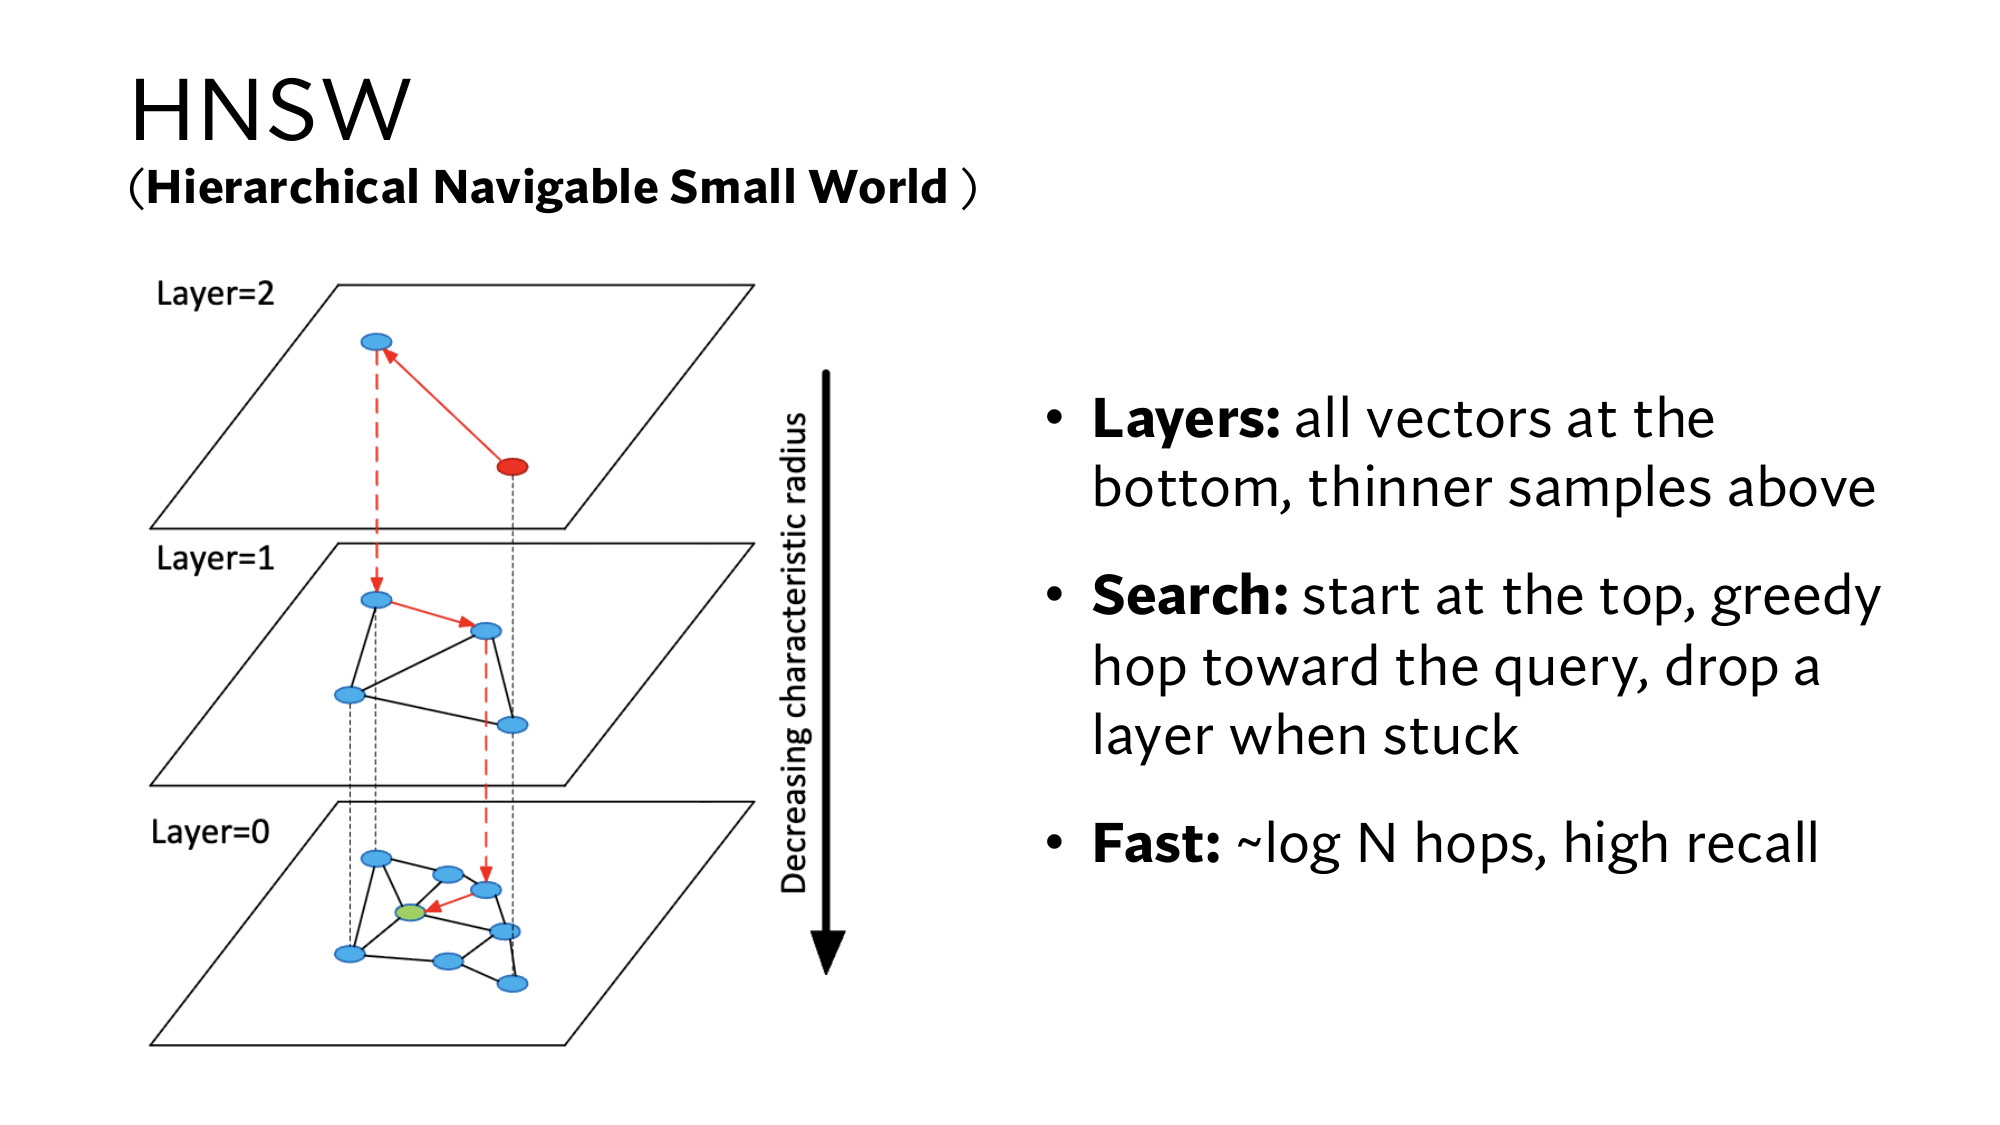
एक ही layer में दूर से शुरू करें, तो छोटे-छोटे बहुत सारे कदम लगते हैं। इसलिए HNSW (Hierarchical Navigable Small World) graph को layers में बनाता है। Layer 0 में सारे vectors हैं, और ऊपर की layers में कम nodes और लंबी छलाँगें। Search सबसे ऊपर से शुरू होती है, और जहाँ अटके, वहीं से एक layer नीचे उतरती है।
हाथ से हिसाब हो सके, इसलिए 1 dimension का example लीजिए। Vectors 0 से 100 तक 5-5 के फ़ासले पर 21 numbers हैं, और दूरी बस दोनों numbers का फ़र्क है। हर node अपनी layer में अपने दाएँ और बाएँ वाले node से जुड़ा है। Query 73 है, और search layer 2 के node 10 से शुरू होती है। मेरा example
Layer 2: 10, 50, 90
Layer 1: 10, 30, 50, 70, 90
Layer 0: 0, 5, 10, …, 100 (सारे 21)
Layer
कहाँ हैं (दूरी)
Neighbors (दूरी)
फ़ैसला
2
10 (63)
50 (23)
50 पर जाइए
2
50 (23)
10 (63), 90 (17)
90 पर जाइए
2
90 (17)
50 (23)
अटके, layer 1 पर उतरिए
1
90 (17)
70 (3)
70 पर जाइए
1
70 (3)
50 (23), 90 (17)
अटके, layer 0 पर उतरिए
0
70 (3)
?
?
0
75 (2)
70 (3), 80 (7)
अटके। जवाब: 75
छठी row आप निकालिए
Layer 0 पर आप node 70 पर हैं। उसके neighbors कौन हैं, query 73 से उनकी दूरी कितनी है, और फ़ैसला क्या है?
जवाब देखिए
Layer 0 में सारे 21 numbers हैं, तो 70 के neighbors 65 और 75 हैं। दूरियाँ: 65 (8) और 75 (2)। 75 अभी वाले 70 (3) से पास है, तो 75 पर जाइए।
कुल 4 कदम लगे (50, 90, 70, 75), और जवाब सही है, क्योंकि 73 के सबसे पास 75 ही है। रास्ते में search ने 7 nodes की दूरी निकाली, जबकि brute force सारे 21 की निकालता।
N बढ़ने पर ये फ़र्क बहुत बढ़ता है। Slide कहती है कि HNSW में करीब कदम लगते हैं, यानी 2 को जितनी बार गुणा करने पर N बने, करीब उतने। 2 को 20 बार गुणा करने पर 10,48,576 बनता है। इसलिए 10 लाख vectors पर करीब 20 कदम लगते हैं, और 10 करोड़ पर करीब 27।
Stanford की slide: HNSW की layers। लाल point सबसे ऊपर का शुरुआती node है, लाल arrows greedy चाल हैं, और लाल dashed arrows वहाँ हैं जहाँ search एक layer नीचे उतरी। हरा point query है। दाईं तरफ़ का arrow कहता है कि नीचे की layers में edges छोटी होती हैं, जैसे हमारे example में 40, 20 और 5 की छलाँगें। Image पर click करने से वो पूरे size में खुलती है।
HNSW की कीमत memory में है, क्योंकि हर node के साथ उसकी edges भी रखनी पड़ती हैं। slide के बाहर इसकी हद ये है कि greedy चाल ऐसे node पर भी अटक सकती है, जो असली सबसे पास वाला नहीं है। ऐसा ख़ासकर तब होता है, जब vectors अलग-अलग groups में बँटे हों। इसलिए HNSW हर नए vector को एक edge किसी दूसरे group तक भी देता है।
गहरे version में और क्या है
गहरे version में ये पूरा lesson है, और उसके बाद 5 पड़ाव और, जो Stanford की slides के level तक ले जाते हैं:
पड़ाव 6: दूरी का गणित, और length 1 वाले vectors पर दूरी और dot product एक ही क्रम क्यों देते हैं।
पड़ाव 7: k-means से IVF के centroids, और कितने clusters बनाएँ।
पड़ाव 8: PQ के codebooks, lookup table से तेज़ score, और IVF के साथ PQ।
पड़ाव 9: HNSW की random layers, ef, neighbors चुनने का नियम, और memory।
पड़ाव 10: Stanford की तीनों vector search slides, जिन्हें आप खुद पढ़ते हैं।
Brute force का खर्च O(N·d) है: ये पक्का सही है, लेकिन 10 करोड़ passages पर हर query करीब 7.7 seconds लेती है।
ANN कम vectors देखता है, और उसका recall बताता है कि असली top-k में से कितने मिले। IVF सिर्फ़ पास वाले clusters देखता है, और nprobe से ये सौदा तय होता है।
PQ हर vector को 3,072 से 96 bytes के code में बदलता है। HNSW layers वाले graph पर ऊपर से नीचे greedy चलता है, करीब log N कदमों में।
इस lesson के नए शब्द
Exact search (brute force)
हर vector से तुलना करके पक्का सही top-k निकालना। जैसे 21 vectors हों, तो 21 दूरियाँ गिनना।
Big-O, O(N·d)
N या d बढ़ने पर खर्च किस हिसाब से बढ़ता है। जैसे O(N·d) में N दोगुना हो, तो खर्च भी दोगुना।
Nearest neighbors
Query के सबसे पास वाले vectors। जैसे query 73 के पास वालों में 75 पहले आता है।
ANN
Approximate nearest neighbor search: कम vectors देखकर ज़्यादातर बार सही neighbors ढूँढना। जैसे असली top-10 में से 9 मिलें, तो recall 0.9।
दूरी
दो vectors के फ़र्क वाले vector की length। जैसे [0.8, 0.2] और [0.9, 0.1] का फ़र्क [0.1, −0.1] है, तो दूरी √(0.01 + 0.01) = 0.14।
IVF
Inverted file index: vectors को clusters में बाँटकर query के पास वाले clusters ही देखना। जैसे 10 लाख vectors पर 11,000 तुलनाएँ।
nprobe
IVF में कितने clusters देखने हैं। जैसे 1,000 clusters में nprobe = 10 हो, तो सिर्फ़ 10 clusters के vectors देखना।
Product quantization (PQ)
Vector को टुकड़ों में काटकर हर टुकड़े की जगह codeword का number रखना। जैसे [0.9, 0.1, 0.2, 0.8] बनता है code (0, 1)।
Codebook
हर टुकड़े के नमूना vectors (codewords) की list। जैसे #0 [1, 0], #1 [0, 1], #2 [0.5, 0.5], #3 [0.7, 0.7]।
Proximity graph
ऐसा graph, जिसमें हर vector अपने पास वाले vectors से जुड़ा हो। जैसे 70 अपने पड़ोसी 65 और 75 से जुड़ा है।
Greedy search
हर कदम पर query के सबसे पास वाले neighbor पर जाना, अटकने तक। जैसे query 73 के लिए 70 से 75 पर जाना।
HNSW
Layers वाला proximity graph: ऊपर से greedy चाल, और अटकने पर एक layer नीचे। जैसे query 73 पर 4 कदम।