Vector search का काम है: query के vector के सबसे पास वाले k vectors ढूँढना। ये lesson ऐसे तरीके सिखाता है, जो हर vector देखे बिना ज़्यादातर बार वही k vectors ढूँढ लेते हैं।Lesson 3 का retriever हर query पर index के हर vector से तुलना करता था। Lesson 2 की company के 60,000 passages पर ये पल भर का काम है, लेकिन 10 करोड़ passages पर हर query करीब 7.7 seconds लेगी। मेरा अंदाज़ा
Lesson 5 की search सबसे बड़े dot product वाले k passages ढूँढती है। उसे तेज़ करने का रास्ता भी यही है: हर vector मत देखिए। तब कभी-कभी सबसे पास वाला passage छूटता है, और ये lesson उस चूक को नापना भी सिखाता है।
इस lesson की सीढ़ी
सीढ़ी में 10 पड़ाव हैं। पहले 5 आसान version जैसे ही हैं, और 6 से 10 आपको Stanford की slides के level तक ले जाते हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
पहले से क्या चाहिए: Lesson 3 (vector, dot product, length) और Lesson 9 (cluster, centroid, graph)। पड़ाव 6 से आगे Lesson 3 का पड़ाव 6 (दूरी को खोलना), Lesson 4 (ln) और Lesson 12 (DPR) भी काम आते हैं। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1हर vector से तुलना: exact search और उसका खर्च
Stanford की slide पर vector search का काम ये है: query के vector के लिए index के N vectors में से top-k लौटाने हैं। सबसे सीधा तरीका हर vector से score निकालता है, और सबसे ऊँचे k scores वाले vectors लौटाता है। इसे exact search या brute force कहते हैं, क्योंकि ये बिना किसी तरकीब के सब कुछ देखता है।
इसका खर्च गिनना आसान है। Lesson 3 की query [0.8, 0.2] और office hours page [0.9, 0.1] का 0.8 × 0.9 + 0.2 × 0.1 = 0.74 है। इसमें 2 गुणा लगे। d numbers वाले vectors में d गुणा लगते हैं, इसलिए N vectors से तुलना में N × d गुणा लगते हैं।
असली vectors में d बड़ा है: BERT-base के vector में 768 numbers हैं, यानी d = 768। Speed के लिए एक मोटा अंदाज़ा लीजिए कि computer एक second में 1,000 करोड़ गुणा करता है। speed मेरा अंदाज़ा है
Corpus
एक query पर गुणा
एक query का समय
Lesson 2 की company60,000 passages
4.6 करोड़60,000 × 768
0.005 second
Lesson 5 का Wikipedia2.1 करोड़ passages
1,613 करोड़2.1 करोड़ × 768
1.6 seconds
बड़ा corpus10 करोड़ passages
7,680 करोड़10 करोड़ × 768
7.7 seconds
आख़िरी row दो steps में निकली:
एक query पर गुणा: 10 करोड़ × 768 = 7,680 करोड़।
समय: 7,680 करोड़ ÷ 1,000 करोड़ per second = 7.68 seconds, यानी करीब 7.7 seconds।
Slide इस खर्च को O(N·d) लिखती है, और इस लिखावट को Big-O कहते हैं। Big-O सही गिनती नहीं बताता। वो बताता है कि N या d बढ़ने पर खर्च किस हिसाब से बढ़ता है। O(N·d) का मतलब है कि N दोगुना हो, तो खर्च दोगुना, और d दोगुना हो, तब भी दोगुना। Table में N 60,000 से 10 करोड़ हुआ, यानी करीब 1,667 गुना, और समय भी 0.005 से 7.7 seconds, उतने ही गुना बढ़ा।
Brute force हमेशा असली top-k देता है, इसलिए छोटे corpus पर यही सबसे अच्छा तरीका है। दिक्कत सिर्फ़ बड़े corpus पर है, जहाँ हर query seconds लेती है।
2ANN: थोड़ा recall देकर बहुत speed
हर vector देखे बिना पक्का top-k नहीं मिल सकता, क्योंकि जो vector नहीं देखा, वही सबसे पास हो सकता है। इसलिए बड़े corpus पर एक सौदा करना पड़ता है: कम vectors देखिए, और ज़्यादातर बार सही जवाब पाइए। Query के सबसे पास वाले vectors को उसके nearest neighbors कहते हैं।
ANN, यानी approximate nearest neighbor search, वो तरीके हैं जो कुछ ही vectors देखकर ज़्यादातर बार असली nearest neighbors लौटाते हैं। Approximate का मतलब है लगभग। Slide इसे एक सौदा कहती है: trade a little recall for a lot of speed, यानी थोड़ा recall दीजिए, और बहुत speed लीजिए।
यहाँ का मतलब है: brute force जो असली top-10 देता, उनमें से ANN ने कितने लौटाए। ANN ने 10 में से 9 लौटाए, तो recall 9 ÷ 10 = 0.9 है। ANN जो passage छोड़ता है, वो reader तक कभी नहीं पहुँचता। इसलिए ये चूक lesson 2 वाली को नीचे लाती है।
Lesson 13 का Recall@k इससे अलग है। वहाँ सही जवाब इंसानों के labels से आता है, और यहाँ brute force के top-10 से।
दूरी: “पास” कैसे नापें
“पास” नापने के लिए इस lesson के तरीके दूरी लेते हैं। दो vectors की दूरी निकालने के लिए पहले एक ही जगह वाले numbers घटाइए, जिससे फ़र्क वाला vector बनता है। फिर उसकी लीजिए, यानी lesson 3 वाला हिसाब: हर number का square, सबका जोड़, फिर square root।
Lesson 3 की query [0.8, 0.2] और office hours page [0.9, 0.1] पर ये तीन steps में होता है:
फ़र्क: [0.9 − 0.8, 0.1 − 0.2] = [0.1, −0.1]।
Squares का जोड़: 0.1 × 0.1 + (−0.1) × (−0.1) = 0.01 + 0.01 = 0.02। Minus वाले number का square भी plus होता है।
Syllabus [0.1, 0.9] का फ़र्क [−0.7, 0.7] है, और उसकी दूरी √(0.49 + 0.49) = √0.98 = 0.99 है। दूरी जितनी छोटी, vector उतना पास, इसलिए office hours page query के ज़्यादा पास है।
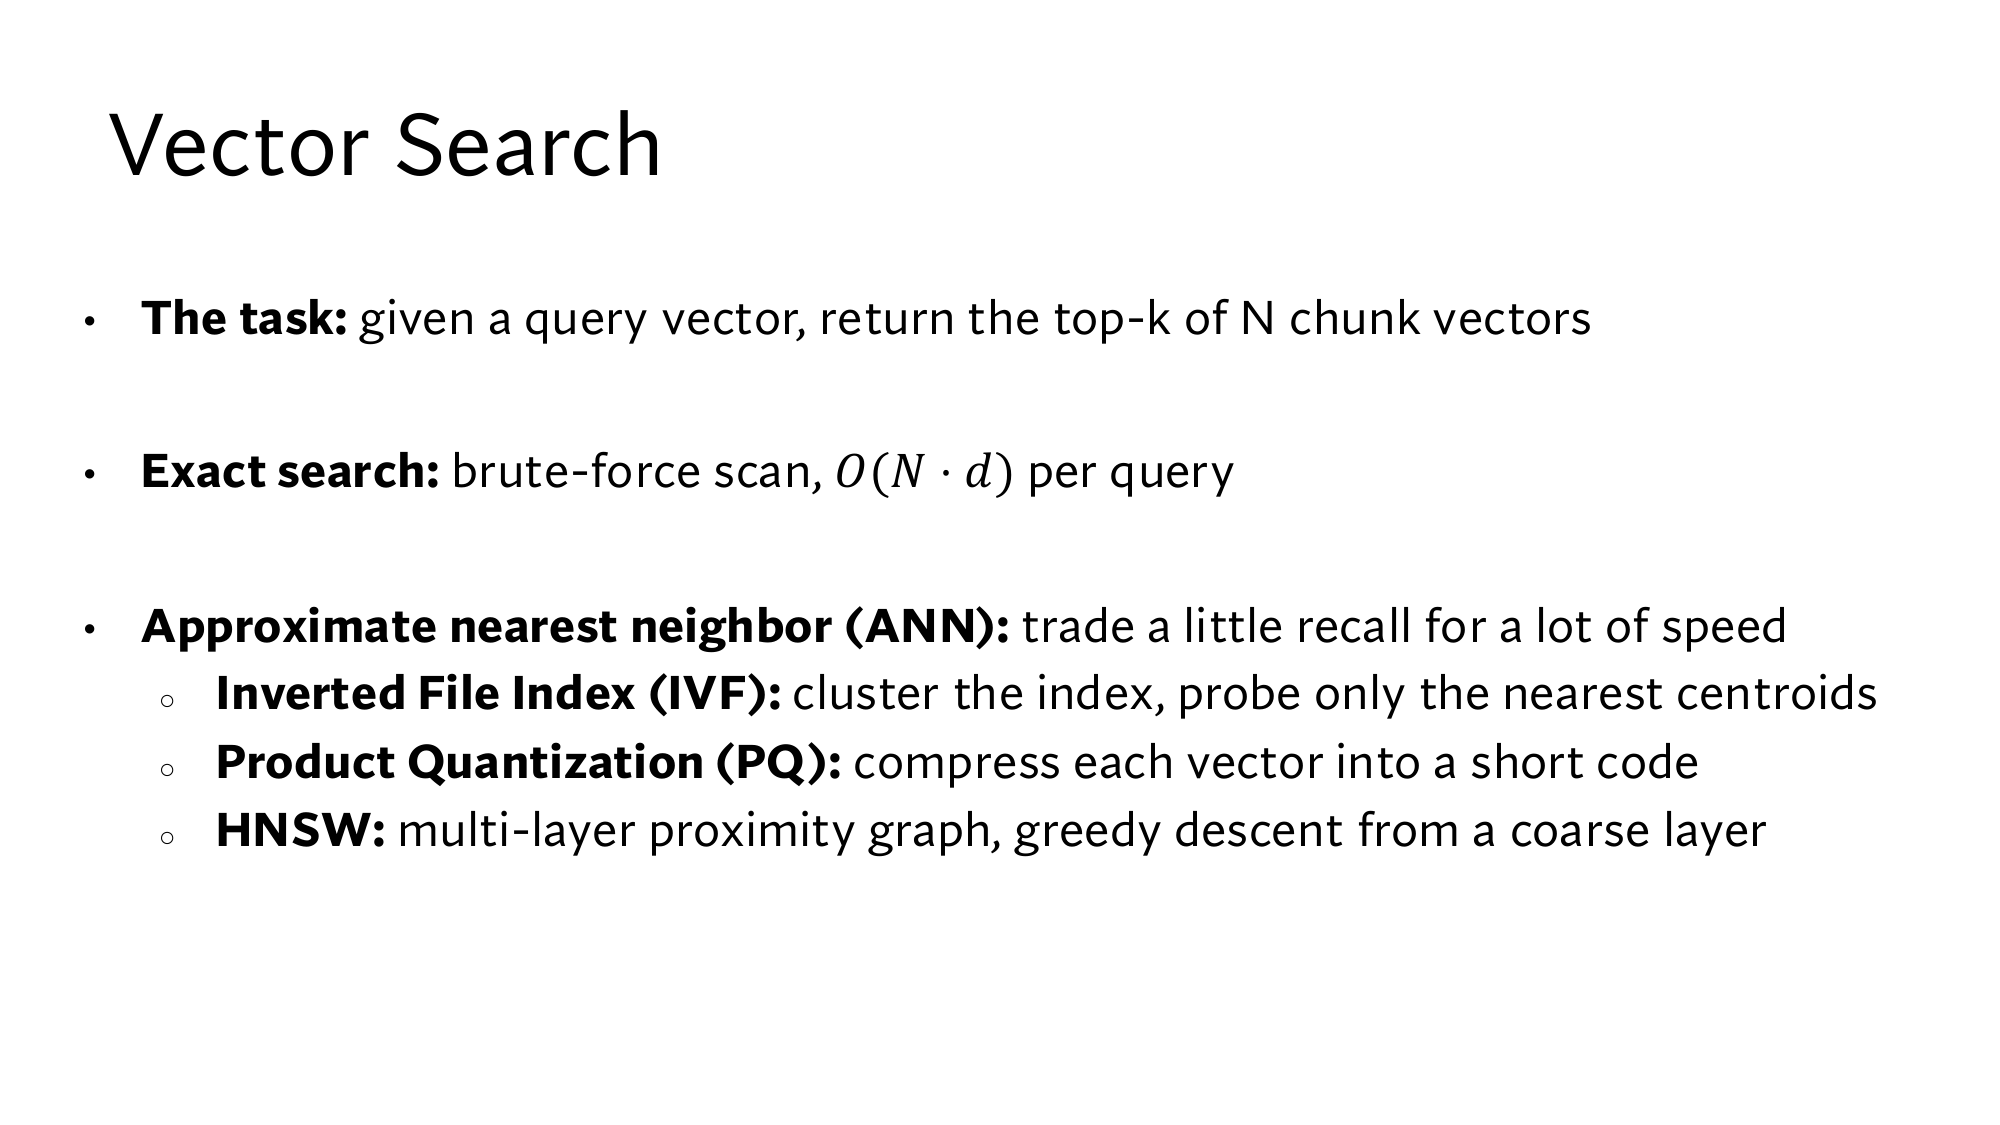
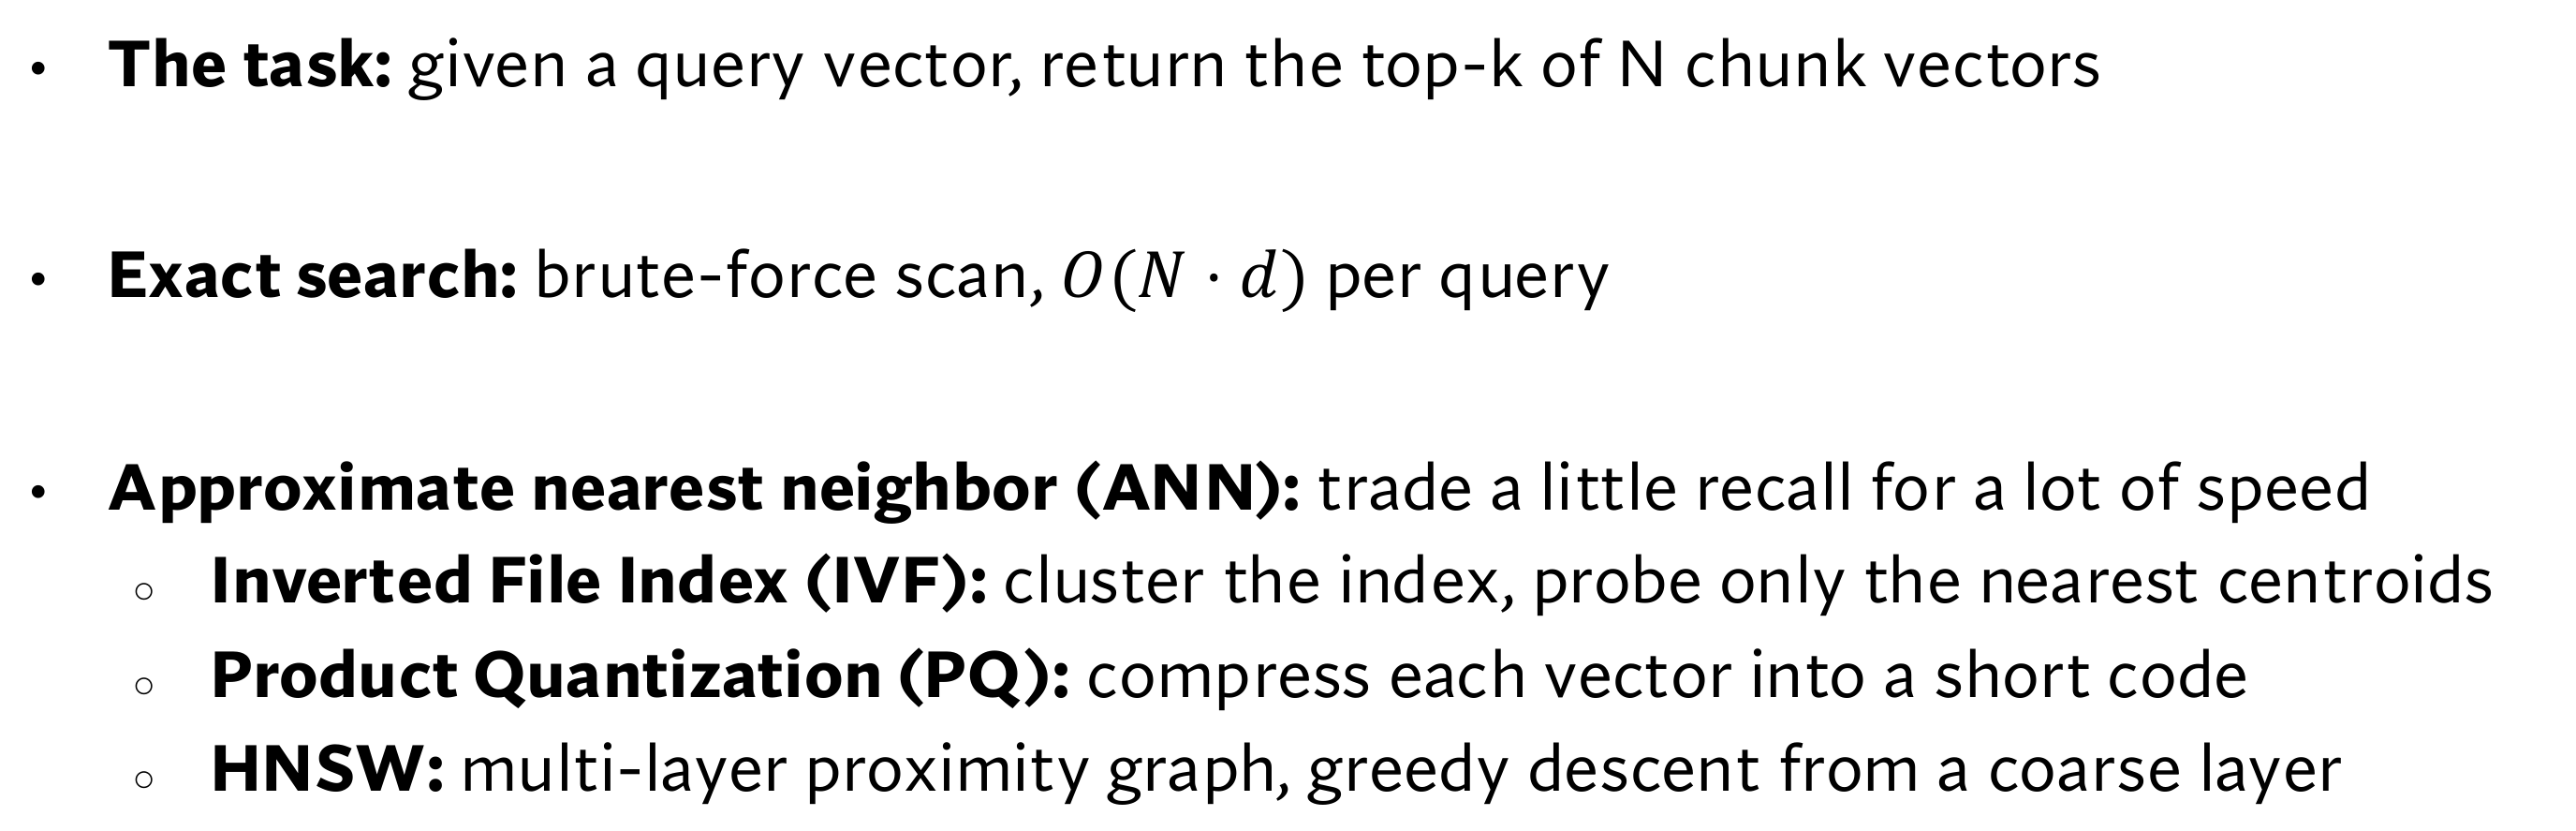
Stanford की slide: vector search। पहली तीन lines अब आप पढ़ सकते हैं: काम, exact search का खर्च O(N·d), और ANN का सौदा। नीचे के तीन ANN तरीके, IVF, PQ और HNSW, अगले तीन पड़ावों में आते हैं। Image पर click करने से वो पूरे size में खुलती है।
3IVF: सिर्फ़ query के पास वाले clusters देखना
Query के nearest neighbors उसके आस-पास होंगे, इसलिए दूर के vectors देखना बेकार है। मुश्किल ये है कि किसी vector को देखे बिना पता नहीं चलता कि वो दूर है। इसमें lesson 9 का काम आता है, यानी किसी cluster के vectors का औसत। जैसे [0.1, 0.9], [0.2, 0.8] और [0.15, 0.85] का centroid [0.15, 0.85] है। Query किसी centroid से दूर है, तो उसके cluster के vectors भी ज़्यादातर दूर होंगे।
IVF (inverted file index) vectors को clusters में बाँटता है, और search के वक्त सिर्फ़ query के पास वाले clusters के vectors देखता है। इसका काम दो हिस्सों में बँटता है:
: हर vector अपने सबसे पास वाले centroid के cluster में जाता है, और हर centroid के साथ उसके vectors की एक list रहती है। इन lists का नाम inverted file है।
Online: query पहले सिर्फ़ centroids से मिलती है। फिर IVF सबसे पास वाले कुछ centroids चुनता है, और सिर्फ़ उनकी lists के vectors से दूरी निकालता है।
कितने clusters देखने हैं, उस number को nprobe कहते हैं। nprobe नाम slide पर नहीं है मान लीजिए 10 लाख vectors 1,000 clusters में बँटे हैं, यानी हर cluster में करीब 1,000 vectors। nprobe = 10 पर तुलनाएँ ऐसे गिनिए:
Centroids से: 1,000 तुलनाएँ।
चुने हुए 10 clusters के vectors से: 10 × 1,000 = 10,000 तुलनाएँ।
कुल 11,000, जबकि brute force में 10,00,000। 10,00,000 ÷ 11,000 = 91, यानी करीब 91 गुना कम काम।
पहले सोचिए
Query दो clusters के किनारे पर है, और nprobe = 1 है। क्या IVF असली सबसे पास वाला point ढूँढ लेगा?
जवाब देखिए
हमेशा नहीं। IVF सिर्फ़ उस cluster को देखता है, जिसका centroid query के सबसे पास है। किनारे वाली query का सबसे पास वाला point पड़ोसी cluster में भी हो सकता है। Widget में “Query किनारे पर” चुनकर देखिए।
IVF खुद चलाइए
40 points, 4 clusters। चौकोर boxes centroids हैं। Plane पर click करके query रखिए, और nprobe बदलिए। गहरे points वो हैं, जिन्हें IVF ने देखा। घेरे वाला point असली सबसे पास वाला है।
“Query किनारे पर” चुनिए। Query का सबसे पास वाला centroid दाईं तरफ़ का है, इसलिए nprobe = 1 पर IVF सिर्फ़ वही cluster देखता है। तुलनाएँ हैं 4 centroids और 11 points, कुल 15, जबकि brute force में 40। लेकिन असली सबसे पास वाला point बाईं तरफ़ के cluster में है, और वो छूट गया। nprobe = 2 करते ही वो मिल जाता है, और तुलनाएँ 25 हो जाती हैं।
यही IVF की हद है: query किनारे पर हो, तो उसके nearest neighbors पड़ोसी cluster में हो सकते हैं। “Query बीचोंबीच” में तो nprobe = 3 तक चाहिए। nprobe बढ़ाने से recall बढ़ता है और speed घटती है, यानी ANN वाला सौदा अब एक setting से तय होता है।
4PQ: हर vector को छोटे code में बदलना
IVF ने तुलनाएँ घटाईं, लेकिन सारे vectors अब भी memory में रखने हैं। एक आम number 4 bytes लेता है, तो 768 numbers का vector 768 × 4 = 3,072 bytes का है। 10 करोड़ vectors के लिए 10 करोड़ × 3,072 = 30,720 करोड़ bytes चाहिए। 1 GB में 100 करोड़ bytes होते हैं, इसलिए ये 307 GB है, यानी करीब 300 GB। slide के बाहर
Product quantization (PQ) हर vector को टुकड़ों में काटता है। फिर हर टुकड़े की जगह वो एक तय list के सबसे पास वाले vector का number लिख देता है। इस list को codebook कहते हैं, और उसके हर vector को codeword। ये numbers मिलकर vector का code बनाते हैं, और index में असली numbers की जगह यही code रहता है। Quantization का मतलब यही है: किसी value को तय list की सबसे पास वाली value से बदलना।
4 numbers का vector [0.9, 0.1, 0.2, 0.8] लीजिए, और उसे दो टुकड़ों में काटिए: [0.9, 0.1] और [0.2, 0.8]। Codebook में 4 codewords हैं: #0 [1, 0], #1 [0, 1], #2 [0.5, 0.5] और #3 [0.7, 0.7]। यहाँ दोनों टुकड़े एक ही codebook से काम चलाते हैं, जबकि असली PQ में हर टुकड़े की जगह का अपना codebook होता है। मेरा example
Codeword
[0.9, 0.1] से दूरी
[0.2, 0.8] से दूरी
#0 [1, 0]
0.14
1.13
#1 [0, 1]
1.27
0.28
#2 [0.5, 0.5]
0.57
0.42
#3 [0.7, 0.7]
0.63
0.51
पहली दूरी ऐसे निकली: [1 − 0.9, 0 − 0.1] = [0.1, −0.1], और √(0.01 + 0.01) = 0.14। पहले टुकड़े के सबसे पास #0 है, और दूसरे के सबसे पास #1। इसलिए पूरा vector बस code (0, 1) बन गया।
Code से vector लगभग वापस बनता है: #0 और #1 को साथ रखकर [1, 0, 0, 1]। अब query [1, 0, 0, 1] से dot product देखिए। असली vector से ये 1 × 0.9 + 0 × 0.1 + 0 × 0.2 + 1 × 0.8 = 1.7 है, और code वाले vector से 1 + 1 = 2.0।
असली पैमाने पर 768 numbers को 8-8 के 96 टुकड़ों में काटिए, और हर codebook में 256 codewords रखिए। 1 byte में 8 bits हैं, और 8 bits से 2 × 2 × 2 × 2 × 2 × 2 × 2 × 2 = 256 अलग numbers बनते हैं। इसलिए 0 से 255 तक का हर code 1 byte में आता है, और पूरा vector 96 bytes का बनता है। ये settings आम हैं, slide पर नहीं
Vector 3,072 ÷ 96 = 32 गुना छोटा हुआ, और 10 करोड़ vectors 300 GB से घटकर करीब 9.6 GB रह गए। हिसाब: 10 करोड़ × 96 = 960 करोड़ bytes, यानी 9.6 GB।
इसकी हद ऊपर के 1.7 और 2.0 में दिखती है: code से निकला score अंदाज़न है, और पास-पास scores का क्रम उलट सकता है। इसलिए कई systems आख़िरी कुछ candidates को असली vectors से दोबारा score करते हैं।
पहले सोचिए
ऊपर वाले codebook से vector [0.65, 0.65, 0.95, 0.05] का code क्या होगा?
जवाब देखिए
[0.65, 0.65] के सबसे पास #3 [0.7, 0.7] है, दूरी 0.07। #2 [0.5, 0.5] की दूरी 0.21 है। [0.95, 0.05] के सबसे पास #0 [1, 0] है, दूरी 0.07। Code = (3, 0)।
5HNSW: layers वाले graph पर greedy चाल
IVF किनारे पर इसलिए चूकता है, क्योंकि वो बाकी clusters के vectors देखता ही नहीं। दूसरा idea clusters बनाता ही नहीं, वो हर vector को उसके कुछ पास वाले vectors से जोड़ देता है। ऐसे graph को proximity graph कहते हैं, जिसमें हर vector एक node है, जैसे lesson 9 के graph में।
Proximity graph पर search एक node से शुरू होती है, और हर कदम पर उस neighbor पर जाती है जो query के सबसे पास है। जब कोई neighbor अभी वाले node से ज़्यादा पास न हो, तो search अटक जाती है, और वही node जवाब है। इस चाल को greedy search कहते हैं।
एक ही layer में दूर से शुरू करें, तो छोटे-छोटे बहुत सारे कदम लगते हैं। इसलिए HNSW (Hierarchical Navigable Small World) graph को layers में बनाता है। Layer 0 में सारे vectors हैं, और ऊपर की layers में कम nodes और लंबी छलाँगें। Search सबसे ऊपर से शुरू होती है, और जहाँ अटके, वहीं से एक layer नीचे उतरती है।
हाथ से हिसाब हो सके, इसलिए 1 dimension का example लीजिए। Vectors 0 से 100 तक 5-5 के फ़ासले पर 21 numbers हैं, और दूरी बस दोनों numbers का फ़र्क है। हर node अपनी layer में अपने दाएँ और बाएँ वाले node से जुड़ा है। Query 73 है, और search layer 2 के node 10 से शुरू होती है। मेरा example
Layer 2: 10, 50, 90
Layer 1: 10, 30, 50, 70, 90
Layer 0: 0, 5, 10, …, 100 (सारे 21)
Layer
कहाँ हैं (दूरी)
Neighbors (दूरी)
फ़ैसला
2
10 (63)
50 (23)
50 पर जाइए
2
50 (23)
10 (63), 90 (17)
90 पर जाइए
2
90 (17)
50 (23)
अटके, layer 1 पर उतरिए
1
90 (17)
70 (3)
70 पर जाइए
1
70 (3)
50 (23), 90 (17)
अटके, layer 0 पर उतरिए
0
70 (3)
?
?
0
75 (2)
70 (3), 80 (7)
अटके। जवाब: 75
छठी row आप निकालिए
Layer 0 पर आप node 70 पर हैं। उसके neighbors कौन हैं, query 73 से उनकी दूरी कितनी है, और फ़ैसला क्या है?
जवाब देखिए
Layer 0 में सारे 21 numbers हैं, तो 70 के neighbors 65 और 75 हैं। दूरियाँ: 65 (8) और 75 (2)। 75 अभी वाले 70 (3) से पास है, तो 75 पर जाइए।
कुल 4 कदम लगे (50, 90, 70, 75), और जवाब सही है, क्योंकि 73 के सबसे पास 75 ही है। रास्ते में search ने 7 nodes की दूरी निकाली, जबकि brute force सारे 21 की निकालता।
N बढ़ने पर ये फ़र्क बहुत बढ़ता है। Slide कहती है कि HNSW में करीब कदम लगते हैं, यानी 2 को जितनी बार गुणा करने पर N बने, करीब उतने। 2 को 20 बार गुणा करने पर 10,48,576 बनता है। इसलिए 10 लाख vectors पर करीब 20 कदम लगते हैं, और 10 करोड़ पर करीब 27।
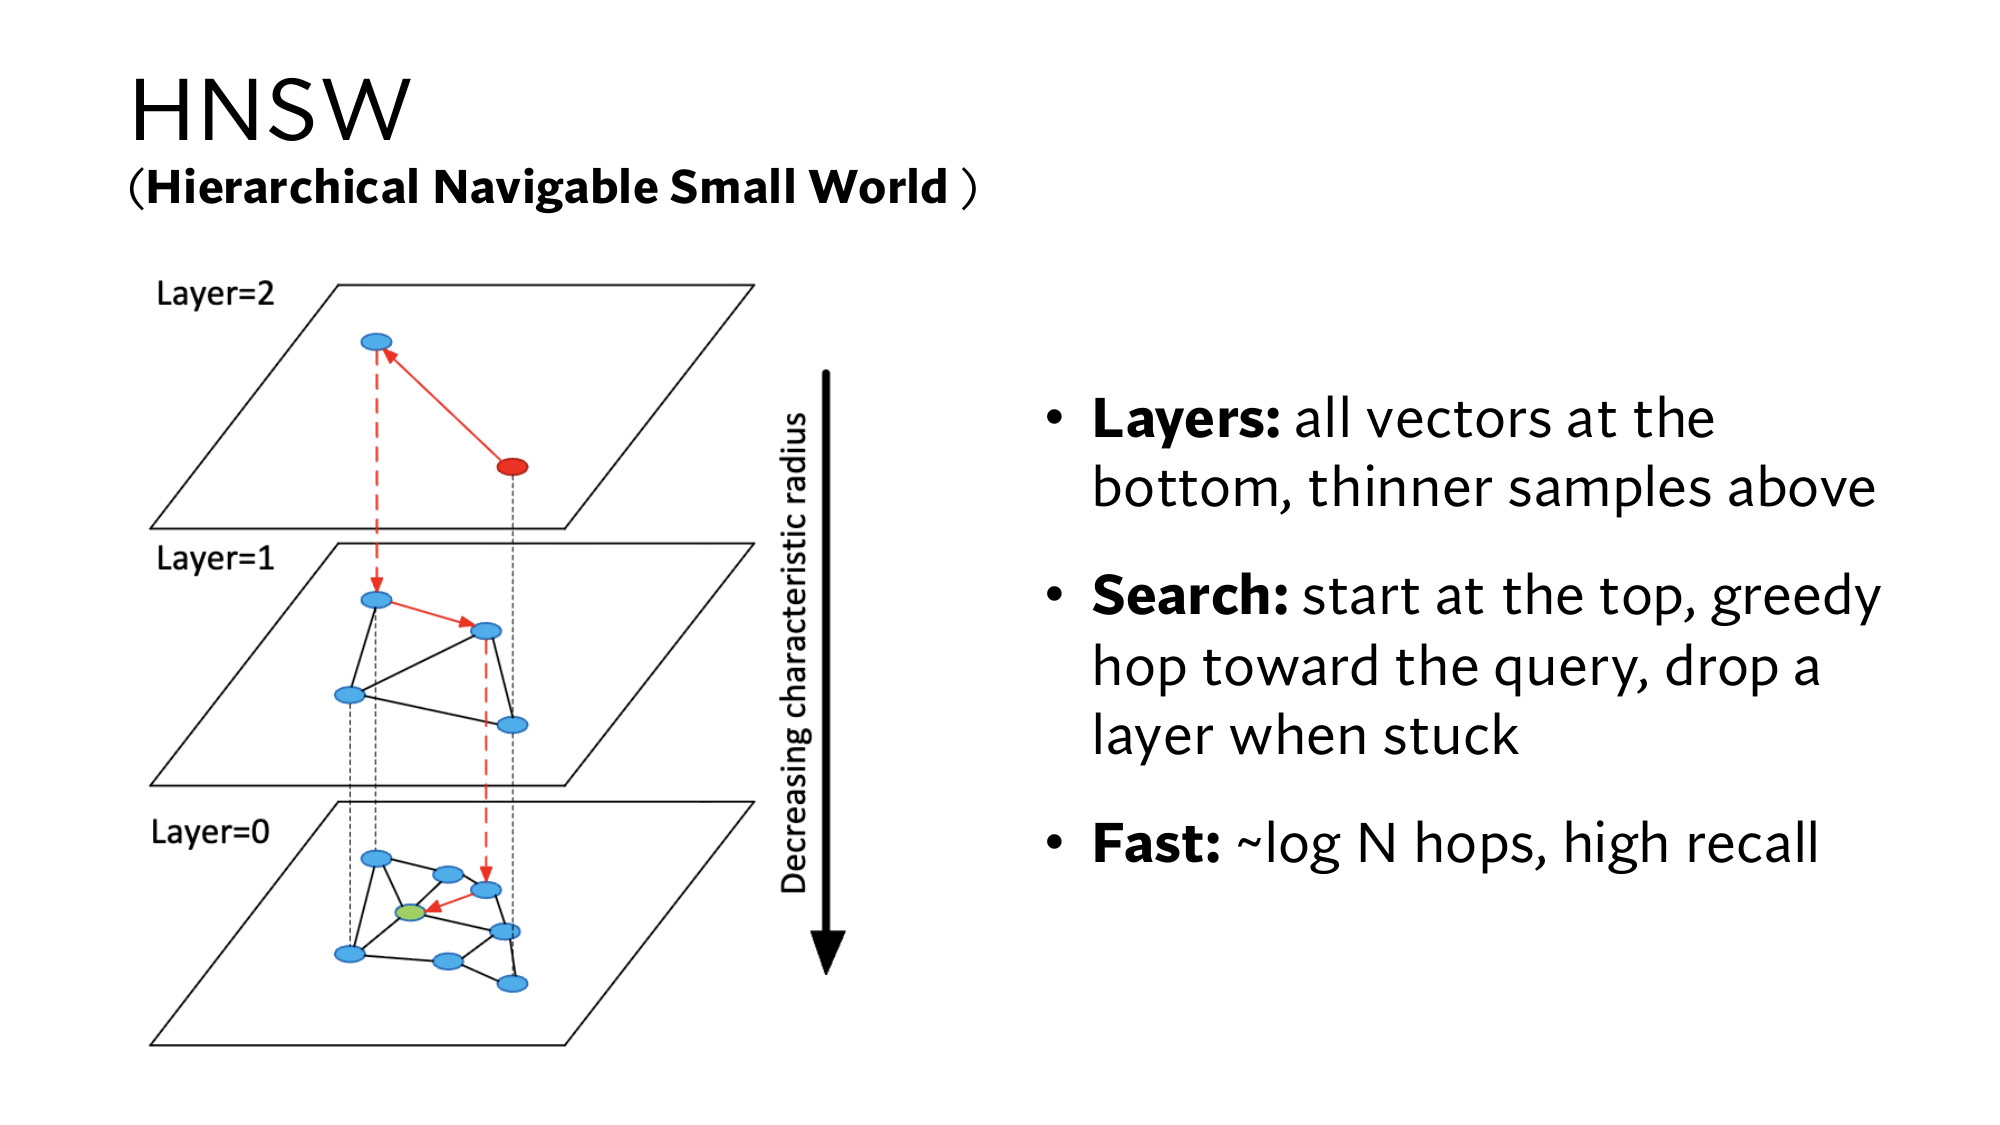
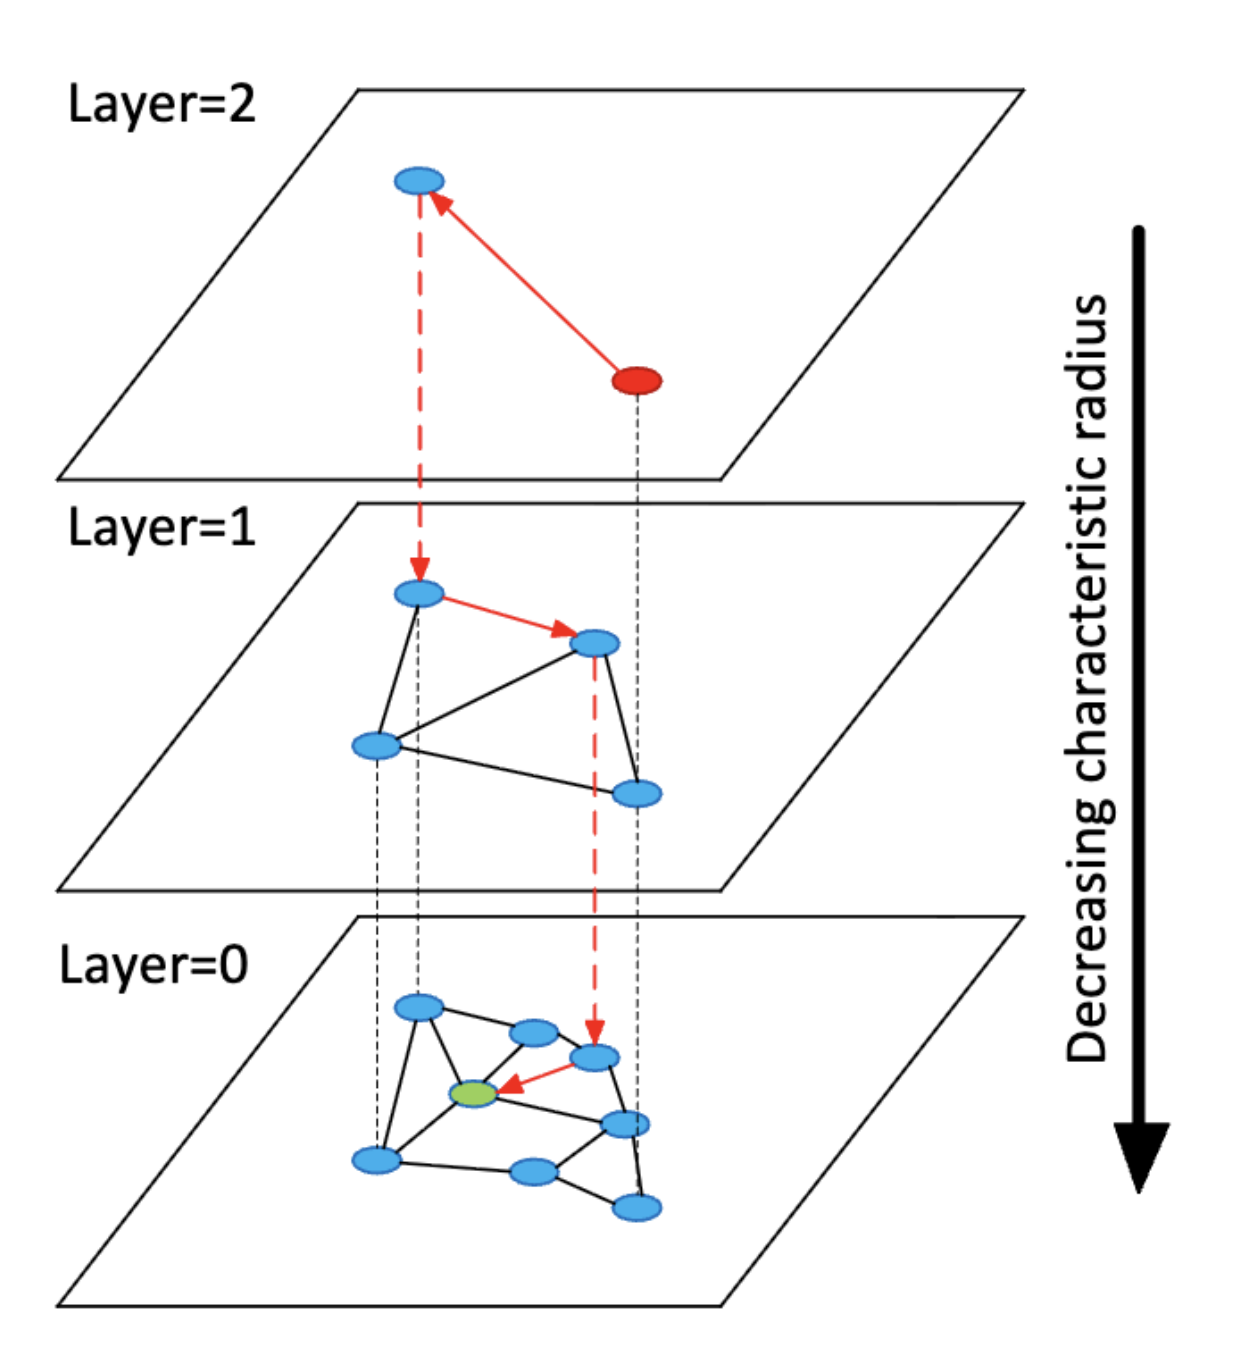
Stanford की slide: HNSW की layers। लाल point सबसे ऊपर का शुरुआती node है, लाल arrows greedy चाल हैं, और लाल dashed arrows वहाँ हैं जहाँ search एक layer नीचे उतरी। हरा point query है। दाईं तरफ़ का arrow कहता है कि नीचे की layers में edges छोटी होती हैं, जैसे हमारे example में 40, 20 और 5 की छलाँगें। Image पर click करने से वो पूरे size में खुलती है।
HNSW की कीमत memory में है, क्योंकि हर node के साथ उसकी edges भी रखनी पड़ती हैं। slide के बाहर इसकी हद ये है कि greedy चाल ऐसे node पर भी अटक सकती है, जो असली सबसे पास वाला नहीं है। ऐसा ख़ासकर तब होता है, जब vectors अलग-अलग groups में बँटे हों। इसलिए HNSW हर नए vector को एक edge किसी दूसरे group तक भी देता है।
यहाँ से Stanford वाला level
ऊपर के 5 पड़ाव आसान version जैसे ही हैं। आगे के 5 पड़ाव आपको Stanford की slides के level तक ले जाते हैं। इनमें पहले दूरी और dot product का गणित है, फिर k-means से IVF के centroids, और फिर PQ के codebooks। उसके बाद HNSW की layers, ef और neighbors चुनने का नियम है, और आख़िर में आप slides खुद पढ़ते हैं। हर गणित वहीं समझाया है, जहाँ वो पहली बार आता है।
6दूरी और dot product: कब दोनों एक ही क्रम देते हैं
पड़ाव 2 में दूरी का हिसाब आया था। इस पड़ाव में आप देखेंगे कि वो हिसाब Pythagoras क्यों है, और दूरी dot product से कैसे जुड़ी है। ये जुड़ाव इसलिए ज़रूरी है, क्योंकि IVF और HNSW दूरी पर चलते हैं, जबकि lesson 5 का MIPS सबसे बड़ा dot product माँगता है।
Pythagoras से दूरी, 2 से 768 numbers तक
Plane पर query [0.8, 0.2] एक point है, और office hours page [0.9, 0.1] दूसरा। पहले से दूसरे point तक जाने के लिए x-axis की दिशा में 0.1 चलिए, फिर y-axis की दिशा में 0.1 नीचे। ये दोनों चालें आपस में 90° पर हैं, इसलिए वो एक right triangle की दो छोटी sides हैं। दोनों points को सीधे जोड़ने वाली line सबसे लंबी side है, और Pythagoras से उसकी लंबाई √(0.1² + 0.1²) = √0.02 = 0.141 है।
तीसरा number हो, तो एक और दिशा जुड़ती है, जो पहली दोनों से 90° पर है, और Pythagoras दो बार लगता है। नतीजा ये है कि फ़र्क के हर number का square जुड़ता है। जैसे [0.8, 0.2, 0.5] और [0.9, 0.1, 0.3] की दूरी √(0.01 + 0.01 + 0.04) = √0.06 = 0.245 है। मेरे numbers 768 numbers पर भी यही नियम है: 768 घटाव, 768 squares और 767 जोड़। ये खर्च करीब dot product जितना है, इसलिए दूरी वाला brute force भी O(N·d) ही है।
Square root के बिना क्रम
Passages का क्रम तय करने के लिए square root की ज़रूरत नहीं है। Office hours page के लिए squares का जोड़ 0.02 है, और syllabus के लिए 0.98। Square root लेने पर ये 0.14 और 0.99 बनते हैं, और क्रम वही रहता है। ऐसा हमेशा होता है, क्योंकि √ एक है: बड़े number का square root भी बड़ा होता है। PQ paper भी इसी वजह से search में square roots नहीं निकालता। PQ paper से आगे के पड़ावों में भी दूरी², यानी squares का जोड़, ही चलेगा।
Length 1 वाले vectors पर दूरी और dot product
Lesson 3 के गहरे version में दूरी² को खोलकर एक formula निकला था। वहाँ school का नियम (x − y)² = x² + y² − 2xy हर number पर लगा, और सबको जोड़ने पर ये बना:
|a − b|2 = |a|2 + |b|2 − 2 a · b
Office hours page पर इसकी जाँच कीजिए: |a|² = 0.8² + 0.2² = 0.68, |b|² = 0.9² + 0.1² = 0.82, और a · b = 0.74। तो 0.68 + 0.82 − 2 × 0.74 = 0.02, जो ऊपर वाला squares का जोड़ ही है।
अब दोनों vectors को कीजिए, यानी हर number को vector की length से भाग दीजिए, ताकि length 1 हो जाए। तब |a|² = |b|² = 1, और formula ऐसा बनता है:
|a − b|2 = 2 − 2 a · b
यहाँ 2 हर passage के लिए बराबर है, इसलिए dot product जितना बड़ा, दूरी² उतनी छोटी। Normalize करने पर query [0.970, 0.243], office hours page [0.994, 0.110] और syllabus [0.110, 0.994] बनते हैं: हिसाब मेरा
Passage
Dot product
2 − 2 × dot product
सीधे निकाली दूरी²
Office hours page
0.991
0.018
0.018
Syllabus
0.348
1.304
1.304
मतलब length 1 वाले vectors पर सबसे पास वाले vectors वही हैं, जिनका dot product सबसे बड़ा है। इसलिए दूरी पर चलने वाला IVF या HNSW index ऐसे vectors पर MIPS का काम भी कर देता है।
Length 1 न हो, तब: एक extra number से MIPS को दूरी वाली search बनाना
Lesson 3 में FAQ page [1.6, 1.4] dot product में पहला था (1.56), लेकिन दूरी में आख़िरी (1.44)। मतलब length 1 न हो, तो सबसे पास वाला vector और सबसे बड़े dot product वाला vector अलग हो सकते हैं। FAISS paper इसका एक तरीका देता है: हर passage के vector में एक number और जोड़िए, और query में 0। FAISS paper से
जोड़ा गया number √(α² − |y|²) है। यहाँ |y|² passage की length का square है, और α² सबसे लंबे passage का |y|²। हमारे चार passages में सबसे लंबा FAQ page है, जिसका |y|² = 1.6² + 1.4² = 4.52 है। इसलिए α² = 4.52 लीजिए।
Office hours page: |y|² = 0.82, तो जोड़ा गया number √(4.52 − 0.82) = √3.70 = 1.924 है। नया vector [0.9, 0.1, 1.924] है, और query [0.8, 0.2, 0]।
FAQ page: जोड़ा गया number √(4.52 − 4.52) = 0 है, और दूरी² = 0.8² + 1.2² + 0 = 0.64 + 1.44 = 2.08।
अब FAQ page (2.08) office hours page (3.72) से पास है, ठीक dot product वाले क्रम की तरह। वजह ये है कि नए passage vector का |y|² हमेशा α² बनता है, क्योंकि |y|² + (α² − |y|²) = α²। ऊपर के formula से नई दूरी² = |x|² + α² − 2 x · y बनती है। |x|² और α² हर passage के लिए बराबर हैं, इसलिए क्रम सिर्फ़ dot product से तय होता है। जाँच: 0.68 + 4.52 − 2 × 1.56 = 2.08।
Passage
Dot product
पुरानी दूरी
नई दूरी²
FAQ page
1.56
1.44
2.08
Office hours page
0.74
0.14
3.72
Project page
0.32
0.85
4.56
Syllabus
0.26
0.99
4.68
7k-means: IVF के centroids कहाँ से आते हैं
पड़ाव 3 में IVF के centroids पहले से तैयार थे। उन्हें बनाने का सबसे आम तरीका k-means है, और PQ paper अपने codebooks भी इसी से बनाता है। PQ paper से k-means में k पहले से तय होता है, यानी कितने clusters चाहिए।
k-means vectors को k clusters में बाँटता है, और इसके लिए दो steps बार-बार दोहराता है। पहला step हर vector को सबसे पास वाले centroid को देता है, और दूसरा हर centroid को उसके vectors का औसत बनाता है। पूरा तरीका चार steps में है:
शुरुआत: k vectors random चुनिए, और उन्हें centroids मान लीजिए।
बाँटना: हर vector को उसके सबसे पास वाले centroid के cluster में डालिए।
औसत: हर centroid को उसके cluster के vectors का औसत बना दीजिए।
Steps 2 और 3 तब तक दोहराइए, जब तक कोई vector अपना cluster न बदले।
इसे course के 6 passages पर चलाइए। हर vector के दो numbers हैं: passage office hours के बारे में कितना है, और deadlines के बारे में कितना, जैसे lesson 3 में। k = 2 है, और शुरुआत में queue log और forum post centroids बनते हैं। ये दोनों office hours वाले passages हैं, यानी ये जान-बूझकर खराब शुरुआत है। vectors और शुरुआत मेरी
Passage और vector
Round 1
Round 2
Office hours page[0.9, 0.1]
A
A
Queue log[0.85, 0.2]
A
A
Forum post[0.7, 0.3]
B
A
Syllabus[0.1, 0.9]
B
B
Project page[0.2, 0.8]
B
B
Homework 1 की announcement[0.3, 0.7]
B
B
Round 1. Centroids A = queue log [0.85, 0.2] और B = forum post [0.7, 0.3] हैं। Syllabus [0.1, 0.9] की A से दूरी² 0.75² + 0.7² = 1.0525 है, और B से 0.6² + 0.6² = 0.72। इसलिए syllabus B में जाता है, और project page और Homework भी। Office hours page A में जाता है।
पहला औसत। A = [(0.9 + 0.85) ÷ 2, (0.1 + 0.2) ÷ 2] = [0.875, 0.15]। B के चार vectors का औसत [(0.7 + 0.1 + 0.2 + 0.3) ÷ 4, (0.3 + 0.9 + 0.8 + 0.7) ÷ 4] = [0.325, 0.675] है।
Round 2. Forum post [0.7, 0.3] की A से दूरी² 0.175² + 0.15² = 0.053 है, और B से 0.375² + 0.375² = 0.281। इसलिए forum post A में चला जाता है, और बाकी पाँच अपनी जगह रहते हैं।
दूसरा औसत। A = [0.817, 0.2] और B = [0.2, 0.8]।
Round 3. कोई vector cluster नहीं बदलता, इसलिए k-means रुक जाता है।
Round 1 में B बहुत बड़ा था, क्योंकि शुरुआत के दोनों centroids office hours वाली तरफ़ थे। पहला औसत लेते ही B का centroid deadlines की तरफ़ खिसका, और forum post office hours वाले group में लौट आया।
k-means का हर step एक number को घटाता है, या बराबर रखता है। ये number है हर vector से उसके centroid तक की दूरी² का जोड़। हमारे example में ये 1.553 से शुरू होता है। पहले औसत के बाद ये 0.421 है, round 2 के बाद 0.193, और दूसरे औसत के बाद 0.082। औसत इसलिए घटाता है, क्योंकि औसत ही वो point है, जिससे अपने vectors की दूरी² का जोड़ सबसे कम होता है। जैसे 0.9 और 0.85 से 0.875 तक ये जोड़ 0.025² + 0.025² = 0.00125 है, और 0.85 तक 0.05² + 0 = 0.0025।
बाँटना और औसत, दोनों steps इस जोड़ को कभी नहीं बढ़ाते, इसलिए k-means कहीं न कहीं रुकता ज़रूर है। लेकिन वो जगह हमेशा सबसे अच्छी नहीं होती, और PQ paper भी यही कहता है।
PQ paper इन दो steps से जुड़ी दो शर्तों को Lloyd की शर्तें कहता है। पहली, हर vector सबसे पास वाले centroid को जाए, और दूसरी, हर centroid अपने vectors का औसत हो। PQ paper से पड़ाव 3 के widget के चौकोर boxes भी इन शर्तों पर खरे हैं। हर box अपने cluster के 10, 11, 10 या 9 points का ठीक औसत है। हिसाब मेरा
k-means वाले clusters पर IVF search
अब query [0.8, 0.2] पर nprobe = 1 के साथ IVF चलाइए:
Centroids से दूरी²: A [0.817, 0.2] से 0.0003, और B [0.2, 0.8] से 0.72। इसलिए IVF सिर्फ़ A देखता है।
A के तीन passages से दूरी²: office hours page 0.02, queue log 0.0025, और forum post 0.02।
सबसे पास queue log है, और सारे 6 passages में भी वही सबसे पास है। तुलनाएँ 2 + 3 = 5 हुईं, जबकि brute force में 6।
6 passages पर बचत छोटी है, लेकिन पड़ाव 3 के 10 लाख vectors पर यही तरीका 91 गुना कम काम करता था।
कितने clusters बनाएँ
IVF की तुलनाओं का formula FAISS paper देता है। मान लीजिए K clusters हैं, N vectors उनमें बराबर बँटे हैं, और nprobe clusters देखने हैं: FAISS paper से
तुलनाएँ = K + nprobe × N ÷ K
पहला हिस्सा centroids से तुलनाएँ हैं, और दूसरा चुने हुए clusters के vectors से। K बढ़ाइए, तो पहला हिस्सा बढ़ता है, लेकिन हर cluster छोटा होने से दूसरा हिस्सा घटता है। N = 10 लाख और nprobe = 10 पर ये table देखिए:
K, यानी clusters
10 × N ÷ K
कुल तुलनाएँ
100
1,00,000
1,00,100
1,000
10,000
11,000
3,162
3,162
6,325
10,000
1,000
11,000
1,00,000
100
1,00,100
कुल सबसे कम वहाँ है, जहाँ दोनों हिस्से बराबर हों: K = nprobe × N ÷ K, यानी K² = nprobe × N। यहाँ K² = 10 × 10,00,000 = 1 करोड़, और K = √(1 करोड़) = 3,162। पड़ाव 3 के 1,000 clusters 11,000 तुलनाएँ देते थे, और 3,162 clusters सिर्फ़ 6,325।
FAISS paper ये भी कहता है कि असली data पर ये बस मोटा अंदाज़ा है। Clusters बराबर नहीं बँटते, और ज़्यादा clusters पर वही recall पाने के लिए nprobe भी बढ़ाना पड़ता है। Paper के experiments में सबसे तेज़ K, √N का करीब 15 से 20 गुना निकला। FAISS paper से
Lesson 4 के गहरे version में बात आई थी कि passages दोगुने हों, तो MIPS का समय दोगुने से कम बढ़ता है। FAISS paper ने IVF का समय Nα की तरह नापा, और 0.9 recall पर α = 0.34 निकला। FAISS paper से N दोगुना होने पर समय 20.34 गुना होता है। इसे समझने के लिए 20.5 देखिए: 20.5 × 20.5 = 21 = 2, इसलिए 20.5 = √2 = 1.41। 0.34 उससे छोटा है, और 20.34 = 1.27, यानी समय सिर्फ़ 27% बढ़ता है। ऊँचे recall पर α बढ़ता है: 0.5 recall पर 0.29, और 0.99 पर 0.45।
IVF का नाम lesson 11 के से आया है। वहाँ हर शब्द के साथ उन passages की list होती है, जिनमें वो शब्द है। IVF में हर centroid के साथ उसके cluster के vectors की list होती है। PQ paper query को सबसे पास वाले w centroids देता है, और इसे multiple assignment कहता है। यही w आज का nprobe है। PQ paper से
8PQ के codebooks, और code से तेज़ score
Codebook k-means से बनता है
पड़ाव 4 का codebook पहले से दिया था। असली PQ हर टुकड़े की जगह के लिए अलग से k-means चलाकर codebook बनाता है। PQ paper से यानी training के बहुत सारे vectors लीजिए, उनके पहले टुकड़ों पर k-means से 256 centroids निकालिए, और यही पहला codebook है। दूसरे टुकड़ों से दूसरा codebook बनता है, और ऐसे कुल 96 codebooks।
छोटे पैमाने पर देखिए। 8 training टुकड़े लीजिए, जो जोड़ों में पास-पास हैं। पहला जोड़ा [0.95, 0] और [1.05, 0] है, और दूसरा [0, 0.95] और [0, 1.05]। तीसरा जोड़ा [0.45, 0.55] और [0.55, 0.45] है, और चौथा [0.75, 0.65] और [0.65, 0.75]।
शुरुआत हर जोड़े के एक टुकड़े से हो, तो k = 4 वाला k-means एक round में हर जोड़े को एक cluster बना देता है। हर centroid अपने जोड़े का औसत है, जैसे [(0.75 + 0.65) ÷ 2, (0.65 + 0.75) ÷ 2] = [0.7, 0.7]। चारों centroids [1, 0], [0, 1], [0.5, 0.5] और [0.7, 0.7] हैं, यानी ठीक पड़ाव 4 का codebook। मेरे numbers
Codebooks खुद बहुत छोटे हैं। 96 codebooks × 256 codewords × 8 numbers = 1,96,608 numbers हैं, और हर number 4 bytes का। कुल 7,86,432 bytes, यानी करीब 0.79 MB, जबकि 10 करोड़ codes 9.6 GB के हैं।
नाम में product क्यों
Toy में हर टुकड़ा 4 codewords में से एक ले सकता है, इसलिए code से 4 × 4 = 16 तरह के vectors बन सकते हैं। दो lists की हर जोड़ी के set को गणित में Cartesian product कहते हैं, और PQ का नाम यहीं से आया। PQ paper से असली पैमाने पर ये गिनती 25696 है। 256 = 28, और power की power में exponents गुणा होते हैं, जैसे (22)3 = 43 = 64 = 26। इसलिए 25696 = 28 × 96 = 2768, जो 232 अंकों वाला number है।
इतने vectors की list कोई नहीं रख सकता। PQ सिर्फ़ 96 × 256 = 24,576 codewords रखता है, और उन्हीं के मेल से इनमें से कोई भी vector लिख सकता है।
Lookup table: code से score, vector बनाए बिना
पड़ाव 4 में code से score निकालने के लिए पहले vector [1, 0, 0, 1] वापस बनाया था। PQ paper इससे तेज़ तरीका देता है। इसमें query code में नहीं बदलती। System query के हर टुकड़े का हर codeword से score पहले ही निकालकर एक table में रख लेता है। PQ paper से
Paper इसे asymmetric distance computation, यानी ADC, कहता है, क्योंकि query असली रहती है और passage code में। हमारी query [1, 0, 0, 1] के दो टुकड़े [1, 0] और [0, 1] हैं, और table ये है:
Codeword
पहला टुकड़ा [1, 0]
दूसरा टुकड़ा [0, 1]
#0 [1, 0]
1
0
#1 [0, 1]
0
1
#2 [0.5, 0.5]
0.5
0.5
#3 [0.7, 0.7]
0.7
0.7
अब हर passage का score बस दो numbers का जोड़ है:
Code (0, 1): पहली column में #0 का 1, और दूसरी column में #1 का 1। Score 1 + 1 = 2.0, ठीक पड़ाव 4 वाला।
Code (3, 0): 0.7 + 0 = 0.7। उसके असली vector [0.65, 0.65, 0.95, 0.05] का dot product 0.65 + 0.05 = 0.70 है।
ये table इसलिए चलती है, क्योंकि पूरे vector का dot product टुकड़ों के dot products का जोड़ है। दूरी² भी टुकड़ों की दूरी² का जोड़ है, और PQ paper यही table दूरी² के साथ बनाता है। असली पैमाने पर हिसाब ऐसा है:
Table: 96 टुकड़े × 256 codewords = 24,576 numbers। इसे बनाने में 256 × 768 = 1,96,608 गुणा लगते हैं, और ये हर query पर एक बार होता है।
हर passage: table से 96 numbers उठाइए, और जोड़िए। असली vector पर 768 गुणा लगते थे।
10 करोड़ passages: 10 करोड़ × 96 = 960 करोड़ जोड़, जबकि असली vectors पर 7,680 करोड़ गुणा। साथ में memory से 32 गुना कम data पढ़ना पड़ता है।
PQ paper कहता है कि हर दूरी पर सिर्फ़ m जोड़ लगते हैं, जहाँ m टुकड़ों की गिनती है। Paper में query को भी code में बदलने वाला तरीका, SDC, भी है। लेकिन paper ADC को बेहतर मानता है, क्योंकि उसकी दूरियाँ ज़्यादा सटीक हैं। PQ paper से
IVF और PQ साथ: residual का code
PQ paper IVF और PQ को जोड़ता है, और इस मेल को IVFADC कहता है। PQ paper से इसमें vector का code सीधे नहीं बनता। पहले vector में से उसके cluster का centroid घटाइए, और बचे हुए फ़र्क का code बनाइए। इस फ़र्क को residual कहते हैं।
पड़ाव 7 के cluster A का centroid [0.817, 0.2] है। Queue log [0.85, 0.2] का residual [0.033, 0] है, office hours page [0.9, 0.1] का [0.083, −0.1], और forum post [0.7, 0.3] का [−0.117, 0.1]। ये numbers असली vectors से बहुत छोटे हैं, इसलिए 256 codewords एक छोटे इलाके को घना ढक लेते हैं। Paper भी कहता है कि residual का code, vector के code से ज़्यादा सटीक है।
Paper ज़्यादातर m = 8 टुकड़े और 256 codewords लेता है, यानी हर code 8 bytes, या 64 bits। उसके SIFT image vectors में 128 numbers हैं, यानी 128 × 4 = 512 bytes, इसलिए code 64 गुना छोटा है। IVF के लिए paper 1,000 से 10 लाख तक clusters लेता है, और तरीके को 200 करोड़ vectors पर भी जाँचता है। आख़िरी R candidates को paper असली दूरी से दोबारा क्रम देता है, और R = 10, 100 और 1,000 आज़माता है। PQ paper से
9HNSW: random layers, ef और neighbors चुनने का नियम
कौन सा node कितनी ऊँची layer तक जाता है
HNSW paper हर नए node की सबसे ऊँची layer random चुनता है, और हर अगली layer तक पहुँचने का chance 1/M रखता है। HNSW paper से M = 16 लीजिए। तब हर node 1/16 chance से layer 1 तक पहुँचता है, उनमें से 1/16 layer 2 तक, और ऐसे ही आगे। 10 करोड़ nodes पर गिनती ऐसी बनती है: हिसाब मेरा
कम से कम इस layer तक
हिसाब
Nodes
0
सारे
10,00,00,000
1
10 करोड़ ÷ 16
62,50,000
2
÷ 256
3,90,625
3
÷ 4,096
24,414
4
÷ 65,536
1,526
5
÷ 10,48,576
95
6
÷ 1,67,77,216
6
Layer 7 तक औसतन 0.37 nodes पहुँचते हैं, यानी अक्सर एक भी नहीं। इसलिए सबसे ऊपर की layer करीब 6 है। ये गिनती log16 N है, यानी 16 को कितनी बार गुणा करें कि 10 करोड़ बने: 6.64 बार।
पड़ाव 5 में log2 लिया था, जो 10 करोड़ पर 26.6 है। 16 = 24, इसलिए 16 का हर गुणा 2 के 4 गुणा के बराबर है, और log16 N = log2 N ÷ 4 = 26.6 ÷ 4 = 6.64। Slide के ~log N में आधार नहीं लिखा, क्योंकि आधार बदलने से सिर्फ़ एक तय गुणा बदलता है। Lesson 4 में ln और log10 के साथ भी यही था।
HNSW paper की दलील दो हिस्सों में है। HNSW paper से हर layer पर कदमों की औसत गिनती एक तय number से ऊपर नहीं जाती, N कितना भी बड़ा हो। और layers की गिनती log N की तरह बढ़ती है, जैसा ऊपर की table में दिखा। इसलिए कुल कदम भी log N की तरह बढ़ते हैं। Paper ये बात पक्के तौर पर कम dimensions वाले data पर दिखाता है, और 128 जैसे बड़े dimensions के लिए इसे खुला सवाल मानता है।
Paper का formula: l = ⌊−ln(U) × mL⌋
Paper हर नए node की layer l इस formula से चुनता है: HNSW paper से
l = ⌊ −ln(U) × mL ⌋, जहाँ mL = 1 ÷ ln M
U, 0 और 1 के बीच का एक random number है। M = 16 पर 16 = 2.773, इसलिए mL = 0.361। ⌊x⌋ का मतलब है x का दशमलव वाला हिस्सा हटाना, जैसे ⌊2.10⌋ = 2। तीन random draws देखिए:
U = 0.5: −ln 0.5 = 0.693, और 0.693 × 0.361 = 0.25। ⌊0.25⌋ = 0, यानी node सिर्फ़ layer 0 में रहता है।
U = 0.05: −ln 0.05 = 2.996, और 2.996 × 0.361 = 1.08। Node layer 1 तक जाता है।
U = 0.003: −ln 0.003 = 5.809, और 5.809 × 0.361 = 2.10। Node layer 2 तक जाता है।
Node layer 1 तक तब पहुँचता है, जब −ln(U) × mL कम से कम 1 हो। दोनों तरफ़ ln 16 से गुणा कीजिए, तो शर्त बनती है −ln U ≥ ln 16। Lesson 4 के नियम ln(a ÷ b) = ln a − ln b से −ln U = ln(1 ÷ U)। ln एक increasing function है, इसलिए शर्त का मतलब है 1 ÷ U ≥ 16, यानी U ≤ 1/16 = 0.0625।
U के 0.0625 से छोटा होने का chance ठीक 1/16 है। इसी तरह layer 2 के लिए U ≤ 1/256 = 0.0039 चाहिए। ऊपर का 0.05 पहली शर्त पूरी करता है, और 0.003 दोनों। Paper के हिसाब से mL = 1/ln M एक आसान और अच्छा चुनाव है।
ef: एक की जगह कई candidates
पड़ाव 5 की greedy चाल हर पल सिर्फ़ एक node याद रखती थी। HNSW paper की search layer 0 पर अब तक मिले ef सबसे पास वाले nodes की list रखती है। वो इन सारे nodes के neighbors देखती है। HNSW paper से ऊपर की layers पर ef = 1 रहता है, यानी वहाँ वही greedy चाल चलती है। ef बड़ा हो, तो ज़्यादा दूरियाँ निकलती हैं, लेकिन recall बढ़ता है। इसलिए HNSW में ef वही काम करता है, जो IVF में nprobe।
पड़ाव 5 के example में layer 0 पर node 70 से ef = 3 के साथ चलिए। List में ज़्यादा से ज़्यादा 3 nodes रहते हैं। Search हर बार list का वो सबसे पास वाला node लेती है, जिसके neighbors अभी नहीं देखे: मेरा example
70 (3) के neighbors 65 (8) और 75 (2) हैं। List अभी भरी नहीं है, इसलिए दोनों आते हैं: {75, 70, 65}।
75 के neighbors 70 और 80 हैं। 70 पहले से list में है, और 80 (7) list के सबसे दूर वाले 65 (8) से पास है। इसलिए 80 आता है और 65 हटता है: {75, 70, 80}।
80 का नया neighbor 85 (12) list के सबसे दूर वाले 80 (7) से भी दूर है, इसलिए वो नहीं आता।
बचा हुआ candidate 65 (8) भी list के सबसे दूर वाले 80 (7) से दूर है, इसलिए search रुकती है।
नतीजा {75, 70, 80} है, और query 73 का असली top-3 भी यही है: 75 (2), 70 (3) और 80 (7)। ef = 1 पर search सिर्फ़ 75 लौटाती। Paper का search algorithm आख़िर में list से k सबसे पास nodes लौटाता है, इसलिए ef कम से कम k होना चाहिए। DPR ने FAISS के HNSW index में search depth 128 रखी थी, और यही ef है। DPR paper से
Neighbors चुनने का नियम, जिससे चाल फँसे नहीं
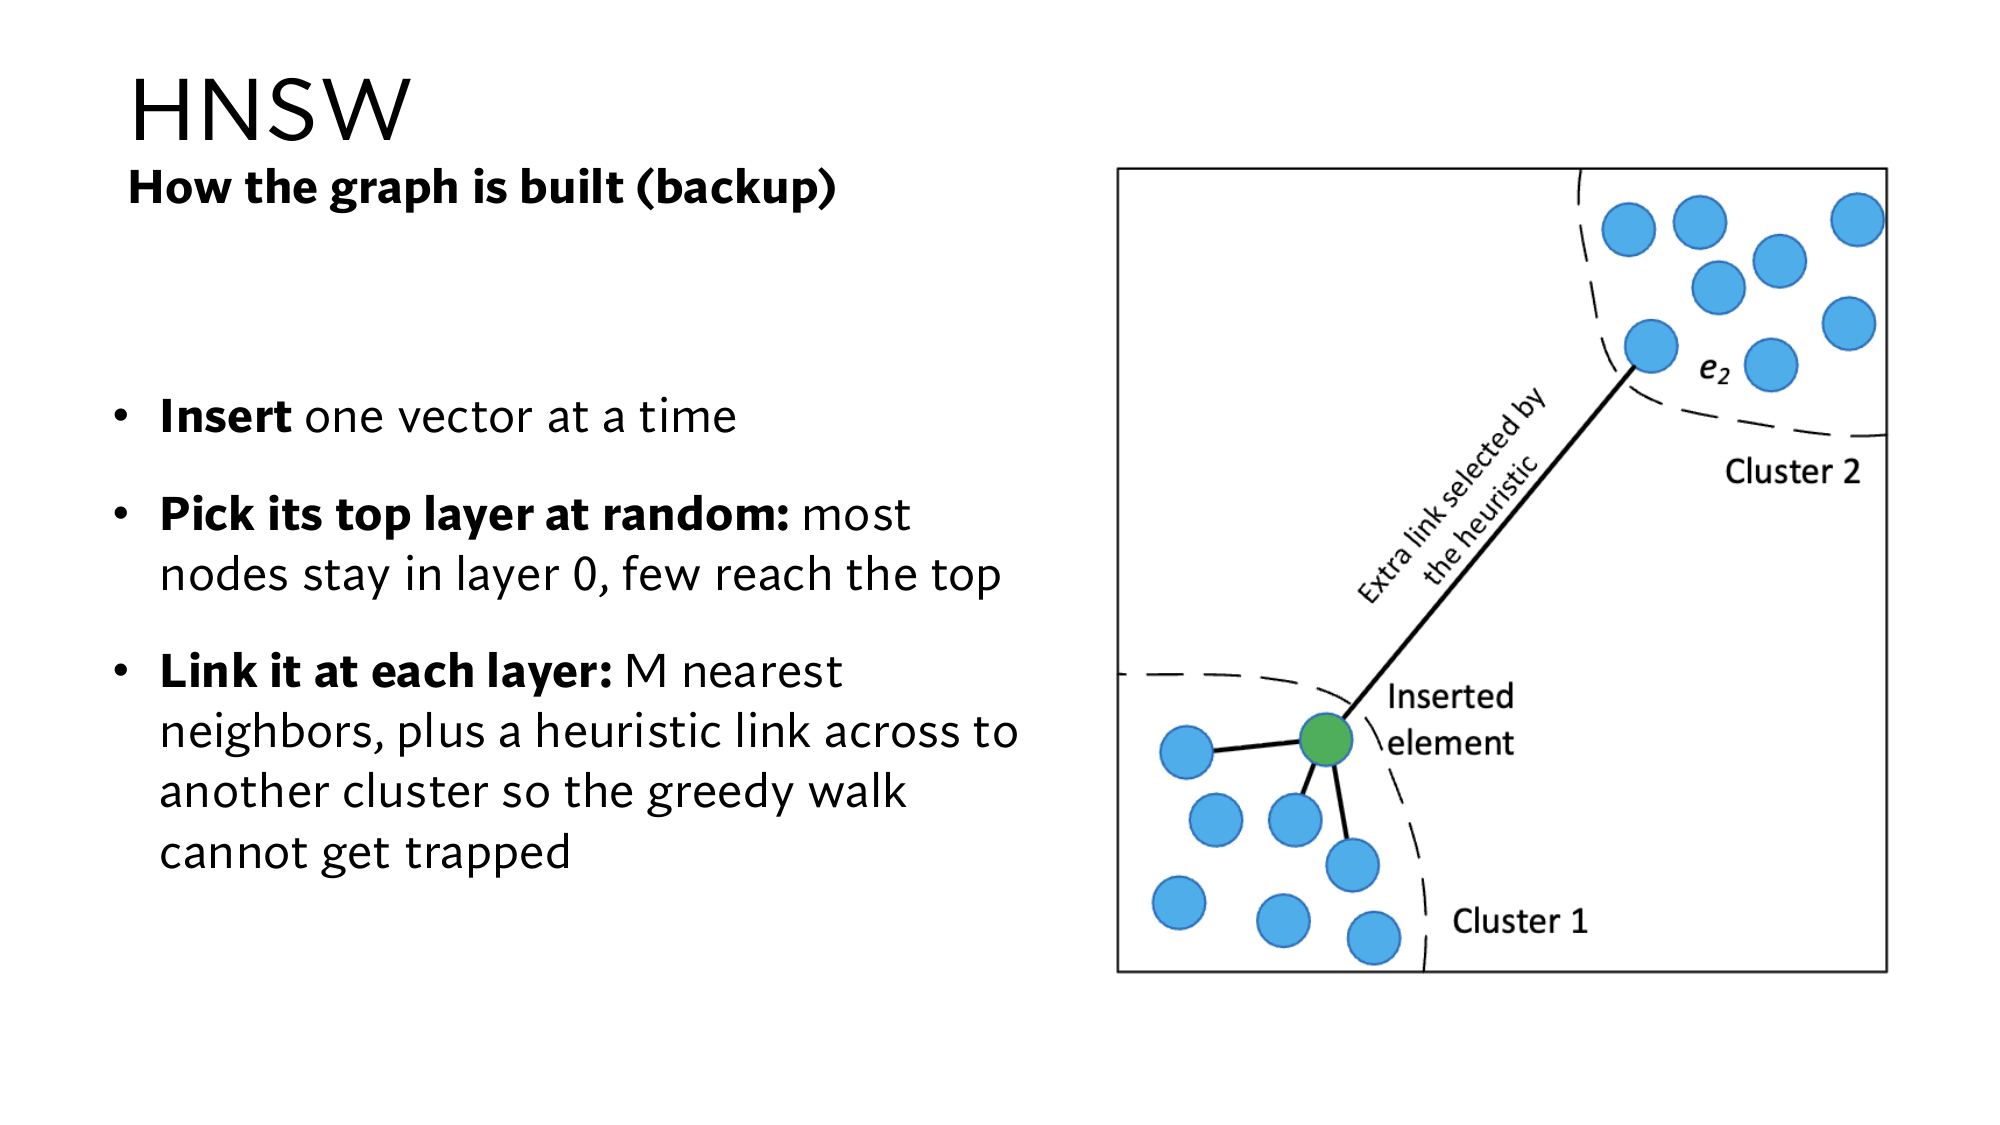
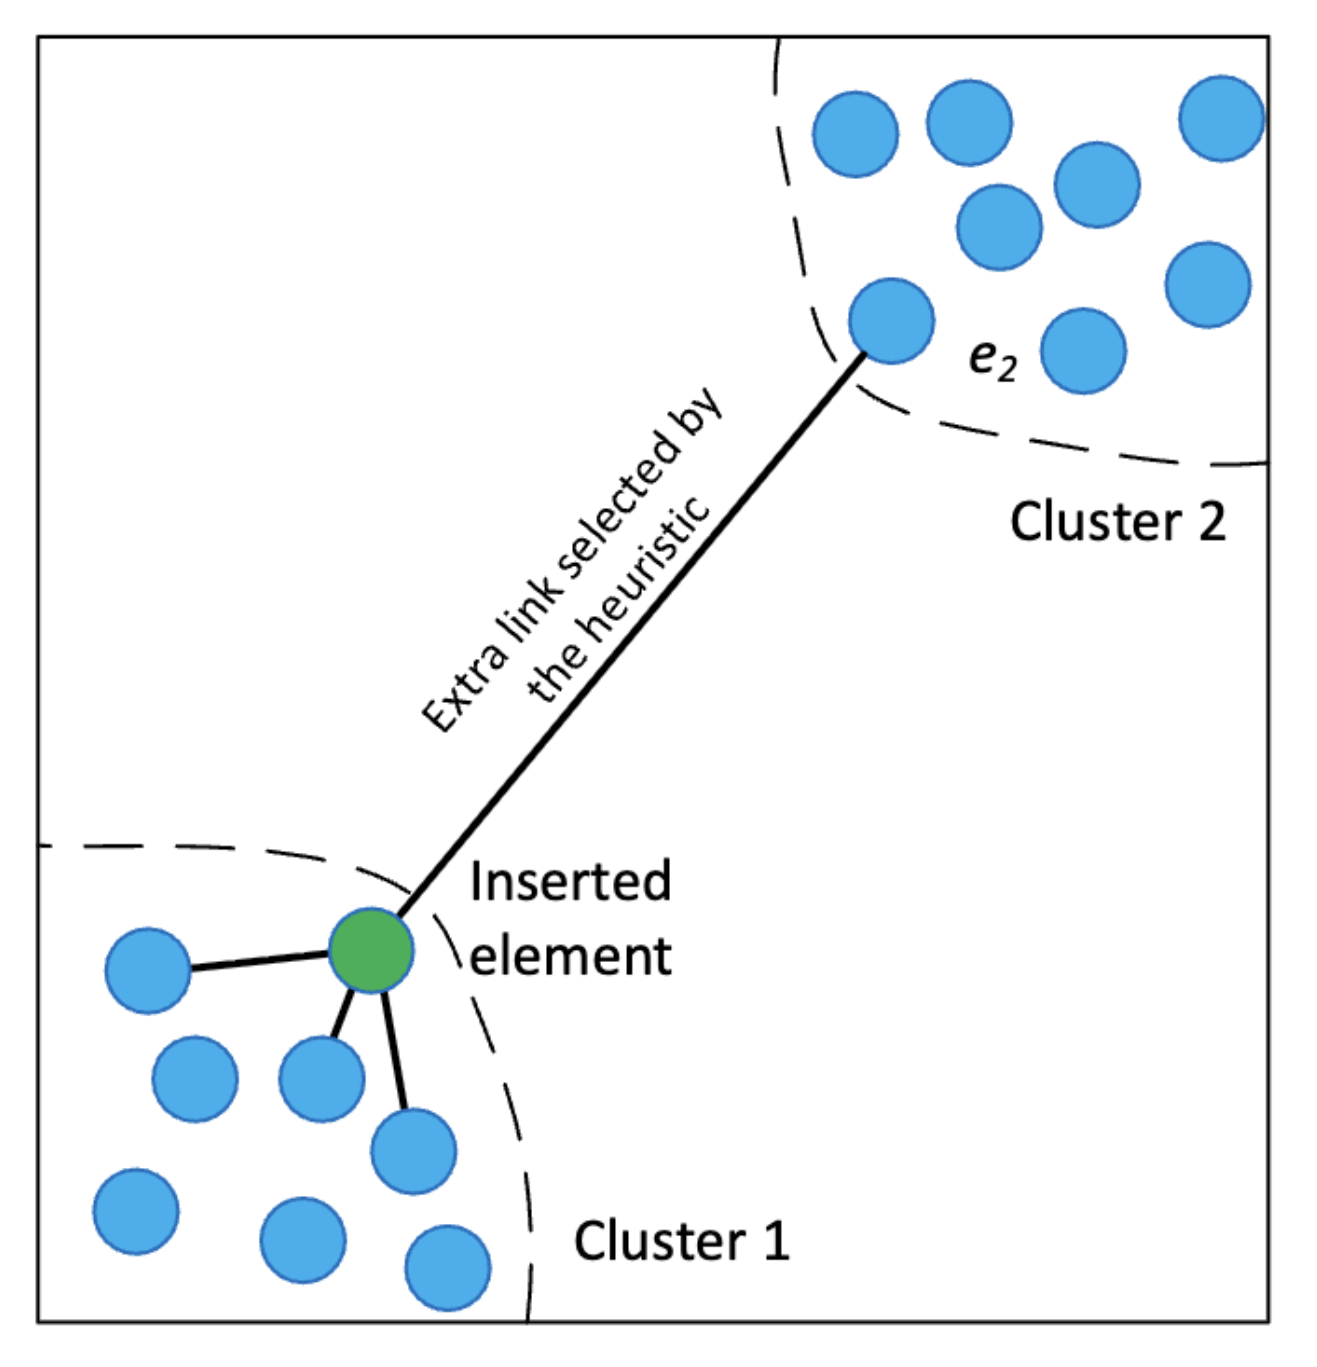
आसान version में हर नया node अपने M सबसे पास वाले nodes से जुड़ता था। HNSW paper इससे बेहतर नियम लेता है, जिसे वो heuristic कहता है। HNSW paper सेCandidates को पास से दूर के क्रम में देखिए। किसी candidate को तभी जोड़िए, जब वो पहले से जुड़े हर node की तुलना में नए node के ज़्यादा पास हो।
एक example लीजिए। नया node X = [3, 0] है, और M = 2। Cluster 1 में A [2, 0], B [1.6, 0.6] और C [1.5, −0.5] हैं, और cluster 2 में E2 [6, 0]। मेरे numbers
Candidate
X से दूरी
पहले जुड़े A से दूरी
फ़ैसला
A
1.00
–
जोड़िए
B
1.52
0.72
छोड़िए
C
1.58
0.71
छोड़िए
E2
3.00
4.00
जोड़िए
सिर्फ़ पास वाले चुनने पर X, A और B से जुड़ता, और दोनों cluster 1 में हैं। नियम B और C को छोड़ता है, क्योंकि दोनों X के बजाय A के ज़्यादा पास हैं, यानी A के रास्ते पहुँच में हैं। E2 दूर है, लेकिन A से और भी दूर है, यानी वो एक नई दिशा में है, इसलिए वो जुड़ता है। Stanford की backup slide पर e2 वाली “extra link” यही है।
अब cluster 2 में दो nodes और रखिए, F [7, 1] और G [6.4, 0.6], जो E2 से और आपस में जुड़े हैं। Cluster 1 के A, B और C भी आपस में जुड़े हैं। Query [6.5, 0.5] है, और search B से शुरू होती है:
कहाँ हैं (दूरी)
Neighbors (दूरी)
फ़ैसला
B (4.90)
A (4.53), C (5.10)
A पर जाइए
A (4.53)
B (4.90), C (5.10), X (3.54)
X पर जाइए
X (3.54)
A (4.53), E2 (0.71)
E2 पर जाइए
E2 (0.71)
X (3.54), F (0.71), G (0.14)
G पर जाइए
G (0.14)
E2 (0.71), F (0.71)
अटके। जवाब: G
नियम के बिना X के neighbors A और B होते। तब search B से सीधे X पर पहुँचती, और वहीं अटक जाती, क्योंकि A और B दोनों query से X के मुकाबले ज़्यादा दूर हैं। जवाब X आता, जिसकी दूरी 3.54 है, जबकि असली सबसे पास वाला G 0.14 पर है। HNSW paper भी कहता है कि सिर्फ़ पास वाले neighbors से clustered data पर search clusters के किनारे पर अटकती है। तब ऊँचा recall नहीं मिलता। HNSW paper से
Memory और पैमाना
HNSW की memory ज़्यादातर edges में जाती है। HNSW paper से Layer 0 पर हर node की ज़्यादा से ज़्यादा Mmax0 edges हैं, और paper Mmax0 = 2M सुझाता है। ऊपर की हर layer पर Mmax edges हैं, और एक node औसतन mL ऊपरी layers में होता है। हर edge एक 4 bytes का number है, इसलिए paper का formula ये है:
memory per vector = (Mmax0 + mL × Mmax) × 4 bytes
M = 16 और Mmax = M लीजिए: Mmax = M मेरा मानना है
Mmax0 = 2 × 16 = 32, और mL × Mmax = 0.361 × 16 = 5.77।
(32 + 5.77) × 4 = 151 bytes हर vector पर।
10 करोड़ vectors पर 15.1 GB, vectors के अपने 300 GB के ऊपर।
Paper M को 5 से 48 के बीच ठीक मानता है, और edges की memory 60 से 450 bytes per vector बताता है। जाँच: M = 6 पर (12 + 0.558 × 6) × 4 = 61 bytes, और M = 48 पर (96 + 0.258 × 48) × 4 = 434 bytes। Paper के हिसाब से छोटा M कम recall और कम dimensions पर बेहतर है, और बड़ा M ऊँचे recall और ज़्यादा dimensions पर।
Graph बनाने में भी ef चलता है, जिसे efConstruction कहते हैं। नया node जोड़ते वक्त HNSW इसी size की list से उसके candidates ढूँढता है। Paper में 1 करोड़ SIFT vectors का index efConstruction = 100 पर, 40 cores वाले server पर करीब 3 minute में बना। DPR ने lesson 12 के 2.1 करोड़ vectors के लिए हर node के 512 neighbors और efConstruction 200 रखा। उसका index 8.5 घंटे में बना। DPR paper से
10अब Stanford की slides खुद पढ़िए
नीचे Stanford की vector search वाली तीन slides हैं, बिना किसी बदलाव के। हर slide के नीचे कुछ सवाल हैं। पहले खुद जवाब सोचिए, फिर खोलिए। कोई बात अटके, तो जवाब में लिखे पड़ाव पर लौट जाइए। Phone पर slide छोटी दिखे, तो image पर click कीजिए, वो पूरे size में खुलेगी।
Stanford की vector search वाली slide, और नीचे उसका text, बड़ा करके।
Vector search वाली slide पढ़िए
O(N·d) per query में N और d क्या हैं? 10 करोड़ passages और d = 768 पर इसका मतलब क्या है?
जवाब देखिए
N index के vectors की गिनती है, और d हर vector के numbers की। 10 करोड़ × 768 = 7,680 करोड़ गुणा, यानी 1,000 करोड़ per second पर करीब 7.7 seconds per query। दूरी से भी यही खर्च है। (पड़ाव 1 और 6)
“trade a little recall for a lot of speed” में recall किस चीज़ का है? Lesson 13 के Recall@k से ये कैसे अलग है?
जवाब देखिए
यहाँ recall बताता है कि brute force के असली top-k में से ANN ने कितने लौटाए, जैसे 10 में से 9 पर 0.9। Lesson 13 का Recall@k इंसानों के labels से नापता है कि सही passages top-k में आए या नहीं। (पड़ाव 2)
IVF, PQ और HNSW में से कौन तुलनाओं की गिनती घटाता है, और कौन memory? IVF की line के centroids कहाँ से आते हैं?
जवाब देखिए
IVF और HNSW कम vectors देखते हैं, यानी तुलनाएँ घटाते हैं। PQ memory घटाता है, 3,072 से 96 bytes per vector, और lookup table से हर तुलना भी सस्ती करता है। “Cluster the index” वाले centroids k-means से आते हैं, और “probe only the nearest centroids” में कितने centroids देखने हैं, वो nprobe तय करता है। (पड़ाव 3, 4, 7 और 8)
Stanford की HNSW वाली slide, और नीचे उसका चित्र, बड़ा करके। ये चित्र HNSW paper का है।
HNSW वाली slide पढ़िए
चित्र में लाल point, लाल arrows, लाल dashed arrows और हरा point क्या हैं? लाल point से हरे point तक कितने कदम हैं?
जवाब देखिए
लाल point सबसे ऊपर की layer का शुरुआती node है। लाल arrows greedy कदम हैं, और लाल dashed arrows वहाँ हैं, जहाँ search अटककर एक layer नीचे उतरी। HNSW paper के caption के हिसाब से हरा point query है। हर layer पर एक कदम है, यानी कुल 3 कदम। काली dashed lines दिखाती हैं कि ऊपर का हर node नीचे की हर layer में भी है। (पड़ाव 5)
दाईं तरफ़ का arrow “Decreasing characteristic radius” क्या कहता है?
जवाब देखिए
नीचे की layers में edges छोटी होती जाती हैं। ऊपर कम nodes हैं, इसलिए उनके बीच की edges लंबी हैं, और एक कदम दूर तक ले जाता है। हमारे example में layer 2 पर 40 की छलाँग थी, layer 1 पर 20, और layer 0 पर 5। (पड़ाव 5)
“~log N hops, high recall” में log का आधार क्या है? 10 करोड़ vectors पर ये कितना है, और high recall किससे आता है?
जवाब देखिए
Slide आधार नहीं लिखती, क्योंकि आधार बदलने से सिर्फ़ एक तय गुणा बदलता है। log2 से 10 करोड़ पर करीब 27 बनता है, और M = 16 वाली layers की गिनती log16 से करीब 6.64। हर layer पर कदम एक तय number से ऊपर नहीं जाते, और layers log N की तरह बढ़ती हैं। High recall के लिए layer 0 पर ef वाली search चलती है। (पड़ाव 5 और 9)
Stanford की HNSW वाली दूसरी slide: graph कैसे बनता है। Title में “backup” का मतलब है कि ये lecture की एक extra slide है। नीचे उसका चित्र है, बड़ा करके, और ये भी HNSW paper का है।
Graph बनाने वाली slide पढ़िए
Slide कहती है: “Pick its top layer at random: most nodes stay in layer 0, few reach the top”। M = 16 पर 10 करोड़ में से कितने nodes layer 1 तक पहुँचते हैं, और सबसे ऊपर कितने?
जवाब देखिए
हर अगली layer का chance 1/16 है। इसलिए layer 1 तक 10 करोड़ ÷ 16 = 62,50,000 nodes पहुँचते हैं, और layer 6 तक करीब 6। बाकी 15/16, यानी करीब 9.4 करोड़ nodes, सिर्फ़ layer 0 में रहते हैं। (पड़ाव 9)
चित्र में नया हरा node cluster 1 के किनारे पर है। e2 तक की “extra link” कौन सा नियम चुनता है, और उसके बिना क्या होता?
जवाब देखिए
Neighbors चुनने का नियम: candidate तभी जुड़ता है, जब वो पहले से जुड़े हर node की तुलना में नए node के ज़्यादा पास हो। Cluster 1 के बाकी candidates पहले से जुड़े nodes के ज़्यादा पास हैं, इसलिए छूटते हैं, और e2 नई दिशा में है, इसलिए जुड़ता है। इसके बिना greedy चाल cluster 1 के किनारे पर अटकती, जैसे हमारे example में X पर। (पड़ाव 9)
“M nearest neighbors” वाला M memory और recall पर कैसे असर डालता है?
जवाब देखिए
Layer 0 पर हर node की 2M तक edges होती हैं, और हर edge 4 bytes की। M = 16 पर ये करीब 151 bytes per vector है, यानी 10 करोड़ vectors पर 15.1 GB। HNSW paper के हिसाब से बड़ा M ऊँचे recall पर बेहतर है, लेकिन memory भी उसी हिसाब से बढ़ती है। (पड़ाव 9)
इस lesson की 3 बातें
Brute force का खर्च O(N·d) है, दूरी से भी। Length 1 वाले vectors पर दूरी² = 2 − 2 × dot product, इसलिए दूरी वाले index MIPS का काम भी कर देते हैं।
IVF के centroids k-means से बनते हैं, और तुलनाएँ K + nprobe × N ÷ K हैं, जो K = √(nprobe × N) पर सबसे कम होती हैं। PQ के codebooks भी k-means से बनते हैं, और lookup table से हर vector का score 96 जोड़ों में आता है।
HNSW में हर ऊपरी layer तक 1/M nodes पहुँचते हैं, इसलिए layers करीब log N हैं। ef recall तय करता है, और neighbors चुनने का नियम clusters के बीच edges रखकर greedy चाल को फँसने से बचाता है।
इस lesson के नए शब्द
Exact search (brute force)
हर vector से तुलना करके पक्का सही top-k निकालना। जैसे 21 vectors हों, तो 21 दूरियाँ गिनना।
Big-O, O(N·d)
N या d बढ़ने पर खर्च किस हिसाब से बढ़ता है। जैसे O(N·d) में N दोगुना हो, तो खर्च भी दोगुना।
Nearest neighbors
Query के सबसे पास वाले vectors। जैसे query 73 के पास वालों में 75 पहले आता है।
ANN
Approximate nearest neighbor search: कम vectors देखकर ज़्यादातर बार सही neighbors ढूँढना। जैसे असली top-10 में से 9 मिलें, तो recall 0.9।
दूरी
दो vectors के फ़र्क वाले vector की length। जैसे [0.8, 0.2] और [0.9, 0.1] का फ़र्क [0.1, −0.1] है, तो दूरी √(0.01 + 0.01) = 0.14।
IVF
Inverted file index: vectors को clusters में बाँटकर query के पास वाले clusters ही देखना। जैसे 10 लाख vectors पर 11,000 तुलनाएँ।
nprobe
IVF में कितने clusters देखने हैं। जैसे 1,000 clusters में nprobe = 10 हो, तो सिर्फ़ 10 clusters के vectors देखना।
Product quantization (PQ)
Vector को टुकड़ों में काटकर हर टुकड़े की जगह codeword का number रखना। जैसे [0.9, 0.1, 0.2, 0.8] बनता है code (0, 1)।
Codebook
हर टुकड़े के नमूना vectors (codewords) की list। जैसे #0 [1, 0], #1 [0, 1], #2 [0.5, 0.5], #3 [0.7, 0.7]।
Proximity graph
ऐसा graph, जिसमें हर vector अपने पास वाले vectors से जुड़ा हो। जैसे 70 अपने पड़ोसी 65 और 75 से जुड़ा है।
Greedy search
हर कदम पर query के सबसे पास वाले neighbor पर जाना, अटकने तक। जैसे query 73 के लिए 70 से 75 पर जाना।
HNSW
Layers वाला proximity graph: ऊपर से greedy चाल, और अटकने पर एक layer नीचे। जैसे query 73 पर 4 कदम।
k-means
Vectors को k clusters में बाँटने का तरीका: हर vector को सबसे पास वाले centroid को देना, फिर हर centroid को औसत बनाना। जैसे 6 passages पर 3 rounds में A = [0.817, 0.2] और B = [0.2, 0.8]।
Lookup table (ADC)
Query के हर टुकड़े का हर codeword से score पहले निकालकर table में रखना। तब हर passage का score बस table के numbers का जोड़ है। जैसे code (0, 1) का score 1 + 1 = 2.0।
Residual
Vector में से उसके cluster का centroid घटाने पर बचा फ़र्क। IVFADC इसी का code बनाता है। जैसे queue log [0.85, 0.2] − [0.817, 0.2] = [0.033, 0]।
ef
HNSW की search में अब तक मिले सबसे पास वाले nodes की list का size। बड़ा ef यानी ज़्यादा दूरियाँ और ऊँचा recall। जैसे node 70 से ef = 3 पर नतीजा {75, 70, 80}।
Neighbors चुनने का नियम (heuristic)
Candidate तभी जुड़ता है, जब वो पहले से जुड़े हर node की तुलना में नए node के ज़्यादा पास हो। जैसे X के लिए A और E2 जुड़ते हैं, और B और C छूटते हैं।