RAPTOR और GraphRAG index में chunks के साथ उनके सार भी रखते हैं, ताकि पूरे document में बिखरे जवाब भी मिल सकें। RAPTOR सारों का एक tree बनाता है, और GraphRAG text की चीज़ों और उनके रिश्तों का graph।
इसकी ज़रूरत इस सवाल पर दिखती है: What are all the deadlines? जवाब में course की 4 तारीखें हैं, और वो lesson 2 के तीन passages में बिखरी हैं। Syllabus में milestone (Week 6) और final report (Week 10) हैं। Project page में proposal (Oct 9) है, और Homework 1 की announcement में उसके release की तारीख (Oct 5)। Retriever project page को सबसे ऊपर रखता है, इसलिए K = 1 पर reader को 4 में से 1 तारीख मिलती है। मेरे बनाए vectors से
इस lesson की सीढ़ी
सीढ़ी में 10 पड़ाव हैं। पहले 5 आसान version जैसे ही हैं, और 6 से 10 आपको Stanford की slides के level तक ले जाते हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
पहले से क्या चाहिए: Lesson 3 (vector, cosine), Lesson 6 (indexing time, query time) और Lesson 7 (chunk, mean pooling)। पड़ाव 6 से आगे Lesson 4 (exp, softmax, marginalization, likelihood) भी काम आता है। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1Top-K सिर्फ़ टुकड़े लाता है
Detail question का जवाब किसी एक passage में लिखा होता है, और thematic question का जवाब कई passages को मिलाकर बनता है।When is the milestone due? detail question है, क्योंकि जवाब syllabus की एक line में है। What are all the deadlines? thematic है, क्योंकि उसकी 4 तारीखें तीन passages में हैं।
Retriever हर passage को अलग से score देता है, और ऊपर के K passages लौटाता है। Thematic question पर हर passage के पास जवाब का सिर्फ़ एक हिस्सा होता है। नीचे हर text का vector 4 numbers का है। पहला number बताता है कि text milestone के बारे में कितना है, दूसरा बाकी deadlines के बारे में, और तीसरा office hours के बारे में। चौथा number बताता है कि text कितनी बातें समेटता है, यानी वो कितना overview जैसा है। vectors मेरे बनाए हैं
Detail question पर syllabus को 0.99 मिला, यानी साफ़ जीत। Thematic question पर सबसे ऊँचा cosine project page का 0.66 है, और उसमें 4 में से 1 तारीख है। कोई भी passage “सारी deadlines” के बारे में नहीं है, इसलिए किसी का cosine ऊँचा नहीं आता। सवाल का चौथा number 0.8 है, क्योंकि वो overview माँगता है, जबकि हर passage का चौथा number सिर्फ़ 0.1 या 0.15 है।
पहले सोचिए
K = 3 पर reader को कितनी तारीखें मिलेंगी? और अगर 40 pages के syllabus में 10 deadlines 10 अलग chunks में हों, तो K = 3 पर कितनी?
जवाब देखिए
इन 6 passages में top-3 project page (0.66), Homework 1 की announcement (0.61) और syllabus (0.60) हैं, इसलिए चारों तारीखें मिल जाती हैं। लेकिन 10 chunks वाले syllabus में K = 3 पर कम से कम 7 deadlines छूटेंगी। K पहले से तय होता है, और retriever नहीं जानता कि सवाल को कितने टुकड़े चाहिए। मेरा example
पूरे syllabus का एक बड़ा chunk भी नहीं चलता। Lesson 7 में बड़े chunk का vector उसके विषयों का औसत था, यानी । वहाँ दो विषय मिलने पर ही cosine 1.00 से 0.71 पर गिरा था। इसलिए index में ऐसा text चाहिए, जो खुद सारी deadlines के बारे में हो, यानी कई passages का लिखा हुआ सार।
2मिलते-जुलते passages के groups: clustering
सारे 6 passages का एक ही सार बहुत मोटा होगा। Deadlines का एक सार और office hours का दूसरा सार ज़्यादा काम का है। इसलिए सार लिखने से पहले passages को विषय के हिसाब से groups में बाँटिए।
Clustering का मतलब है vectors को ऐसे groups में बाँटना, कि एक group के vectors आपस में पास हों और दूसरे groups से दूर। हर group को cluster कहते हैं। “पास” नापने के लिए यहाँ cosine काफ़ी है: cosine 1 के जितना पास, दोनों vectors की दिशा उतनी मिलती है।
हाथ का हिसाब छोटा रखने के लिए यहाँ lesson 3 वाले 2 numbers लीजिए। पहला number बताता है कि text office hours के बारे में कितना है, और दूसरा deadlines के बारे में। vectors मेरे बनाए हैं
जोड़ा
Cosine
नतीजा
Syllabus [0.1, 0.9] और project page [0.2, 0.8]
0.99
एक cluster
Office hours page [0.9, 0.1] और queue log [0.85, 0.2]
0.99
एक cluster
Syllabus [0.1, 0.9] और office hours page [0.9, 0.1]
0.22
अलग clusters
पहली row ऐसे निकली। Dot product 0.1 × 0.2 + 0.9 × 0.8 = 0.02 + 0.72 = 0.74 है। Lengths √(0.01 + 0.81) = 0.906 और √(0.04 + 0.64) = 0.825 हैं, इसलिए cosine 0.74 ÷ (0.906 × 0.825) = 0.74 ÷ 0.747 = 0.99 है।
ऐसे बाकी जोड़े मिलाइए, तो दो clusters बनते हैं। Deadlines वाले cluster में syllabus, project page और Homework 1 की announcement [0.15, 0.85] हैं। Office hours वाले cluster में office hours page, queue log और पुराना forum post [0.8, 0.15] हैं।
हर cluster का एक बीच वाला point भी होता है, जो पूरे cluster की जगह खड़ा हो सकता है। Centroid cluster के सारे vectors का औसत है, जिसमें हर जगह के number का औसत अलग से लेते हैं। Deadlines cluster में पहला number (0.1 + 0.2 + 0.15) ÷ 3 = 0.15 है, और दूसरा (0.9 + 0.8 + 0.85) ÷ 3 = 0.85। तो centroid [0.15, 0.85] है, और office hours वाले cluster का [0.85, 0.15]। Lesson 10 में centroid search को तेज़ करता है।
कुछ passages दो विषयों के बीच होते हैं। Lesson 3 के लंबे FAQ page [1.6, 1.4] का cosine office hours वाले centroid से 0.86 है, और deadlines वाले से 0.78। RAPTOR ऐसे passage को दोनों clusters में रख सकता है, ताकि उसकी बात दोनों सारों तक पहुँचे। इसे soft clustering कहते हैं।
3RAPTOR: सारों का tree, नीचे से ऊपर
RAPTOR हर cluster का सार एक LLM से लिखवाता है, और उस सार को भी एक chunk की तरह index में रखता है। सार नया text है, vectors का औसत नहीं। इसलिए उसका vector “सारी deadlines” की दिशा में होता है, जबकि lesson 7 के बड़े chunk का vector औसत में घुल गया था।
सारों के ऊपर भी सार बन सकता है: deadlines के सार और office hours के सार से पूरे course का एक सार। ऐसे levels वाले ढाँचे को tree कहते हैं। Tree का हर box एक node है। सबसे नीचे के nodes, यानी असली chunks, leaves कहलाते हैं, और सबसे ऊपर का node root।
RAPTOR का पूरा नाम Recursive Abstractive Processing for Tree-Organized Retrieval है, और इसे 2024 में Stanford के Sarthi और साथियों ने बनाया paper से। ये tree नीचे से ऊपर पाँच steps में बनता है:
हर chunk का embedding बनाइए।
Embeddings को cluster कीजिए।
हर cluster के chunks एक LLM को दीजिए, और उनका सार लिखवाइए। ये सार एक level ऊपर का नया node है।
सारों के embeddings बनाइए।
Steps 2 से 4 दोहराइए, जब तक सबसे ऊपर गिने-चुने nodes न बचें।
Course corpus पर tree ऐसा बनता है। 6 passages leaves हैं, उनके ऊपर 2 सार हैं, और सबसे ऊपर 1 root। मेरा example
Level
Node
Text
2, root
R, course का overview
CS 329Z logistics: deadlines from Oct 5 to Week 10, and office hours on Tuesday and Thursday.
1
A, deadlines का सार
Homework 1 releases Oct 5. Proposal due Oct 9. Milestone due Week 6, Thursday 11:59pm, no late days. Final report Week 10.
1
B, office hours का सार
Tuesday 4pm in Room 104 (busy, about 14 waiting) and Thursday 9am on Zoom (about 3). An old 2024 post says midweek afternoons are quiet.
0, leaves
6 passages
Lesson 2 के 6 passages
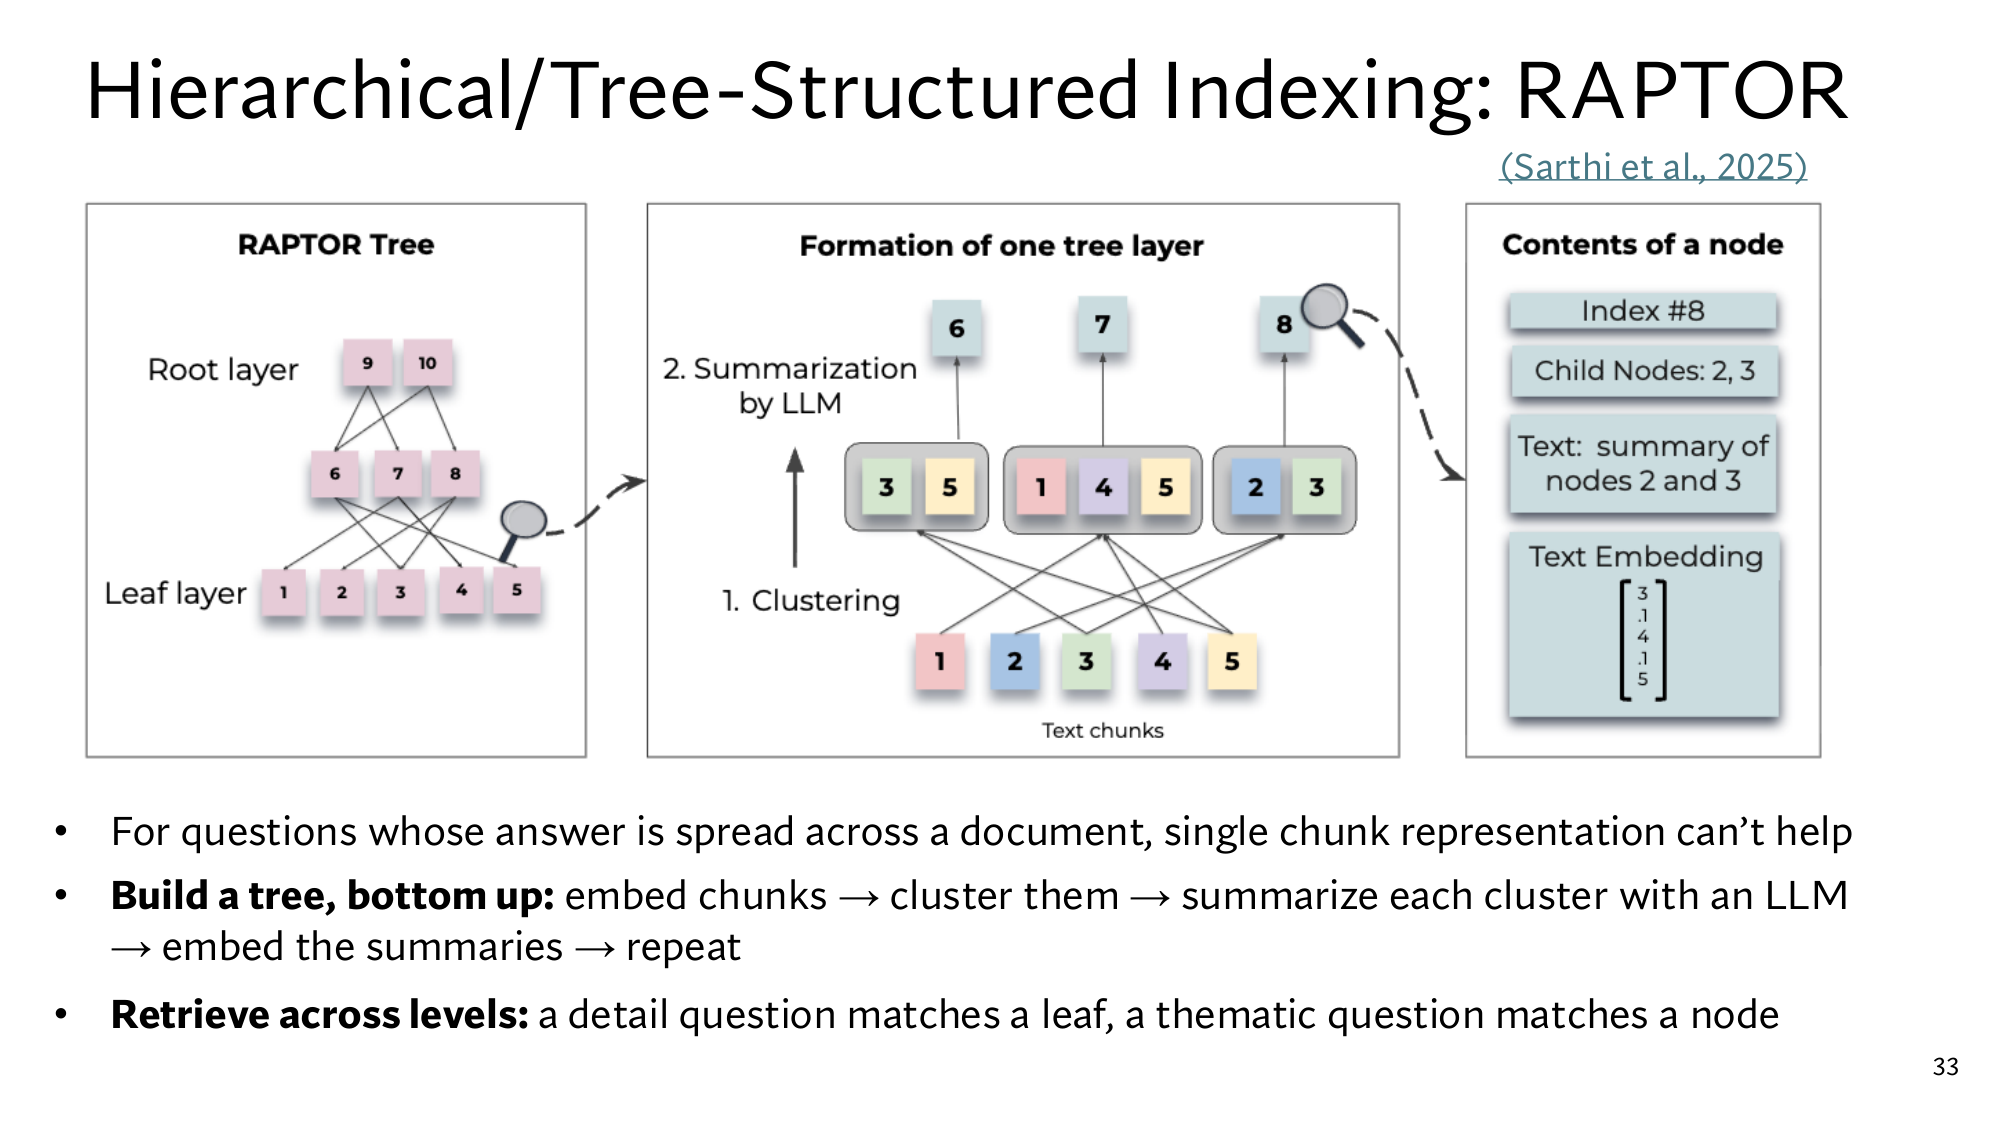
Stanford की RAPTOR slide: बाएँ पूरा tree, बीच में एक level बनने के दो steps, और दाएँ एक node के अंदर की चीज़ें। Image पर click करने से वो पूरे size में खुलती है।
Slide के बीच वाले box में 5 chunks से 3 groups बने: {3, 5}, {1, 4, 5} और {2, 3}। Chunk 3 और 5 दो-दो groups में हैं, यानी यहाँ soft clustering है। हर group का सार ऊपर का एक node बना: 6, 7 और 8। दाएँ box में node 8 के children (2 और 3), उनका सार, और उस सार का embedding है।
इसकी कीमत indexing time पर है, क्योंकि हर level पर हर cluster के लिए एक LLM call लगता है। सार LLM लिखता है, इसलिए वो बारीक बात छोड़ सकता है, या गलत लिख सकता है। Node B ने पुराने post की राय को queue log के data के बराबर रख दिया। यानी पुराने forum post की दिक्कत अब सार में बैठ गई।
पहले सोचिए
Corpus में 64 chunks हैं, और हर cluster में करीब 4 nodes आते हैं। Root तक कितने levels बनेंगे, और कुल कितने सार?
जवाब देखिए
Level 1 पर 64 ÷ 4 = 16 सार बनते हैं, level 2 पर 16 ÷ 4 = 4, और level 3 पर 4 ÷ 4 = 1 root। कुल 16 + 4 + 1 = 21 सार, यानी indexing पर 21 LLM calls। Leaves के ऊपर 3 levels बने।
4Tree के हर level में ढूँढना
RAPTOR सवाल को tree के हर level के nodes से मिलाता है, leaves से भी और सारों से भी। Leaves और सार एक ही index में हैं, इसलिए retriever हर node का cosine निकालता है, और ऊपर के nodes लौटाता है। Widget में हर node का 4 numbers वाला vector है, और सारों का चौथा number बड़ा है, क्योंकि वो कई बातें समेटते हैं। vectors मेरे बनाए हैं
सवाल tree के किस level से मिलता है?
एक सवाल चुनिए। Table हर node का cosine दिखाती है, सबसे ऊँचा पहले। चुनने से पहले अंदाज़ा लगाइए कि सवाल किस level के node से मिलेगा।
Node
Level
Cosine
Milestone वाला सवाल leaf syllabus से 0.99 पर मिलता है। सारी deadlines वाला सवाल सार A से 1.00 पर मिलता है, और A में चारों तारीखें हैं। पड़ाव 1 में सबसे अच्छा passage, project page, सिर्फ़ 0.66 पर था, और उसमें 1 तारीख थी। Overview वाला सवाल root R से मिलता है। A और R के vectors मैंने सवालों जैसे ही बनाए हैं, इसलिए cosine पूरा 1.00 है। असली embeddings में ये 1 से कम होता है।
Stanford की slide यही बात एक line में कहती है: detail question किसी leaf से मिलता है, और thematic question किसी ऊपर के node से। RAPTOR paper ने इसे Cinderella की कहानी के दो सवालों पर दिखाया: central theme of the story? और how did she find a happy ending?
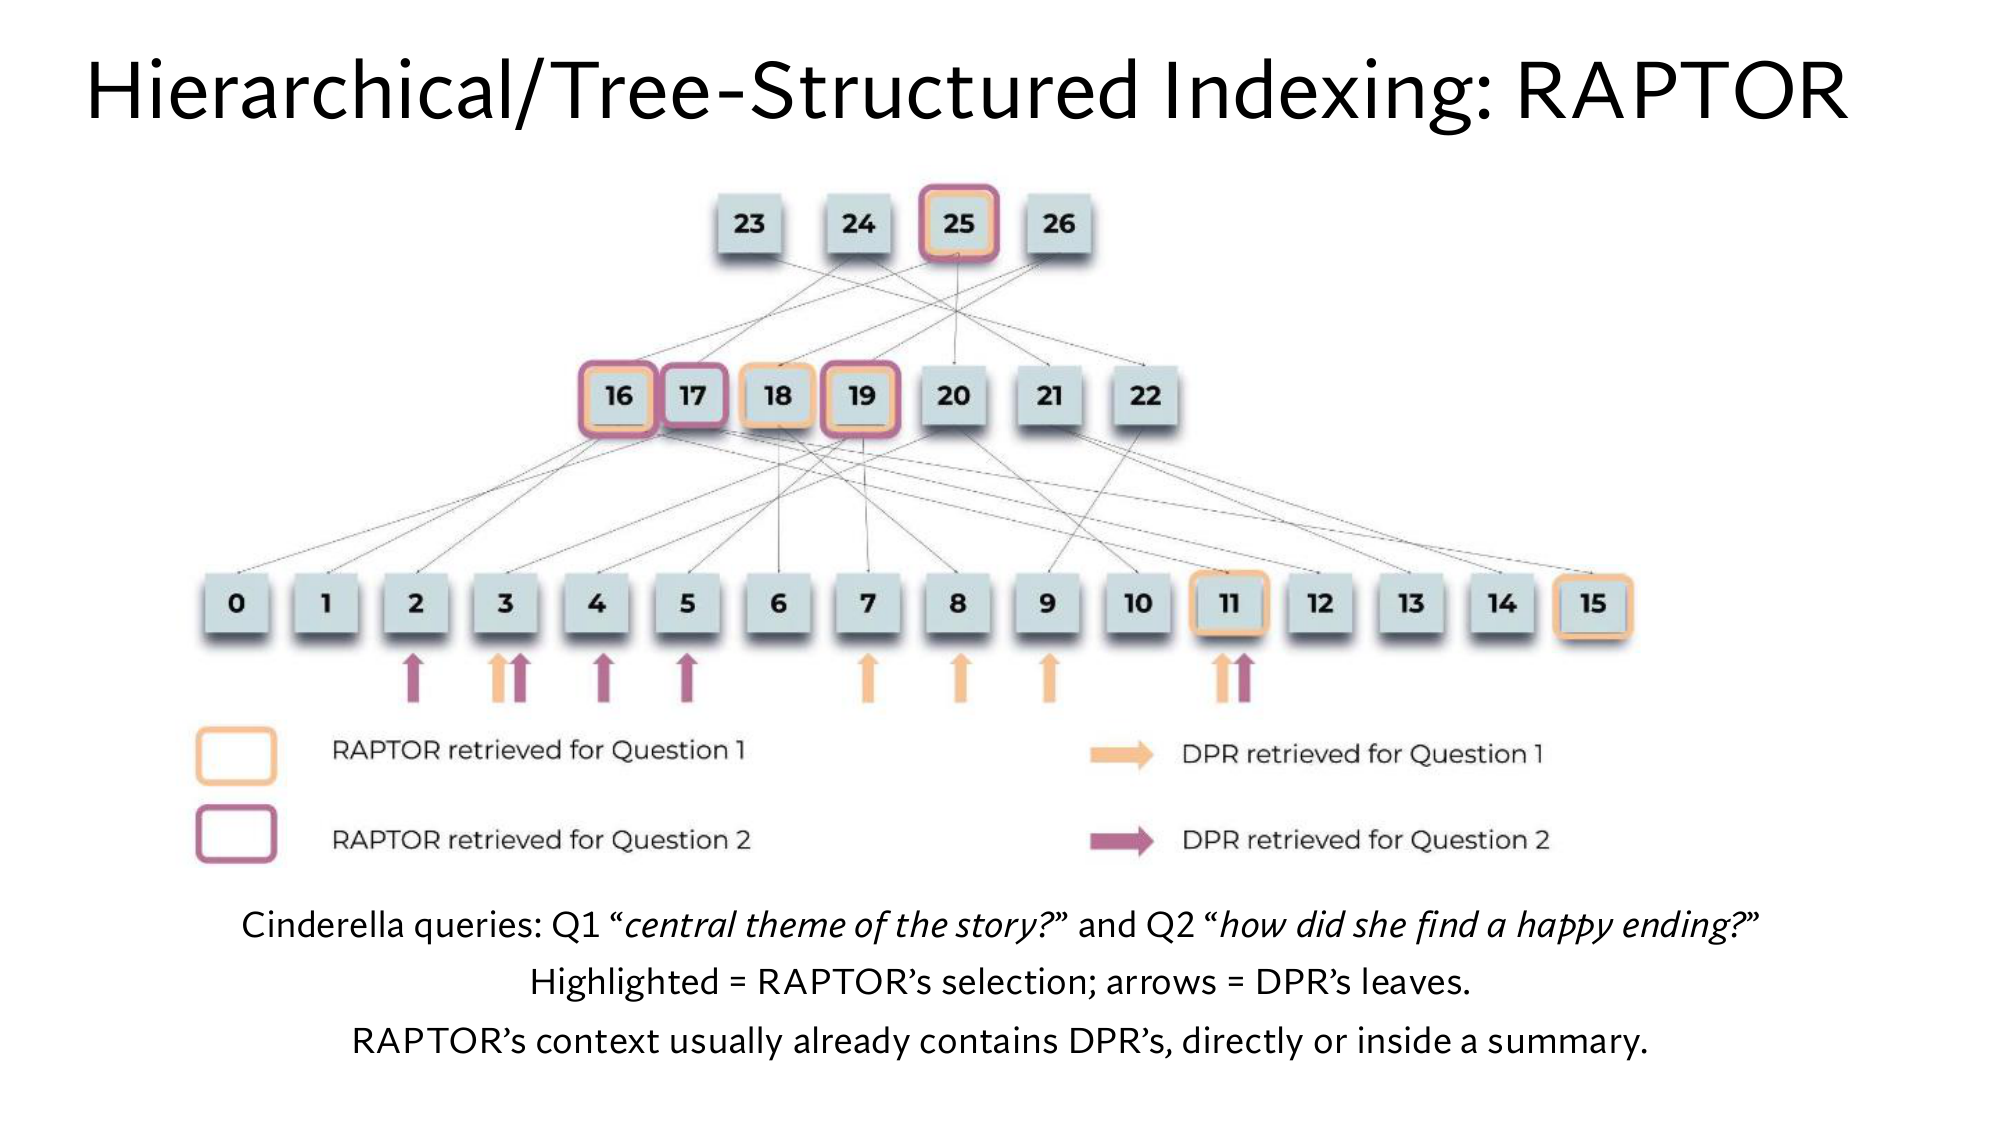
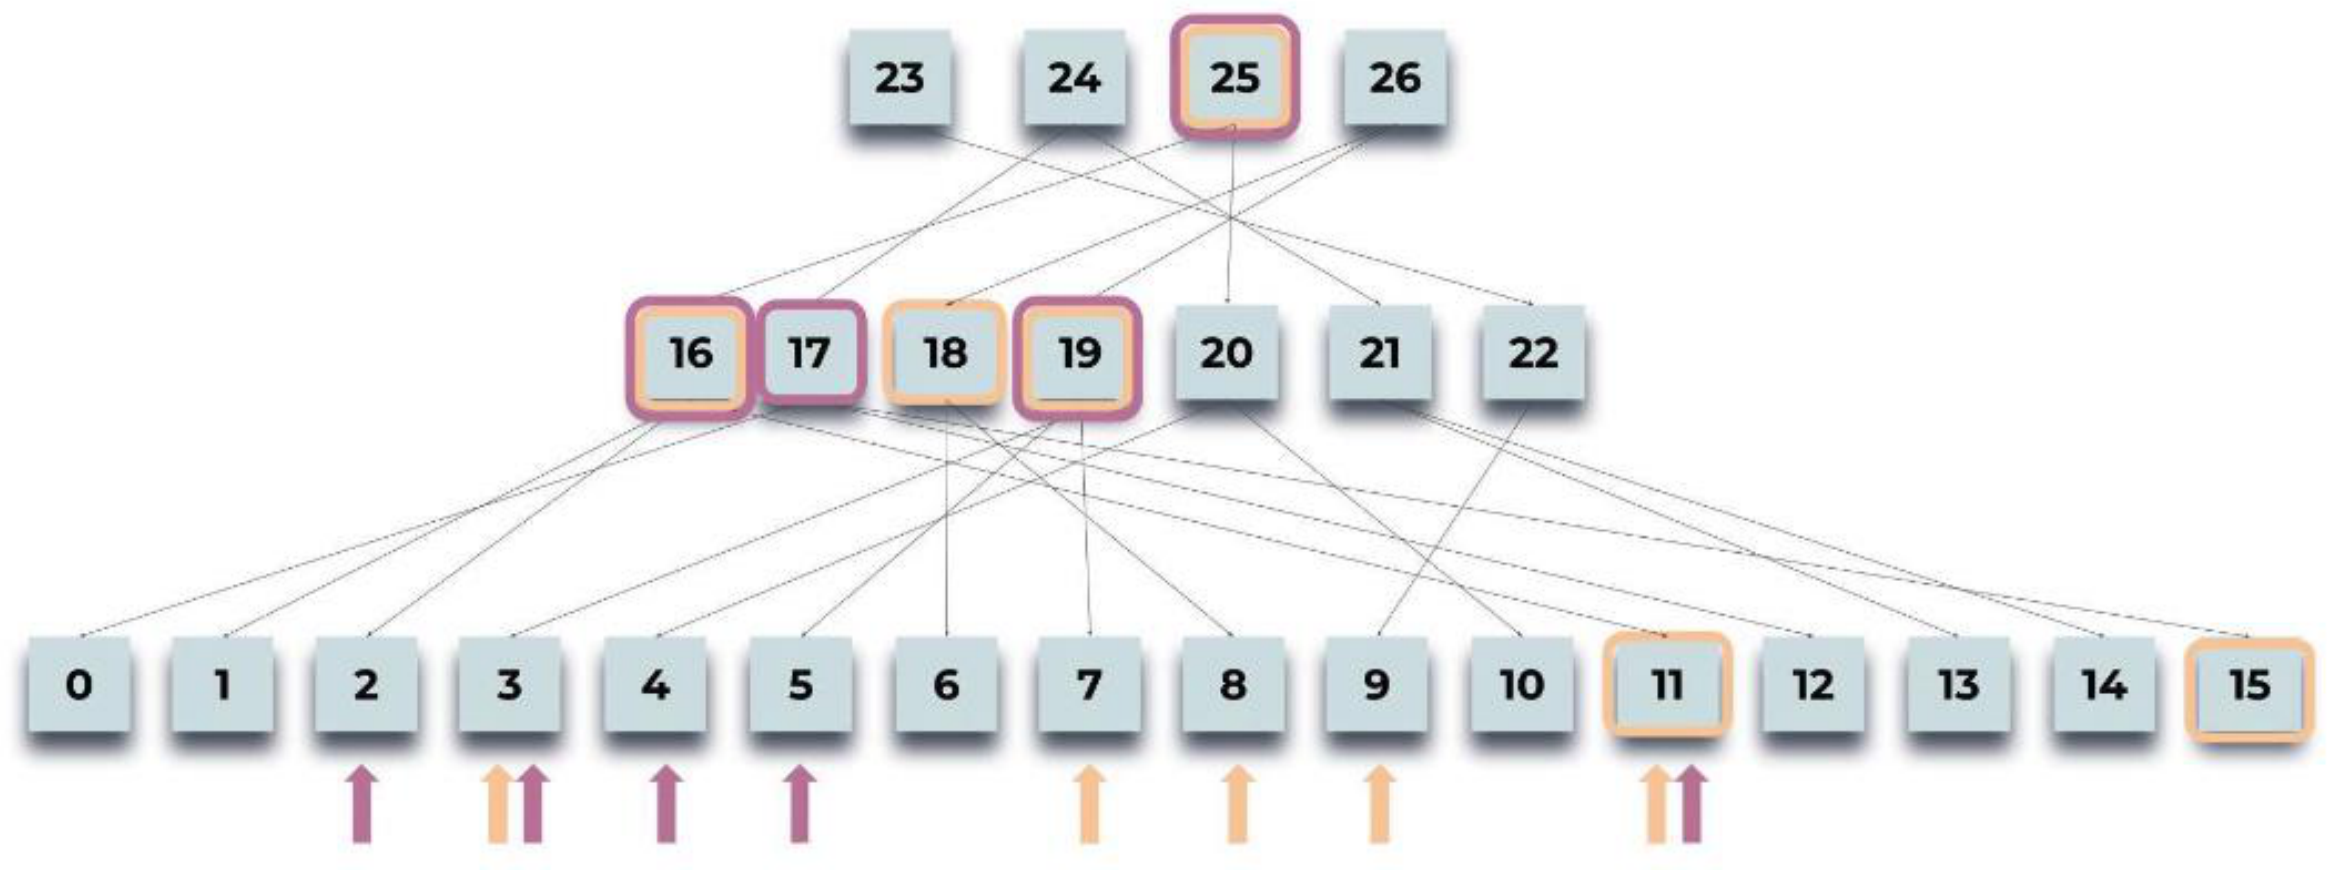
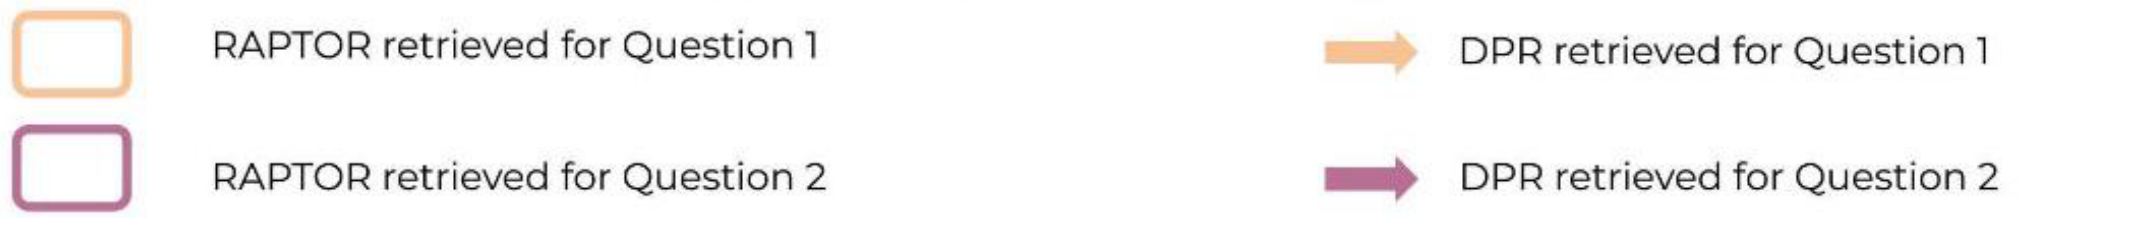
Stanford की Cinderella वाली slide। रंगीन घेरे वाले boxes RAPTOR के चुने nodes हैं, और सबसे नीचे के तीर DPR के चुने leaves। नारंगी रंग पहले सवाल का है, और बैंगनी दूसरे का।
, यानी lesson 5 के RAG का retriever, सिर्फ़ leaves में ढूँढता है। RAPTOR ने दोनों सवालों पर ऊपर के levels से भी nodes चुने। Slide के मुताबिक DPR के leaves की बात ज़्यादातर RAPTOR के context में पहले से होती है, सीधे या किसी सार के अंदर।
5GraphRAG: चीज़ों और रिश्तों का graph
RAPTOR के groups vectors की नज़दीकी से बनते हैं। लेकिन documents में चीज़ों के रिश्ते साफ़ लिखे होते हैं: milestone की deadline Week 6 है, और office hours TAs चलाते हैं। GraphRAG इन्हीं रिश्तों से groups बनाता है, और हर group के सार से पूरे corpus वाले सवालों का जवाब लिखता है।
नाम वाली हर चीज़ को entity कहते हैं: कोई व्यक्ति, जगह, course, document या तारीख। जैसे Project milestone, Week 6, TAs और Room 104। दो entities के रिश्ते को relation कहते हैं, और उसे तीन हिस्सों में लिखते हैं: (entity, रिश्ता, entity)। जैसे (Project milestone, due, Week 6)।
GraphRAG में एक LLM हर chunk पढ़कर ये relations निकालता है। Course corpus से ये 7 rows निकलती हैं: मेरा example
Entity
Relation
Entity
Project
has part
Proposal, Project milestone, Final report
Proposal
due
Oct 9
Project milestone
due
Week 6
Final report
due
Week 10
Homework 1
released
Oct 5
Office hours
run by
TAs
Office hours
held in
Room 104, Zoom
अब हर entity को एक node बनाइए, और हर relation को दो nodes के बीच की एक line। इन lines को edges कहते हैं, और nodes और edges के network को graph। Entities और relations वाले graph को knowledge graph कहते हैं। पहली row से Project तीन nodes से जुड़ता है, और हर part अपनी तारीख से।
Graph के कुछ हिस्सों के nodes आपस में बहुत जुड़े होते हैं, और बाकी graph से कम। ऐसे हिस्से को community कहते हैं। हमारे graph में तीन communities हैं, और वो आपस में किसी edge से नहीं जुड़ीं। पहली में Project, उसके तीन parts और उनकी तारीखें हैं। दूसरी में Office hours, TAs, Room 104 और Zoom हैं, और तीसरी में Homework 1 और Oct 5।
GraphRAG को 2024 में Microsoft Research के Edge और साथियों ने बनाया paper से। Indexing time पर इसके पाँच steps हैं, और query time पर दो:
Indexing time
Query time
1. Documents को chunks में तोड़िए। 2. LLM हर chunk से entities और relations निकालता है। 3. उनसे knowledge graph बनाइए। 4. Graph में communities ढूँढिए। 5. LLM हर community का सार लिखता है।
6. LLM हर community के सार से सवाल का एक हिस्सा-जवाब लिखता है। 7. LLM सारे हिस्सा-जवाबों को जोड़कर एक global answer लिखता है।
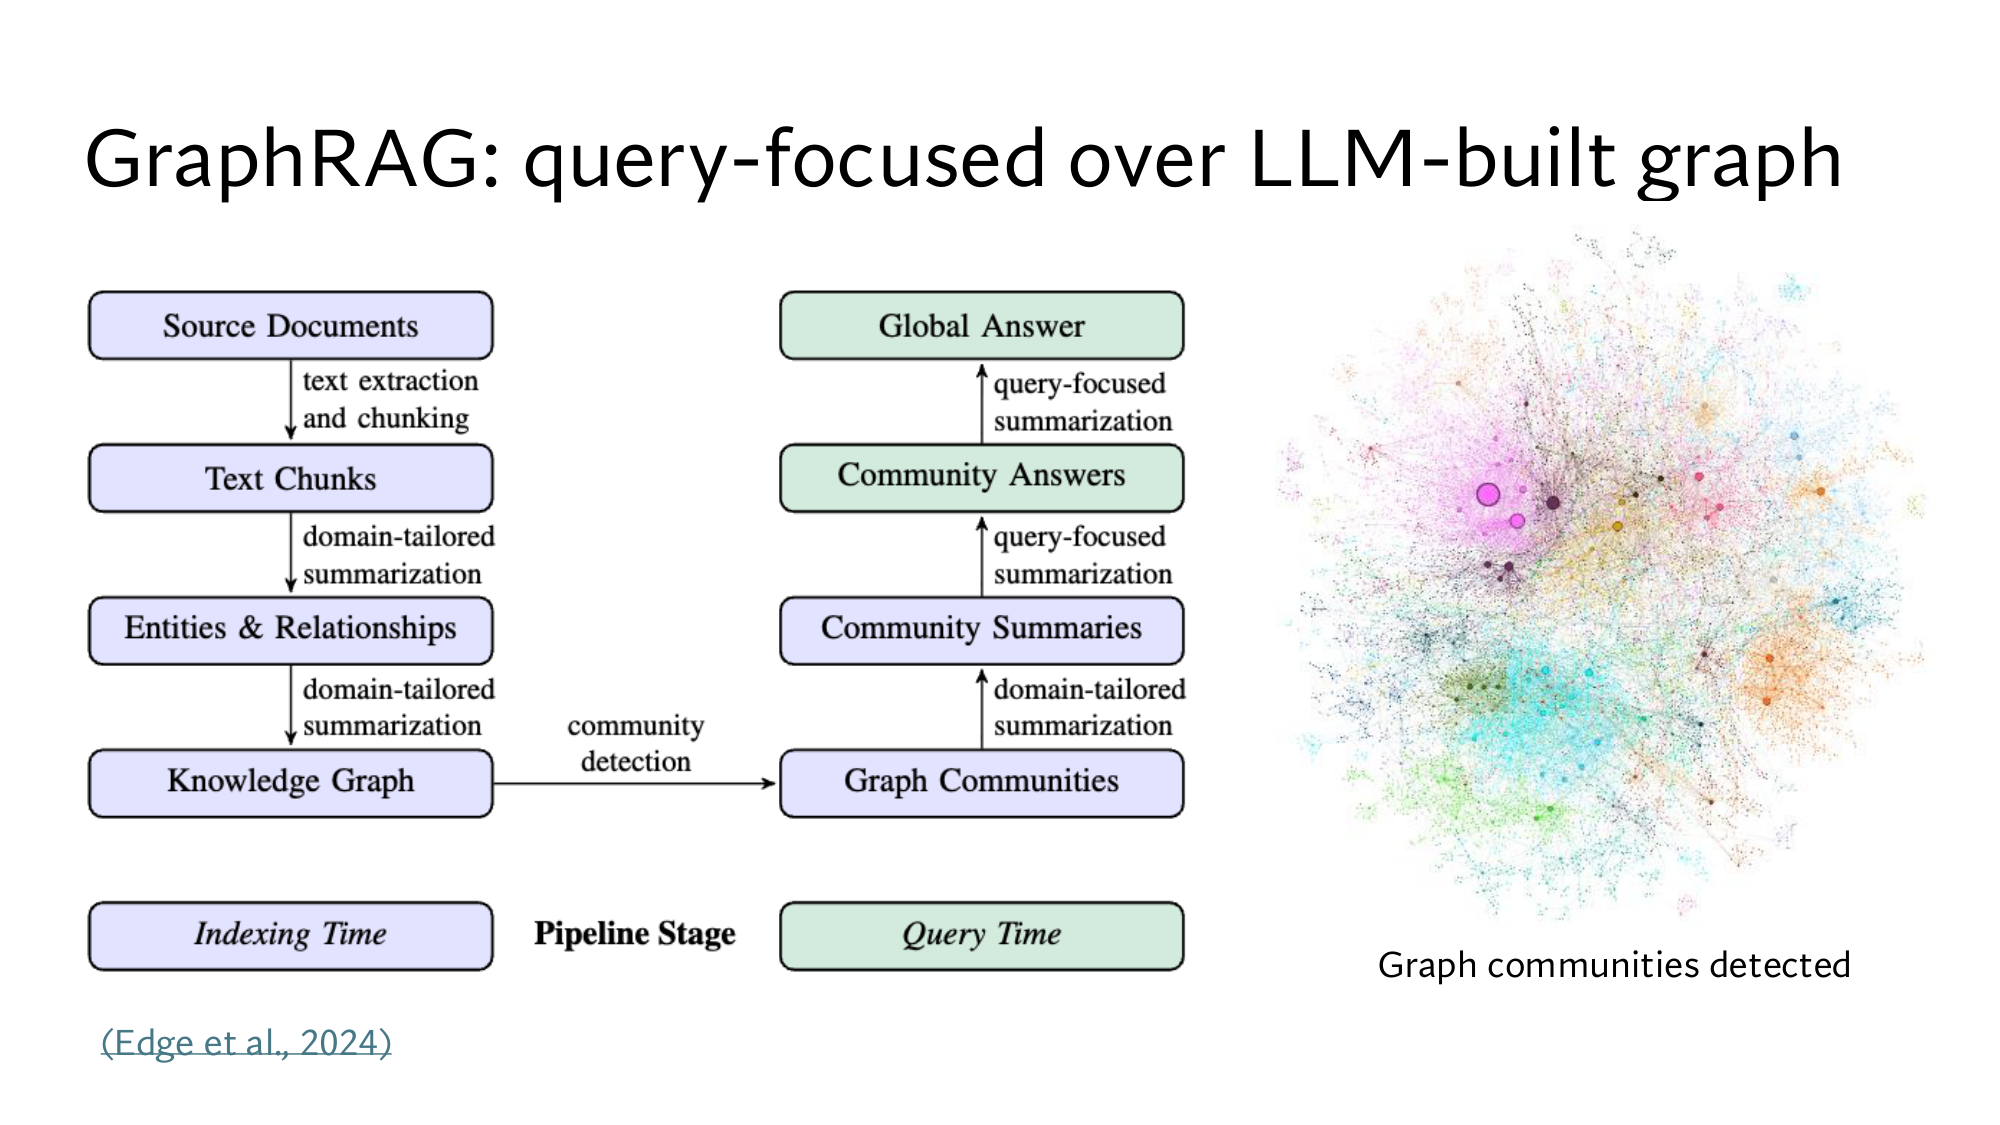
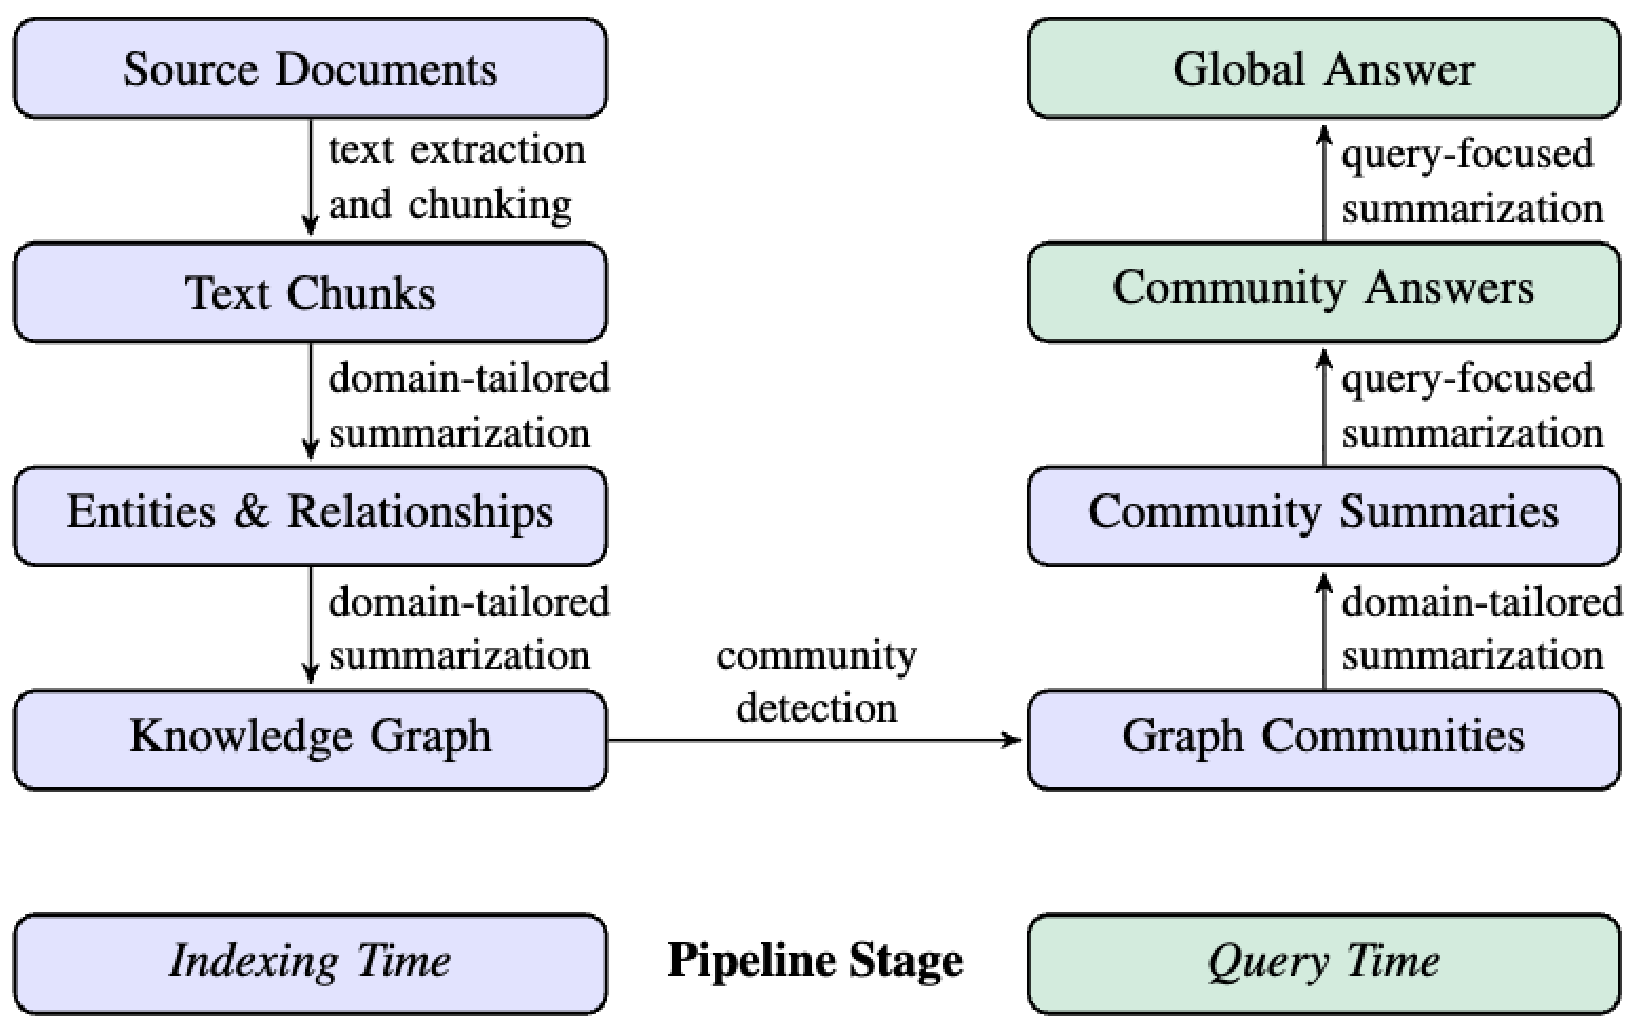
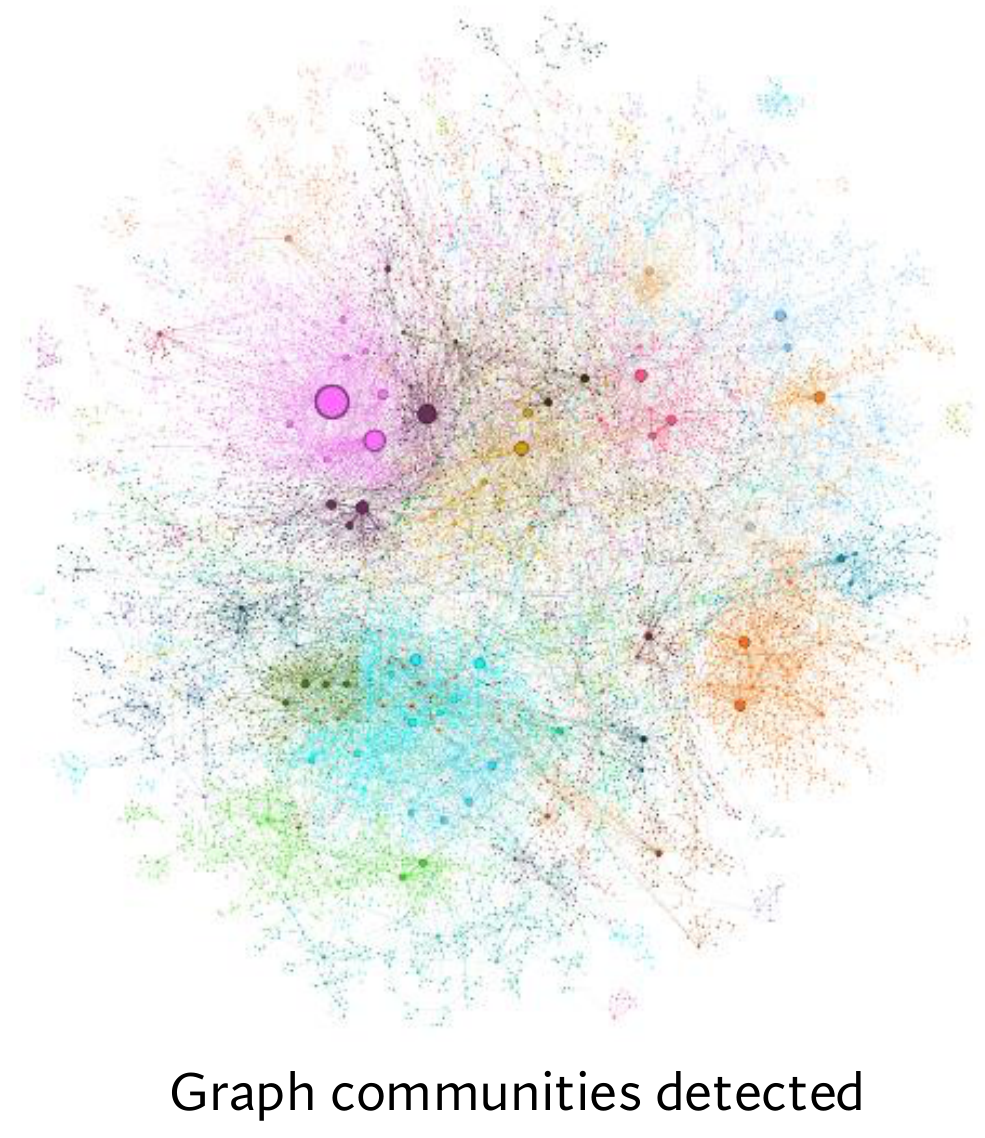
Stanford की GraphRAG slide। बाएँ नीचे की तरफ़ indexing time के steps हैं, और फिर दाएँ ऊपर की तरफ़ query time के। सबसे दाएँ एक असली graph है, जिसमें हर रंग एक community है।
हमारे सवाल पर step 6 हर community से एक हिस्सा-जवाब लिखता है। Project वाली community से तीन तारीखें आती हैं, Homework 1 वाली से एक, और office hours वाली से कोई नहीं। Step 7 इन्हें जोड़कर चारों तारीखों वाला जवाब लिखता है।
Steps 6 और 7 में LLM सार को सवाल के हिसाब से लिखता है, और इसे query-focused summarization कहते हैं। Slide के title में यही शब्द है। RAPTOR के सार सवाल आने से पहले बनते हैं, जबकि GraphRAG का आख़िरी सार सवाल आने पर बनता है।
GraphRAG का फ़ायदा पूरे corpus वाले global सवालों पर है, जहाँ top-K passages बिल्कुल नहीं चलते। कीमत ज़्यादा है: indexing पर हर chunk और हर community के लिए LLM calls, और query पर भी हर community के लिए एक call। LLM ने कोई गलत entity या relation निकाला, तो वो गलती graph में बैठकर उस community के सार तक पहुँचती है।
पहले सोचिए
आपकी company के पास 2,000 support tickets हैं। दो सवाल आते हैं: (a) Ticket #4471 किस product के बारे में है? (b) Customers सबसे ज़्यादा किस बात की शिकायत करते हैं? किस पर आम top-K काफ़ी है, और किस पर नहीं?
जवाब देखिए
(a) detail question है, क्योंकि उसका जवाब एक ticket में लिखा है, इसलिए top-K काफ़ी है। (b) thematic है, क्योंकि जवाब सैकड़ों tickets को मिलाकर बनता है, और कोई एक ticket ऊँचा score नहीं पाएगा। उसके लिए सार चाहिए, और सवाल पूरे corpus पर है, इसलिए GraphRAG ठीक बैठता है।
यहाँ से Stanford वाला level
ऊपर के 5 पड़ाव आसान version जैसे ही हैं। आगे के 5 पड़ाव आपको Stanford की slides के level तक ले जाते हैं। पहले RAPTOR की clustering का गणित है, फिर RAPTOR और GraphRAG के papers के तरीके और नतीजे। उसके बाद GraphRAG का पूरा परिवार है, और आख़िर में आप slides खुद पढ़ते हैं। हर गणित वहीं समझाया है, जहाँ वो पहली बार आता है।
6RAPTOR की clustering का गणित: Gaussian mixture और soft membership
पड़ाव 2 में clusters cosine देखकर हाथ से बने थे, और FAQ page दोनों clusters में गया। RAPTOR ये फ़ैसला एक probability model से करता है, जिसे Gaussian mixture model (GMM) कहते हैं paper से। ये model हर passage को हर cluster के लिए एक probability देता है, और soft clustering इसी probability से चलती है। इसे चार कदमों में बनाते हैं: दूरी, एक cluster का bell curve, कई curves का mixture, और membership।
दूरी: centroid से कितना दूर
GMM cosine की जगह देखता है। दूरी दो vectors के फ़र्क वाले vector की length है, यानी फ़र्क के हर number का square, उनका जोड़, और फिर square root। पुराना forum post [0.8, 0.15] है, और office hours वाला centroid [0.85, 0.15]। फ़र्क [−0.05, 0] है, इसलिए दूरी √(0.0025 + 0) = 0.05 है।
Deadlines वाले centroid [0.15, 0.85] से फ़र्क [0.65, −0.7] है, और दूरी √(0.4225 + 0.49) = √0.9125 = 0.955। तो forum post office hours के centroid के बहुत पास है, और deadlines वाले से करीब 19 गुना दूर।
एक cluster: bell curve
GMM हर cluster को एक bell curve की तरह देखता है, जो centroid पर सबसे ऊँचा है और दूर जाने पर तेज़ी से गिरता है। इस curve को Gaussian कहते हैं। उसकी ऊँचाई e−d²/(2σ²) के हिसाब से चलती है, जहाँ d centroid से दूरी है। σ (sigma) cluster का फैलाव है, यानी उसके points centroid से आम तौर पर कितनी दूर हैं, और इसे कहते हैं।
e की negative power 1 से छोटी होती है, क्योंकि e−a = 1 ÷ ea। जैसे lesson 4 में (−1) = 1 ÷ 2.718 = 0.368 था। इसलिए दूरी जितनी बढ़ती है, ऊँचाई उतनी तेज़ी से गिरती है:
Centroid से दूरी d
d²/(2σ²)
ऊँचाई e−d²/(2σ²)
0
0
1.000
σ
0.5
0.607
2σ
2
0.135
3σ
4.5
0.011
एक number वाले data पर Gaussian का पूरा formula ये है, जहाँ x point है और μ (mu) curve का बीच:
𝒩(x; μ, σ) = 1σ√(2π) e−(x − μ)²/(2σ²)
आगे का 1 ÷ (σ√(2π)) सिर्फ़ curve के नीचे का कुल area 1 करता है। μ = 0 और σ = 1 पर ऊँचाई x = 0 पर 0.399, x = 1 पर 0.242, और x = 2 पर 0.054 है। जाँच: 0.242 ÷ 0.399 = 0.607, जो table की दूसरी row है। ये ऊँचाई probability नहीं है, इसे density कहते हैं, और पतले curve में ये 1 से ऊपर भी होती है।
दो numbers वाले vector पर (x − μ)² की जगह centroid से दूरी का square d² आता है। आगे का number 1 ÷ (2πσ²) हो जाता है। यहाँ मैंने माना है कि फैलाव हर दिशा में एक जैसा है, और दोनों clusters का σ = 0.25 है σ मेरा चुना हुआ। तब 2σ² = 0.125 है, और आगे का number 1 ÷ (2π × 0.0625) = 2.546।
कई clusters: mixture
Gaussian mixture कई bell curves का weighted जोड़ है। हर cluster k का एक वज़न πk होता है, यानी कुल passages का कितना हिस्सा उस cluster में है। हमारे 6 passages में 3-3 हैं, इसलिए दोनों वज़न 0.5 हैं, और किसी point x पर mixture की ऊँचाई ये है:
Lesson 4 का यही था: हर case का वज़न गुणा उस case की probability, फिर सबका जोड़, जैसे 0.5 × 0.8 + 0.5 × 0.1 = 0.45। वहाँ cases दिन थे, और यहाँ cases clusters हैं। Paper यही बात K clusters के लिए लिखता है:
P(x) = ∑k=1K πk 𝒩(x; μk, Σk)
हमारे example में K = 2 है, πk दोनों 0.5 हैं, और μk दोनों centroids हैं: [0.85, 0.15] और [0.15, 0.85]। Σk यहाँ जोड़ का चिह्न नहीं, cluster k का फैलाव है, जो हर दिशा में अलग हो सकता है। हमारे simplification में ये हर दिशा में σ² = 0.0625 है।
Soft membership: हर cluster की probability
अब एक नया passage लीजिए, जिसमें दोनों विषय हैं: Milestone week में Thursday के office hours लंबे होंगे। इसका vector [0.6, 0.4] है मेरा passage। Membership वो probability है कि ये passage cluster k से आया। इसे निकालने के लिए cluster की ऊँचाई को उसके वज़न से गुणा कीजिए, और कुल ऊँचाई P(x) से भाग दीजिए। Lesson 4 में p(Tuesday | भरा) = 0.40 ÷ 0.45 = 0.89 ठीक ऐसे ही निकला था।
दूरी के squares: office hours centroid से (0.6 − 0.85)² + (0.4 − 0.15)² = 0.0625 + 0.0625 = 0.125, और deadlines वाले से (0.6 − 0.15)² + (0.4 − 0.85)² = 0.2025 + 0.2025 = 0.405।
ऊँचाइयाँ: e−0.125/0.125 = e−1 = 0.368, और e−0.405/0.125 = e−3.24 = 0.0392। इन्हें 2.546 से गुणा करने पर 𝒩office hours = 0.937 और 𝒩deadlines = 0.0997।
वज़न से गुणा: 0.5 × 0.937 = 0.468 और 0.5 × 0.0997 = 0.0499। जोड़ P(x) = 0.518 है।
Membership: office hours 0.468 ÷ 0.518 = 0.904, और deadlines 0.0499 ÷ 0.518 = 0.096। दोनों का जोड़ 1 है।
p(k | x) = πk 𝒩(x; μk, Σk)∑j πj 𝒩(x; μj, Σj)
ऊपर वाला हिस्सा step 3 का 0.468 है, और नीचे वाला जोड़ 0.518। 2.546 और 0.5 ऊपर और नीचे, दोनों में हैं, इसलिए भाग में कट जाते हैं। तब membership सिर्फ़ e−1 और e−3.24 का रह जाती है: 0.368 ÷ (0.368 + 0.0392) = 0.904।
RAPTOR के code में passage हर उस cluster में जाता है, जिसकी membership 0.1 से ऊपर हो RAPTOR के code से। हमारे passage की deadlines वाली membership 0.096 है, जो 0.1 से नीचे है। इसलिए ये सिर्फ़ office hours वाले cluster में जाता है।
पहले सोचिए
Lesson 7 का बड़ा chunk [0.5, 0.5] office hours और deadlines का बराबर औसत था। उसकी दोनों memberships क्या होंगी, और वो कितने clusters में जाएगा?
जवाब देखिए
दोनों centroids से दूरी का square (0.35)² + (0.35)² = 0.245 है, इसलिए दोनों ऊँचाइयाँ एक जैसी हैं: e−1.96 = 0.141। Memberships 0.5 और 0.5 हैं, और दोनों 0.1 से ऊपर हैं, इसलिए chunk दोनों clusters में जाता है। (पड़ाव 2 और 6)
σ = 0.25 मैंने चुना था, ताकि numbers पढ़ने लायक रहें। असली GMM μ, σ और π खुद data से निकालता है, और इसके लिए Expectation-Maximization (EM) नाम का तरीका चलाता है paper से। EM पहले हर passage की memberships निकालता है, फिर उन्हीं से centroids, फैलाव और वज़न दोबारा निकालता है। ये दोनों काम बारी-बारी तब तक चलते हैं, जब तक numbers टिक न जाएँ।
हमारे 6 points पर ऐसा fit करीब σ = 0.04 देता है, क्योंकि हर cluster के points बहुत पास-पास हैं हिसाब मेरा। इतने छोटे σ पर ज़्यादातर memberships लगभग पक्की 0 या 1 होती हैं, और सिर्फ़ बिल्कुल बीच वाले passages बँटते हैं।
कितने clusters बनें: BIC से चुनाव
GMM को पहले बताना पड़ता है कि clusters कितने हैं। RAPTOR ये गिनती BIC (Bayesian Information Criterion) से चुनता है: कई गिनतियाँ आज़माइए, और जिसका BIC सबसे छोटा हो, वो लीजिए paper से। Paper का formula ये है:
BIC = ln(N) · k − 2 ln(L̂)
N passages की गिनती है, यहाँ 6, और ln 6 = 1.792। L̂ सबसे अच्छे fit की है, यानी हर passage की P(x) का गुणा। Lesson 4 का नियम ln(a × b) = ln a + ln b इस गुणा को जोड़ बना देता है। k model के parameters की गिनती है, यानी वो numbers जो fit तय करता है।
हमारे simplified model में हर centroid के 2 numbers हैं, और सारे clusters का एक σ है। K clusters के K − 1 वज़न हैं, क्योंकि आख़िरी वज़न बाकी से तय हो जाता है। हिसाब मेरा
Clusters K
ln L̂
k, और ln(6) · k
BIC
1: सारे passages एक साथ
−4.51
3, 5.38
14.40
2: deadlines और office hours
17.20
6, 10.75
−23.64
3: office hours page अलग
18.12
9, 16.13
−20.11
K = 2 वाली row ऐसे निकली। हर passage की P(x) में दूसरे cluster का हिस्सा लगभग 0 है, इसलिए ln P(x) = ln 0.5 + ln 𝒩 है। Fit का σ² = 0.001667 है, और सारी दूरियों के squares का जोड़ 0.02।
वज़न: 6 × ln 0.5 = 6 × (−0.693) = −4.159।
आगे का number: 1 ÷ (2π × 0.001667) = 95.5, और 6 × ln 95.5 = 6 × 4.559 = 27.354।
ln L̂ यहाँ positive है, क्योंकि पतले curves की density 1 से ऊपर है। K = 3 पर ln L̂ सिर्फ़ 17.20 से 18.12 तक बढ़ता है, लेकिन parameters का penalty 10.75 से 16.13 हो जाता है। इसलिए BIC सबसे छोटा K = 2 पर है, और RAPTOR यही गिनती चुनता है।
UMAP: पहले vector छोटा करना
Paper एक और दिक्कत बताता है: बहुत ज़्यादा numbers वाले vectors में दूरी ठीक से फ़र्क नहीं दिखाती paper से। ये देखने के लिए मैंने 200 random points लिए, जिनका हर number 0 और 1 के बीच है। फिर एक random query से सबसे पास और सबसे दूर वाले point की दूरी नापी: मेरे बनाए random points
हर vector में numbers
सबसे पास, सबसे दूर
दूर ÷ पास
2
0.03, 0.80
25.94
10
0.58, 1.79
3.09
768
10.82, 12.07
1.11
768 numbers पर सबसे पास और सबसे दूर वाला point लगभग बराबर दूर है, इसलिए “पास” का मतलब धुंधला हो जाता है। इसलिए RAPTOR clustering से पहले UMAP चलाता है। UMAP हर vector को बहुत कम numbers में बदलता है। साथ में वो कोशिश करता है कि जो points पहले पास थे, वो नए vectors में भी पास रहें। RAPTOR के code में ये 10 numbers हैं। RAPTOR के code से
UMAP का n_neighbors बताता है कि हर point कितने पड़ोसियों को देखकर अपनी जगह तय करे। बड़ा n_neighbors पूरे data का मोटा ढाँचा रखता है, और छोटा पास-पास की बारीकी। RAPTOR पहले मोटे global clusters बनाता है, फिर हर global cluster के अंदर local clusters। किसी cluster का text summary model की token limit से बड़ा हो, तो RAPTOR उसके अंदर फिर cluster करता है। paper से
7RAPTOR का paper: tree में ढूँढने के दो तरीके, setup और नतीजे
Tree traversal और collapsed tree
Paper tree में ढूँढने के दो तरीके आज़माता है paper से। Tree traversal ऊपर से नीचे चलता है। सबसे ऊपर के level से सवाल के सबसे पास वाले k nodes चुनिए, फिर सिर्फ़ उनके children में से k, और ऐसे leaves तक। Collapsed tree पूरे tree को एक list बनाकर सारे nodes को cosine से sort करता है। फिर वो ऊपर से nodes तब तक जोड़ता है, जब तक tokens की limit न भरे।
हमारे tree पर k = 1 वाला traversal deadlines वाले सवाल के लिए ऐसे चलता है। Root R अकेला है, इसलिए traversal उसी से शुरू होता है। उसके children में A (1.00) B (0.62) से आगे है। A के children में project page (0.66) Homework (0.61) और syllabus (0.60) से आगे है। Context बनता है: R, A और project page।
Collapsed tree के लिए हर node के tokens चाहिए, और limit 100 tokens रखिए: token गिनती मेरी
Node, cosine के क्रम में
Cosine
Tokens, और अब तक का जोड़
A, deadlines का सार
1.00
30, 30
R, course का overview
0.89
25, 55
Project page
0.66
15, 70
B, office hours का सार
0.62
35, छोड़ा (105 बनता)
Homework 1 की announcement
0.61
10, 80
Syllabus
0.60
20, 100
फ़र्क detail question पर दिखता है। Milestone वाले सवाल पर traversal हर level से एक node लेता है: R (0.33), A (0.52), और फिर syllabus (0.99)। Collapsed tree syllabus को सबसे पहले रखता है। Traversal में हर level के nodes का अनुपात हर सवाल पर एक जैसा रहता है, जबकि collapsed tree level सवाल के हिसाब से चुनता है। Paper ने 20 QASPER stories पर दोनों आज़माए, और collapsed tree हर setting में बेहतर रहा।
Main experiments में RAPTOR collapsed tree को 2,000 tokens की limit के साथ चलाता है, जो करीब top-20 nodes के बराबर है। UnifiedQA reader एक बार में सिर्फ़ 512 tokens पढ़ता है, इसलिए उसे 400 tokens का context मिलता है। Baselines को भी उतने ही tokens मिलते हैं। paper से
Tree कैसे बना
Paper का setup ये है: paper से
Chunks 100 tokens के हैं। कोई sentence 100 की limit पार करे, तो पूरा sentence अगले chunk में जाता है, बीच से कटता नहीं।
Embeddings SBERT से बनते हैं, जो BERT पर बना encoder है (multi-qa-mpnet-base-cos-v1)।
सार gpt-3.5-turbo लिखता है, और prompt है: Write a summary of the following, including as many key details as possible।
हर parent के नीचे औसतन 6.7 nodes हैं, और सार अपने children के कुल text की करीब 0.28 गुना लंबाई का है, यानी 72% छोटा।
Authors ने 150 nodes हाथ से जाँचे, और 6 में, यानी 4% में, छोटा hallucination मिला। ये गलतियाँ ऊपर के सारों तक नहीं पहुँचीं, और जवाबों पर उनका असर नहीं दिखा।
Tree बनाने के tokens और समय, दोनों document की लंबाई के साथ सीधी line में बढ़ते हैं।
तीन datasets के नतीजे
Paper तीन datasets पर नापता है। NarrativeQA में किताबों और movie scripts पर सवाल हैं, कुल 1,572 documents। QASPER में 1,585 NLP papers पर 5,049 सवाल हैं, और QuALITY में करीब 5,000 tokens के passages पर multiple-choice सवाल। paper से
QASPER का नाप F1 है, जो reader के जवाब के शब्दों को सही जवाब के शब्दों से मिलाता है। मान लीजिए जवाब में 4 शब्द हैं, सही जवाब में 5, और 3 शब्द दोनों में हैं। मेरे numbers 3 ÷ 4 = 0.75 है, और 3 ÷ 5 = 0.6। F1 = 2 × 0.75 × 0.6 ÷ (0.75 + 0.6) = 0.9 ÷ 1.35 = 0.667, और इसे % में लिखते हैं।
Retriever
GPT-3
GPT-4
UnifiedQA
BM25
46.6
50.2
26.4
DPR
51.3
53.0
32.1
RAPTOR
53.1
55.7
36.6
QASPER पर F1 (%)। Columns में जवाब लिखने वाला reader है, और rows में retriever। paper से
तीनों readers के साथ RAPTOR आगे है: DPR से 1.8, 2.7 और 4.5 points, और BM25 से 6.5, 5.5 और 10.2 points। QuALITY पर GPT-3 के साथ accuracy BM25 की 57.3% है, DPR की 60.4% और RAPTOR की 62.4%। RAPTOR हर retriever की मदद करता है: UnifiedQA के साथ QuALITY पर BM25 49.9 से 52.1 होता है, और DPR 53.1 से 54.7। paper से
RAPTOR को GPT-4 के साथ जोड़ने पर QuALITY पर accuracy 82.6% है, जबकि पहले का सबसे अच्छा नतीजा 62.3% था, यानी 20.3 points ऊपर। सबसे मुश्किल सवालों वाले HARD हिस्से पर ये 76.2 बनाम 54.7 है, यानी 21.5 points। QASPER पर RAPTOR + GPT-4 का F1 55.7 है, जो पिछले सबसे अच्छे 53.9 से 1.8 ऊपर है। paper से
कौन से levels काम आए
QuALITY की एक story पर paper ने search को अलग-अलग levels तक सीमित किया। सिर्फ़ leaves में ढूँढने पर accuracy 57.9% थी, और तीनों levels में ढूँढने पर 73.68%। Collapsed tree के लौटाए nodes में से 18.5% से 57% तक leaves नहीं, ऊपर के सार थे, dataset और retriever के हिसाब से। paper से
Paper ने ये भी नापा कि clustering खुद कितना काम आता है। Clusters की जगह लगातार 7-7 chunks का सार लिखने पर QuALITY accuracy 55.8% रही। GMM clustering के साथ ये 56.6% थी, यानी फ़र्क 0.8 points का है। Cinderella पर GPT-4 को DPR का context मिला, तो उसने लिखा कि happy ending का पता नहीं चल सकता। RAPTOR के context से उसने सही जवाब लिखा। paper से
8GraphRAG का paper: graph बनाना, map-reduce जवाब और नतीजे
Chunks से graph तक
GraphRAG documents को 600 tokens के chunks में तोड़ता है, जिनमें 100 tokens का है paper से। यानी हर नया chunk 500 नए tokens लाता है। Chunk का size एक सौदा है: बड़े chunks पर LLM calls कम लगती हैं, लेकिन LLM उनमें entities छोड़ता है। HotPotQA के data पर GPT-4 ने 600 tokens वाले chunks से 2,400 tokens वाले chunks के मुकाबले करीब दोगुने entity references निकाले।
इसलिए GraphRAG एक दूसरा मौका देता है, जिसे gleaning कहते हैं। Entities निकलने के बाद GraphRAG LLM से हाँ या ना में पूछता है कि कोई entity छूटी या नहीं। हाँ हो, तो अगला prompt कहता है कि बहुत सी entities छूट गईं, और LLM और entities निकालता है। GraphRAG ये एक तय गिनती तक दोहराता है। paper से
LLM हर entity और relation के साथ एक छोटा description भी लिखता है। साथ में वो claims निकालता है, यानी तारीख या घटना जैसी तथ्य वाली बातें। एक ही entity कई chunks से निकलती है, तो सबका एक node बनता है, और LLM उसके descriptions का सार लिखता है। कोई relation जितनी बार निकले, उसके edge का weight उतना होता है। जैसे (Office hours, run by, TAs) दो passages से निकले, तो उस edge का weight 2 होगा।
Community के levels: Leiden
Communities ढूँढने के लिए GraphRAG Leiden algorithm चलाता है paper से। Leiden graph को ऐसे हिस्सों में बाँटता है, जिनके अंदर edges ज़्यादा हों और हिस्सों के बीच कम। GraphRAG इसे बार-बार चलाता है: पहले communities, फिर हर community के अंदर sub-communities, जब तक और बाँटना मुमकिन न रहे।
इससे community के levels बनते हैं: C0 सबसे ऊपर का level है, जिसमें सबसे कम communities हैं, और C3 सबसे नीचे का, जिसमें सबसे ज़्यादा। हर level पर हर node ठीक एक community में होता है। यहाँ GraphRAG, RAPTOR से अलग है, क्योंकि RAPTOR में एक passage दो clusters में भी हो सकता था। हमारे graph में level 0 पर तीन communities होंगी। नीचे के level पर Project वाली community proposal वाले और milestone वाले हिस्सों में बँट सकती है।
Community का सार लिखते वक्त LLM की token limit भर सकती है, इसलिए GraphRAG ज़रूरी बातें पहले डालता है। किसी node की degree उससे जुड़े edges की गिनती है, और हर edge की अहमियत उसके दोनों nodes की degree का जोड़ है। हमारे graph में Project की degree 3 है, और Proposal की 2। इसलिए (Project, has part, Proposal) की अहमियत 3 + 2 = 5 है, और (Proposal, due, Oct 9) की 2 + 1 = 3। सार में पहले 5 वाले edges आते हैं।
सवाल आने पर: map-reduce
Query time पर GraphRAG जवाब map-reduce से लिखता है। Map का मतलब है हर टुकड़े पर अलग से एक ही काम, और reduce का मतलब है उन सबके नतीजों को जोड़ना। Paper में ये तीन steps हैं: paper से
चुने गए level के community सारों को random क्रम में मिलाइए, और तय tokens के टुकड़ों में बाँटिए।
Map: हर टुकड़े से LLM एक हिस्सा-जवाब लिखता है। साथ में वो 0 से 100 के बीच score देता है कि जवाब कितना काम का है, और score 0 वाले हिस्से हटते हैं।
Reduce: बाकी हिस्से score के क्रम में तब तक जुड़ते हैं, जब तक context window न भरे, और LLM उनसे आख़िरी जवाब लिखता है।
हमारे सवाल पर Project वाला हिस्सा 95 पाता है, Homework 1 वाला 80, और office hours वाला 0 scores मेरे बनाए। Office hours वाला हिस्सा हटता है, और reduce पहले Project और फिर Homework 1 वाला हिस्सा पढ़कर चारों तारीखें लिखता है। Paper ने summaries, हिस्सा-जवाब और आख़िरी जवाब, तीनों के लिए 8k tokens की window रखी।
LLM judge वाले नतीजे
Global सवालों का कोई एक सही जवाब नहीं होता, इसलिए paper ने सवाल भी LLM से बनवाए। LLM ने हर dataset के लिए 5 तरह के users सोचे, और हर user के 5 काम। हर काम पर 5 सवाल बने, यानी 5 × 5 × 5 = 125 सवाल। जैसे एक tech journalist का सवाल: Which episodes deal primarily with tech policy and government regulation?paper से
Paper में दो datasets थे। Podcast transcripts में 600 tokens के 1,669 chunks थे (करीब 10 लाख tokens), और News articles में 3,197 chunks (करीब 17 लाख tokens)। Podcast से बने graph में 8,564 nodes और 20,691 edges थे, और उसकी indexing में gpt-4-turbo के साथ 281 minute लगे। paper से
फिर एक दूसरा LLM judge बना। उसे सवाल और दो systems के जवाब मिले, और उसने हर कसौटी पर बताया कि कौन बेहतर है, या दोनों बराबर हैं। कसौटियाँ चार थीं: comprehensiveness (कितनी बातें आईं), diversity (कितने अलग नज़रिए), empowerment (पढ़ने वाला कितना समझकर फ़ैसला ले सके), और directness (कितना सीधा जवाब)। Paper ने directness जानबूझकर रखी, ताकि बाकी नतीजों की जाँच हो सके। वो comprehensiveness की उल्टी है, इसलिए कोई तरीका चारों कसौटियों पर नहीं जीत सकता।
हर जोड़ी की तुलना हर सवाल पर 5 बार हुई, यानी 125 × 5 = 625 फ़ैसले। Win rate बताता है कि इनमें से कितने % में judge ने एक system को बेहतर चुना, और 50% का मतलब बराबरी है। जैसे 72% win rate का मतलब है 625 में से करीब 0.72 × 625 = 450 फ़ैसले। हिसाब मेरा
Paper ने छह तरीके मिलाए: चारों community levels C0 से C3, TS, और SS। TS उसी map-reduce को graph के बिना सीधे chunks पर चलाता है, और SS आम vector RAG है, जो सबसे पास वाले chunks लेता है। Comprehensiveness में graph वाले और TS जैसे global तरीकों का SS पर win rate 72% से 83% था (podcast) और 72% से 80% (news)। Diversity में ये 75% से 82% और 62% से 71% था। Directness में SS जीता, जैसा सोचा था। paper से
फ़र्क tokens में भी है। नीचे की table बताती है कि podcast पर हर सवाल के जवाब में कितना context पढ़ा गया: paper से
किससे जवाब
Units
Tokens per सवाल
C0, सबसे ऊपर की communities
34
26,657
C1
367
225,756
C2
969
565,720
C3, सबसे नीचे की communities
1,310
746,100
TS, सीधे chunks
1,669
1,014,611
C0 को TS के tokens का सिर्फ़ 26,657 ÷ 1,014,611 = 2.6% चाहिए, यानी करीब 38 गुना कम। News पर ये 39,770 ÷ 1,707,694 = 2.3% है, यानी करीब 43 गुना कम। इतने कम tokens पर भी C0 का SS पर comprehensiveness win rate 72% और diversity 62% रहा। paper से
RAPTOR
GraphRAG
Groups कैसे बनते हैं
Vectors की नज़दीकी से (GMM), एक passage कई clusters में
लिखे रिश्तों से (Leiden), हर node एक community में
सार कब बनता है
Indexing time पर
Indexing पर, और फिर सवाल आने पर
किस सवाल पर अच्छा
Detail और thematic, दोनों एक index से
पूरे corpus वाले global सवाल
9GraphRAG का पूरा परिवार: Han और साथियों का survey
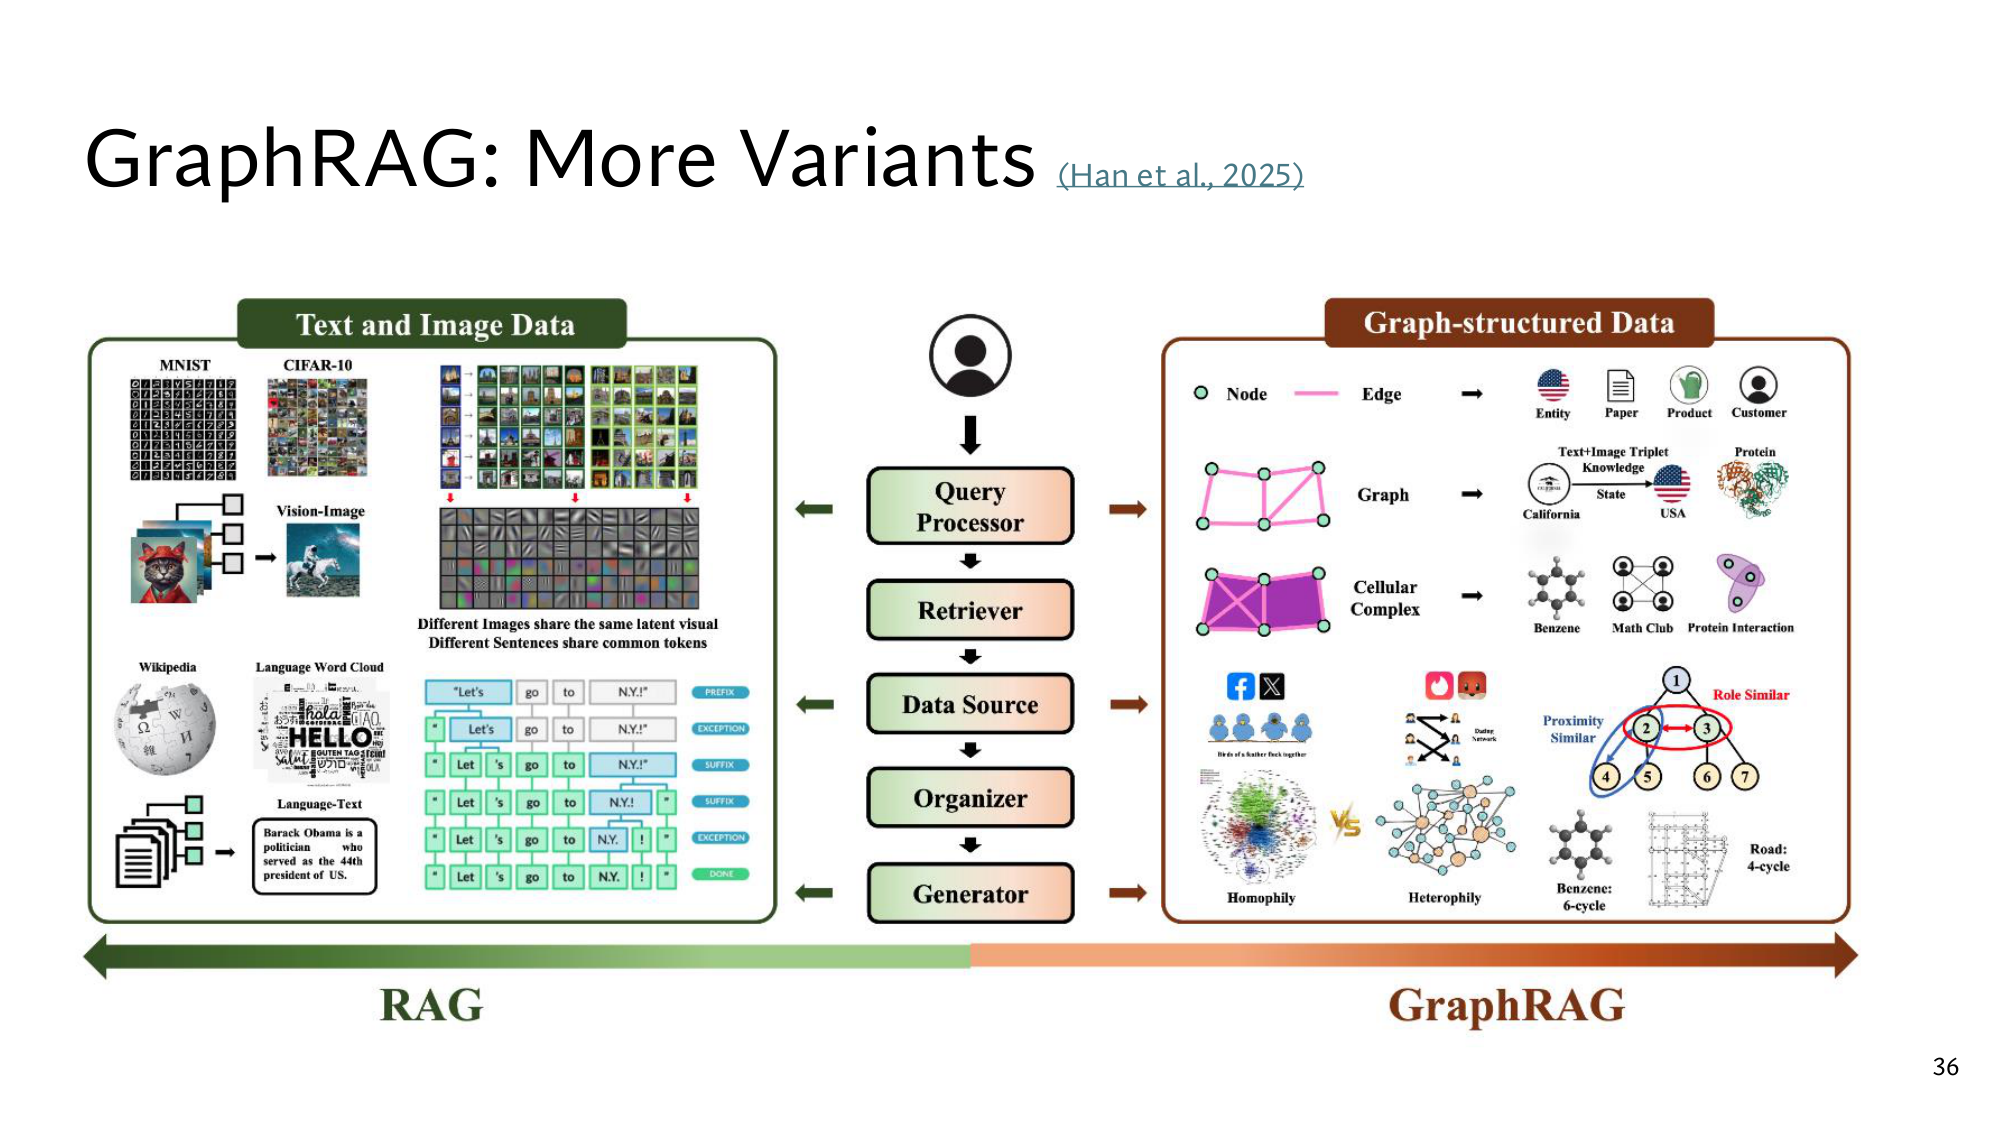
Edge का GraphRAG एक system है, लेकिन ये नाम अब पूरे परिवार के लिए भी चलता है। Han और साथियों का 2025 का survey हर उस RAG को GraphRAG कहता है, जिसका data source एक graph है paper से। Stanford की आख़िरी GraphRAG slide इसी survey की है, और पड़ाव 10 में आप उसे पढ़ेंगे।
Survey हर GraphRAG को पाँच हिस्सों में बाँटता है, और slide के बीच में यही पाँच boxes हैं। हमारे सारी deadlines वाले सवाल पर ये ऐसे दिखते हैं: course वाला example मेरा
हिस्सा
काम
हमारे course में
Query processor
सवाल को ढूँढने लायक बनाना
“deadlines” से entities निकालना: Proposal, Project milestone, Final report, Homework 1
Retriever
Graph से काम का हिस्सा लाना
इन nodes से due और released वाले edges पर चलकर तारीखें लाना
Data source
Graph खुद
पड़ाव 5 का knowledge graph
Organizer
लाए हिस्से को छाँटना और क्रम देना
चार relations को चार lines के text में लिखना
Generator
जवाब लिखना
LLM, जो चारों तारीखें लिखता है
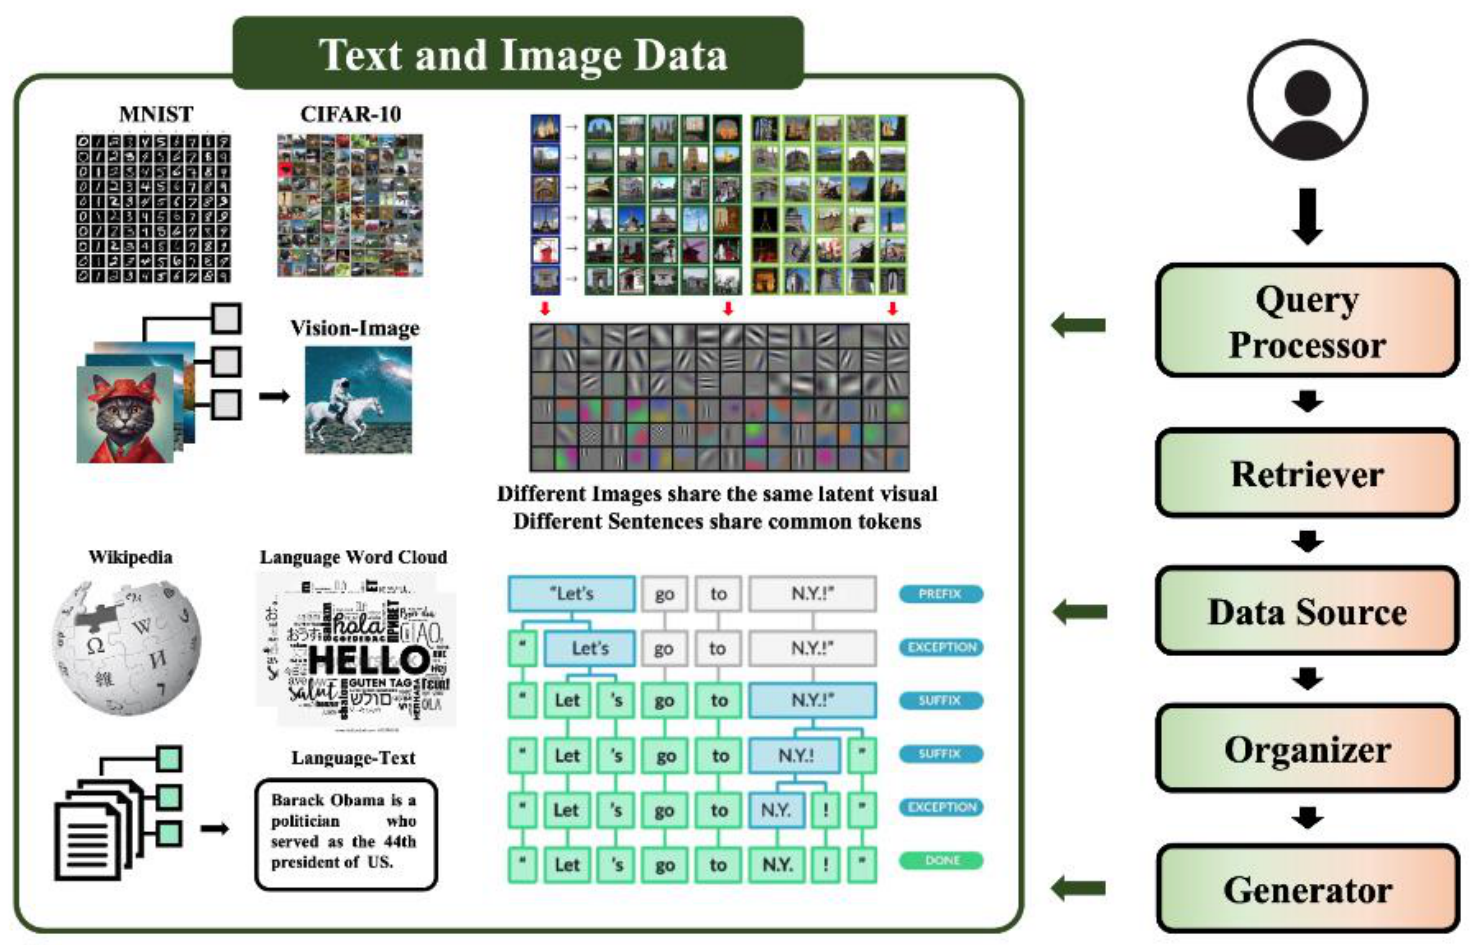
Slide के बाएँ हिस्से में आम RAG का data है: text और images। Survey के मुताबिक text tokens की एक line है, और image छोटे टुकड़ों (patches) की एक grid। अलग sentences एक जैसे tokens बाँटते हैं। Graph data में ऐसी कोई साझा unit नहीं है, और उसका ढाँचा हर domain में अलग है। इसलिए हर domain के लिए GraphRAG अलग बनता है। paper से
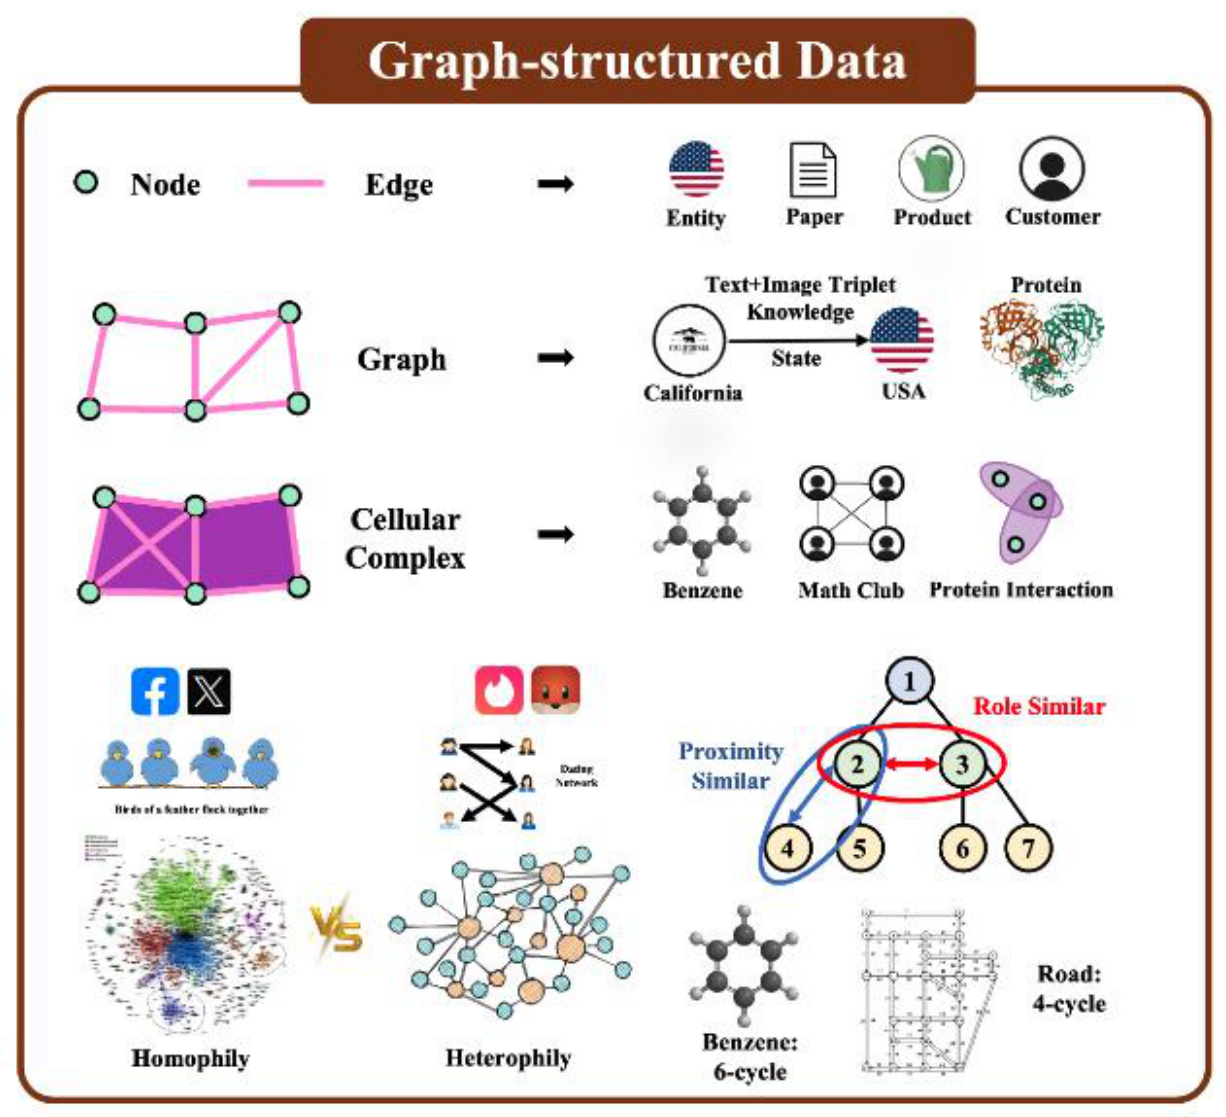
Slide के दाएँ हिस्से में graphs की किस्में हैं:
Nodes क्या हैं: entity, research paper, product या customer। जैसे papers के बीच citation वाले edges, या customers और products के बीच खरीद वाले edges।
Graph: knowledge graph की एक row, (California, State, USA), जो हमारे (Project milestone, due, Week 6) जैसी ही है। Protein का ढाँचा भी एक graph है।
Cellular complex: इसमें edges के साथ ऐसे हिस्से भी होते हैं, जो कई nodes को एक unit मानते हैं। जैसे benzene का पूरा ring, या एक club के चार सदस्य, जो सब आपस में जुड़े हैं।
Homophily और heterophily: homophily में जुड़े nodes एक जैसे होते हैं, जैसे social network के दोस्त। Heterophily में जुड़े nodes अलग किस्म के होते हैं, जैसे dating network।
Proximity similar और role similar: slide के tree में 2 और 4 जुड़े होने से मिलते-जुलते हैं। 2 और 3 जुड़े नहीं हैं, फिर भी एक जैसी जगह पर हैं: दोनों 1 के children हैं, और दोनों के दो-दो children। हमारे graph में Project milestone और Final report role similar हैं, क्योंकि दोनों Project के parts हैं और दोनों की एक due तारीख है।
6-cycle और 4-cycle: benzene में 6 nodes का घेरा है, और सड़कों के जाल में 4 nodes के घेरे। Drug design या शहर की planning में retriever को ऐसे आकार पहचानने पड़ते हैं।
Survey ऐसे 10 domains गिनता है: knowledge, document, scientific, social, planning और reasoning, tabular, infrastructure, biological, scene और random graphs। Edge का GraphRAG document graph वाले domain में आता है। paper से
10अब Stanford की slides खुद पढ़िए
नीचे इस lesson की चारों Stanford slides हैं, बिना किसी बदलाव के। हर slide के नीचे कुछ सवाल हैं। पहले खुद जवाब सोचिए, फिर खोलिए। कोई बात अटके, तो जवाब में लिखे पड़ाव पर लौट जाइए। Phone पर slide छोटी दिखे, तो image पर click कीजिए, वो पूरे size में खुलेगी।
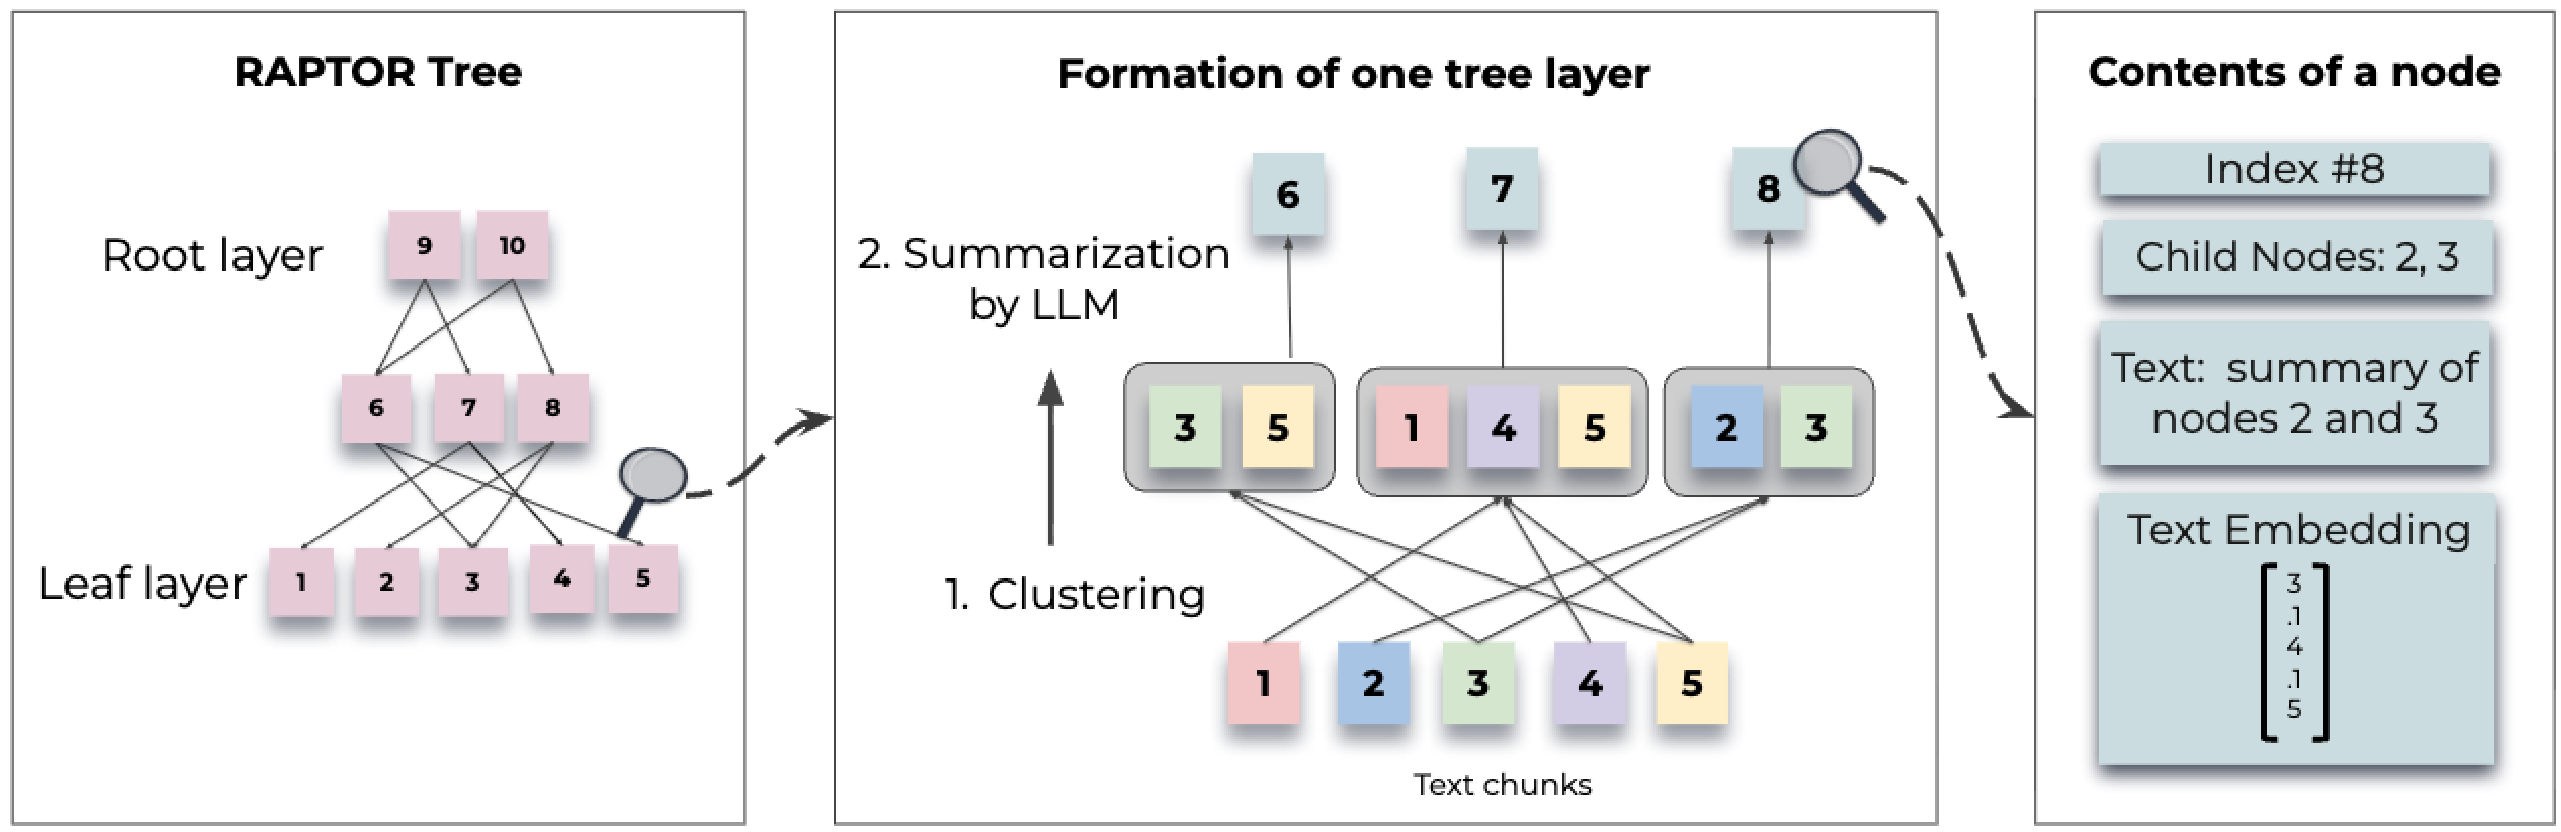
Stanford की RAPTOR slide, और नीचे उसके तीनों boxes, बड़े करके।
RAPTOR वाली slide पढ़िए
बीच वाले box में chunk 5 किन nodes के नीचे है, और ये किस तरीके की clustering है?
जवाब देखिए
Chunk 5 दो groups में है: {3, 5} और {1, 4, 5}, इसलिए वो node 6 और node 7, दोनों के नीचे है। ये soft clustering है। RAPTOR में ये फ़ैसला GMM की membership से होता है, और code में membership 0.1 से ऊपर हो, तो chunk उस cluster में जाता है। (पड़ाव 2 और 6)
दाएँ box में node 8 के अंदर चार चीज़ें हैं। “Text Embedding” वाला [3, .1, 4, .1, 5] किस काम आता है?
जवाब देखिए
ये node 8 के सार का embedding है, और retrieval में सवाल से cosine इसी vector का निकलता है। Slide पर 5 numbers सिर्फ़ दिखाने के लिए हैं। Index #8 node की पहचान है, और Child Nodes 2, 3 बताते हैं कि ये सार किन nodes का है। (पड़ाव 3 और 4)
आख़िरी line कहती है: a detail question matches a leaf, a thematic question matches a node। ये आपने कहाँ देखा, और paper इसे किस तरीके से करता है?
जवाब देखिए
पड़ाव 4 के widget में milestone वाला सवाल syllabus leaf से 0.99 पर मिला, और deadlines वाला सवाल सार A से 1.00 पर। Paper इसके लिए collapsed tree चलाता है, जो सारे levels के nodes एक list में sort करता है। (पड़ाव 4 और 7)
Stanford की Cinderella वाली slide, और नीचे उसका tree और रंगों का मतलब, बड़े करके। नारंगी पहले सवाल का रंग है, और बैंगनी दूसरे का।
Cinderella वाली slide पढ़िए
इस tree के हर level में कितने nodes हैं? और सबसे ऊपर 1 root की जगह 4 nodes क्यों हैं?
जवाब देखिए
Leaves 0 से 15 तक 16 हैं, बीच में 16 से 22 तक 7, और सबसे ऊपर 23 से 26 तक 4। कुल 27 nodes हैं। RAPTOR तब रुकता है, जब आगे clustering मुमकिन न रहे, इसलिए सबसे ऊपर कई nodes रह सकते हैं। पहली slide के tree में भी सबसे ऊपर दो nodes थे, 9 और 10। (पड़ाव 3)
पहले सवाल, central theme, पर RAPTOR ने किन levels से nodes चुने?
जवाब देखिए
तीनों levels से: सबसे ऊपर से 25, बीच से 16, 18 और 19, और leaves में से 11 और 15। Thematic सवाल पर ज़्यादातर nodes सार हैं, फिर भी दो leaves भी आईं, क्योंकि RAPTOR हर level के nodes को सवाल से मिलाता है। (पड़ाव 4 और 7)
दूसरे सवाल पर RAPTOR ने सिर्फ़ 25, 16, 17 और 19 चुने, कोई leaf नहीं। DPR ने leaves 2, 3, 4, 5 और 11 चुने। DPR की बात RAPTOR के context में कैसे पहुँचती है, और इससे जवाब में क्या फ़र्क पड़ा?
जवाब देखिए
16 से 26 तक के nodes नीचे वाले nodes के सार हैं, इसलिए leaves की बात उनके अंदर पहुँचती है। Slide की आख़िरी line यही कहती है। Paper में GPT-4 को सिर्फ़ DPR का context मिला, तो उसने लिखा कि happy ending का पता नहीं चल सकता। RAPTOR के context से उसने सही जवाब लिखा। (पड़ाव 4 और 7)
Stanford की GraphRAG slide, और नीचे उसके steps और communities वाला graph, बड़े करके।
GraphRAG वाली slide पढ़िए
बाएँ column के arrows पर दो बार “domain-tailored summarization” लिखा है। Entities निकालना summarization क्यों है, और “domain-tailored” का मतलब क्या है?
जवाब देखिए
Entities, relations और उनके descriptions text की छोटी, लिखी हुई शक्ल हैं, इसलिए paper इन्हें summarization का एक रूप कहता है। Domain-tailored का मतलब है कि prompt में उसी domain के examples होते हैं, जैसे science या law के। (पड़ाव 8)
दाएँ column में “query-focused summarization” दो बार क्यों है?
जवाब देखिए
पहली बार community summaries से community answers बनते हैं, यानी map step। दूसरी बार community answers से global answer बनता है, यानी reduce step। दोनों में LLM सवाल को ध्यान में रखकर लिखता है। (पड़ाव 5 और 8)
दाएँ की तस्वीर में रंग और circles के size क्या बताते हैं?
जवाब देखिए
ये paper की तस्वीर है, जिसमें News वाले dataset के graph पर Leiden की सबसे ऊपर वाली communities हैं। हर circle एक entity है, उसका size उसकी degree के हिसाब से है, और रंग उसकी community बताता है। बड़ा गुलाबी circle बहुत सारे edges वाली entity है paper से। (पड़ाव 8)
Stanford की GraphRAG variants वाली slide, और नीचे उसके दोनों हिस्से, बड़े करके।
GraphRAG variants वाली slide पढ़िए
बीच के पाँच boxes क्या हैं, और सारी deadlines वाले सवाल पर Retriever क्या करेगा?
जवाब देखिए
Query Processor, Retriever, Data Source, Organizer और Generator। Retriever Proposal, Project milestone, Final report और Homework 1 के nodes से due और released वाले edges पर चलकर चारों तारीखें लाएगा। (पड़ाव 9)
दाएँ नीचे वाले tree में node 2 किसके साथ proximity similar है, और किसके साथ role similar?
जवाब देखिए
Node 4 के साथ proximity similar, क्योंकि 2 और 4 एक edge से जुड़े हैं। Node 3 के साथ role similar, क्योंकि दोनों 1 के children हैं और दोनों के दो-दो children हैं, भले वो आपस में जुड़े नहीं। (पड़ाव 9)
बाएँ हिस्से में लिखा है कि अलग sentences एक जैसे tokens बाँटते हैं। Graphs वाले हिस्से के लिए ये बात क्यों नहीं लिखी?
जवाब देखिए
Graph data में tokens जैसी कोई साझा unit नहीं है। Knowledge graph rows में है, molecule rings में, और सड़कें घेरों में, इसलिए हर domain का GraphRAG अलग बनता है। (पड़ाव 9)
इस lesson की 3 बातें
Thematic question का जवाब किसी एक chunk में नहीं होता। हर chunk का cosine कम आता है, K बढ़ाना काफ़ी नहीं, और बड़ा chunk सारी बातें औसत में घोल देता है।
RAPTOR, GMM से हर chunk को हर cluster की membership देता है, और soft clustering से उसे एक से ज़्यादा clusters में रख सकता है। हर cluster का सार लिखवाकर वो tree बनाता है, और collapsed tree से हर level में ढूँढता है। GPT-4 के साथ QuALITY पर उसकी accuracy 82.6% है, पिछले best से 20.3 points ऊपर।
GraphRAG LLM से knowledge graph बनाता है, Leiden से communities के levels ढूँढता है, और map-reduce से global जवाब लिखता है। Comprehensiveness में vector RAG पर उसका win rate 72% से 83% है। सबसे ऊपर वाले level को सीधे chunks के मुकाबले सिर्फ़ 2.3% से 2.6% tokens चाहिए।
इस lesson के नए शब्द
Detail question और thematic question
जवाब एक जगह लिखा हो, या कई passages को मिलाकर बने। जैसे “milestone कब है?” और “सारी deadlines क्या हैं?”।
Clustering
Vectors को ऐसे groups में बाँटना कि एक group के vectors आपस में पास हों। जैसे syllabus [0.1, 0.9] और project page [0.2, 0.8] का cosine 0.99 है, तो दोनों एक group में।
Cluster और centroid
Cluster एक group है, और centroid उसके vectors का औसत। जैसे [0.1, 0.9], [0.2, 0.8] और [0.15, 0.85] का centroid [0.15, 0.85]।
Soft clustering
एक passage को एक से ज़्यादा clusters में रखना। जैसे FAQ page, जिसका cosine दोनों centroids से ऊँचा है (0.86 और 0.78)।
RAPTOR
Clusters के सारों से नीचे से ऊपर tree बनाना, और हर level पर ढूँढना। जैसे सारी deadlines वाला सवाल सार A से मिलता है।
Tree, node, leaf, root
Levels वाला ढाँचा: node एक box, leaf सबसे नीचे का node, और root सबसे ऊपर का। जैसे 6 chunks (leaves) के ऊपर 2 सार, और उनके ऊपर 1 root।
Entity
नाम वाली कोई चीज़: व्यक्ति, जगह, course, document या तारीख। जैसे Week 6, TAs, Room 104।
Relation
दो entities का रिश्ता। जैसे (Project milestone, due, Week 6)।
Knowledge graph और edge
Entities (nodes) और relations (edges) का network। जैसे milestone और Week 6 के बीच एक edge, जिस पर “due” लिखा है।
Community
Graph का आपस में बहुत जुड़ा हिस्सा। जैसे Office hours, TAs, Room 104 और Zoom।
GraphRAG
Knowledge graph, उसकी communities और उनके सारों से global सवालों का जवाब। जैसे सारी deadlines वाला जवाब, जो Project और Homework 1 वाली communities से बनता है।
Query-focused summarization
सवाल को ध्यान में रखकर सार लिखना। जैसे “सारी deadlines” पूछने पर Project community के सार से सिर्फ़ तारीखें आएँ।
Gaussian mixture model (GMM)
Bell curves का weighted जोड़: P(x) = ∑ πk 𝒩k(x)। ये हर passage को हर cluster की membership देता है। जैसे [0.6, 0.4] को office hours 0.904 और deadlines 0.096।
BIC
ln(N) · k − 2 ln(L̂): fit की likelihood और parameters की गिनती तौलकर clusters की गिनती चुनना, और सबसे छोटा BIC जीतता है। जैसे 6 passages पर K = 2 का BIC −23.64, और K = 3 का −20.11।
UMAP
Vectors को कम numbers में बदलना, ताकि पास वाले points पास रहें। जैसे RAPTOR के code में हर vector 10 numbers का बनता है।
Tree traversal और collapsed tree
ऊपर से नीचे हर level पर top-k चुनना, या सारे nodes एक list में sort करके token limit तक लेना। जैसे deadlines वाले सवाल पर collapsed tree 100 tokens में 5 nodes लेता है, और A सबसे पहले।
F1
Precision और recall को मिलाने वाला नाप, 2PR ÷ (P + R)। जैसे P = 0.75 और R = 0.6 पर F1 = 0.667।
Leiden और degree
Leiden graph को ऐसी communities में बाँटता है, जिनके अंदर edges ज़्यादा हों। Degree किसी node के edges की गिनती है। जैसे Project की degree 3 है।
Map-reduce
हर टुकड़े पर अलग से एक ही काम (map), फिर नतीजे जोड़ना (reduce)। जैसे हर community से हिस्सा-जवाब और score, फिर score के क्रम में आख़िरी जवाब।
Win rate
दो systems की तुलना में कितने % फ़ैसले एक के पक्ष में गए, और 50% का मतलब बराबरी। जैसे 625 में से करीब 450 फ़ैसले, यानी 72%।