RAPTOR और GraphRAG index में chunks के साथ उनके सार भी रखते हैं, ताकि पूरे document में बिखरे जवाब भी मिल सकें। RAPTOR सारों का एक tree बनाता है, और GraphRAG text की चीज़ों और उनके रिश्तों का graph।
इसकी ज़रूरत इस सवाल पर दिखती है: What are all the deadlines? जवाब में course की 4 तारीखें हैं, और वो lesson 2 के तीन passages में बिखरी हैं। Syllabus में milestone (Week 6) और final report (Week 10) हैं। Project page में proposal (Oct 9) है, और Homework 1 की announcement में उसके release की तारीख (Oct 5)। Retriever project page को सबसे ऊपर रखता है, इसलिए K = 1 पर reader को 4 में से 1 तारीख मिलती है। मेरे बनाए vectors से
इस lesson की सीढ़ी
सीढ़ी में 5 पड़ाव हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
पहले से क्या चाहिए: Lesson 3 (vector, cosine), Lesson 6 (indexing time, query time) और Lesson 7 (chunk, mean pooling)। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1Top-K सिर्फ़ टुकड़े लाता है
Detail question का जवाब किसी एक passage में लिखा होता है, और thematic question का जवाब कई passages को मिलाकर बनता है।When is the milestone due? detail question है, क्योंकि जवाब syllabus की एक line में है। What are all the deadlines? thematic है, क्योंकि उसकी 4 तारीखें तीन passages में हैं।
Retriever हर passage को अलग से score देता है, और ऊपर के K passages लौटाता है। Thematic question पर हर passage के पास जवाब का सिर्फ़ एक हिस्सा होता है। नीचे हर text का vector 4 numbers का है। पहला number बताता है कि text milestone के बारे में कितना है, दूसरा बाकी deadlines के बारे में, और तीसरा office hours के बारे में। चौथा number बताता है कि text कितनी बातें समेटता है, यानी वो कितना overview जैसा है। vectors मेरे बनाए हैं
Detail question पर syllabus को 0.99 मिला, यानी साफ़ जीत। Thematic question पर सबसे ऊँचा cosine project page का 0.66 है, और उसमें 4 में से 1 तारीख है। कोई भी passage “सारी deadlines” के बारे में नहीं है, इसलिए किसी का cosine ऊँचा नहीं आता। सवाल का चौथा number 0.8 है, क्योंकि वो overview माँगता है, जबकि हर passage का चौथा number सिर्फ़ 0.1 या 0.15 है।
पहले सोचिए
K = 3 पर reader को कितनी तारीखें मिलेंगी? और अगर 40 pages के syllabus में 10 deadlines 10 अलग chunks में हों, तो K = 3 पर कितनी?
जवाब देखिए
इन 6 passages में top-3 project page (0.66), Homework 1 की announcement (0.61) और syllabus (0.60) हैं, इसलिए चारों तारीखें मिल जाती हैं। लेकिन 10 chunks वाले syllabus में K = 3 पर कम से कम 7 deadlines छूटेंगी। K पहले से तय होता है, और retriever नहीं जानता कि सवाल को कितने टुकड़े चाहिए। मेरा example
पूरे syllabus का एक बड़ा chunk भी नहीं चलता। Lesson 7 में बड़े chunk का vector उसके विषयों का औसत था, यानी । वहाँ दो विषय मिलने पर ही cosine 1.00 से 0.71 पर गिरा था। इसलिए index में ऐसा text चाहिए, जो खुद सारी deadlines के बारे में हो, यानी कई passages का लिखा हुआ सार।
2मिलते-जुलते passages के groups: clustering
सारे 6 passages का एक ही सार बहुत मोटा होगा। Deadlines का एक सार और office hours का दूसरा सार ज़्यादा काम का है। इसलिए सार लिखने से पहले passages को विषय के हिसाब से groups में बाँटिए।
Clustering का मतलब है vectors को ऐसे groups में बाँटना, कि एक group के vectors आपस में पास हों और दूसरे groups से दूर। हर group को cluster कहते हैं। “पास” नापने के लिए यहाँ cosine काफ़ी है: cosine 1 के जितना पास, दोनों vectors की दिशा उतनी मिलती है।
हाथ का हिसाब छोटा रखने के लिए यहाँ lesson 3 वाले 2 numbers लीजिए। पहला number बताता है कि text office hours के बारे में कितना है, और दूसरा deadlines के बारे में। vectors मेरे बनाए हैं
जोड़ा
Cosine
नतीजा
Syllabus [0.1, 0.9] और project page [0.2, 0.8]
0.99
एक cluster
Office hours page [0.9, 0.1] और queue log [0.85, 0.2]
0.99
एक cluster
Syllabus [0.1, 0.9] और office hours page [0.9, 0.1]
0.22
अलग clusters
पहली row ऐसे निकली। Dot product 0.1 × 0.2 + 0.9 × 0.8 = 0.02 + 0.72 = 0.74 है। Lengths √(0.01 + 0.81) = 0.906 और √(0.04 + 0.64) = 0.825 हैं, इसलिए cosine 0.74 ÷ (0.906 × 0.825) = 0.74 ÷ 0.747 = 0.99 है।
ऐसे बाकी जोड़े मिलाइए, तो दो clusters बनते हैं। Deadlines वाले cluster में syllabus, project page और Homework 1 की announcement [0.15, 0.85] हैं। Office hours वाले cluster में office hours page, queue log और पुराना forum post [0.8, 0.15] हैं।
हर cluster का एक बीच वाला point भी होता है, जो पूरे cluster की जगह खड़ा हो सकता है। Centroid cluster के सारे vectors का औसत है, जिसमें हर जगह के number का औसत अलग से लेते हैं। Deadlines cluster में पहला number (0.1 + 0.2 + 0.15) ÷ 3 = 0.15 है, और दूसरा (0.9 + 0.8 + 0.85) ÷ 3 = 0.85। तो centroid [0.15, 0.85] है, और office hours वाले cluster का [0.85, 0.15]। Lesson 10 में centroid search को तेज़ करता है।
कुछ passages दो विषयों के बीच होते हैं। Lesson 3 के लंबे FAQ page [1.6, 1.4] का cosine office hours वाले centroid से 0.86 है, और deadlines वाले से 0.78। RAPTOR ऐसे passage को दोनों clusters में रख सकता है, ताकि उसकी बात दोनों सारों तक पहुँचे। इसे soft clustering कहते हैं।
3RAPTOR: सारों का tree, नीचे से ऊपर
RAPTOR हर cluster का सार एक LLM से लिखवाता है, और उस सार को भी एक chunk की तरह index में रखता है। सार नया text है, vectors का औसत नहीं। इसलिए उसका vector “सारी deadlines” की दिशा में होता है, जबकि lesson 7 के बड़े chunk का vector औसत में घुल गया था।
सारों के ऊपर भी सार बन सकता है: deadlines के सार और office hours के सार से पूरे course का एक सार। ऐसे levels वाले ढाँचे को tree कहते हैं। Tree का हर box एक node है। सबसे नीचे के nodes, यानी असली chunks, leaves कहलाते हैं, और सबसे ऊपर का node root।
RAPTOR का पूरा नाम Recursive Abstractive Processing for Tree-Organized Retrieval है, और इसे 2024 में Stanford के Sarthi और साथियों ने बनाया paper से। ये tree नीचे से ऊपर पाँच steps में बनता है:
हर chunk का embedding बनाइए।
Embeddings को cluster कीजिए।
हर cluster के chunks एक LLM को दीजिए, और उनका सार लिखवाइए। ये सार एक level ऊपर का नया node है।
सारों के embeddings बनाइए।
Steps 2 से 4 दोहराइए, जब तक सबसे ऊपर गिने-चुने nodes न बचें।
Course corpus पर tree ऐसा बनता है। 6 passages leaves हैं, उनके ऊपर 2 सार हैं, और सबसे ऊपर 1 root। मेरा example
Level
Node
Text
2, root
R, course का overview
CS 329Z logistics: deadlines from Oct 5 to Week 10, and office hours on Tuesday and Thursday.
1
A, deadlines का सार
Homework 1 releases Oct 5. Proposal due Oct 9. Milestone due Week 6, Thursday 11:59pm, no late days. Final report Week 10.
1
B, office hours का सार
Tuesday 4pm in Room 104 (busy, about 14 waiting) and Thursday 9am on Zoom (about 3). An old 2024 post says midweek afternoons are quiet.
0, leaves
6 passages
Lesson 2 के 6 passages
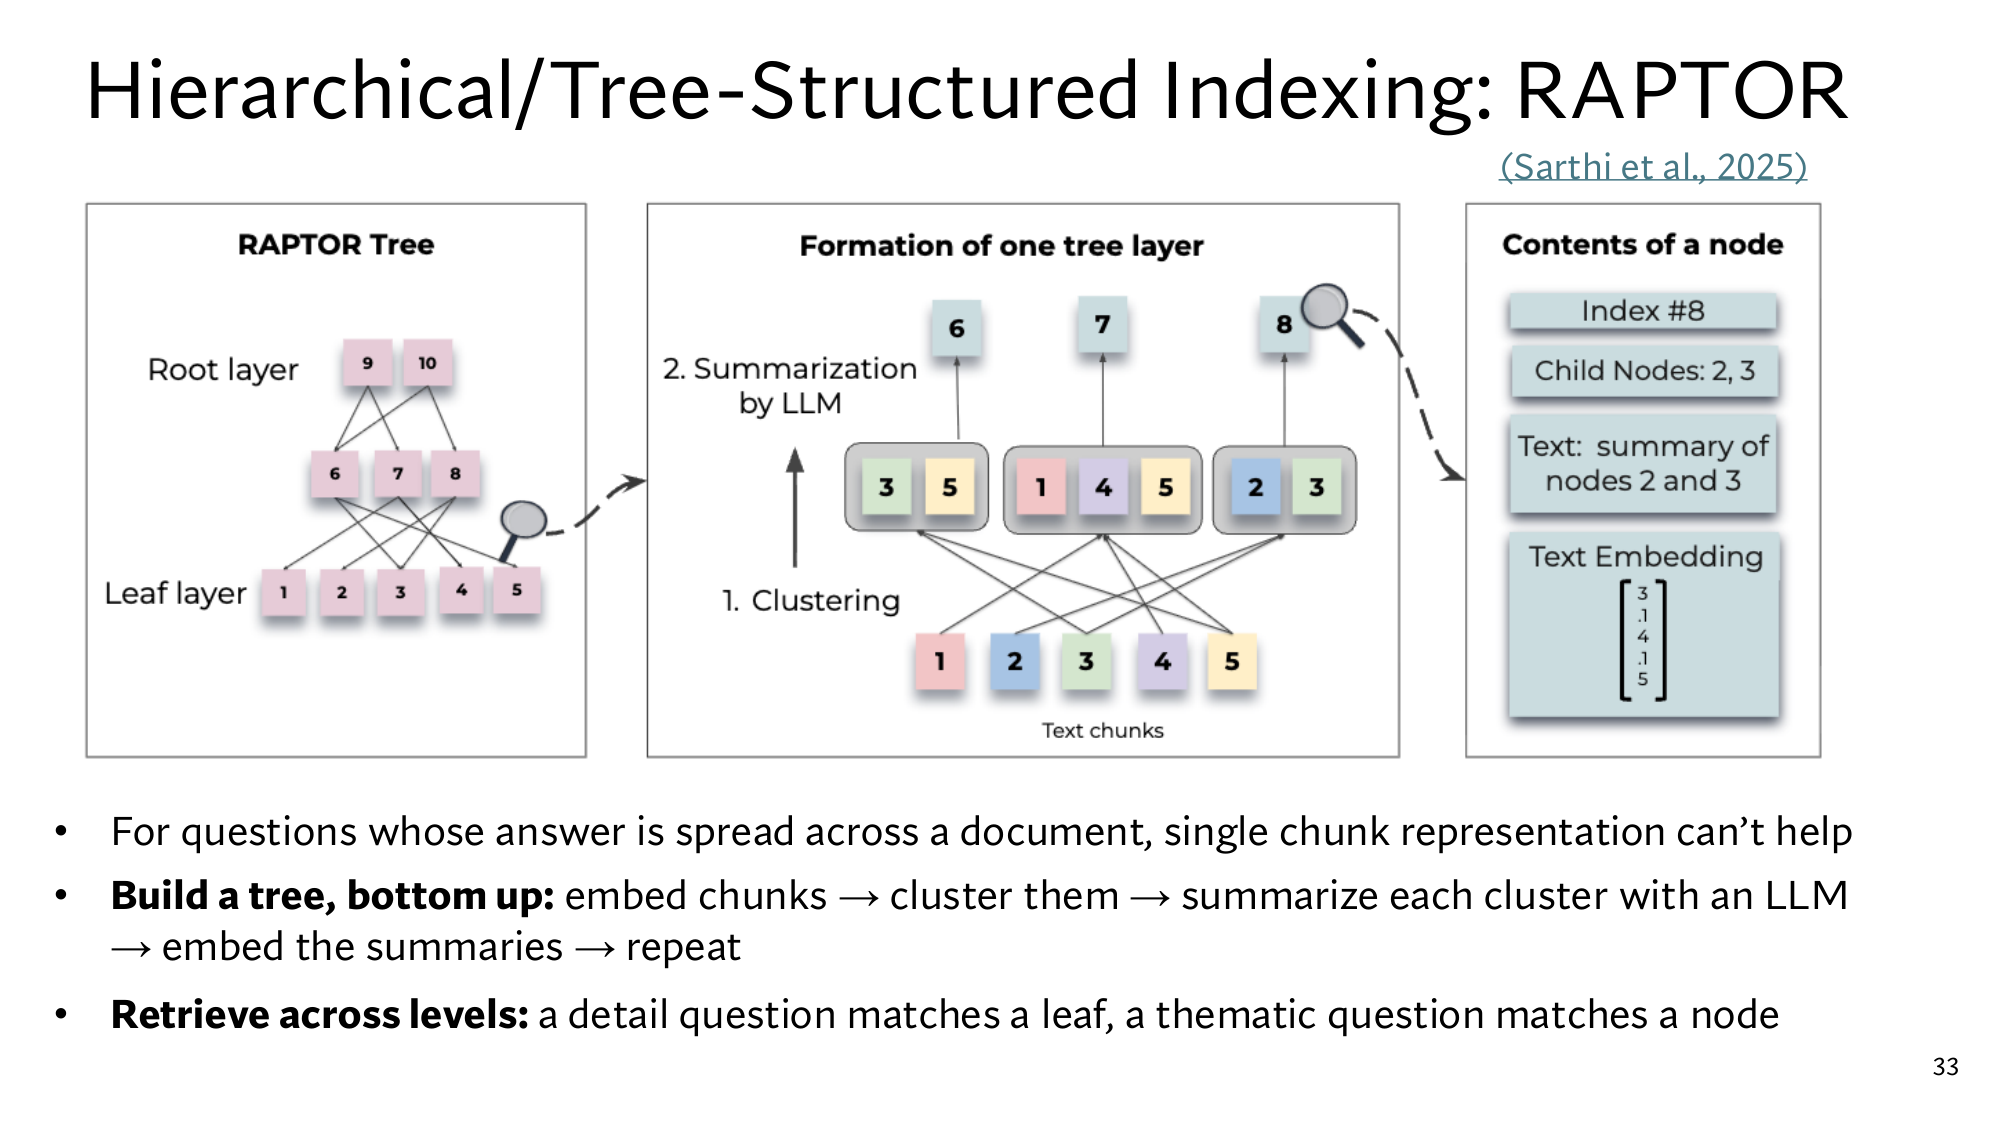
Stanford की RAPTOR slide: बाएँ पूरा tree, बीच में एक level बनने के दो steps, और दाएँ एक node के अंदर की चीज़ें। Image पर click करने से वो पूरे size में खुलती है।
Slide के बीच वाले box में 5 chunks से 3 groups बने: {3, 5}, {1, 4, 5} और {2, 3}। Chunk 3 और 5 दो-दो groups में हैं, यानी यहाँ soft clustering है। हर group का सार ऊपर का एक node बना: 6, 7 और 8। दाएँ box में node 8 के children (2 और 3), उनका सार, और उस सार का embedding है।
इसकी कीमत indexing time पर है, क्योंकि हर level पर हर cluster के लिए एक LLM call लगता है। सार LLM लिखता है, इसलिए वो बारीक बात छोड़ सकता है, या गलत लिख सकता है। Node B ने पुराने post की राय को queue log के data के बराबर रख दिया। यानी पुराने forum post की दिक्कत अब सार में बैठ गई।
पहले सोचिए
Corpus में 64 chunks हैं, और हर cluster में करीब 4 nodes आते हैं। Root तक कितने levels बनेंगे, और कुल कितने सार?
जवाब देखिए
Level 1 पर 64 ÷ 4 = 16 सार बनते हैं, level 2 पर 16 ÷ 4 = 4, और level 3 पर 4 ÷ 4 = 1 root। कुल 16 + 4 + 1 = 21 सार, यानी indexing पर 21 LLM calls। Leaves के ऊपर 3 levels बने।
4Tree के हर level में ढूँढना
RAPTOR सवाल को tree के हर level के nodes से मिलाता है, leaves से भी और सारों से भी। Leaves और सार एक ही index में हैं, इसलिए retriever हर node का cosine निकालता है, और ऊपर के nodes लौटाता है। Widget में हर node का 4 numbers वाला vector है, और सारों का चौथा number बड़ा है, क्योंकि वो कई बातें समेटते हैं। vectors मेरे बनाए हैं
सवाल tree के किस level से मिलता है?
एक सवाल चुनिए। Table हर node का cosine दिखाती है, सबसे ऊँचा पहले। चुनने से पहले अंदाज़ा लगाइए कि सवाल किस level के node से मिलेगा।
Node
Level
Cosine
Milestone वाला सवाल leaf syllabus से 0.99 पर मिलता है। सारी deadlines वाला सवाल सार A से 1.00 पर मिलता है, और A में चारों तारीखें हैं। पड़ाव 1 में सबसे अच्छा passage, project page, सिर्फ़ 0.66 पर था, और उसमें 1 तारीख थी। Overview वाला सवाल root R से मिलता है। A और R के vectors मैंने सवालों जैसे ही बनाए हैं, इसलिए cosine पूरा 1.00 है। असली embeddings में ये 1 से कम होता है।
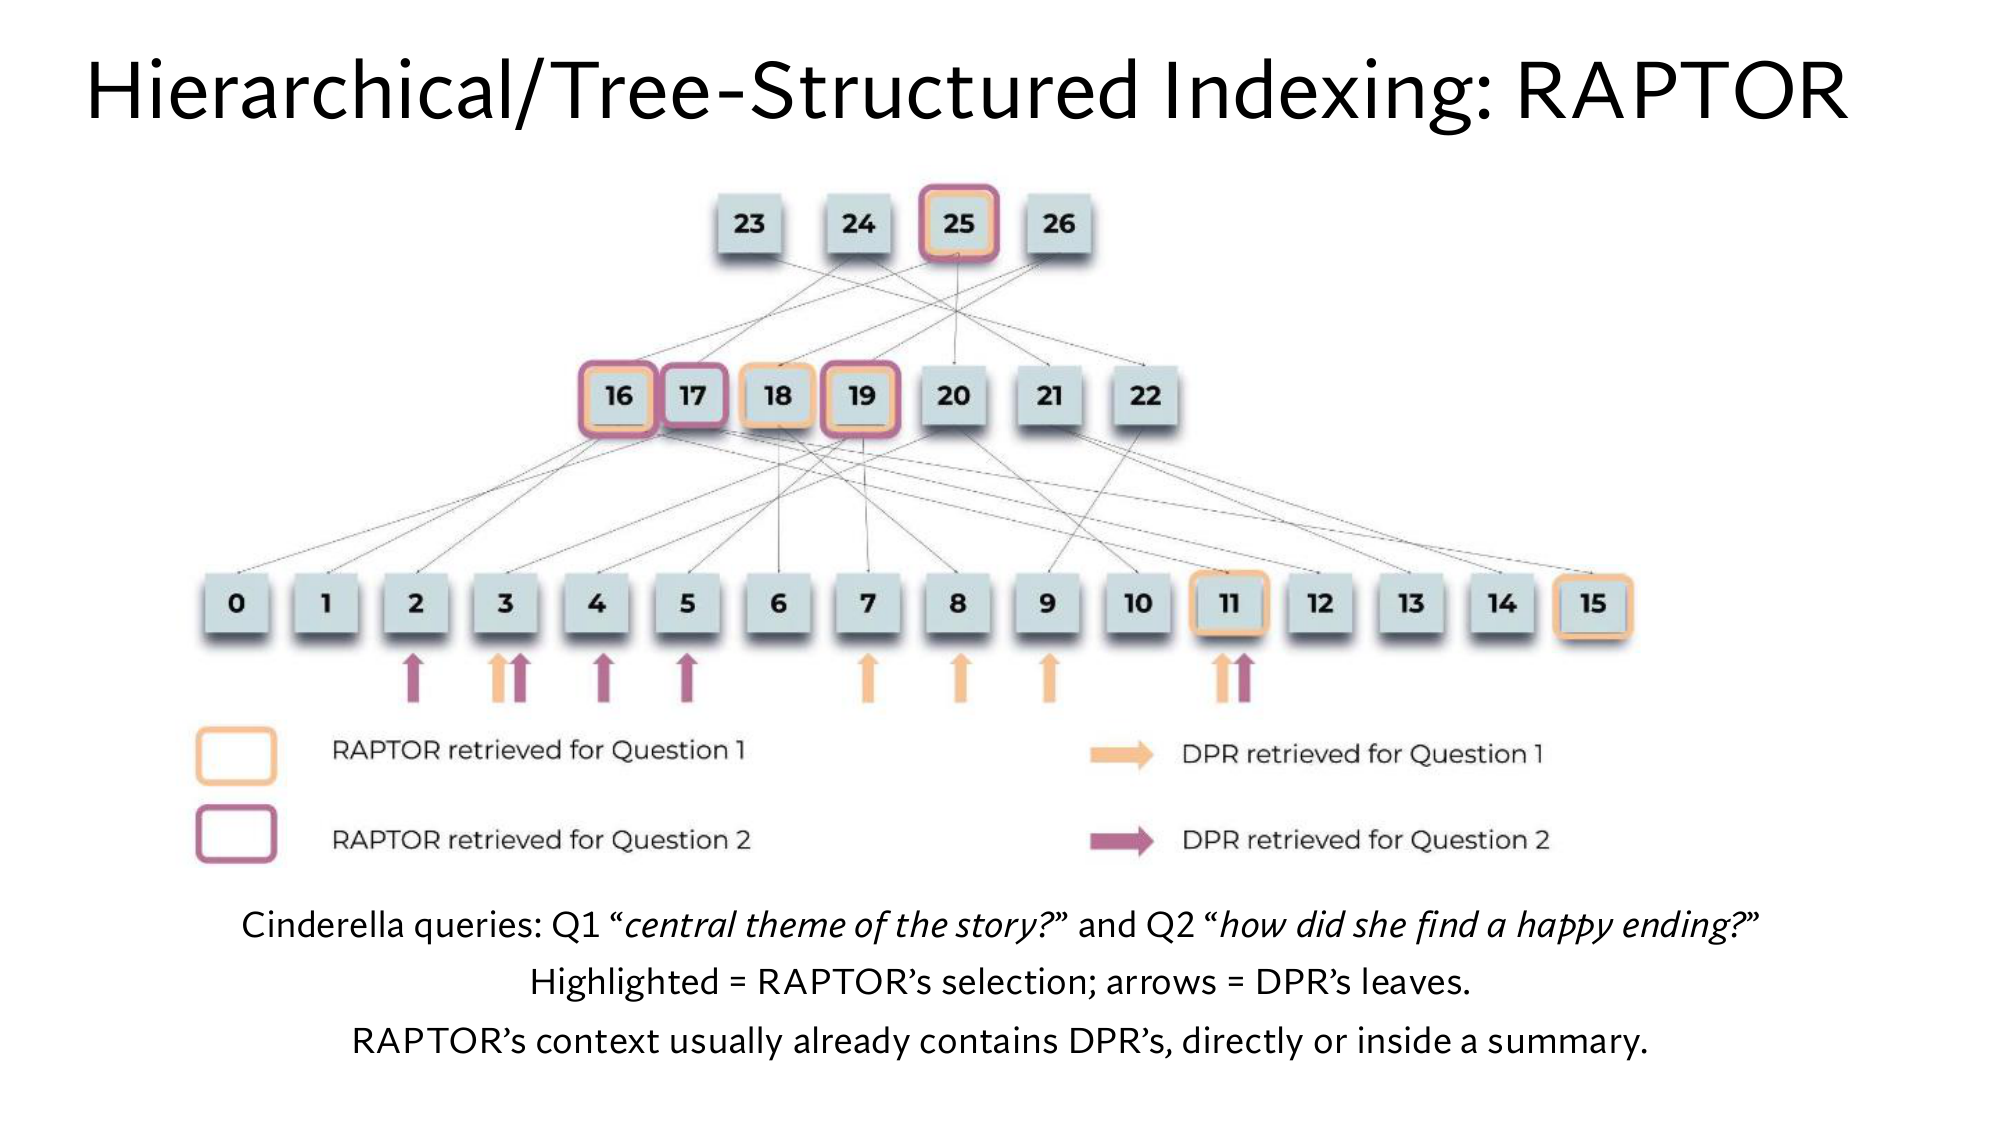
Stanford की slide यही बात एक line में कहती है: detail question किसी leaf से मिलता है, और thematic question किसी ऊपर के node से। RAPTOR paper ने इसे Cinderella की कहानी के दो सवालों पर दिखाया: central theme of the story? और how did she find a happy ending?
Stanford की Cinderella वाली slide। रंगीन घेरे वाले boxes RAPTOR के चुने nodes हैं, और सबसे नीचे के तीर DPR के चुने leaves। नारंगी रंग पहले सवाल का है, और बैंगनी दूसरे का।
, यानी lesson 5 के RAG का retriever, सिर्फ़ leaves में ढूँढता है। RAPTOR ने दोनों सवालों पर ऊपर के levels से भी nodes चुने। Slide के मुताबिक DPR के leaves की बात ज़्यादातर RAPTOR के context में पहले से होती है, सीधे या किसी सार के अंदर।
5GraphRAG: चीज़ों और रिश्तों का graph
RAPTOR के groups vectors की नज़दीकी से बनते हैं। लेकिन documents में चीज़ों के रिश्ते साफ़ लिखे होते हैं: milestone की deadline Week 6 है, और office hours TAs चलाते हैं। GraphRAG इन्हीं रिश्तों से groups बनाता है, और हर group के सार से पूरे corpus वाले सवालों का जवाब लिखता है।
नाम वाली हर चीज़ को entity कहते हैं: कोई व्यक्ति, जगह, course, document या तारीख। जैसे Project milestone, Week 6, TAs और Room 104। दो entities के रिश्ते को relation कहते हैं, और उसे तीन हिस्सों में लिखते हैं: (entity, रिश्ता, entity)। जैसे (Project milestone, due, Week 6)।
GraphRAG में एक LLM हर chunk पढ़कर ये relations निकालता है। Course corpus से ये 7 rows निकलती हैं: मेरा example
Entity
Relation
Entity
Project
has part
Proposal, Project milestone, Final report
Proposal
due
Oct 9
Project milestone
due
Week 6
Final report
due
Week 10
Homework 1
released
Oct 5
Office hours
run by
TAs
Office hours
held in
Room 104, Zoom
अब हर entity को एक node बनाइए, और हर relation को दो nodes के बीच की एक line। इन lines को edges कहते हैं, और nodes और edges के network को graph। Entities और relations वाले graph को knowledge graph कहते हैं। पहली row से Project तीन nodes से जुड़ता है, और हर part अपनी तारीख से।
Graph के कुछ हिस्सों के nodes आपस में बहुत जुड़े होते हैं, और बाकी graph से कम। ऐसे हिस्से को community कहते हैं। हमारे graph में तीन communities हैं, और वो आपस में किसी edge से नहीं जुड़ीं। पहली में Project, उसके तीन parts और उनकी तारीखें हैं। दूसरी में Office hours, TAs, Room 104 और Zoom हैं, और तीसरी में Homework 1 और Oct 5।
GraphRAG को 2024 में Microsoft Research के Edge और साथियों ने बनाया paper से। Indexing time पर इसके पाँच steps हैं, और query time पर दो:
Indexing time
Query time
1. Documents को chunks में तोड़िए। 2. LLM हर chunk से entities और relations निकालता है। 3. उनसे knowledge graph बनाइए। 4. Graph में communities ढूँढिए। 5. LLM हर community का सार लिखता है।
6. LLM हर community के सार से सवाल का एक हिस्सा-जवाब लिखता है। 7. LLM सारे हिस्सा-जवाबों को जोड़कर एक global answer लिखता है।
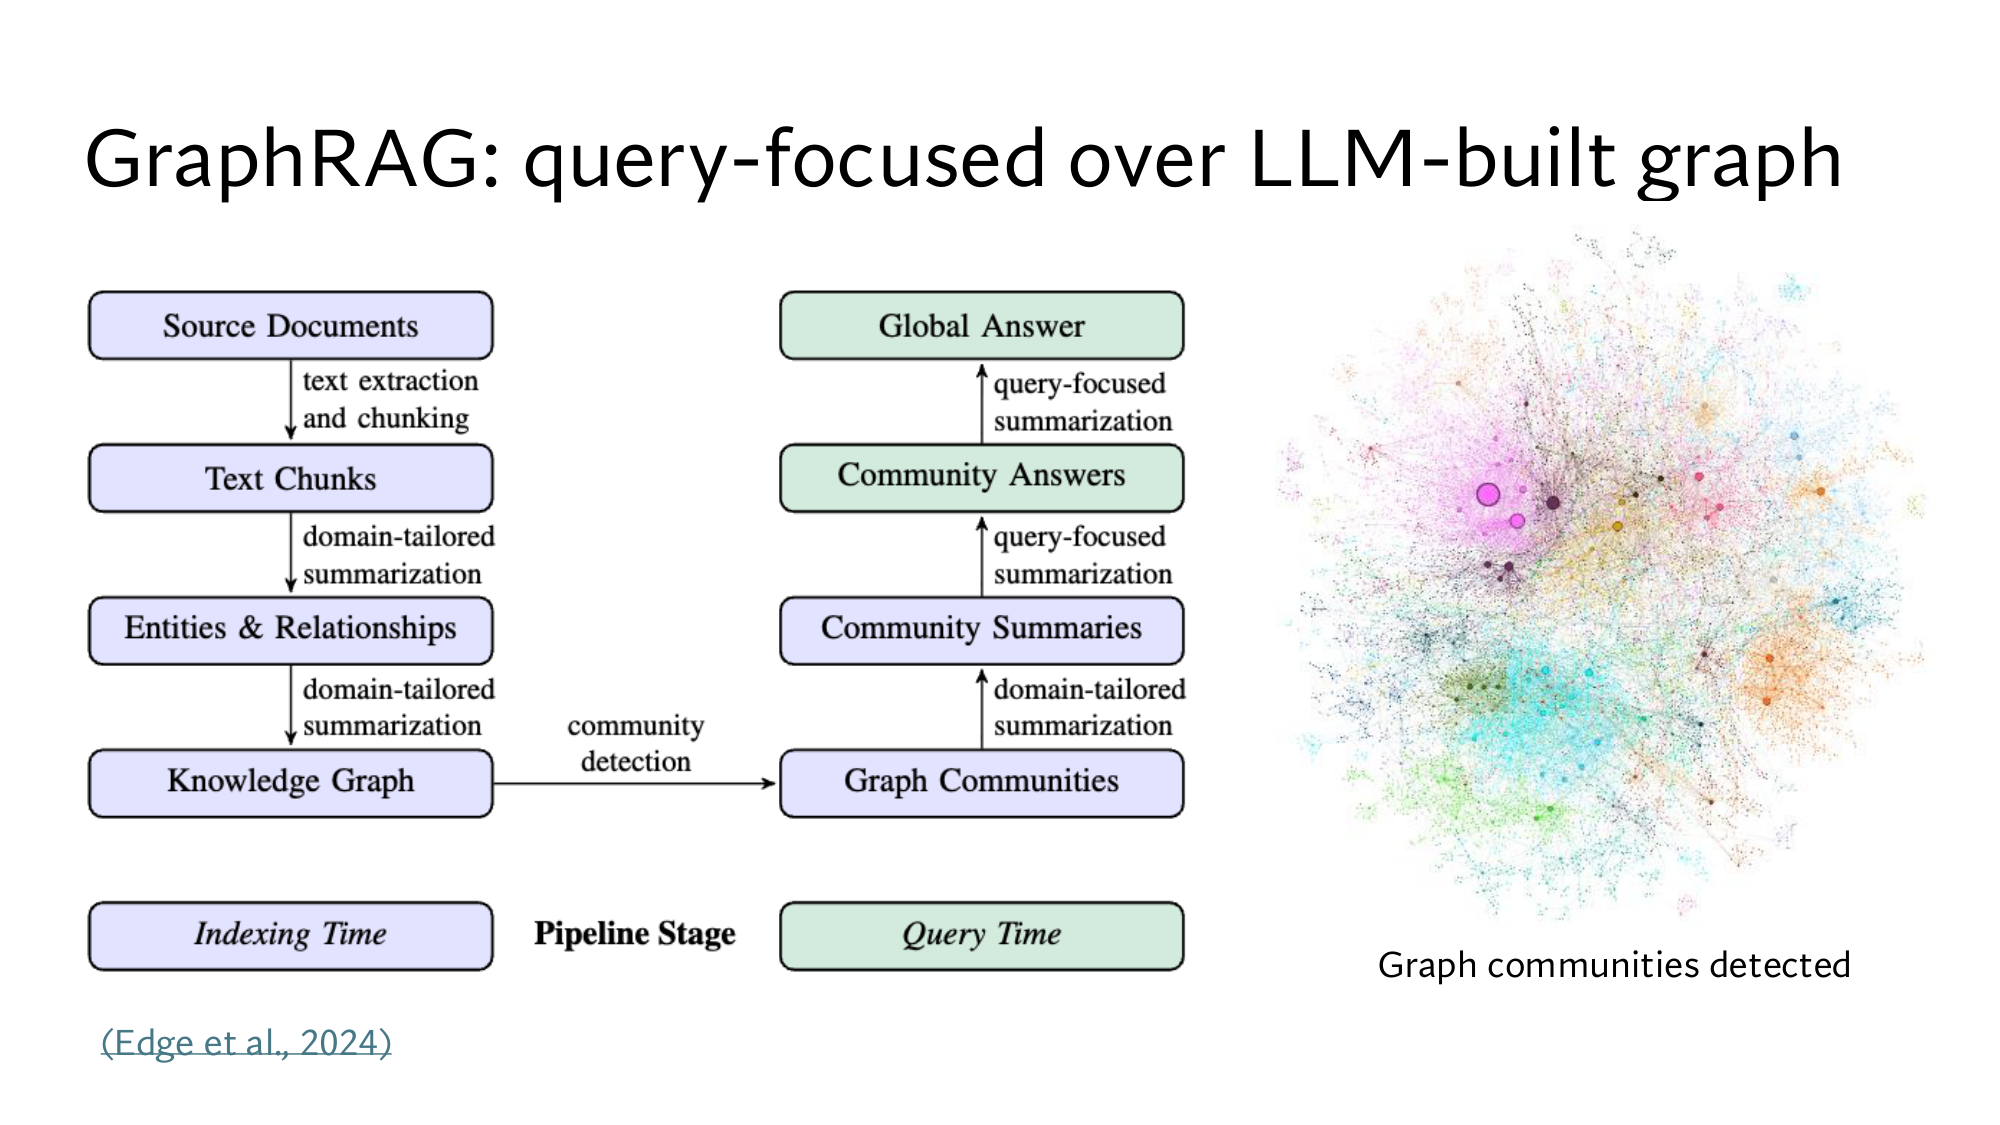
Stanford की GraphRAG slide। बाएँ नीचे की तरफ़ indexing time के steps हैं, और फिर दाएँ ऊपर की तरफ़ query time के। सबसे दाएँ एक असली graph है, जिसमें हर रंग एक community है।
हमारे सवाल पर step 6 हर community से एक हिस्सा-जवाब लिखता है। Project वाली community से तीन तारीखें आती हैं, Homework 1 वाली से एक, और office hours वाली से कोई नहीं। Step 7 इन्हें जोड़कर चारों तारीखों वाला जवाब लिखता है।
Steps 6 और 7 में LLM सार को सवाल के हिसाब से लिखता है, और इसे query-focused summarization कहते हैं। Slide के title में यही शब्द है। RAPTOR के सार सवाल आने से पहले बनते हैं, जबकि GraphRAG का आख़िरी सार सवाल आने पर बनता है।
GraphRAG का फ़ायदा पूरे corpus वाले global सवालों पर है, जहाँ top-K passages बिल्कुल नहीं चलते। कीमत ज़्यादा है: indexing पर हर chunk और हर community के लिए LLM calls, और query पर भी हर community के लिए एक call। LLM ने कोई गलत entity या relation निकाला, तो वो गलती graph में बैठकर उस community के सार तक पहुँचती है।
पहले सोचिए
आपकी company के पास 2,000 support tickets हैं। दो सवाल आते हैं: (a) Ticket #4471 किस product के बारे में है? (b) Customers सबसे ज़्यादा किस बात की शिकायत करते हैं? किस पर आम top-K काफ़ी है, और किस पर नहीं?
जवाब देखिए
(a) detail question है, क्योंकि उसका जवाब एक ticket में लिखा है, इसलिए top-K काफ़ी है। (b) thematic है, क्योंकि जवाब सैकड़ों tickets को मिलाकर बनता है, और कोई एक ticket ऊँचा score नहीं पाएगा। उसके लिए सार चाहिए, और सवाल पूरे corpus पर है, इसलिए GraphRAG ठीक बैठता है।
गहरे version में और क्या है
गहरे version में ये पूरा lesson है, और उसके बाद 5 पड़ाव और, जो Stanford की slides के level तक ले जाते हैं:
पड़ाव 6: RAPTOR की clustering का गणित: दूरी, Gaussian mixture, soft membership, BIC और UMAP।
पड़ाव 7: RAPTOR का paper: tree में ढूँढने के दो तरीके, setup और नतीजे।
पड़ाव 8: GraphRAG का paper: graph और communities कैसे बनते हैं, map-reduce वाला जवाब, और LLM judge वाले नतीजे।
पड़ाव 9: Survey में GraphRAG का पूरा परिवार।
पड़ाव 10: Stanford की चारों slides, जिन्हें आप खुद पढ़ते हैं।
Thematic question का जवाब किसी एक chunk में नहीं होता। हर chunk का cosine कम आता है, K बढ़ाना काफ़ी नहीं, और बड़ा chunk सारी बातें औसत में घोल देता है।
RAPTOR chunks को cluster करता है, हर cluster का सार LLM से लिखवाता है, और ऊपर तक tree बनाता है। Detail question leaf से मिलता है, और thematic question किसी सार से।
GraphRAG entities और relations का knowledge graph बनाता है, और हर community का सार लिखवाता है। Global सवाल का जवाब वो इन सारों से query-focused summarization करके लिखता है।
इस lesson के नए शब्द
Detail question और thematic question
जवाब एक जगह लिखा हो, या कई passages को मिलाकर बने। जैसे “milestone कब है?” और “सारी deadlines क्या हैं?”।
Clustering
Vectors को ऐसे groups में बाँटना कि एक group के vectors आपस में पास हों। जैसे syllabus [0.1, 0.9] और project page [0.2, 0.8] का cosine 0.99 है, तो दोनों एक group में।
Cluster और centroid
Cluster एक group है, और centroid उसके vectors का औसत। जैसे [0.1, 0.9], [0.2, 0.8] और [0.15, 0.85] का centroid [0.15, 0.85]।
Soft clustering
एक passage को एक से ज़्यादा clusters में रखना। जैसे FAQ page, जिसका cosine दोनों centroids से ऊँचा है (0.86 और 0.78)।
RAPTOR
Clusters के सारों से नीचे से ऊपर tree बनाना, और हर level पर ढूँढना। जैसे सारी deadlines वाला सवाल सार A से मिलता है।
Tree, node, leaf, root
Levels वाला ढाँचा: node एक box, leaf सबसे नीचे का node, और root सबसे ऊपर का। जैसे 6 chunks (leaves) के ऊपर 2 सार, और उनके ऊपर 1 root।
Entity
नाम वाली कोई चीज़: व्यक्ति, जगह, course, document या तारीख। जैसे Week 6, TAs, Room 104।
Relation
दो entities का रिश्ता। जैसे (Project milestone, due, Week 6)।
Knowledge graph और edge
Entities (nodes) और relations (edges) का network। जैसे milestone और Week 6 के बीच एक edge, जिस पर “due” लिखा है।
Community
Graph का आपस में बहुत जुड़ा हिस्सा। जैसे Office hours, TAs, Room 104 और Zoom।
GraphRAG
Knowledge graph, उसकी communities और उनके सारों से global सवालों का जवाब। जैसे सारी deadlines वाला जवाब, जो Project और Homework 1 वाली communities से बनता है।
Query-focused summarization
सवाल को ध्यान में रखकर सार लिखना। जैसे “सारी deadlines” पूछने पर Project community के सार से सिर्फ़ तारीखें आएँ।