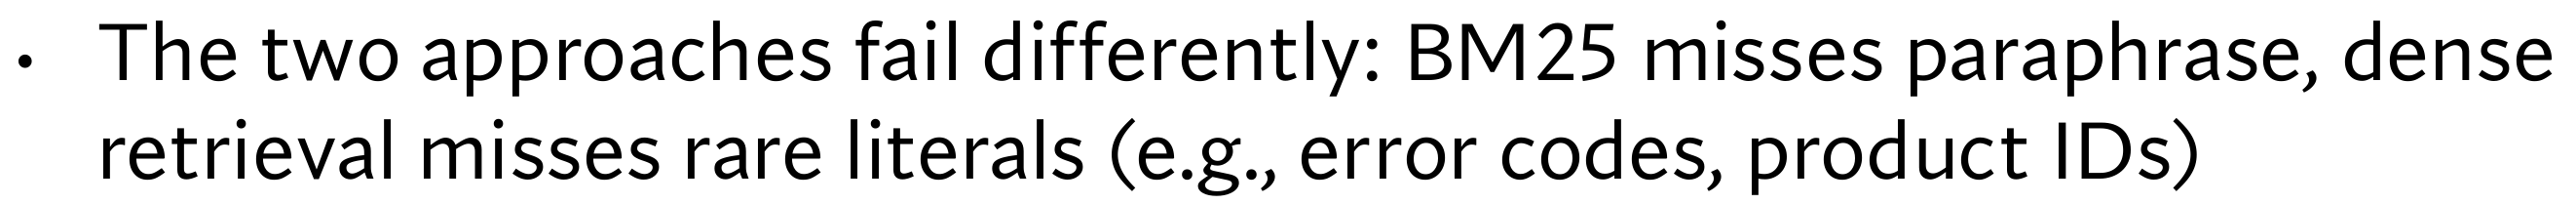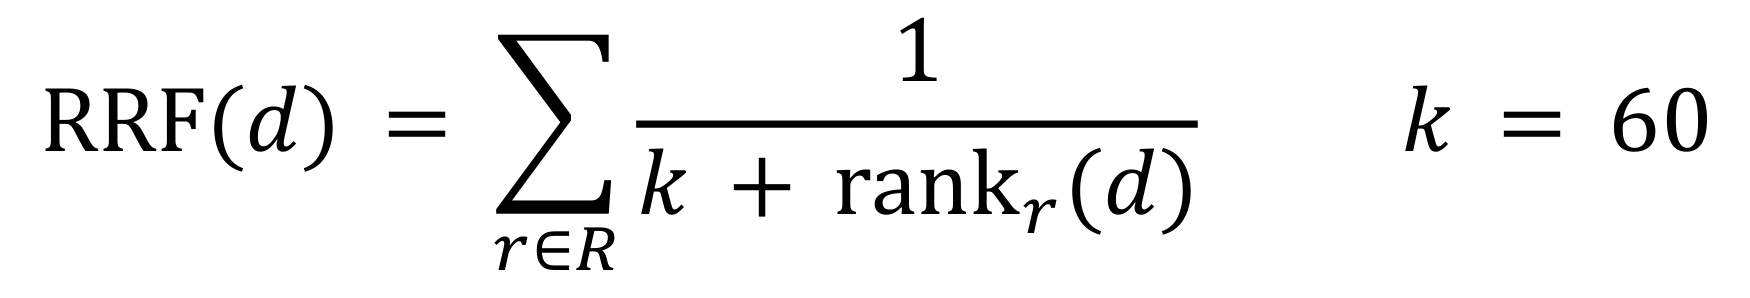Vector numbers की तय लंबाई वाली एक list है। Retriever हर text को vector में बदलता है, और फिर query के vector की हर passage के vector से तुलना करके score देता है। इस तुलना के दो आम तरीके हैं, dot product और cosine similarity, और इस lesson में आप दोनों हाथ से निकालेंगे।
इसकी ज़रूरत lesson 2 के आख़िर में दिखी थी। Query when can I get help from a TA पर ने हर passage को 0 दिया। जवाब office hours page में था: Office hours… run by the TAs। दोनों एक ही बात कहते हैं, लेकिन उनमें एक भी शब्द common नहीं है।
इस lesson की सीढ़ी
सीढ़ी में 9 पड़ाव हैं। पहले 4 आसान version जैसे ही हैं, और 5 से 9 आपको Stanford की slides के level तक ले जाते हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
पहले से क्या चाहिए: Lesson 2 (query, passage, score, top-K, word overlap)। पड़ाव 5 से आगे कुछ शब्द बाद के lessons के हैं, जैसे lesson 10 की दूरी और lesson 11 का BM25। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1Text की numbers वाली list
Vector numbers की तय लंबाई वाली list है, जैसे [0.9, 0.1]। List में कितने numbers हैं, उसे vector का dimension कहते हैं। [0.9, 0.1] का dimension 2 है, और [3, 0, 1, 2] का 4। Retriever को हर passage के लिए एक score चाहिए, और numbers की तुलना आसान है, इसलिए वो हर text को vector में बदलता है।
2 numbers वाले vector को plane पर एक तीर की तरह खींच सकते हैं: पहला number x-axis पर, और दूसरा y-axis पर। Origin (0, 0) से उस point तक का तीर ही vector है, और तीर की दिशा vector की दिशा है।
अब हर passage को हाथ से दो सवालों पर नापिए, और हर जवाब 0 से 2 के बीच दीजिए। पहला number बताता है कि passage मदद या office hours के बारे में कितना है। दूसरा number बताता है कि वो deadlines के बारे में कितना है। Lesson 2 के corpus से तीन passages लीजिए। साथ में एक नया passage जोड़िए: course का लंबा FAQ page, जिसमें office hours और deadlines, दोनों की बहुत बातें हैं। vectors मेरे बनाए हैं
Text
Vector
Office hours page
[0.9, 0.1]
Syllabus: milestone की तारीख
[0.1, 0.9]
Project page: proposal की तारीख
[0.2, 0.8]
Course FAQ, लंबा page
[1.6, 1.4]
Query: when can I get help from a TA
[0.8, 0.2]
Query और office hours page में एक भी common शब्द नहीं है, फिर भी उनके vectors पास-पास हैं: [0.8, 0.2] और [0.9, 0.1]। ये numbers उन दो सवालों के जवाब हैं, और दोनों texts के जवाब लगभग एक जैसे हैं। इसलिए vector वो मेल पकड़ सकता है, जो शब्द गिनने में छूट जाता है।
असली systems में dimensions के ऐसे नाम नहीं होते, और dimension सैकड़ों में होता है, जैसे BERT-base के vectors में 768। paper से यहाँ 2 numbers हैं, ताकि आप vectors को plane पर देख सकें। आगे का हर हिसाब 768 numbers पर भी इसी तरह चलता है।
पहले सोचिए
Passage Extra office hours on Zoom this Friday को इन्हीं दो सवालों पर नापिए। करीब कौन सा vector बनेगा, और वो table के किस passage के पास होगा?
जवाब देखिए
ये passage पूरी तरह office hours के बारे में है, और इसमें कोई deadline नहीं है। तो करीब [0.9, 0.0] जैसा vector बनेगा, जो office hours page [0.9, 0.1] के बिल्कुल पास है।
2Dot product: लंबा vector जीतता है
Dot product दो vectors से एक number बनाता है: एक ही जगह वाले numbers का गुणा कीजिए, फिर सारे गुणा जोड़ दीजिए। Query [0.8, 0.2] और office hours page [0.9, 0.1] के लिए ये 0.8 × 0.9 + 0.2 × 0.1 = 0.72 + 0.02 = 0.74 है। Dot product का दूसरा नाम inner product है, और Stanford की slides यही नाम लेती हैं।
पहले सोचिए
FAQ page [1.6, 1.4] की दिशा query से उतनी नहीं मिलती, जितनी office hours page की। फिर भी उसका dot product 0.74 से कम होगा, या ज़्यादा?
जवाब देखिए
ज़्यादा: 0.8 × 1.6 + 0.2 × 1.4 = 1.28 + 0.28 = 1.56। नीचे की table में बाकी passages भी हैं।
Passage
हिसाब
Dot product
Office hours page[0.9, 0.1]
0.8 × 0.9 + 0.2 × 0.1 = 0.72 + 0.02
0.74
Syllabus[0.1, 0.9]
0.8 × 0.1 + 0.2 × 0.9 = 0.08 + 0.18
0.26
Project page[0.2, 0.8]
0.8 × 0.2 + 0.2 × 0.8 = 0.16 + 0.16
0.32
FAQ page[1.6, 1.4]
0.8 × 1.6 + 0.2 × 1.4 = 1.28 + 0.28
1.56
सबसे ऊपर FAQ page है, क्योंकि उसके दोनों numbers बड़े हैं। FAQ page का vector [0.8, 0.7] का ठीक दोगुना है। [0.8, 0.7] से query का dot product 0.64 + 0.14 = 0.78 है, और FAQ page का 1.56 = 2 × 0.78।
किसी vector को दोगुना करने पर ऐसा हर बार होता है। Dot product के हर गुणा में एक number उसी vector से आता है। वो number दोगुना हुआ, तो हर गुणा दोगुना हुआ, और उनका जोड़ भी। मतलब dot product दिशा के साथ तीर की लंबाई भी नापता है, और लंबा vector सिर्फ़ लंबाई की वजह से ऊपर आ सकता है।
यही हिसाब symbols में ऐसे लिखते हैं:
a · b = ∑i = 1 … daibi
∑ (sigma) का मतलब है कि नीचे लिखी range के हर i के लिए जोड़ते जाइए, यहाँ i = 1 से dimension d = 2 तक। ai query का i-वाँ number है, और bi office hours page का। तो a · b = a1b1 + a2b2 = 0.8 × 0.9 + 0.2 × 0.1 = 0.74।
Dot product तेज़ है, सिर्फ़ d गुणा और d जोड़, और lesson 5 और lesson 12 के retrievers यही score लेते हैं। उसकी हद ऊपर दिख गई: लंबे vector वाला passage ऊपर आ सकता है, चाहे उसकी दिशा उतनी न मिले।
3Cosine similarity: सिर्फ़ दिशा की तुलना
Cosine similarity दो vectors की सिर्फ़ दिशा की तुलना करता है, उनकी लंबाई की नहीं। इसके लिए वो dot product को दोनों vectors की लंबाई के गुणा से भाग देता है। तो पहले लंबाई निकालना सीखिए।
Vector की length
Vector की length उसके तीर की लंबाई है। Plane पर query का तीर एक right triangle की सबसे लंबी side है, जिसकी बाकी दो sides 0.8 और 0.2 लंबी हैं। इसलिए Pythagoras से length √(0.8² + 0.2²) है। मतलब हर number का square लीजिए, सबको जोड़िए, फिर square root लीजिए:
Squares: 0.8 × 0.8 = 0.64, और 0.2 × 0.2 = 0.04।
जोड़: 0.64 + 0.04 = 0.68।
Square root: √0.68 = 0.82। Square root वो number है, जिसे खुद से गुणा करने पर अंदर वाला number मिले। जाँच: 0.8246 × 0.8246 = 0.680।
|a| = √( ∑iai2 )
Office hours page की length इसी तरह √(0.81 + 0.01) = √0.82 = 0.91 है।
Dot product ÷ दोनों lengths
अब dot product को दोनों lengths के गुणा से भाग दीजिए। Query और office hours page के लिए ये 0.74 ÷ (0.82 × 0.91) = 0.99 है। इस number को cosine similarity कहते हैं।
cos(a, b) = a · b|a| × |b|
नाम cosine इसलिए है, क्योंकि ये number दोनों तीरों के बीच के कोण (angle) का cosine है। एक ही दिशा वाले तीरों पर ये 1 है, 90° पर 0, और उल्टी दिशा में −1। Query और office hours page के बीच करीब 8° का कोण है, और cos 8° = 0.99।
वही query, जिसकी length 0.82 है, अब हर passage से:
Passage
Dot product
Length
Cosine
Office hours page[0.9, 0.1]
0.74
0.91
0.990.74 ÷ (0.82 × 0.91)
FAQ page[1.6, 1.4]
1.56
2.13
0.891.56 ÷ (0.82 × 2.13)
Project page[0.2, 0.8]
0.32
0.82
0.470.32 ÷ (0.82 × 0.82)
Syllabus[0.1, 0.9]
0.26
?
?
Lengths 2 decimal तक rounded हैं। Cosine पूरे numbers से निकला है, इसलिए हाथ के हिसाब में आख़िरी अंक थोड़ा अलग आ सकता है।
Syllabus वाली row आप निकालिए
Syllabus = [0.1, 0.9], और query से उसका dot product 0.26 है। Syllabus की length और cosine कितने हैं?
जवाब देखिए
Length = √(0.01 + 0.81) = √0.82 = 0.91। Cosine = 0.26 ÷ (0.82 × 0.91) = 0.35। ये सबसे नीचे है, क्योंकि syllabus deadlines के बारे में है, और query मदद के बारे में।
Cosine में office hours page सबसे ऊपर आया, और FAQ page दूसरी जगह पर गिर गया। FAQ page का vector [0.8, 0.7] का दोगुना है, इसलिए उसकी length भी दोगुनी है: 1.063 की जगह 2.126। Dot product भी दोगुना हुआ था, और भाग में ये 2 कट जाता है। तो cosine पर vector की length का कोई असर नहीं होता, और लंबे page का फ़ायदा चला जाता है।
Normalize: length 1 वाले vectors
एक shortcut भी है। हर vector के हर number को उसकी length से भाग दीजिए, तो उसकी length 1 हो जाती है, और दिशा वही रहती है। इसे normalize करना कहते हैं। Query normalize करने पर [0.8 ÷ 0.8246, 0.2 ÷ 0.8246] = [0.970, 0.243] बनता है, और office hours page [0.994, 0.110]।
Normalize किए vectors का dot product सीधे cosine है, क्योंकि अब नीचे की दोनों lengths 1 हैं: 0.970 × 0.994 + 0.243 × 0.110 = 0.964 + 0.027 = 0.991। इसलिए अगर index के सारे vectors normalize किए हुए हों, तो dot product और cosine एक ही score देते हैं।
Query का तीर खींचिए
Plane पर click कीजिए या खींचिए, तो query का तीर वहाँ चला जाता है। Milestone वाली query पर dot product से FAQ page ऊपर आता है, और cosine से syllabus।
Passage
Vector
Dot product
Cosine
Cosine की भी एक हद है: वो length को पूरी तरह छोड़ देता है, और कभी length में भी काम की बात होती है। दो vectors से similarity का number बनाने के तरीके को similarity metric कहते हैं। कौन सा metric लेना है, ये इस पर टिका है कि vectors बनाने वाले model की training किस metric के साथ हुई।
4Embedding model: हर text का vector अपने आप
ऊपर के vectors हाथ से बने, दो सवाल पूछकर। Lesson 2 की company के 60,000 passages के लिए ये हाथ से नहीं हो सकता, और दो सवाल किसी text की हर बात नहीं पकड़ते। इसलिए ऐसा program चाहिए, जो किसी भी text को अपने आप vector दे।
Embedding किसी text का वो vector है, जो एक trained model बनाता है, ताकि मिलती-जुलती बात वाले texts के vectors की दिशा भी मिलती-जुलती हो। Text पढ़कर embedding बनाने वाले model को embedding model या encoder कहते हैं। Encoder भी lesson 1 वाले से बना है।
Training encoder को ऐसे text जोड़े दिखाती है, जिनकी बात मिलती है, और ऐसे भी, जिनकी नहीं मिलती। फिर वो parameters को इस तरह बदलती है कि पहली तरह के जोड़ों का score बढ़े, और दूसरी तरह के जोड़ों का घटे। ये training पूरी lesson 12 में है।
अब TA वाली query पर लौटिए। Encoder से query का embedding बनाइए, और lesson 2 के passages से cosine निकालिए। नतीजा कुछ ऐसा हो सकता है: numbers मेरे बनाए हैं, किसी असली model के नहीं
Passage
Common शब्द
Cosine
Office hours pageOffice hours: Tuesday 4pm in Room 104 and Thursday 9am on Zoom, run by the TAs.
Homework 1 की announcementHomework 1 will be released on Oct 5.
0
0.22
SyllabusGrading. The project milestone is due Week 6 …
0
0.15
Query और office hours page में एक भी common शब्द नहीं है, फिर भी office hours page 0.78 के साथ सबसे ऊपर है। Lesson 2 का retriever जहाँ हर passage को 0 देता था, embedding वाला retriever वहाँ सही passage ऊपर लाता है।
Offline और online
Embedding वाला retriever दो हिस्सों में चलता है। Offline, यानी query आने से पहले, encoder हर passage का embedding एक बार बनाता है। पहले से बनाकर रखे इन embeddings की list को index कहते हैं। Online, यानी हर query पर, encoder सिर्फ़ query का embedding बनाता है। फिर index के हर embedding से उसका cosine या dot product निकलता है, और सबसे ऊँचे scores वाले K passages लौटते हैं।
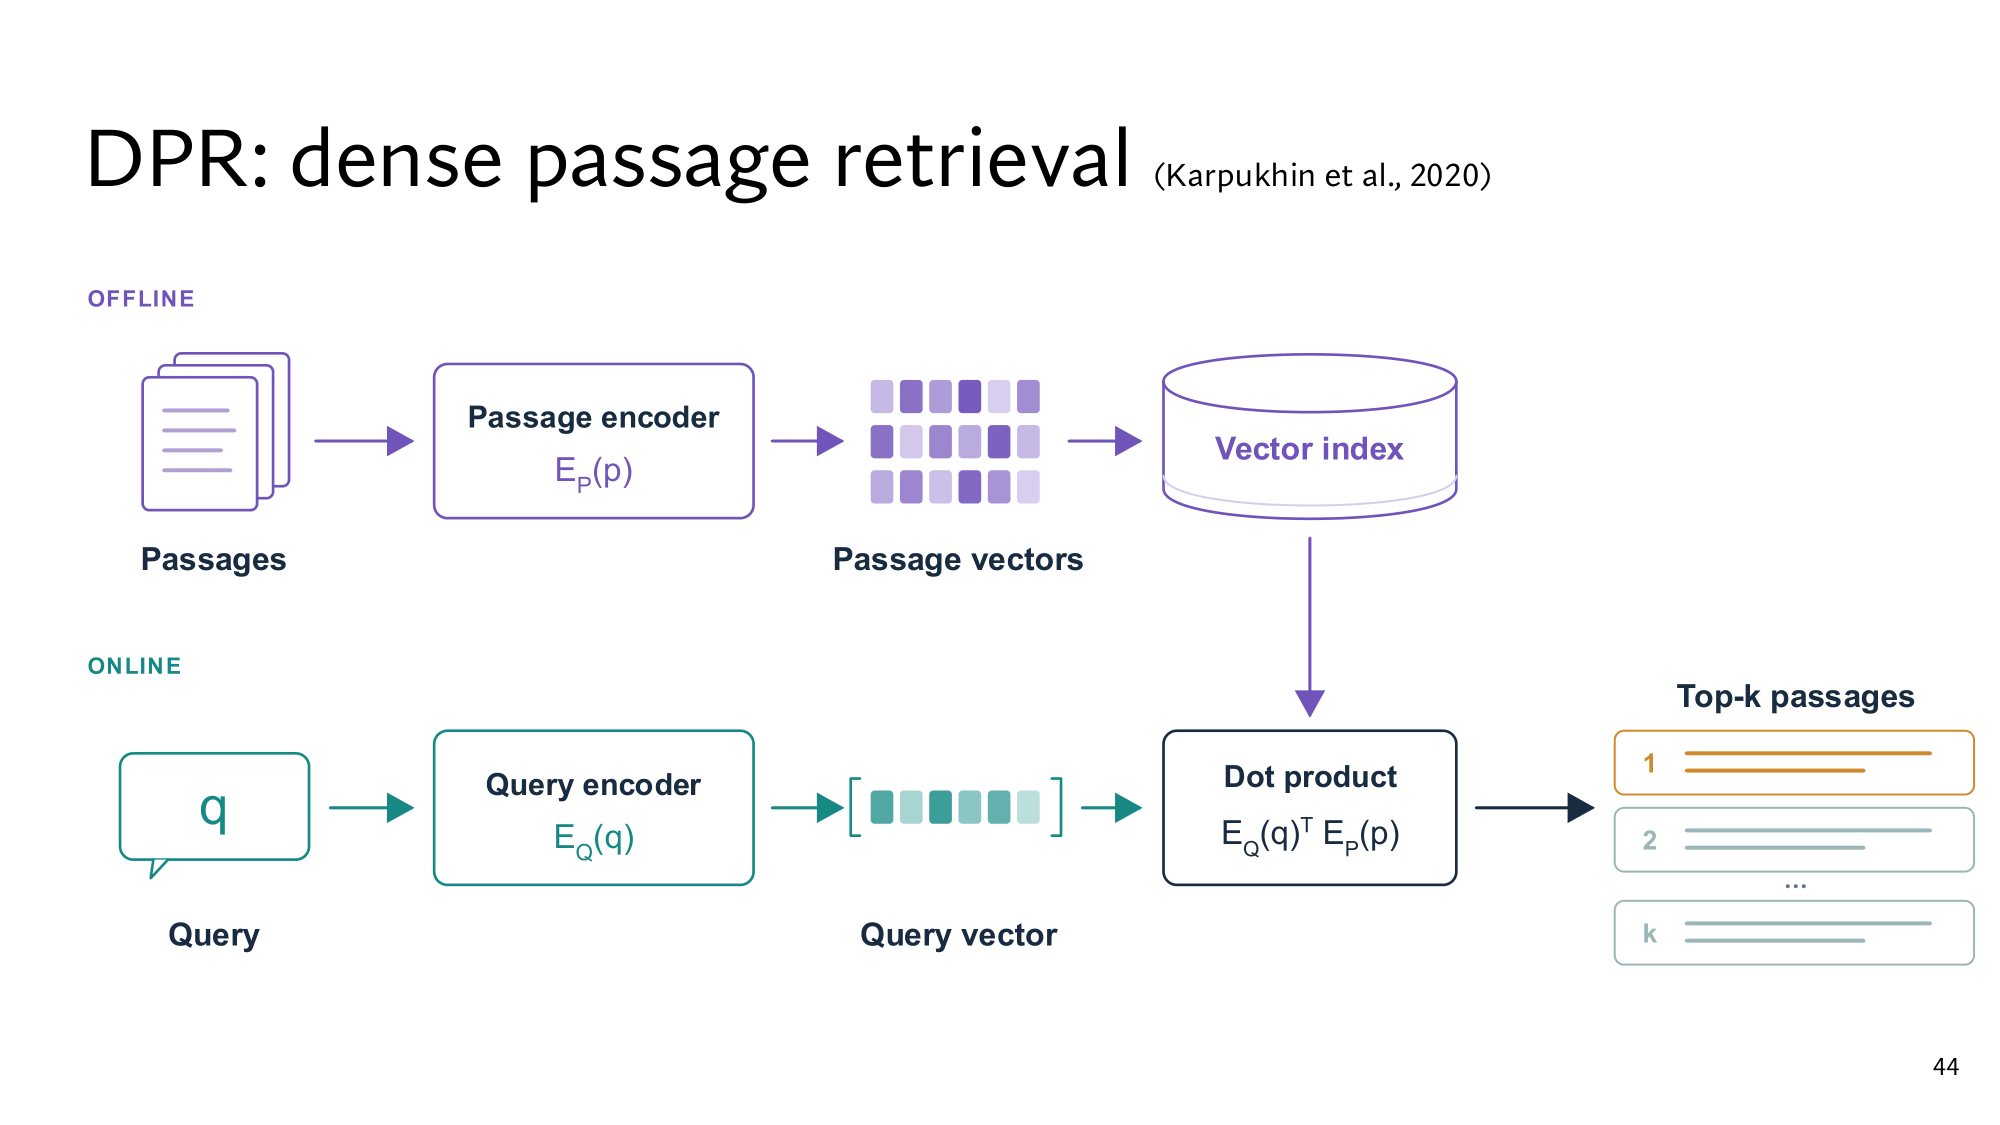
Stanford की DPR वाली slide यही दो हिस्से दिखाती है। Lesson 12 के DPR में दो अलग encoders हैं: EP passages के लिए, और EQ query के लिए। Slide के box में लिखा EQ(q)⊤ EP(p) दोनों vectors का dot product है, और उसे लिखने का एक तरीका है।
Stanford की slide: DPR का offline हिस्सा ऊपर, और online हिस्सा नीचे। Image पर click करने से वो पूरे size में खुलती है।
Embedding वाले retriever की दो हदें आगे आएँगी। पहली, वो हूबहू मिलने वाली चीज़ें चूक सकता है: error code E-4012 और E-4021 वाले passages के embeddings लगभग एक जैसे हो सकते हैं। इसका हल lesson 14 में है। दूसरी, हर query पर index के हर embedding से तुलना होती है, यानी 60,000 passages पर 60,000 cosine। करोड़ों passages पर ये धीमा है, और इसका हल lesson 10 में है।
पहले सोचिए
Corpus में नया passage जुड़े, तो embedding वाले retriever में क्या करना होगा?
जवाब देखिए
Encoder सिर्फ़ उस passage का embedding बनाता है, और आप उसे index में जोड़ देते हैं। बाकी index वैसा ही रहता है। हर query पर तब भी सिर्फ़ query का embedding नया बनता है।
यहाँ से Stanford वाला level
ऊपर के 4 पड़ाव आसान version जैसे ही हैं। आगे के 5 पड़ाव आपको Stanford की slides के level तक ले जाते हैं। पहले cosine और कोण का गणित आता है, फिर dot product, cosine और दूरी का रिश्ता, और DPR का चुनाव। उसके बाद index एक matrix की तरह आता है, और फिर Stanford की table के पाँच तरह के embeddings। आख़िर में आप slides खुद पढ़ते हैं। हर गणित वहीं समझाया है, जहाँ वो पहली बार आता है।
5Cosine और कोण: दिशा का एक number
Cosine similarity सच में दोनों तीरों के बीच के कोण का cosine है, इसलिए वो हमेशा −1 और 1 के बीच रहता है। पड़ाव 3 में ये बात सिर्फ़ कही गई थी। ये पड़ाव उसे school के दो नियमों से numbers पर दिखाता है।
Length 1 वाले तीर के numbers
School का पहला नियम right triangle का है। किसी कोण का cos उसके पास वाली side ÷ सबसे लंबी side है, और sin सामने वाली side ÷ सबसे लंबी side। अब length 1 का एक तीर लीजिए, जो x-axis से A कोण पर है। उसकी सबसे लंबी side 1 है, इसलिए उसके दो numbers सीधे cos A और sin A हैं।
पड़ाव 3 में normalize की हुई query [0.970, 0.243] थी, यानी length 1 का तीर। उसका पहला number cos A है, और cos 14.0° = 0.970, इसलिए query का तीर x-axis से 14.0° पर है। इसी तरह office hours page [0.994, 0.110] का तीर 6.3° पर है। दोनों तीरों के बीच का कोण 14.0° − 6.3° = 7.7° है। हिसाब मेरा
cos(A − B) का नियम
School का दूसरा नियम दो कोणों के फ़र्क का है:
cos(A − B) = cos A · cos B + sin A · sin B
दाईं तरफ़ ठीक दो length 1 वाले तीरों का dot product है: पहले numbers का गुणा, और दूसरे numbers का गुणा, फिर जोड़। हमारे numbers पर:
Query: cos A = 0.970 और sin A = 0.243। Office hours page: cos B = 0.994 और sin B = 0.110।
कोण का cosine: cos 7.7° = 0.991। जाँच: दोनों बराबर हैं।
मतलब normalize किए vectors का dot product उनके बीच के कोण का cosine है, और पड़ाव 3 में ये dot product ही cosine similarity था। नीचे की table चारों passages के कोण दिखाती है, और हर row में cos वही आता है जो पड़ाव 3 की table में था:
Passage
x-axis से कोण
Query से कोण
cos
Office hours page
6.3°
7.7°
0.99
FAQ page
41.2°
27.1°
0.89
Project page
76.0°
61.9°
0.47
Syllabus
83.7°
69.6°
0.35
Query x-axis से 14.0° पर है। कोण पूरे numbers से निकले हैं, इसलिए rounded कोणों को घटाने पर आख़िरी अंक थोड़ा अलग आ सकता है। जैसे FAQ page के लिए 41.19° − 14.04° = 27.15°, और cos 27.15° = 0.89।
तीन आसान cases से ये नियम खुद check कीजिए। [1, 0] और [1, 1] का dot product 1 है, और lengths 1 और √2 = 1.414 हैं, इसलिए cosine 1 ÷ 1.414 = 0.707 है। Plane पर [1, 1] वाला तीर ठीक 45° पर है, और cos 45° = 0.707। [1, 0] और [0, 1] का dot product 0 है, यानी कोण 90° है। [0.8, 0.2] और [−0.8, −0.2] का cosine −0.68 ÷ 0.68 = −1 है, यानी कोण 180° है।
Dot product कभी दोनों lengths के गुणा से बड़ा नहीं होता
किसी भी कोण का cos −1 और 1 के बीच होता है। इसलिए cosine = a · b ÷ (|a| × |b|) भी इसी range में रहता है, और इसका मतलब है कि a · b कभी |a| × |b| से बड़ा नहीं होता। FAQ page पर देखिए: dot product 1.56 है, और 0.82 × 2.13 = 1.75, यानी 1.56 छोटा है। ये नियम 768 dimensions में भी सच है, जहाँ तीर खींच नहीं सकते, और वहाँ यही formula कोण का मतलब तय करता है।
दोनों बराबर सिर्फ़ तब होते हैं, जब दोनों तीर एक ही दिशा में हों। जैसे [0.4, 0.1] query का ठीक आधा है: dot product 0.32 + 0.02 = 0.34 है, और 0.8246 × 0.4123 = 0.34 भी, इसलिए cosine 1.00 है। Dot product में ये छोटा vector office hours page (0.74) से नीचे रहता, लेकिन cosine में सबसे ऊपर है। मेरा example
पहले सोचिए
हमारे सारे vectors के numbers 0 या उससे बड़े हैं। तब किसी भी जोड़े का cosine 0 से कम हो सकता है क्या? असली embeddings में क्या होता है?
जवाब देखिए
नहीं हो सकता। दोनों vectors के सारे numbers 0 या उससे बड़े हों, तो हर गुणा भी 0 या उससे बड़ा है, इसलिए dot product और cosine भी। Plane पर सारे तीर पहले हिस्से में हैं, और उनके बीच का कोण 90° से बड़ा नहीं हो सकता। असली embeddings के numbers negative भी होते हैं, इसलिए वहाँ cosine 0 से कम भी हो सकता है।
6Dot product, cosine और दूरी: कब एक जैसे, कब अलग
दूरी, dot product और cosine एक ही हिसाब से जुड़े हैं: normalize किए vectors पर तीनों एक ही क्रम देते हैं। बाकी vectors पर उनका क्रम अलग हो सकता है। दो vectors के फ़र्क वाले vector की length है। Office hours page − query = [0.9 − 0.8, 0.1 − 0.2] = [0.1, −0.1], और उसकी length √(0.01 + 0.01) = √0.02 = 0.14 है। दूरी जितनी छोटी, passage उतना पास।
तीनों तरीकों से हमारे चारों passages का क्रम देखिए: हिसाब मेरा
Passage
Dot product
Cosine
दूरी
Office hours page
0.74दूसरा
0.99पहला
0.14पहला
FAQ page
1.56पहला
0.89दूसरा
1.44चौथा
Project page
0.32तीसरा
0.47तीसरा
0.85दूसरा
Syllabus
0.26चौथा
0.35चौथा
0.99तीसरा
FAQ page dot product में पहला है, cosine में दूसरा, और दूरी में आख़िरी। तीनों का रिश्ता एक formula से निकलता है, और उसके लिए school का एक नियम चाहिए: (x − y)² = x² + y² − 2xy। जैसे (0.9 − 0.8)² = 0.81 + 0.64 − 1.44 = 0.01।
दूरी के square को खोलना
दूरी का square फ़र्क वाले vector के हर number के square का जोड़ है। हर number पर ऊपर वाला नियम लगाइए, और फिर सबको जोड़िए। x² वाले हिस्से जुड़कर |a|² बनते हैं, y² वाले |b|², और xy वाले a · b:
|a − b|2 = |a|2 + |b|2 − 2 a · b
Office hours page: 0.68 + 0.82 − 2 × 0.74 = 1.50 − 1.48 = 0.02, और √0.02 = 0.14। जाँच: ऊपर भी 0.14 आया था।
FAQ page का |b|² = 4.52 बहुत बड़ा है, इसलिए उसका बड़ा dot product भी दूरी को छोटा नहीं कर पाता। मतलब dot product length का फ़ायदा देता है, दूरी length पर नुकसान देती है, और cosine length को छोड़ देता है।
अब दोनों vectors normalize कीजिए। तब |a|² = |b|² = 1, और formula बनता है 2 − 2 cos। Office hours page के लिए 2 − 2 × 0.991 = 0.018, और FAQ page के लिए 2 − 2 × 0.890 = 0.220। Cosine जितना बड़ा, दूरी उतनी छोटी, इसलिए तीनों तरीके एक ही क्रम देते हैं। मतलब normalize किए vectors पर कौन सा तरीका लें, इससे क्रम नहीं बदलता।
DPR paper भी यही कहता है: unit vectors, यानी length 1 वाले vectors, पर cosine और inner product एक ही चीज़ हैं। साथ में वो कहता है कि ज़्यादातर ऐसे similarity functions L2 दूरी के ही बदले हुए रूप हैं। paper से L2 दूरी इसी दूरी का नाम है।
DPR ने dot product क्यों चुना
DPR paper similarity function की एक शर्त रखता है: वो decomposable हो। मतलब score सवाल के vector और passage के vector से निकले, और passage का vector सवाल देखे बिना बने। तभी पड़ाव 4 वाला offline index बन सकता है। Dot product, cosine और दूरी, तीनों इस शर्त पर खरे हैं। जो model सवाल और passage को साथ पढ़ता है, वो decomposable नहीं है, और lesson 14 का ऐसा ही है। paper से
Paper ने dot product के साथ cosine और L2 दूरी भी आज़माई। एक जगह वो कहता है कि दूसरे functions लगभग बराबर रहे। Experiments वाले हिस्से में वो साफ़ लिखता है कि L2 dot product के लगभग बराबर रहा, और दोनों cosine से बेहतर रहे। NQ के dev set पर top-20 accuracy dot product के साथ 78.1% है, और L2 के साथ 76.1%। Cosine के numbers paper नहीं देता। paper से इसलिए DPR ने सबसे सीधा dot product रखा।
दूसरे models cosine के साथ train होते हैं। Sentence-BERT अपने vectors की तुलना cosine से करता है, और E5 का score cosine ÷ 0.01 है। paper से
E5 में 0.99 वाला जोड़ा 99 बनता है, और 0.89 वाला 89। हर score एक ही number से भाग होता है, इसलिए क्रम वही रहता है, जैसे पड़ाव 2 में दोगुना करने पर रहा था। नियम ये है कि जिस metric के साथ model train हुआ, retrieval में वही metric लीजिए।
7Index एक matrix है: सारे scores एक गुणा में
Stanford की slide कहती है कि retrieval को हर chunk का fixed-dimension vector चाहिए। Dimension तय होना इसलिए ज़रूरी है, क्योंकि dot product numbers को जगह के हिसाब से जोड़ता है। [0.8, 0.2] और [0.9, 0.1, 0.5] का dot product नहीं बनता, क्योंकि तीसरे number का कोई जोड़ीदार नहीं है। इसलिए FAQ page लंबा है, फिर भी उसके vector में 2 ही numbers हैं, और DPR में हर passage के vector में 768।
Matrix numbers की एक table है, जिसमें rows और columns होते हैं। सारे passage vectors को एक के नीचे एक रखिए, तो index एक matrix P बन जाता है। उसकी हर row एक passage है, और हर column एक dimension। हमारा index 4 rows और 2 columns का है, जिसे 4 × 2 matrix कहते हैं:
Row, यानी passage
Column 1
Column 2
Query [0.8, 0.2] से dot product
Office hours page
0.9
0.1
0.74
Syllabus
0.1
0.9
0.26
Project page
0.2
0.8
0.32
FAQ page
1.6
1.4
1.56
आख़िरी column ही matrix-vector गुणा P q है। उसका नियम ये है: matrix की हर row का vector q से dot product लीजिए, और नतीजों को एक के नीचे एक लिखिए। 4 × 2 matrix और 2 numbers वाले vector से 4 numbers निकलते हैं, यानी [0.74, 0.26, 0.32, 1.56]। Matrix के columns और vector के numbers की गिनती बराबर होनी चाहिए, और fixed dimension वाली शर्त यही है।
Transpose और slide का EQ(q)⊤EP(p)
Matrix की भाषा में vector को अक्सर एक column की तरह लिखते हैं, यानी 2 rows और 1 column वाली matrix। Transpose, जिसे ⊤ लिखते हैं, rows को columns बना देता है, इसलिए column वाला vector एक row बन जाता है। Row (1 × 2) गुणा column (2 × 1) का नतीजा 1 × 1 है, यानी एक number, और ये number ठीक dot product है:
[0.8 0.2] × 0.90.1 = 0.8 × 0.9 + 0.2 × 0.1 = 0.74
Stanford की DPR slide पर लिखा EQ(q)⊤EP(p) यही है: query encoder का vector row बनता है, और passage encoder का vector column रहता है। Lesson 4 इसी को लिखता है।
Index के हर row को पहले normalize कर दीजिए, और query को भी। तब यही एक गुणा चारों cosines देता है: [0.99, 0.35, 0.47, 0.89]। Lesson 12 पूरे batch के लिए यही विचार दो matrices के गुणा से लगाता है।
असली पैमाने पर DPR के index में करीब 2.1 करोड़ rows और 768 columns हैं। paper से एक query पर ये matrix-vector गुणा 2.1 करोड़ dot products है, यानी 2.1 करोड़ × 768 = करीब 1,613 करोड़ गुणा। इसे तेज़ करने के तरीके lesson 10 में हैं।
8Stanford की table: पाँच तरह के embeddings
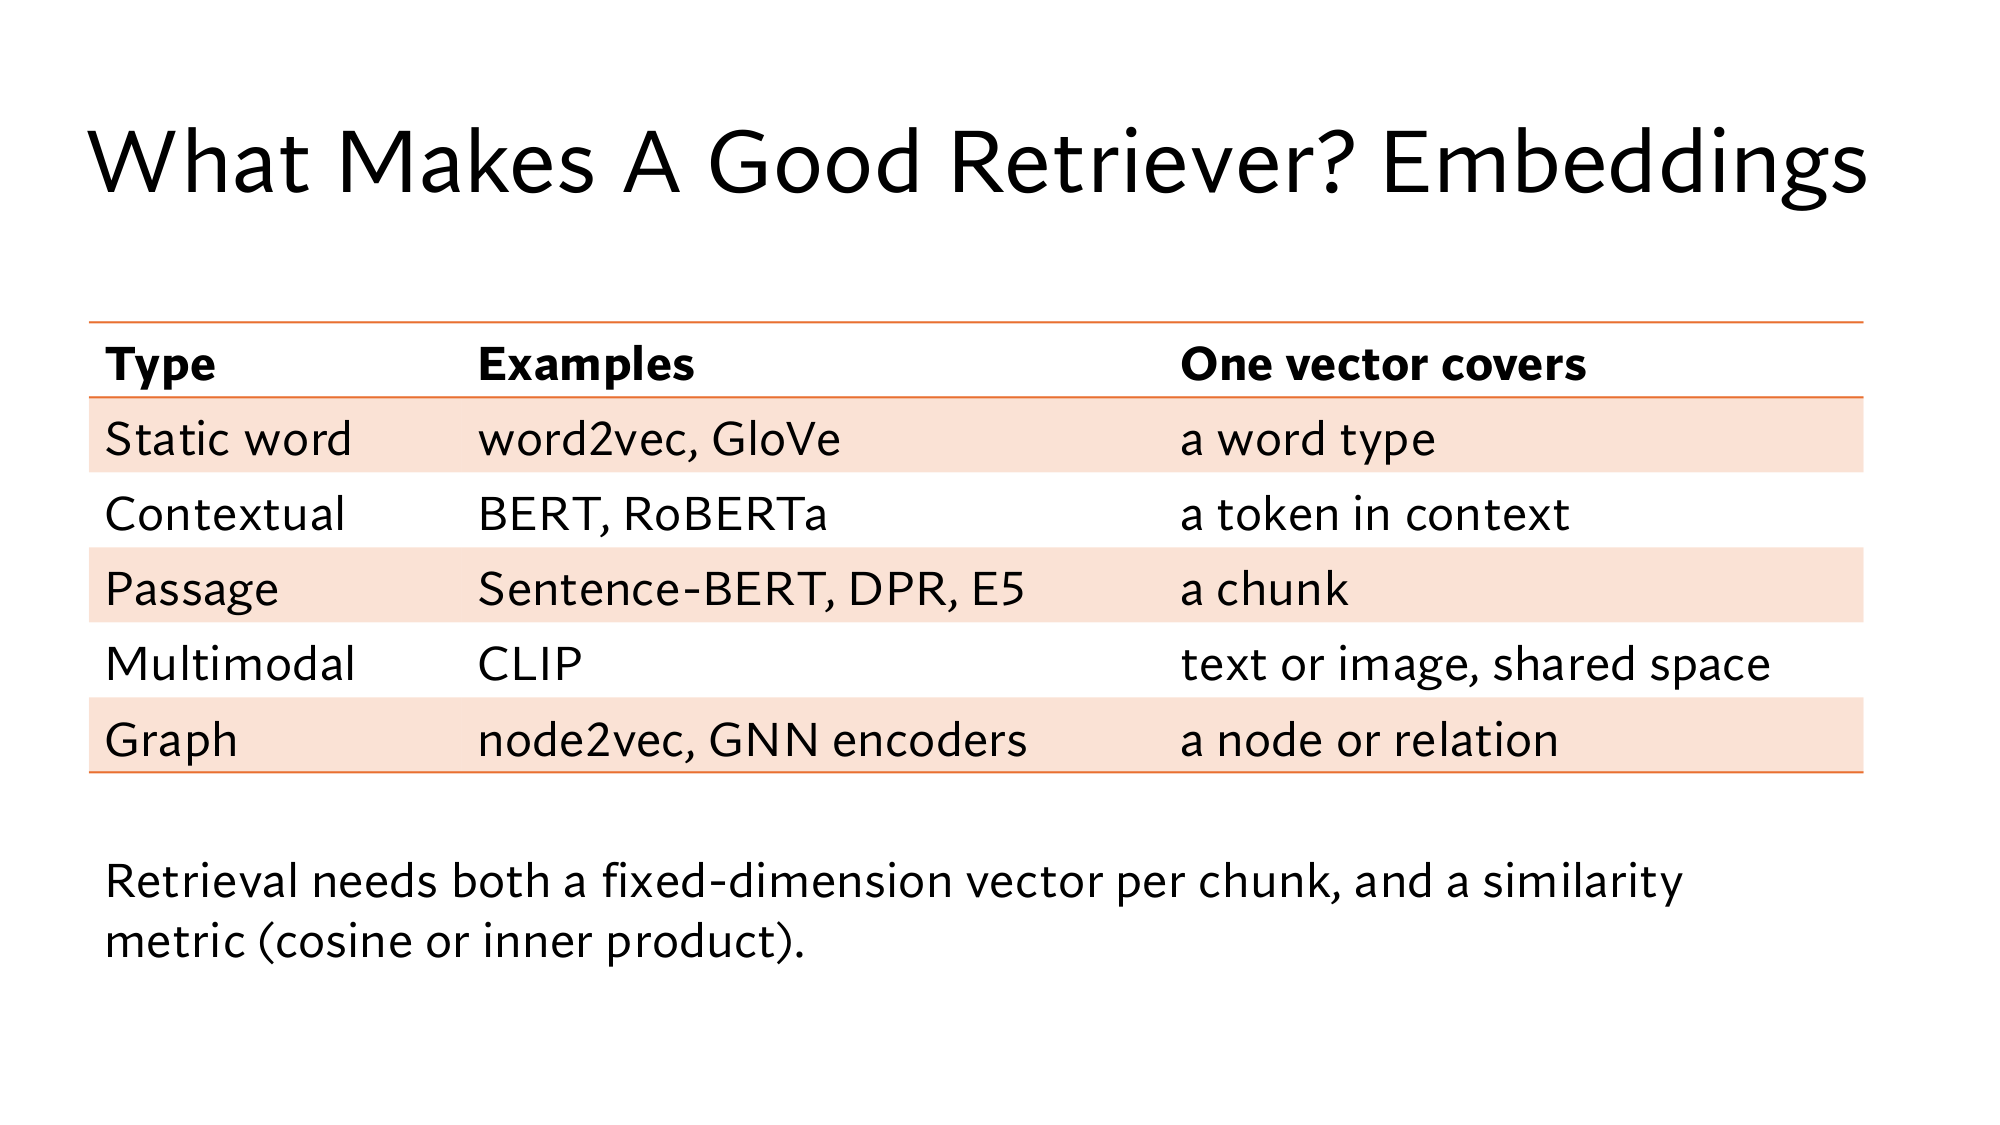
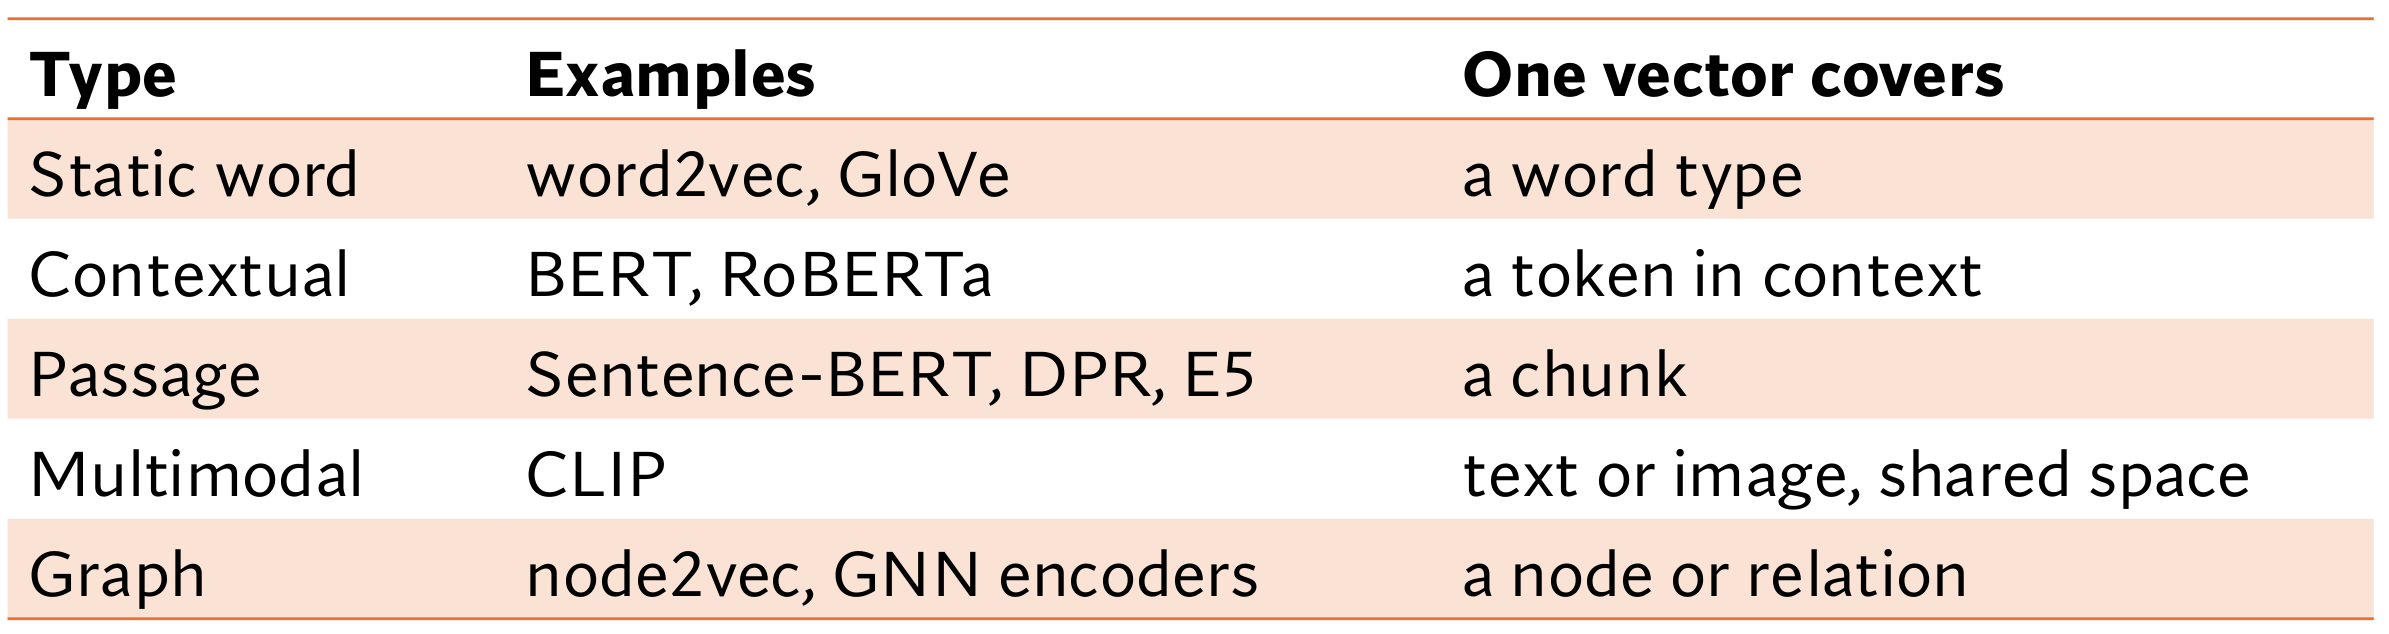
Stanford की embeddings वाली table पाँच तरह के embeddings गिनाती है, और उनका फ़र्क इस बात में है कि एक vector किस चीज़ का है। इनमें से retrieval सीधे passage वाले embeddings लेता है, क्योंकि index में हर chunk का एक vector चाहिए। बाकी किस्में दिखाती हैं कि एक vector किसी शब्द, token, image या node का भी हो सकता है। Lesson 7 इन्हें chunking के साथ फिर से लेता है।
किस्म
Examples
एक vector किसका
word2vec, GloVe
एक word type
BERT, RoBERTa
Context में एक token
Sentence-BERT, DPR, E5
एक chunk
CLIP
Text या image, एक shared space में
node2vec, GNN encoders
एक node या relation
Static word। हर का एक ही vector होता है, sentence कोई भी हो। Late days may not be applied और late afternoon office hours में late को एक ही vector मिलता है। word2vec paper ने दिखाया कि vector(King) − vector(Man) + vector(Woman) के सबसे पास vector(Queen) है। paper से
Contextual। हर token का vector उसके आस-पास के शब्दों से बनता है, इसलिए दोनों late को अलग vectors मिलते हैं। BERT-base हर token का 768 numbers वाला vector देता है। DPR पूरे passage के लिए [CLS] नाम के एक खास token का vector लेता है, जो हर text की शुरुआत में जुड़ता है। paper से
Passage। पूरे chunk का एक vector, यानी इस lesson वाला embedding। Sentence-BERT token vectors का औसत लेता है, जिसे कहते हैं। E5 एक ही encoder से query और passage दोनों पढ़ता है, और फ़र्क बताने के लिए text के आगे query: या passage: जोड़ता है। paper से
Multimodal। Text और image, दोनों के vectors एक ही space में बनते हैं, ताकि उनका cosine निकल सके। Whiteboard पर लिखे office hours की photo और text office hours schedule के vectors पास आ सकते हैं। CLIP internet से इकट्ठा 40 करोड़ (image, text) जोड़ों पर train हुआ, और image और text की तुलना cosine से करता है। paper से
Graph। किसी network के node या relation का vector, जैसे course के graph में TA, office hours और उनके बीच का runs वाला relation। node2vec graph पर random तरीके से चलकर nodes की lists बनाता है, और उन्हें sentences की तरह word2vec वाले Skip-gram तरीके से सीखता है। paper से GNN encoders भी हर node का vector बनाते हैं।
हर chunk का एक vector क्यों
Sentence-BERT paper इसका सबसे साफ़ हिसाब देता है। मान लीजिए 10,000 sentences में से सबसे मिलता-जुलता जोड़ा ढूँढना है, और model हर जोड़े को साथ पढ़ता है, जैसे BERT। तब जोड़ों की गिनती 10,000 × 9,999 ÷ 2 = 4,99,95,000 है, यानी करीब 5 करोड़। Paper के मुताबिक एक V100 GPU पर इसमें करीब 65 घंटे लगते हैं। paper से
हर sentence का एक vector हो, तो model सिर्फ़ 10,000 बार चलता है। Paper में इसमें करीब 5 seconds लगे, और फिर सारे cosine करीब 0.01 second में निकले। paper सेइसीलिए retrieval हर chunk का vector offline बनाकर रखता है, और query पर सिर्फ़ dot products या cosines निकालता है।
एक vector में rare error code क्यों दब जाता है
एक chunk का एक vector तेज़ है, लेकिन उसकी कीमत भी है। मान लीजिए passage का vector उसके 20 tokens के vectors का औसत है, यानी mean pooling। तब हर token औसत में सिर्फ़ 1/20 हिस्सा जोड़ता है। अब दो passages लीजिए, जो एक token छोड़कर एक जैसे हैं: एक में E-4012 लिखा है, और दूसरे में E-4021। numbers मेरे बनाए हैं
बाकी 19 tokens का औसत [0.5, 0.5] मानिए। E-4012 का vector [1, 0] है, और E-4021 का [0, 1], यानी दोनों codes का cosine 0 है।
दोनों codes बिल्कुल अलग दिशा में थे, फिर भी passages का cosine 0.995 है। इसलिए query E-4012 upload failed दोनों passages को लगभग बराबर score देगी। Lesson 11 का BM25 ऐसे rare code को ऊँचा देता है, इसलिए वो सही passage पकड़ लेता है।
DPR paper में इसका असली example है। सवाल Who plays Thoros of Myr in Game of Thrones? पर BM25 का पहला passage वो है, जिसमें Thoros of Myr हूबहू लिखा है, और साथ में उसे निभाने वाले actor का नाम। DPR का पहला passage एक Norwegian actor के बारे में है, जिसने Thor Heyerdahl का role किया था। Paper का अंदाज़ा है कि DPR के vector में कम दिखने वाले खास phrases के लिए जगह कम पड़ती है। paper से
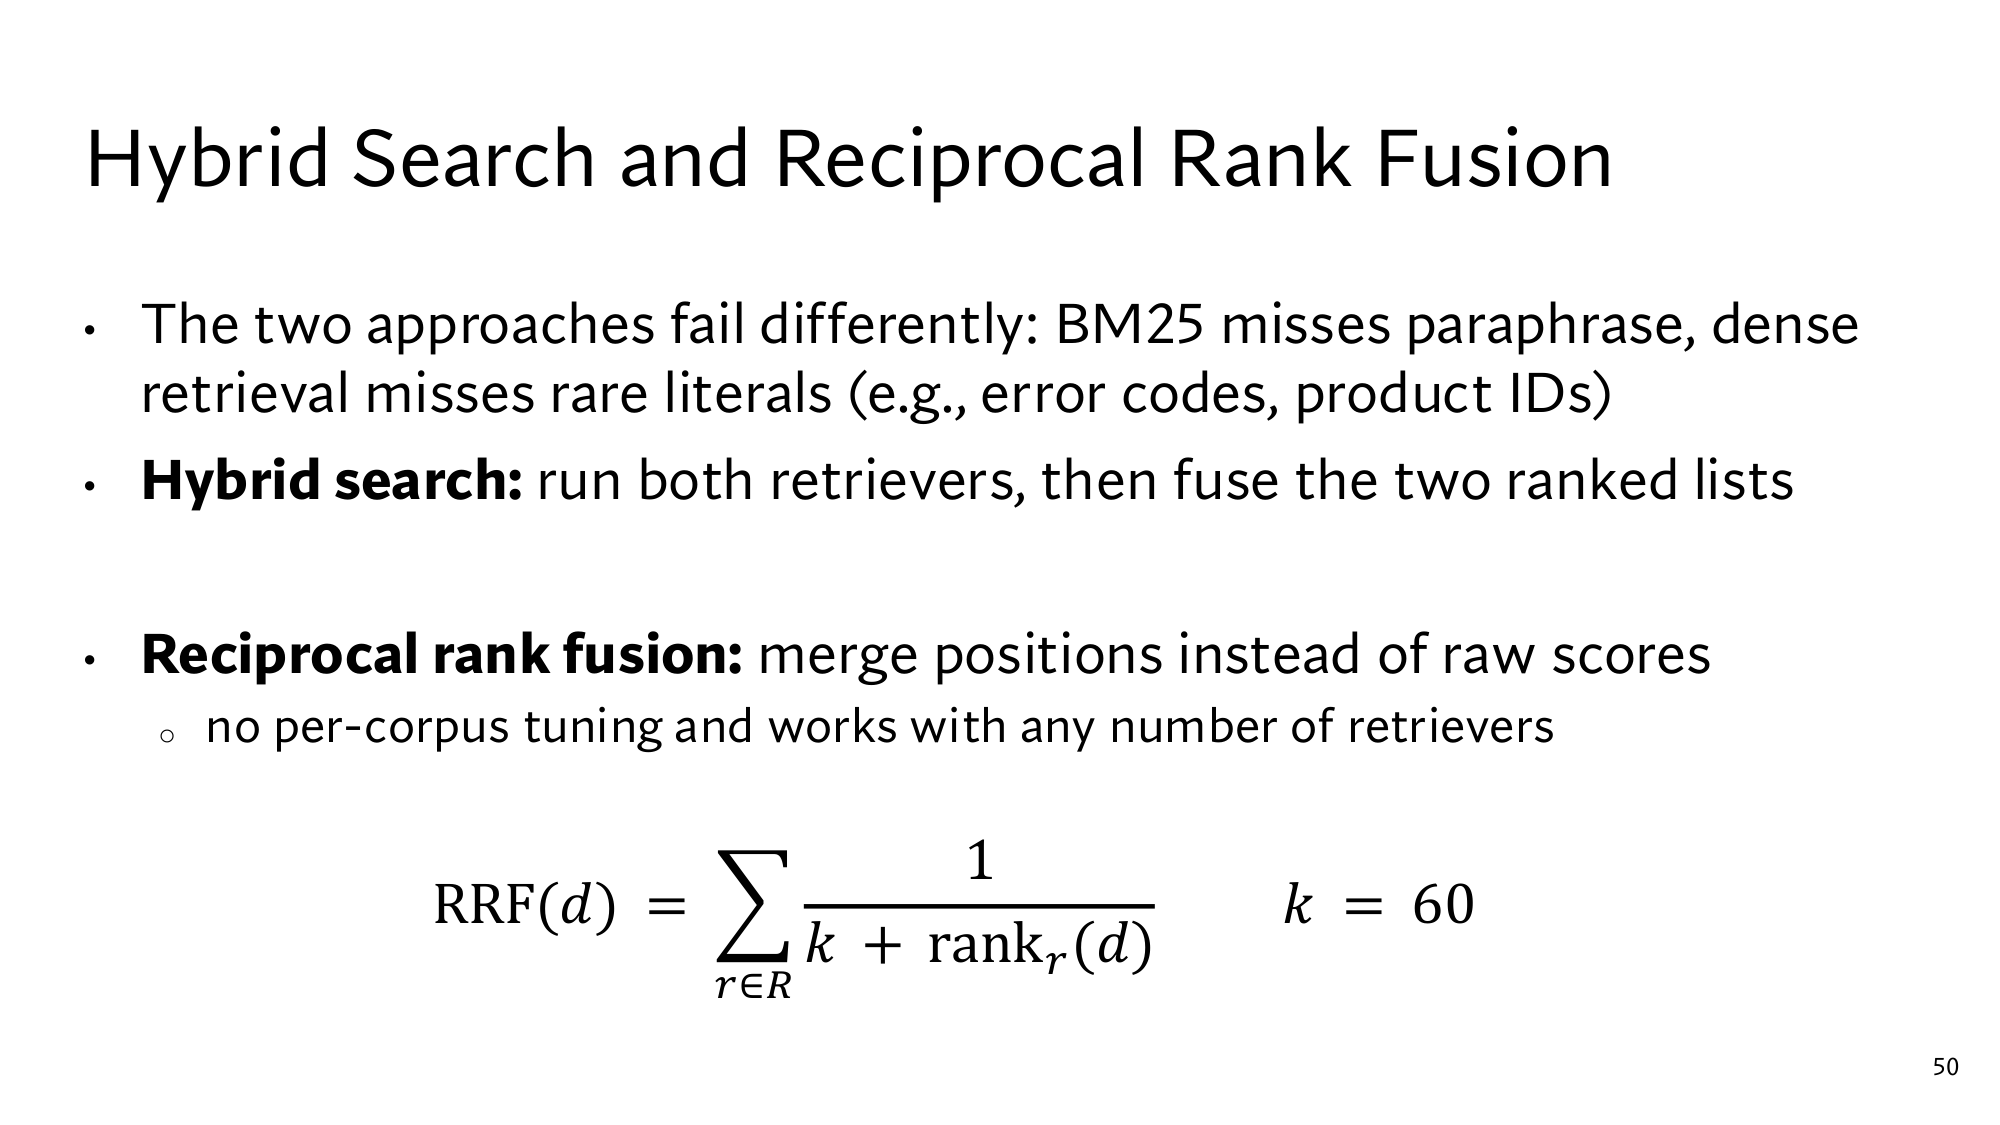
उल्टा example भी उसी paper में है। सवाल What is the body of water between England and Ireland? पर DPR Irish Sea वाला passage लाता है, जबकि BM25 एक cycling वाला passage, जिसमें England और Ireland कई बार लिखे हैं। paper से Stanford की hybrid search वाली slide का पहला point यही है। BM25 अलग शब्दों में कही बात चूकता है, और dense retrieval rare चूकता है। इसलिए lesson 14 दोनों retrievers चलाकर उनकी lists मिलाता है।
9अब Stanford की slides खुद पढ़िए
नीचे इस lesson की तीन Stanford slides हैं, बिना किसी बदलाव के। हर slide के नीचे कुछ सवाल हैं। पहले खुद जवाब सोचिए, फिर खोलिए। कोई symbol अटके, तो जवाब में लिखे पड़ाव पर लौट जाइए। Phone पर slide छोटी दिखे, तो image पर click कीजिए, वो पूरे size में खुलेगी।
Stanford की slide: What Makes A Good Retriever? Embeddings। नीचे उसकी table और आख़िरी line, बड़ी करके।
Embeddings वाली slide पढ़िए
Static word वाली row और passage वाली row में एक vector किसका है? Late वाले example से फ़र्क बताइए।
जवाब देखिए
Static word में हर word type का एक vector है, इसलिए दोनों sentences में late का vector एक है। Passage वाली row में पूरे chunk का एक vector है, और retrieval का index यही vectors रखता है। (पड़ाव 8)
आख़िरी line कहती है कि हर chunk का vector fixed-dimension हो। लंबे FAQ page के vector में कितने numbers हैं, और ये शर्त क्यों ज़रूरी है?
जवाब देखिए
हमारे example में 2, और DPR में 768, chunk कितना भी लंबा हो। Dot product numbers को जगह के हिसाब से जोड़ता है। Index की matrix में उतने ही columns चाहिए, जितने query के vector में numbers हैं। (पड़ाव 7)
Line में cosine or inner product है। हमारी TA वाली query पर दोनों में से कौन सा passage सबसे ऊपर आता है, और normalize करने पर क्या होगा?
जवाब देखिए
Inner product में FAQ page 1.56 के साथ, और cosine में office hours page 0.99 के साथ। Normalize किए vectors पर दोनों एक ही score देते हैं, इसलिए दोनों में office hours page ऊपर आता है। (पड़ाव 3 और 6)
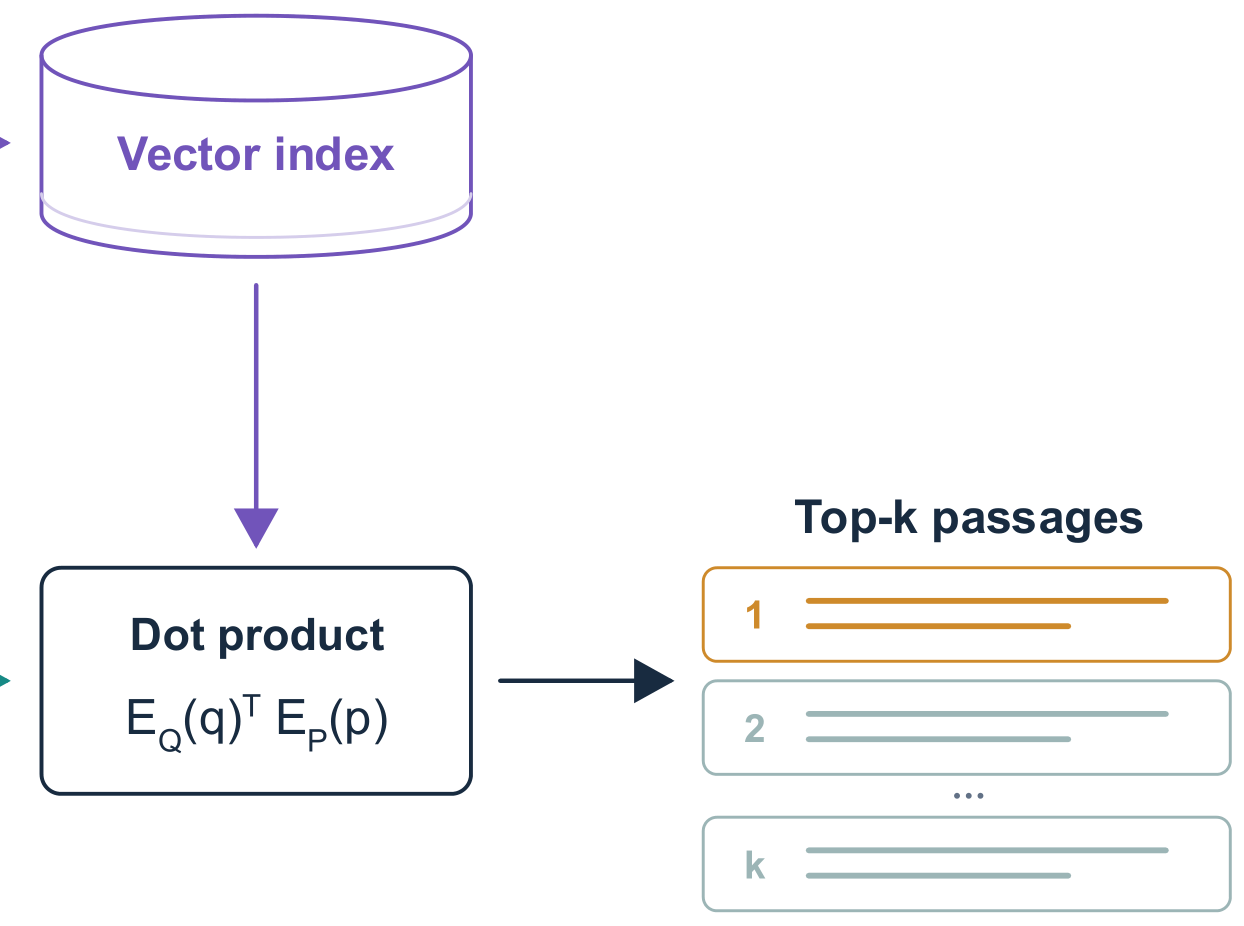
Stanford की slide: DPR, dense passage retrieval। नीचे उसका vector index, dot product और top-k वाला हिस्सा, बड़ा करके।
DPR वाली slide पढ़िए
Dot product वाले box का EQ(q)⊤EP(p) हमारी query और office hours page के numbers से लिखिए।
जवाब देखिए
Query का vector row बनता है, और passage का vector column: [0.8 0.2] × [0.9, 0.1] वाला column = 0.8 × 0.9 + 0.2 × 0.1 = 0.74। (पड़ाव 7)
Vector index में क्या रखा है, और उससे dot product वाले box तक आने वाला तीर एक query पर क्या करता है?
जवाब देखिए
Index सारे passage vectors की matrix है, जो offline बनी। Query आने पर एक matrix-vector गुणा सारे scores देता है: [0.74, 0.26, 0.32, 1.56]। Top-k इन्हीं में से सबसे बड़े k scores हैं, यानी k = 2 पर FAQ page और office hours page। (पड़ाव 4 और 7)
Slide score के लिए dot product लिखती है। DPR paper ने cosine या दूरी क्यों नहीं ली?
जवाब देखिए
तीनों decomposable हैं, इसलिए तीनों से offline index बन सकता था। Paper के experiments में L2 dot product के लगभग बराबर रहा, और दोनों cosine से बेहतर। NQ dev पर top-20 dot product के साथ 78.1% था, और L2 के साथ 76.1%, इसलिए सबसे सीधा dot product रहा। (पड़ाव 6)
Stanford की slide: Hybrid Search and Reciprocal Rank Fusion। नीचे उसका पहला point और formula, बड़े करके। Hybrid search और RRF पूरे lesson 14 में आते हैं।
Hybrid search वाली slide पढ़िए
पहला point कहता है कि dense retrieval rare literals चूकता है। E-4012 वाले example में दोनों passages का cosine कितना आया, और क्यों?
जवाब देखिए
0.995। Passage का vector 20 tokens का औसत था, इसलिए code वाला token उसमें सिर्फ़ 1/20 हिस्सा जोड़ता है। इसी वजह से दोनों codes का फ़र्क औसत में लगभग दब जाता है। (पड़ाव 8)
उसी point का दूसरा हिस्सा: BM25 misses paraphrase। इस lesson की कौन सी query इसका example है?
जवाब देखिए
TA वाली query। उसमें और office hours page में एक भी common शब्द नहीं है, इसलिए शब्दों पर चलने वाला score हर passage को 0 देता है। Embedding वाले retriever ने office hours page को 0.78 के साथ ऊपर रखा। (पड़ाव 4)
Slide कहती है: merge positions instead of raw scores। BM25 और cosine के scores सीधे क्यों नहीं जोड़ सकते? Formula में k = 60 पर, किसी list में पहली जगह वाले passage को कितना मिलता है?
जवाब देखिए
दोनों के पैमाने अलग हैं। Cosine कभी 1 से ऊपर नहीं जाता, जबकि lesson 11 में BM25 ने forum post को 2.749 दिया था। Dot product की भी कोई छत नहीं है। पहली जगह वाले passage को 1 ÷ (60 + 1) = 0.0164 मिलता है। RRF का पूरा हिसाब lesson 14 में है। (पड़ाव 5 और 8)
इस lesson की 3 बातें
Vector numbers की तय लंबाई वाली list है, और दो vectors की तुलना dot product या cosine similarity से होती है। Cosine दोनों तीरों के बीच के कोण का cosine है, इसलिए वो −1 और 1 के बीच रहता है।
Dot product लंबे vector को फ़ायदा देता है, जैसे FAQ page को 1.56। Cosine length को छोड़ देता है, और दूरी लंबे vector को नुकसान देती है। Normalize किए vectors पर तीनों एक ही क्रम देते हैं, और DPR ने dot product रखा।
Index एक matrix है, और एक matrix-vector गुणा हर passage का score देता है। हर chunk का एक vector search को तेज़ बनाता है, लेकिन उसमें rare error code दब सकता है। इसलिए lesson 14 BM25 और dense retrieval को मिलाता है।
इस lesson के नए शब्द
Vector
तय लंबाई वाली numbers की list, जैसे [0.9, 0.1]। 2 numbers हों, तो plane पर एक तीर।
Dimension
Vector में कितने numbers हैं। जैसे [0.9, 0.1] का dimension 2 है, और BERT-base के vectors का 768।
Dot product (inner product)
एक ही जगह वाले numbers का गुणा, फिर सबका जोड़। जैसे [0.8, 0.2] और [0.9, 0.1]: 0.72 + 0.02 = 0.74।
∑ (sigma)
नीचे लिखी range पर जोड़ते जाइए। जैसे i = 1 से 2 तक aibi का जोड़, यानी a1b1 + a2b2।
Length
तीर की लंबाई: हर number का square, उनका जोड़, फिर square root। जैसे [0.8, 0.2] की length √(0.64 + 0.04) = 0.82।
Cosine similarity
Dot product ÷ दोनों lengths का गुणा। सिर्फ़ दिशा देखता है, −1 से 1 के बीच। जैसे 0.74 ÷ (0.82 × 0.91) = 0.99।
Normalize
Vector के हर number को उसकी length से भाग देकर length 1 बनाना। दिशा वही रहती है। जैसे [0.8, 0.2] ÷ 0.82 = [0.97, 0.24]।
Embedding
Trained model से बना text का vector। मिलती-जुलती बात वाले texts की दिशा मिलती-जुलती होती है, जैसे “help from a TA” और “run by the TAs”।
Embedding model (encoder)
Text पढ़कर तय लंबाई का embedding बनाने वाला model। जैसे query को [0.8, 0.2] जैसा vector देना।
Index
Passages के पहले से बनाकर रखे embeddings की list। जैसे 60,000 passages के 60,000 vectors।
Offline और online
Offline: query आने से पहले, एक बार, जैसे passages के embeddings बनाना। Online: हर query पर, जैसे query का embedding।
Matrix और matrix-vector गुणा
Rows और columns वाली numbers की table, और उसकी हर row का किसी vector से dot product। जैसे हमारा 4 × 2 index गुणा query [0.8, 0.2] = [0.74, 0.26, 0.32, 1.56]।
Decomposable similarity
ऐसा score, जो सवाल के vector और passage के vector से निकले, और passage का vector सवाल देखे बिना बने। तभी offline index बन सकता है। जैसे dot product, cosine और दूरी।