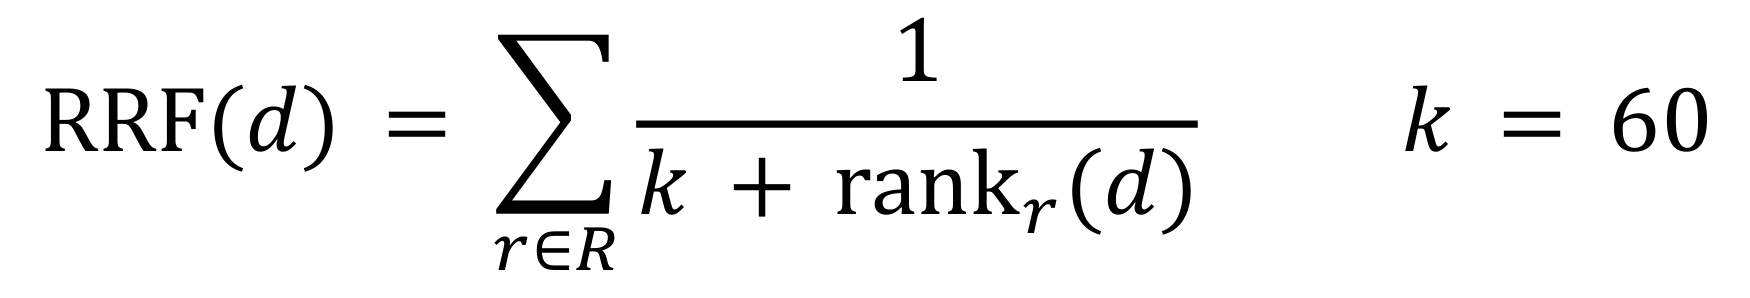Hybrid search दो retrievers की ranked lists को मिलाकर एक list बनाता है। Reranking उस list के ऊपर वाले passages को एक धीमे लेकिन ज़्यादा सटीक model से दोबारा sort करता है।
BM25 ने E2 को तीसरे rank पर रखा, dense ने पहले। Query थी E-4012 upload failed, और उसके दो सही passages हैं। E1 में यही error code हूबहू लिखा है, और E2 में वही बात अलग शब्दों में। Lesson 12 इसी बात पर ख़त्म हुआ था कि की ताकत और कमज़ोरी dense retriever से उल्टी है।
इस lesson की सीढ़ी
सीढ़ी में 10 पड़ाव हैं। पहले 5 आसान version जैसे ही हैं, और 6 से 10 आपको Stanford की slides के level तक ले जाते हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
पहले से क्या चाहिए: Lesson 3 (embedding, cosine), Lesson 6 (fusion, rerank), Lesson 11 (BM25), Lesson 12 (bi-encoder, DPR) और Lesson 13 (MRR)। पड़ाव 6 से आगे Lesson 4 (softmax, ln, loss) और lesson 11 का hyperparameter भी काम आते हैं। Lesson 12 के in-batch negatives और DPR की पूरी table भी वहाँ आती हैं। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1BM25 और dense retriever अलग-अलग passages चूकते हैं
BM25 और dense retriever अलग तरह के text पर चूकते हैं, इसलिए एक ही query पर दोनों अलग सही passages छोड़ते हैं। BM25 एक जैसे शब्द गिनता है, और dense retriever, जैसे , दोनों के की तुलना करता है।
BM25 तब चूकता है, जब passage वही बात दूसरे शब्दों में कहे, और इसे paraphrase कहते हैं। जैसे query में upload failed है, और passage में upload keeps failing। BM25 के लिए failing और failed अलग शब्द हैं, इसलिए उसे सिर्फ़ upload मिलता है।
Dense retriever तब चूकता है, जब कोई चीज़ हूबहू मिलनी चाहिए, जैसे error code या order ID। ऐसे text को literal कहते हैं। Lesson 3 में दिखा था कि E-4012 और E-4021 वाले passages के embeddings लगभग एक जैसे हो सकते हैं। BM25 के लिए 4012 एक rare शब्द है, जिसका IDF ऊँचा है, इसलिए वो सही passage पकड़ लेता है।
अब तीन passages पर दोनों retrievers का क्रम देखिए: मेरा example
Passage
सही?
BM25
Dense
E1, error code वालाError E-4012: file larger than 50 MB. Compress the file and upload again.
हाँ
Rank 14012 हूबहू मिला
Rank 2
E2, अलग शब्दों वालाIf your upload keeps failing on Gradescope, make the file smaller before submitting.
हाँ
Rank 3सिर्फ़ upload मिला
Rank 1vector सबसे पास
E3, दूसरे error वालाError E-4021: submission locked after the deadline.
नहीं
Rank 2E- वाला code, छोटा passage
Rank 3
Top-1 पर BM25 सिर्फ़ E1 लाता है, और dense सिर्फ़ E2। दोनों अलग-अलग सही passage चूकते हैं, इसलिए दोनों की lists मिलाने पर दोनों सही passages ऊपर आ सकते हैं।
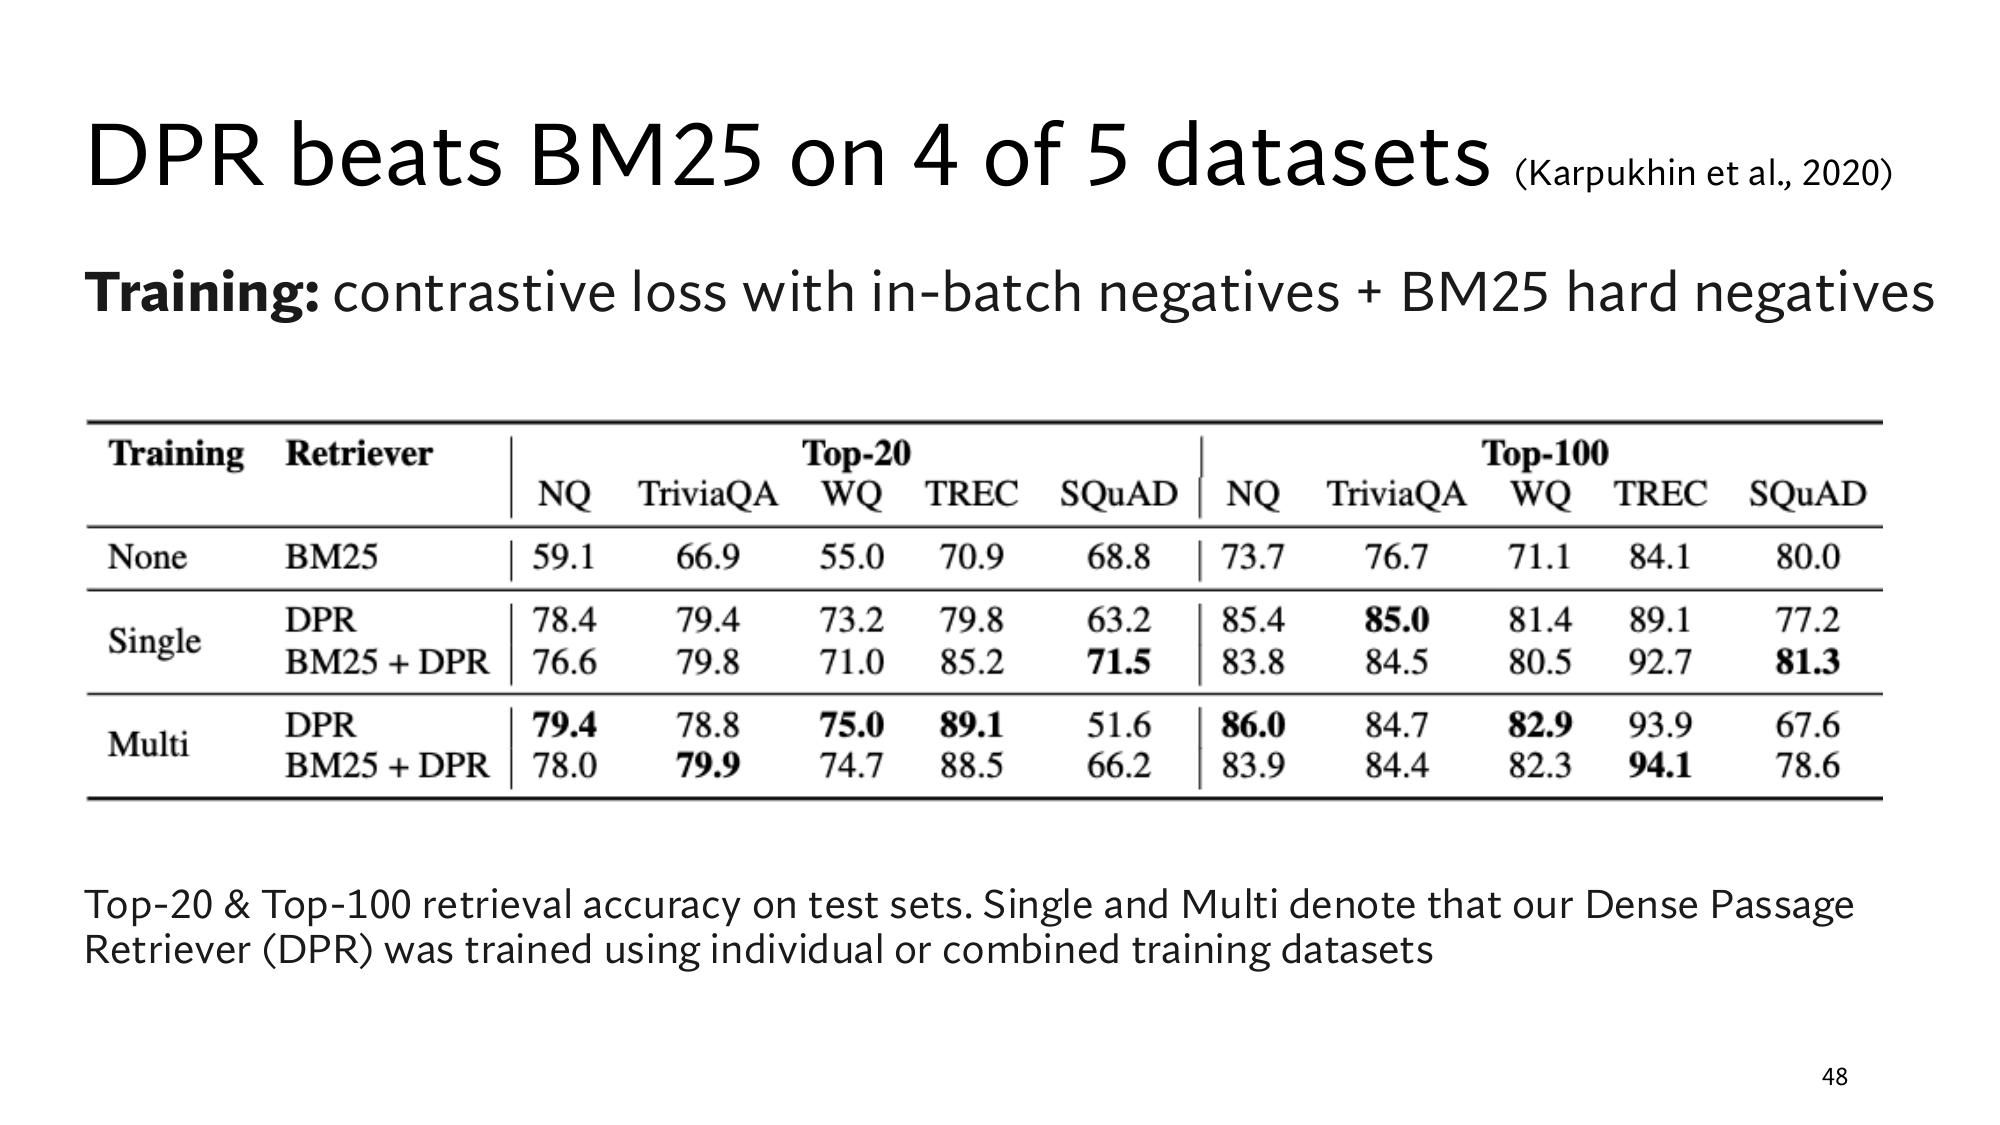
असली data पर भी यही दिखता है। Lesson 12 में SQuAD पर top-20 accuracy BM25 की 68.8% थी, और DPR की 63.2%। उसी Stanford slide पर दोनों को मिलाकर बना retriever 71.5% पर है, यानी दोनों से आगे।
पहले सोचिए
Query है refund policy for order #A77-310। इसका कौन सा हिस्सा BM25 पकड़ेगा, और कौन सा dense retriever?
जवाब देखिए
BM25 rare literal A77-310 को हूबहू पकड़ेगा। Dense retriever refund policy को money back rules वाले passage से भी मिला सकता है, जिसमें एक भी शब्द एक जैसा नहीं है।
2Hybrid search, और scores का सीधा जोड़
Hybrid search दोनों retrievers चलाता है, और उनकी दो ranked lists को मिलाकर एक list बनाता है। Lists मिलाने को lesson 6 में कहा था। सबसे सीधा तरीका ये है कि हर passage के दोनों scores जोड़ दें: BM25 का score, और dense retriever का । scores मेरे बनाए हैं
पहले सोचिए
E1, E3 और E2 के BM25 scores 7.2, 3.1 और 1.0 हैं, और cosine 0.79, 0.75 और 0.82। दोनों जोड़ें, तो dense का पहला passage E2 किस rank पर आएगा?
जवाब देखिए
तीसरे rank पर, सबसे नीचे। हिसाब नीचे की table में है।
Passage
BM25 score
Cosine
सीधा जोड़
E1
7.2
0.79
7.99
E3 (गलत)
3.1
0.75
3.85
E2
1.0
0.82
1.82
जोड़ के बाद क्रम E1, E3, E2 है, यानी ठीक BM25 वाला। इसकी वजह दोनों scores का पैमाना है। Cosine 0.75 से 0.82 तक फैला है, यानी सिर्फ़ 0.07, और BM25 1.0 से 7.2 तक, यानी 6.2।
BM25 का फैलाव cosine से करीब 90 गुना है, इसलिए जोड़ में cosine का असर लगभग गायब हो जाता है। Cosine हमेशा −1 और 1 के बीच रहता है, जबकि BM25 की कोई ऊपरी हद नहीं है। BM25 को किसी number से भाग दे सकते हैं, लेकिन वो number हर corpus पर अलग होगा, और उसे हर बार ढूँढना पड़ेगा।
3Reciprocal rank fusion: scores की जगह ranks मिलाना
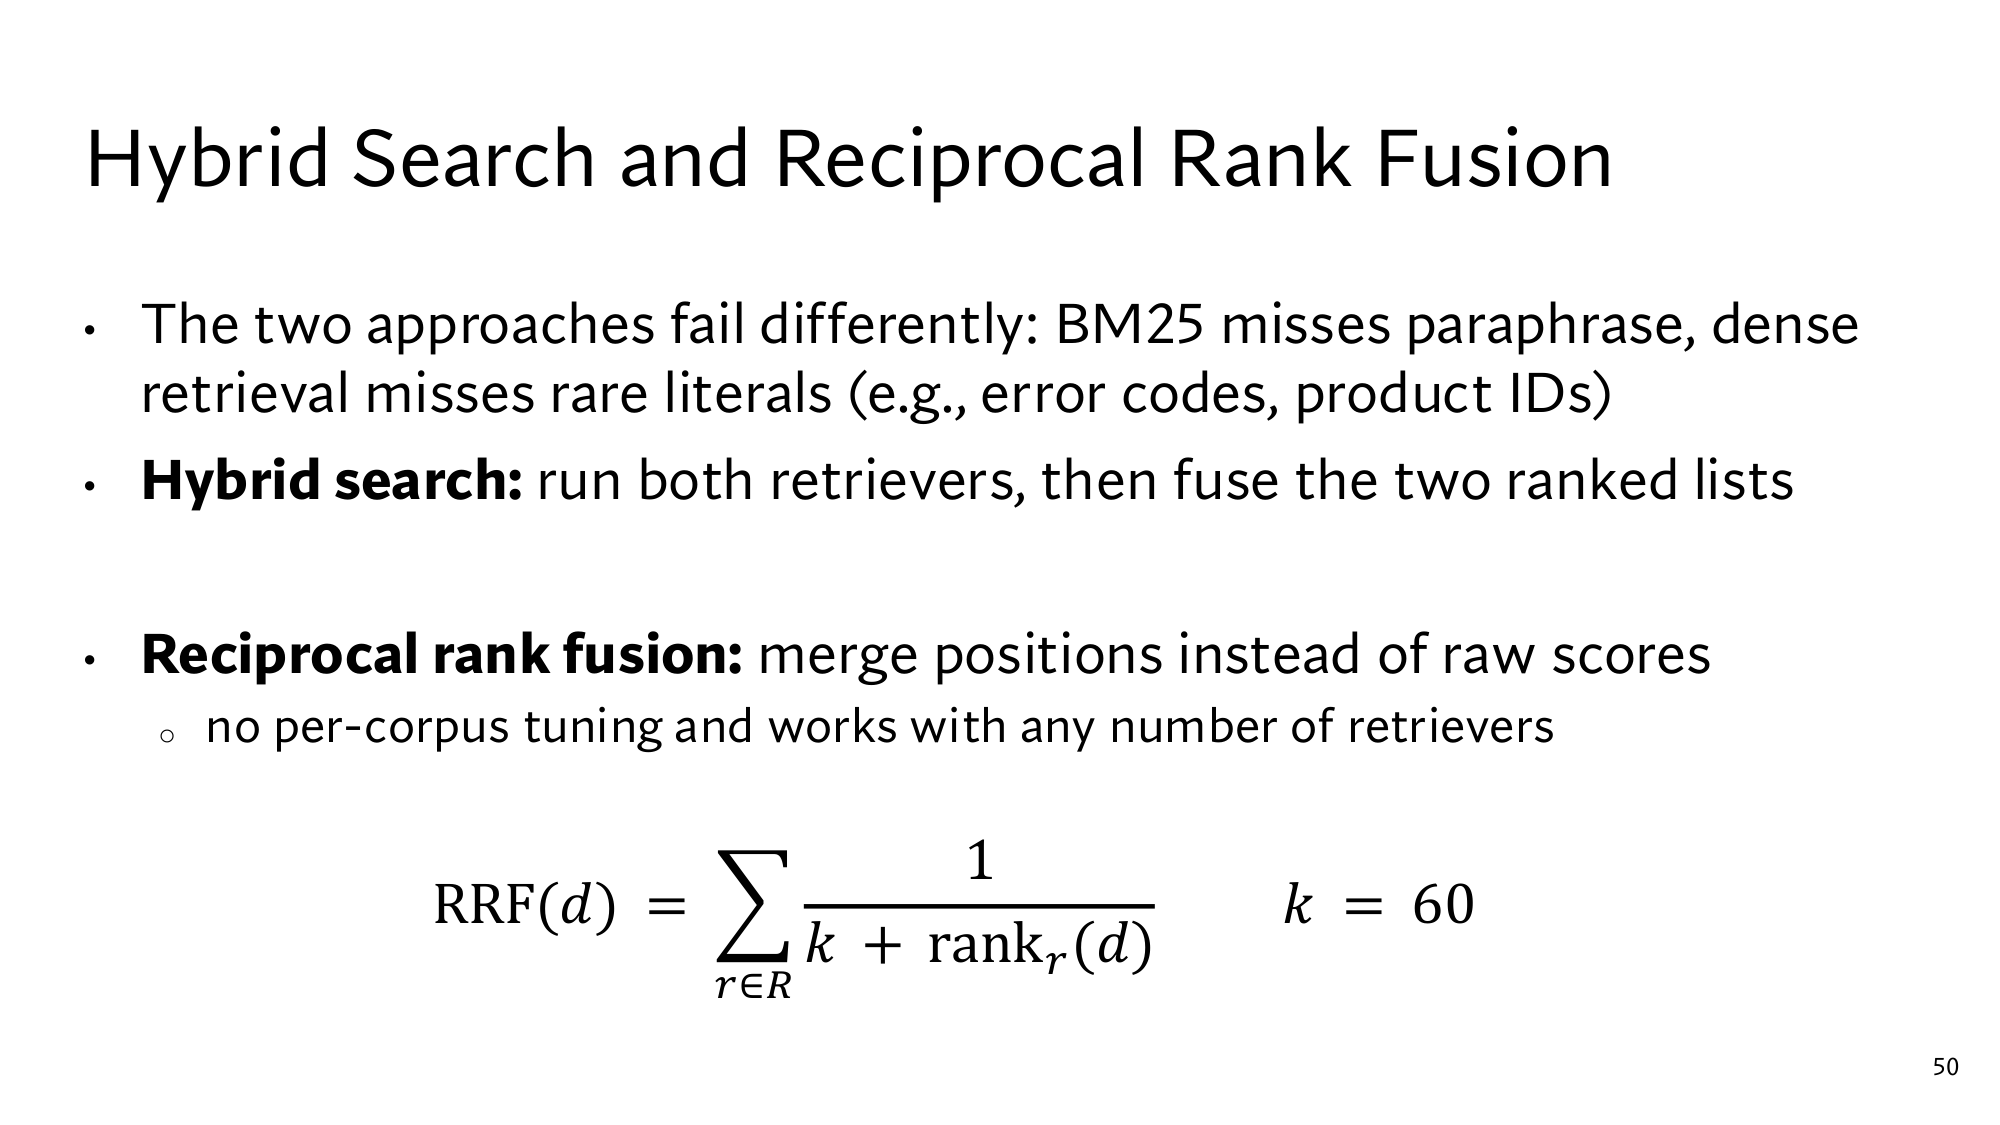
Scores के पैमाने अलग हैं, लेकिन ranks का पैमाना हर retriever में एक है: पहला, दूसरा, तीसरा। Reciprocal rank fusion, यानी RRF, हर list में passage के rank से 1 ÷ (60 + rank) बनाता है, और सारी lists के ये numbers जोड़ता है। फिर passages इसी जोड़ के क्रम में लगते हैं।
E1 BM25 की list में rank 1 पर है, तो उसे 1 ÷ (60 + 1) = 1 ÷ 61 = 0.01639 मिलता है, यानी करीब 0.0164। Dense की list में वो rank 2 पर है, तो 1 ÷ 62 = 0.01613। E1 का RRF इनका जोड़ है: 0.01639 + 0.01613 = 0.03252।
Passage
BM25 से
Dense से
जोड़
E1
1 ÷ (60 + 1) = 0.01639
1 ÷ (60 + 2) = 0.01613
0.03252
E2
1 ÷ (60 + 3) = 0.01587
1 ÷ (60 + 1) = 0.01639
0.03227
E3 (गलत)
1 ÷ (60 + 2) = 0.01613
1 ÷ (60 + 3) = 0.01587
0.03200
नया क्रम E1, E2, E3 है। दोनों सही passages ऊपर आ गए, और E3 नीचे गया, क्योंकि वो किसी list में सबसे ऊपर नहीं था।
तीनों जोड़ पास-पास हैं, और इसकी वजह fraction का बर्ताव है। 1 ÷ (60 + rank) का नीचे वाला हिस्सा बढ़े, तो fraction घटता है। लेकिन 61 से 62 होने पर नीचे वाला हिस्सा सिर्फ़ 1.6% बढ़ता है, इसलिए fraction भी करीब 1.6% ही घटता है। इसलिए RRF के numbers पास-पास रहते हैं, और उनमें सिर्फ़ क्रम काम का है।
Stanford की slide यही हिसाब एक formula में लिखती है:
RRF(d) = ∑r ∈ R1k + rankr(d), k = 60
d
एक passage, जैसे E1।
R
Retrievers का set, यहाँ {BM25, dense}। के नीचे r ∈ R का मतलब है: R के हर retriever r का जोड़।
rankr(d)
Retriever r की list में d का rank। E1 के लिए BM25 में 1, और dense में 2। जिस list में d नहीं है, वहाँ से कुछ नहीं जुड़ता।
k
एक तय number, 60। ये top-k वाला k नहीं है।
Stanford की slide: Hybrid Search and Reciprocal Rank Fusion। पहली line पड़ाव 1 है, दूसरी पड़ाव 2, और नीचे RRF का formula। छोटी line कहती है कि RRF को हर corpus पर tuning नहीं चाहिए, और वो कितने भी retrievers के साथ चलता है। Image पर click करने से वो पूरे size में खुलती है।
k = 60 का काम
k = 60 rank 1 और rank 2 का फ़र्क छोटा कर देता है, इसलिए किसी एक list का rank 1 अकेले फ़ैसला नहीं करता। k = 0 पर rank 1 को 1 मिलता, और rank 2 को 0.5, यानी आधा। k = 60 पर दोनों को 0.01639 और 0.01613 मिलते हैं।
मान लीजिए passage A सिर्फ़ BM25 की list में है, rank 1 पर, और B दोनों lists में rank 3 पर: मेरा example
k = 0 पर A को 1 ÷ 1 = 1 मिलता है, और B को 1 ÷ 3 + 1 ÷ 3 = 0.667। A जीतता है।
k = 60 पर A को 1 ÷ 61 = 0.0164 मिलता है, और B को 1 ÷ 63 + 1 ÷ 63 = 0.0317। B जीतता है।
मतलब k = 60 पर वो passage जीतता है, जिसे दोनों retrievers ऊपर के आस-पास रखते हैं।
k खुद बदलिए
A एक list में rank 1 पर है, और B दोनों lists में rank r पर। k और r बदलकर देखिए कि B कब तक आगे रहता है।
Passage
हिसाब
RRF
पहले सोचिए
Lesson 6 में original query की list थी: queue log, forum post, office hours page। Rewrite की हुई query की list थी: office hours page, queue log। RRF से क्रम क्या बनता है?
जवाब देखिए
Queue log: 1 ÷ 61 + 1 ÷ 62 = 0.03252। Office hours page: 1 ÷ 63 + 1 ÷ 61 = 0.03227। Forum post सिर्फ़ पहली list में है: 1 ÷ 62 = 0.01613। क्रम queue log, office hours page, forum post है।
RRF की कीमत ये है कि वो score की ताकत भूल जाता है। E1 का BM25 score 7.2 हो या 70, rank 1 दोनों बार 1 ÷ 61 ही देता है।
4Cross-encoder: query और passage को साथ पढ़ना
RRF की list में E1 और E2 सिर्फ़ इसलिए ऊपर हैं कि दोनों retrievers सहमत थे। किसी ने query और passage को साथ नहीं पढ़ा। में passage का vector सवाल आने से पहले बन जाता है, और दोनों सिर्फ़ आख़िरी dot product पर मिलते हैं।
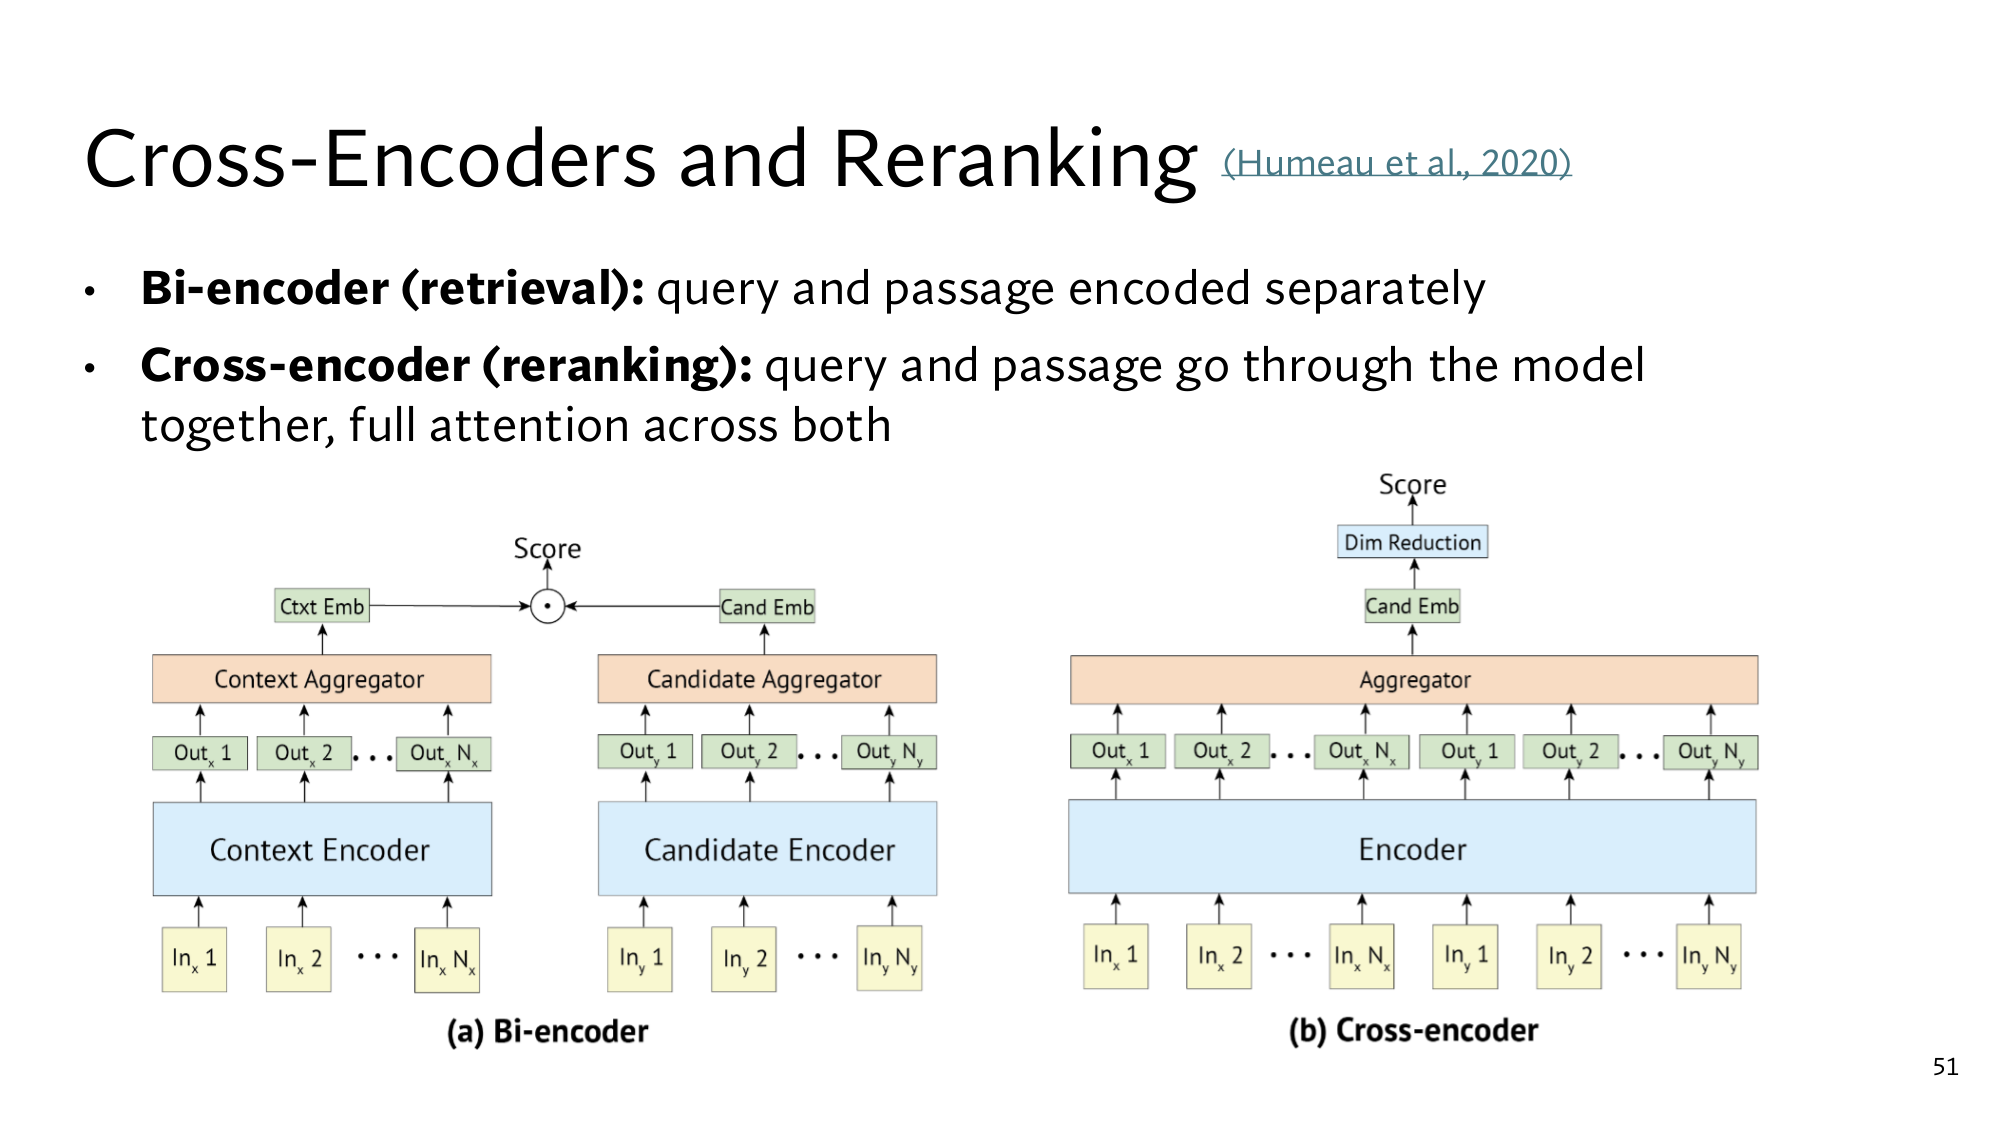
Cross-encoder query और passage को जोड़कर एक ही text की तरह एक model में डालता है, और उस जोड़ी का सीधा एक score देता है। ये model आम तौर पर जैसा encoder होता है।
Attention: हर token दूसरे tokens से अपना vector बदलता है
Encoder हर का एक vector बनाता है, और फिर उसे कई बार बदलता है। Attention में हर token बाकी tokens के vectors का वज़न वाला औसत लेकर अपना नया vector बनाता है। वज़न वाले औसत में हर vector को उसके वज़न से गुणा करके जोड़ते हैं, और वज़नों का जोड़ 1 होता है।
Cross-encoder में query के tokens passage के tokens को भी देखते हैं, और Stanford की slide इसे full attention across both कहती है। नीचे हर vector में 2 numbers हैं: पहला बताता है कि token गिनती वाले data की तरफ़ कितना है, और दूसरा राय की तरफ़ कितना। numbers मेरे बनाए हैं
Query का token crowded शुरू में [0.5, 0.5] है। Query को queue log के साथ जोड़ें, तो crowded 0.6 वज़न queue log के averaged [1.0, 0.0] को देता है, और 0.4 खुद को:
Forum post के साथ वही 0.6 वज़न usually [0.0, 1.0] को जाता है, और crowded [0.2, 0.8] बनता है। मतलब query के उसी token का vector हर passage के साथ अलग बनता है। Bi-encoder में attention सिर्फ़ query के अंदर चलता है, इसलिए वहाँ crowded का vector हर passage के लिए एक ही रहता है।
आख़िर में model पूरी जोड़ी की बात एक vector में समेटकर एक score बनाता है। Lesson 6 के reranker ने least crowded वाले सवाल पर queue log को 0.92 दिया, office hours page को 0.41, और forum post को 0.35। Retriever ने queue log और forum post को बराबर 2 दिया था। lesson 6 के मेरे बनाए scores
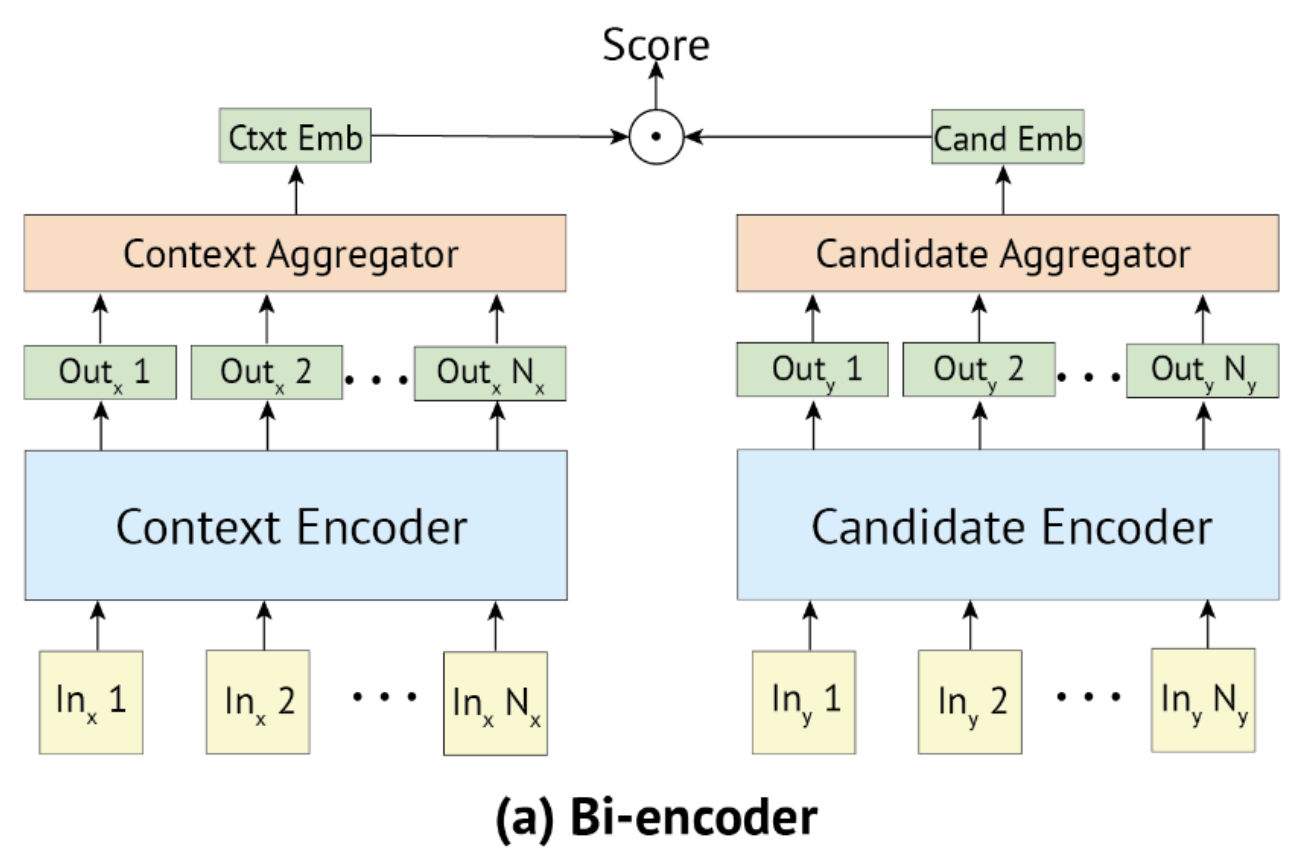
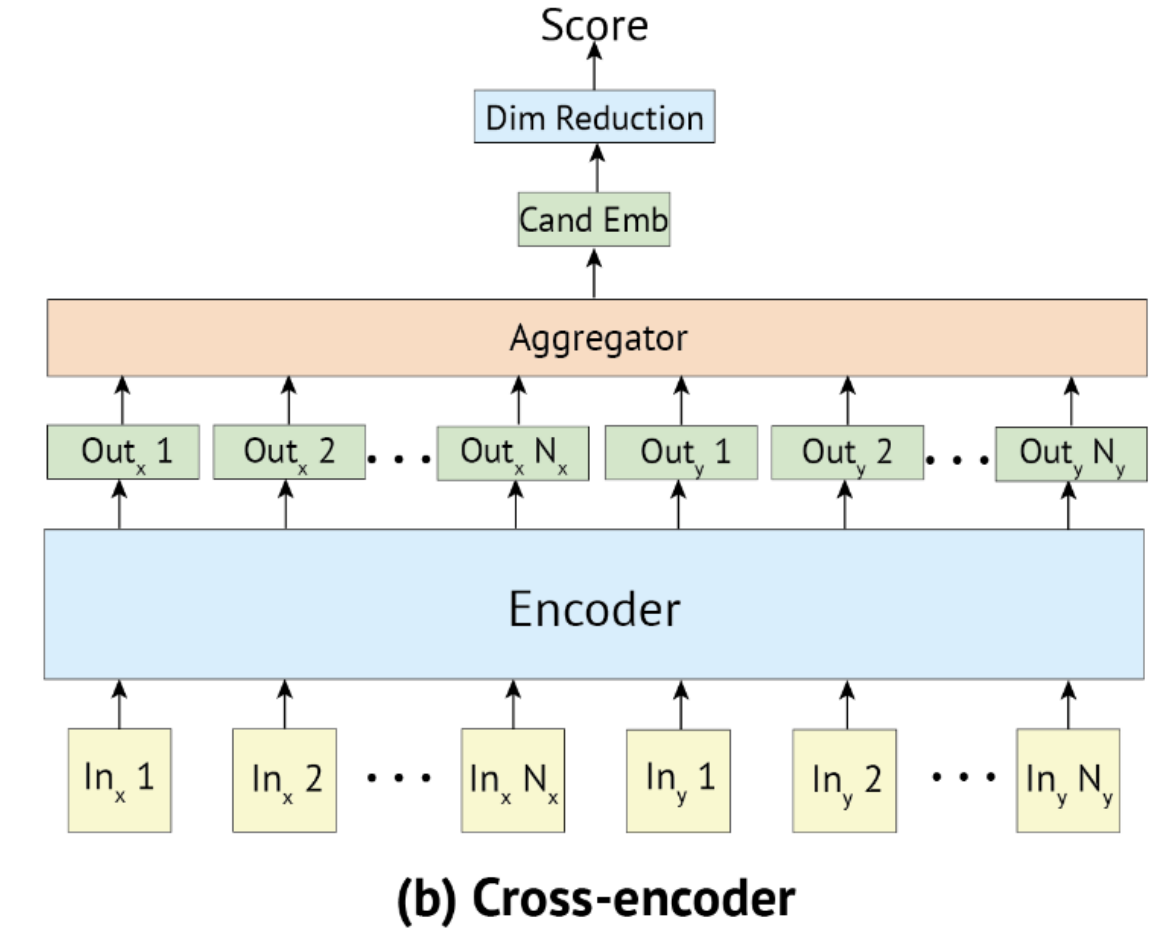
Stanford की slide: Cross-Encoders and Reranking। बाईं तरफ़ bi-encoder में query (Inx) और passage (Iny) अलग encoders से गुज़रते हैं। दाईं तरफ़ cross-encoder में दोनों एक ही Encoder में साथ जाते हैं।
कीमत: पहले से कुछ नहीं बन सकता
Cross-encoder का हर vector query पर टिका है, इसलिए passage का कुछ भी सवाल आने से पहले नहीं बन सकता। हर query पर उसे हर passage के साथ पूरा model चलाना पड़ता है, जबकि bi-encoder में model हर query पर 1 बार चलता था।
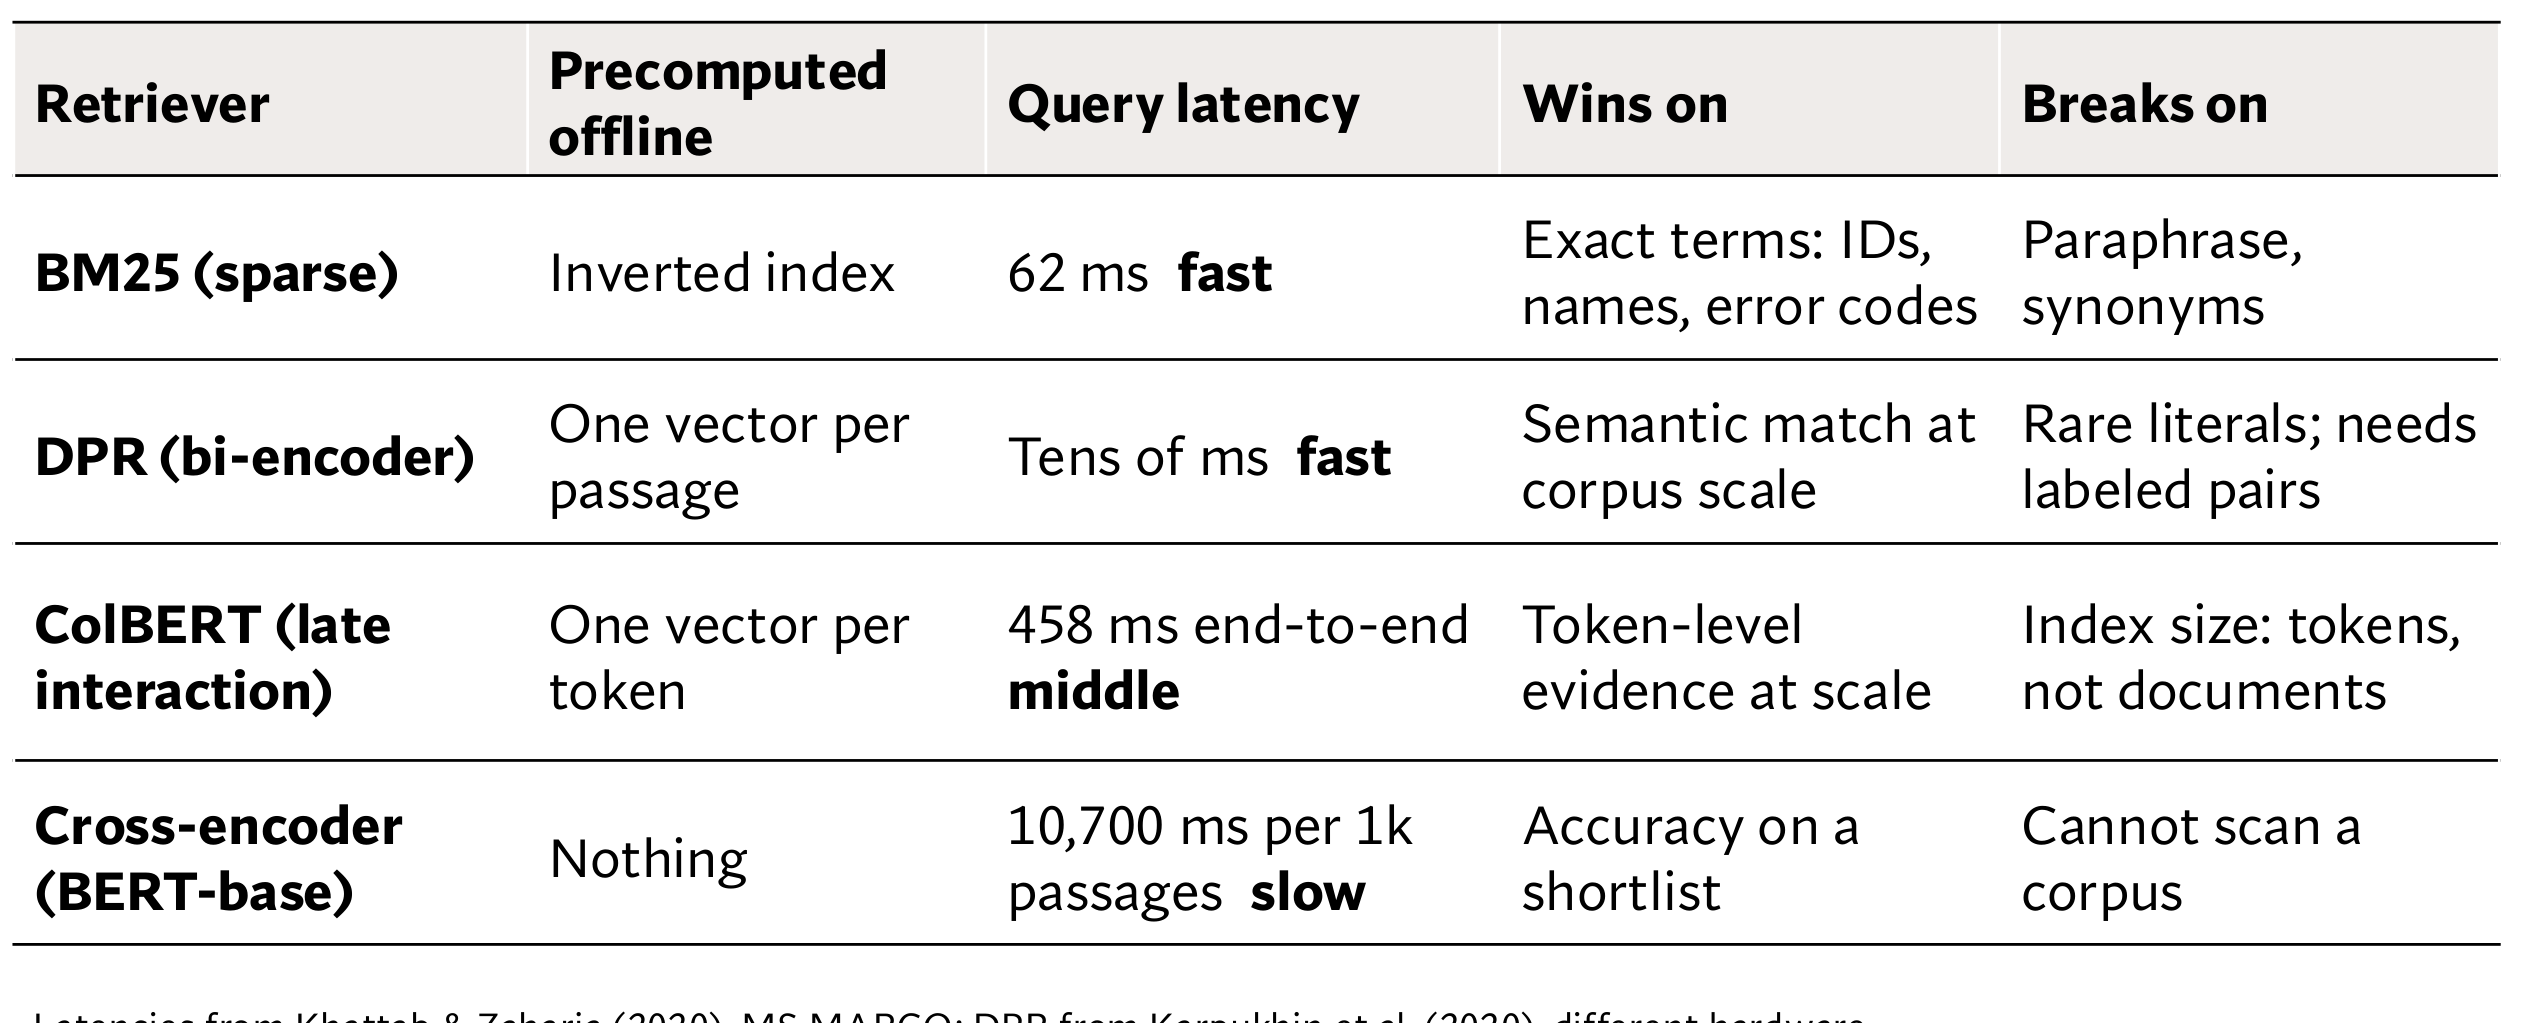
Stanford की slide के मुताबिक BERT-base वाला cross-encoder 1,000 passages पर 10,700 ms लेता है, यानी एक passage पर 10.7 ms। BERT-base, BERT का छोटा version है। Lesson 2 की company के 60,000 passages पर एक query के 60,000 × 10.7 ms = 642 seconds लगेंगे, यानी करीब 11 minute।
5Shortlist पर reranking
Retriever तेज़ है लेकिन passage को मोटे तौर पर देखता है, और cross-encoder सटीक है लेकिन धीमा। इसलिए पहले तेज़ retriever ऊपर के कुछ passages निकालता है, जैसे top-100, और फिर cross-encoder सिर्फ़ उन्हीं को दोबारा score देकर sort करता है। इस छोटी list को shortlist कहते हैं, और दूसरे step को reranking।
Step
किस पर
समय
1. BM25 और dense, फिर RRF
पूरा corpus
BM25 62 msdense दसियों ms, Stanford की slide से
2. Cross-encoder से reranking
Top-100 shortlist
100 × 10.7 = 1,070 ms
3. LLM के prompt में
Rerank के बाद top-5
–
पूरे corpus पर 642 seconds लगते, और shortlist पर करीब 1 second। Accuracy का फ़ायदा Stanford की एक table दिखाती है। उसका data MS MARCO है: Bing search के असली सवाल, और करीब 88 लाख passages। MS MARCO का परिचय paper से
वहाँ BM25 अकेला 16.7 देता है। Lesson 13 में ये पहले सही passage के rank का उल्टा था, जैसे rank 2 पर 0.5। Table इसे 100 से गुणा करके लिखती है। BM25 के top-1,000 को BERT-base cross-encoder से rerank करें, तो MRR@10 34.7 हो जाता है। यानी reranking से MRR@10 करीब दोगुना होता है: 34.7 ÷ 16.7 = 2.08।BM25 के top-1,000 वाली बात paper से
Reranker की एक हद है: वो सिर्फ़ shortlist का क्रम बदलता है, और जो passage उसमें नहीं है, उसे नहीं ला सकता। ये lesson 2 वाली है। 100 में से 60 सवालों की shortlist में सही passage हो, तो reranker भी 60 से ऊपर नहीं जाता।
इसलिए पहले step का recall ऊँचा होना चाहिए, और hybrid search यही करता है: E1 और E2, दोनों shortlist में पहुँचते हैं।
पहले सोचिए
हर query के लिए 500 ms का budget है। Retriever 50 ms लेता है, और cross-encoder एक passage पर 10.7 ms। Shortlist में ज़्यादा से ज़्यादा कितने passages रख सकते हैं?
जवाब देखिए
Reranking के लिए 500 − 50 = 450 ms बचते हैं। 450 ÷ 10.7 = 42.06, यानी 42 passages।
यहाँ से Stanford वाला level
ऊपर के पड़ाव आसान version जैसे ही हैं। आगे के पड़ाव आपको Stanford की slides के level तक ले जाते हैं: पहले RRF का गणित, फिर min-max। उसके बाद cross-encoder अंदर से, फिर उसकी कीमत का पूरा हिसाब, और आख़िर में आप slides खुद पढ़ते हैं। हर गणित वहीं समझाया है, जहाँ वो पहली बार आता है।
6RRF का गणित: k ranks का फ़र्क कैसे घटाता है
RRF का सारा बर्ताव एक fraction से आता है: 1 ÷ (k + rank)। पड़ाव 3 में k = 60 था। नीचे की table दिखाती है कि अलग k पर यही fraction कैसे बदलता है: हिसाब मेरा
Rank
k = 0
k = 10
k = 60
1
1
0.09091
0.01639
2
0.5
0.08333
0.01613
3
0.333
0.07692
0.01587
10
0.1
0.05000
0.01429
100
0.01
0.00909
0.00625
Rank 1 ÷ rank 2
2
1.09
1.016
k = 0 पर rank 1, rank 2 का दोगुना है, और rank 100 का सौ गुना। k = 60 पर rank 1, rank 2 से सिर्फ़ 1.016 गुना है, और rank 100 से 2.6 गुना। वजह ये है कि k = 60 पर नीचे वाले हिस्से में 60 पहले से बैठा है। तब rank का 1 बढ़ना उस हिस्से को 61 से 62 करता है, यानी 1.6%। k = 0 पर वही 1 बढ़ना 1 को 2 कर देता है, यानी 100%।
दोनों lists में rank r, बनाम एक list में rank 1
पड़ाव 3 के A और B को अब किसी भी k और r पर देखिए। A सिर्फ़ एक list में rank 1 पर है, इसलिए उसे 1 ÷ (k + 1) मिलता है। B दोनों lists में rank r पर है, इसलिए उसे 2 ÷ (k + r) मिलता है।
दो positive fractions की तुलना का एक सीधा नियम है। a ÷ b, c ÷ d से तभी बड़ा है, जब a × d, c × b से बड़ा हो। जैसे 2 ÷ 3 बड़ा है 1 ÷ 2 से, क्योंकि 2 × 2 = 4, और 1 × 3 = 3। इसी नियम से B की शर्त तीन steps में निकलती है:
2 ÷ (k + r) बड़ा है 1 ÷ (k + 1) से, तभी जब 2 × (k + 1) बड़ा हो 1 × (k + r) से।
यानी 2k + 2 बड़ा हो k + r से।
दोनों तरफ़ से k घटाइए: k + 2 बड़ा हो r से।
B तब तक आगे है, जब तक r, k + 2 से छोटा है। k = 60 पर B rank 61 तक आगे रहता है। जाँच: 2 ÷ 121 = 0.016529, जो 1 ÷ 61 = 0.016393 से बड़ा है। r = 62 पर दोनों बराबर हैं, क्योंकि 2 ÷ 122 = 1 ÷ 61। k = 0 पर B सिर्फ़ r = 1 पर आगे है।
मतलब k तय करता है कि दोनों retrievers की सहमति कितनी गहराई तक गिनी जाए। k = 60 पर top-61 के अंदर की सहमति किसी एक list के rank 1 पर भारी पड़ती है। पड़ाव 3 का widget यही नियम दिखाता है: वो k + 1 तक B को आगे बताता है।
k एक hyperparameter है, और RRF paper का experiment
k को training नहीं सीखती, उसे पहले से चुनना पड़ता है। ऐसे number को lesson 11 में कहा था, जैसे BM25 के k1 और b, जिन्हें DPR paper ने 0.9 और 0.4 चुना।
k = 60 Cormack, Clarke और Büttcher के 2009 के paper से आता है, जिसने RRF बनाया। Paper के मुताबिक k = 60 एक शुरुआती छोटे experiment में तय हुआ, और उसके बाद कभी नहीं बदला। उस experiment में paper ने 30 search systems की lists मिलाईं, और हर k पर नतीजे को MAP से नापा। paper से
MAP, यानी mean average precision, ranking की quality का 0 से 1 के बीच का एक number है, और जितना बड़ा हो, ranking उतनी अच्छी। ये हर सही document के rank तक की का औसत लेता है। Lesson 6 में precision का मतलब था: लौटे passages में सही का हिस्सा, जैसे 2 में 1 सही तो 0.5।
RRF में k
MAP
0
.2072
10
.2123
60
.2145
80, सबसे अच्छा
.2147
500
.2098
सबसे अच्छा अकेला system, बिना fusion
.2016
TREC के topics 351 से 400 पर 30 systems की fusion। paper से
k = 0 से 60 तक जाने पर MAP .2072 से .2145 तक बढ़ता है, और 500 पर वापस .2098 तक गिरता है। 30 से 100 तक हर k का MAP .2138 से .2147 के बीच है। Paper के शब्दों में k = 60 near-optimal था, लेकिन उसका चुनाव critical नहीं था। हर k पर RRF सबसे अच्छे अकेले system के .2016 से आगे है।
Paper k की वजह भी बताता है। ऊपर के ranks ज़्यादा ज़रूरी हैं, लेकिन नीचे के ranks का असर पूरी तरह ख़त्म नहीं होना चाहिए, जैसा किसी exponential formula में होता। जैसे score 1 ÷ 2rank हो, तो rank 10 को 1 ÷ 1,024, यानी करीब 0.001 मिलता। RRF में k = 60 पर rank 10 को rank 1 का 87% मिलता है। Paper के मुताबिक k किसी एक अकेले system के ऊँचे rank का असर भी घटाता है, यानी ठीक वही जो A और B में दिखा। paper से
7Scores को एक पैमाने पर लाना: min-max, और DPR paper का जोड़
पड़ाव 2 में scores का सीधा जोड़ इसलिए हारा, क्योंकि दोनों के पैमाने अलग थे। RRF ने scores छोड़ दिए। दूसरा रास्ता ये है कि दोनों scores को पहले एक ही पैमाने पर लाएँ, और फिर जोड़ें।
Min-max normalisation हर list के scores को 0 से 1 के पैमाने पर लाता है। सबसे छोटा score 0 बनता है, सबसे बड़ा 1, और बाकी उसी अनुपात में बीच में। Formula (x − min) ÷ (max − min) है। BM25 की list में min 1.0 है और max 7.2, तो E3 का 3.1 बनता है (3.1 − 1.0) ÷ (7.2 − 1.0) = 2.1 ÷ 6.2 = 0.339। Cosine में min 0.75 और max 0.82 है, तो E1 का 0.79 बनता है 0.04 ÷ 0.07 = 0.571। पड़ाव 2 वाले मेरे scores
Passage
BM25, 0 से 1 पर
Cosine, 0 से 1 पर
जोड़
E1
17.2 से
0.5710.79 से
1.571
E2
01.0 से
10.82 से
1.000
E3 (गलत)
0.3393.1 से
00.75 से
0.339
अब क्रम E1, E2, E3 है, यानी RRF जैसा। इस example में min-max ने पैमाने की दिक्कत ठीक कर दी।
Min-max की कमज़ोरी: नतीजा list के min और max पर टिका है
Min-max का हर नया score list के min और max पर टिका है। ये दोनों इस पर टिके हैं कि list में कौन से passages आए। मान लीजिए dense की list में एक चौथा, कमज़ोर passage E4 भी आता है, जिसका cosine 0.60 है। अब cosine का min 0.60 है, और फैलाव 0.82 − 0.60 = 0.22: मेरा example
गलत E3 अब सही E2 से ऊपर है, जबकि E1, E2 और E3 के अपने scores बिल्कुल नहीं बदले। सिर्फ़ एक नीचे वाले passage के आने से क्रम उलट गया। RRF में E4 dense की list में rank 4 पर आता। तब E1, E2 और E3 के ranks वही रहते, इसलिए उनके RRF भी वही रहते।
DPR paper का BM25 + DPR: scores का जोड़, λ के साथ
Lesson 12 के गहरे version में DPR paper की table में एक column था: BM25 + DPR। Paper ये column scores जोड़कर बनाता है, RRF से नहीं। वो BM25 और DPR, दोनों से top-2,000 passages लेता है। फिर दोनों lists के सारे passages को इस score से दोबारा sort करता है: paper से
BM25(q, p) + λ · sim(q, p), λ = 1.1
यहाँ sim(q, p) DPR का dot product वाला score है, और λ (lambda) एक number है, जिससे DPR के score को गुणा करते हैं। Paper ने λ = 1.1 dev set पर accuracy देखकर चुना। Dev set वो सवाल हैं, जिन पर researchers अपने फ़ैसले जाँचते हैं। मतलब ये पड़ाव 2 वाला किसी number से गुणा ही है, और वो number data देखकर चुनना पड़ा।
λ का सही मान scores के पैमाने पर टिका है। हमारे cosine पर λ = 1.1 कुछ नहीं बदलता। E1 को 7.2 + 1.1 × 0.79 = 8.069 मिलता है, E3 को 3.925, E2 को 1.902, और क्रम फिर BM25 वाला है। DPR का sim cosine नहीं, dot product है, और उसकी कोई ऊपरी हद नहीं।
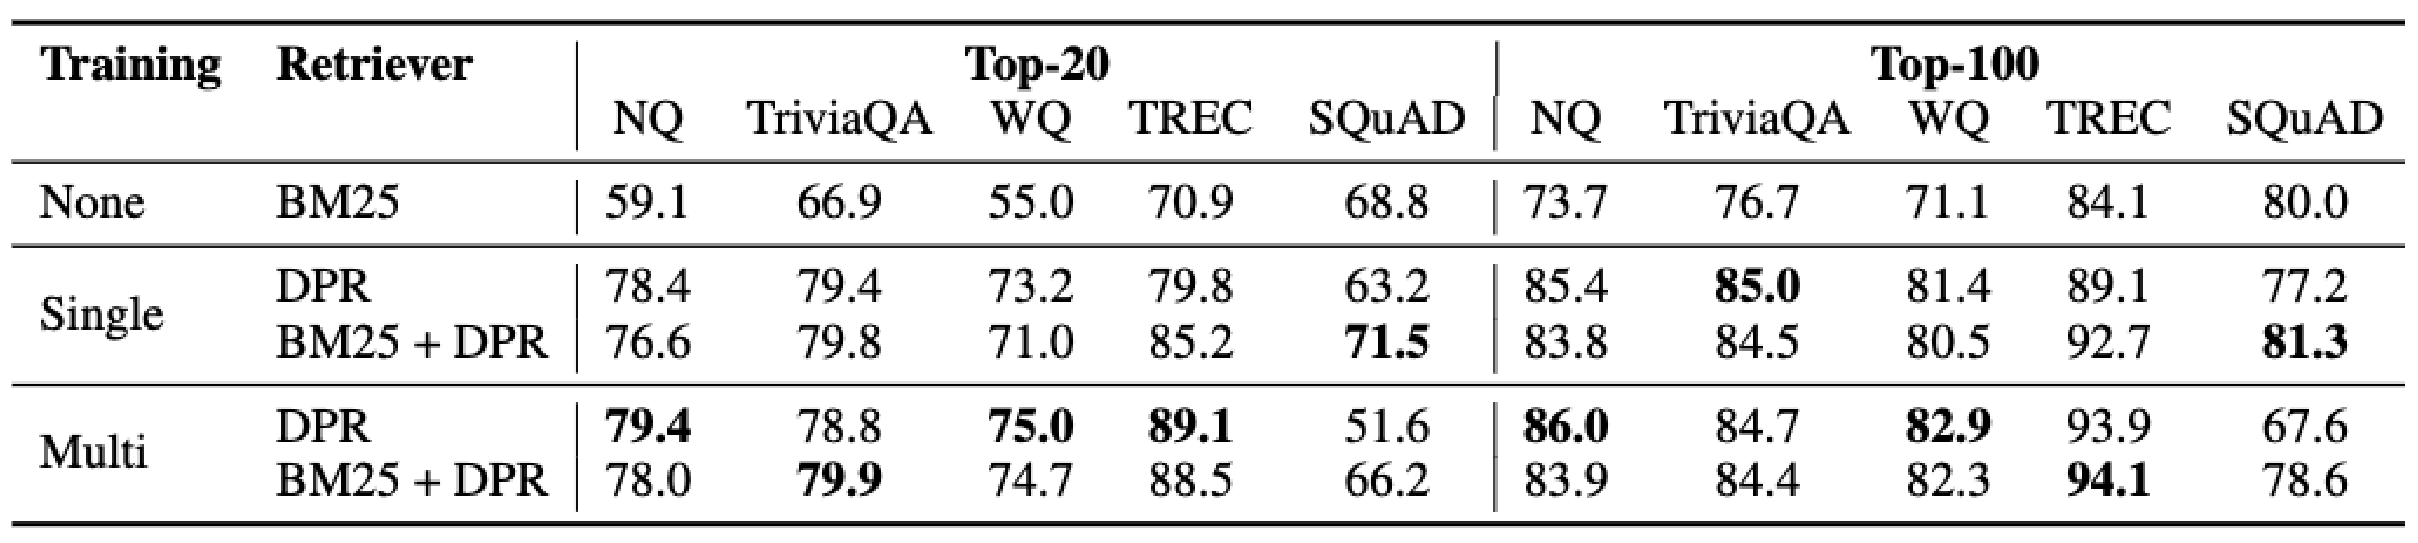
Stanford की results वाली slide पर यही column है। Single का मतलब है कि DPR हर dataset पर अलग train हुआ:
Dataset
BM25
DPR
BM25 + DPR
NQ
59.1
78.4
76.6DPR से 1.8 कम
TriviaQA
66.9
79.4
79.80.4 ज़्यादा
WQ
55.0
73.2
71.0DPR से 2.2 कम
TREC
70.9
79.8
85.25.4 ज़्यादा
SQuAD
68.8
63.2
71.5BM25 से 2.7 ज़्यादा
Top-20 accuracy (%), test set पर। “ज़्यादा” और “कम” दोनों में से बेहतर retriever से तुलना है।
TREC, SQuAD और TriviaQA पर जोड़ दोनों retrievers से आगे है। NQ और WQ पर वो DPR से पीछे है, और इन्हीं दोनों पर BM25, DPR से 19.3 और 18.2 points पीछे था। Table यही दिखाती है कि मिलाना तब फ़ायदा देता है, जब दोनों retrievers अपनी-अपनी जगह ठीक हों। एक बहुत कमज़ोर retriever मिली हुई list को नीचे खींच सकता है।
8Cross-encoder अंदर से: attention के वज़न, score और training
Attention के वज़न softmax से आते हैं
पड़ाव 4 में crowded ने averaged को 0.6 वज़न दिया, और खुद को 0.4। ये वज़न model खुद निकालता है। हर token जोड़ी के लिए model पहले एक score बनाता है, और फिर उन scores को वज़नों में बदलता है। Lesson 4 में softmax का मतलब था: हर score का escore, फिर सबके जोड़ से भाग, ताकि जोड़ 1 हो।
मान लीजिए crowded और averaged की जोड़ी का score 0.9 है, और crowded का खुद से score 0.5: numbers मेरे बनाए
e0.9 = 2.46, और e0.5 = 1.65। दोनों का जोड़ 4.11 है।
averaged का वज़न: 2.46 ÷ 4.11 = 0.599, यानी करीब 0.6।
crowded का अपना वज़न: 1.65 ÷ 4.11 = 0.401, यानी करीब 0.4।
ये score असल में दो vectors का है, लेकिन tokens के अपने vectors का नहीं। Model हर token के vector को अपने सीखे हुए numbers से बदलकर नए vectors बनाता है, और उनका dot product लेता है। Training यही numbers बदलती है, ताकि एक-दूसरे के काम के tokens की जोड़ी को बड़ा score मिले।
Input का ढाँचा, और एक vector से एक score
Nogueira और Cho का 2019 का paper BERT को इसी तरह reranker बनाता है। Stanford की table का BERT-base वाला 34.7 इसी तरीके से आया है। Input एक ही text है: पहले एक खास token [CLS], फिर query, फिर खास token [SEP], फिर passage, और आख़िर में फिर [SEP]। [SEP] सिर्फ़ दोनों हिस्सों को अलग करता है। Query ज़्यादा से ज़्यादा 64 tokens की होती है, और पूरा input 512 tokens का। paper से
[CLS] का vector भी attention से बनता है, और वो query और passage, दोनों के tokens से वज़न वाला औसत लेता है। इसलिए आख़िर में यही एक vector पूरी जोड़ी की बात रखता है। Slide के diagram का Aggregator box यही करता है: सारे output vectors में से एक vector लेता है। Humeau के paper में ये पहला vector है। paper से
फिर एक छोटी layer इस vector को एक number में बदलती है। Humeau के paper में ये layer एक vector W से dot product है, जिसे training सीखती है। paper से Diagram का Dim Reduction box यही है, क्योंकि वो पूरे vector को एक number तक घटाता है। मान लीजिए queue log वाली जोड़ी का vector [0.8, 0.2] है, और W = [2.0, −1.0]: मेरे numbers
Forum post, जिसका vector [0.2, 0.8] है: 0.2 × 2.0 + 0.8 × (−1.0) = 0.4 − 0.8 = −0.4।
Score से probability, और training का loss
Nogueira और Cho का reranker score की जगह ये probability देता है कि passage relevant है। दो classes वाली ऐसी layer दो numbers देती है, एक relevant के लिए और एक not relevant के लिए। Softmax उन्हें probabilities बनाता है। Lesson 12 में देखा था कि सारे scores में एक ही number जोड़ने से softmax नहीं बदलता। इसलिए सिर्फ़ दोनों numbers का फ़र्क मायने रखता है, और not relevant वाले number को 0 मान सकते हैं: probability वाली बात paper से
Queue log का relevant वाला number 2.44 है। e2.44 = 11.47, और e0 = 1।
Forum post का number −0.62 है: e−0.62 = 0.54, और 0.54 ÷ 1.54 = 0.35।
Office hours page का −0.36 इसी तरह 0.41 देता है। यही lesson 6 वाले तीन scores हैं: 0.92, 0.41 और 0.35। 2.44, −0.36 और −0.62 मेरे बनाए हैं
Training में हर सवाल के साथ उसके relevant passages आते हैं, और BM25 के top-1,000 में से non-relevant passages। Loss lesson 4 वाला −ln ही है: relevant passage पर −ln(probability), और non-relevant पर −ln(1 − probability), क्योंकि उसका सही जवाब not relevant है। paper से
𝓛 = − ∑j ∈ Jpos ln sj − ∑j ∈ Jneg ln(1 − sj)
Jpos relevant passages की list है, Jneg non-relevant की, और sj passage j की probability। Paper log लिखता है, और उसका मतलब ln है। हमारे दो passages पर:
Queue log relevant है, और s = 0.92: −ln 0.92 = 0.083।
Forum post relevant नहीं है, और s = 0.35: −ln(1 − 0.35) = −ln 0.65 = 0.431।
दोनों का जोड़: 0.083 + 0.431 = 0.514।
Forum post का loss बड़ा है, क्योंकि model उसे अब भी 0.35 देता है, और training उसका score और नीचे धकेलती है। Paper ने BERT-large को batch 128 के साथ 100,000 steps train किया, यानी 1.28 करोड़ सवाल-passage जोड़ों पर, और इसमें करीब 30 घंटे लगे। paper से
Humeau का paper training का एक और फ़र्क बताता है: cross-encoder को lesson 12 वाले नहीं मिलते। Bi-encoder में batch के हर passage का vector एक बार बनता है, और हर सवाल उसे negative बना सकता है। Cross-encoder में हर सवाल-passage जोड़ी के लिए model अलग चलता है। इसलिए paper अलग से दिए negatives लेता है, और ज़्यादा memory की वजह से batch छोटा रखता है। paper से
9कीमत का हिसाब: N बार model, बनाम एक बार
Cross-encoder और bi-encoder का फ़र्क गिनती से साफ़ होता है। मान लीजिए corpus में N passages हैं, और दिन में Q सवाल आते हैं:
काम
Bi-encoder
Cross-encoder
सवाल आने से पहले
N बार passage encoder, सिर्फ़ एक बार
कुछ नहीं
हर सवाल पर
1 बार question encoder, और N dot products
N बार पूरा model
N = 60,000 और Q = 10,000
60,000 + 10,000 = 70,000 model runs
10,000 × 60,000 = 60 करोड़ model runs
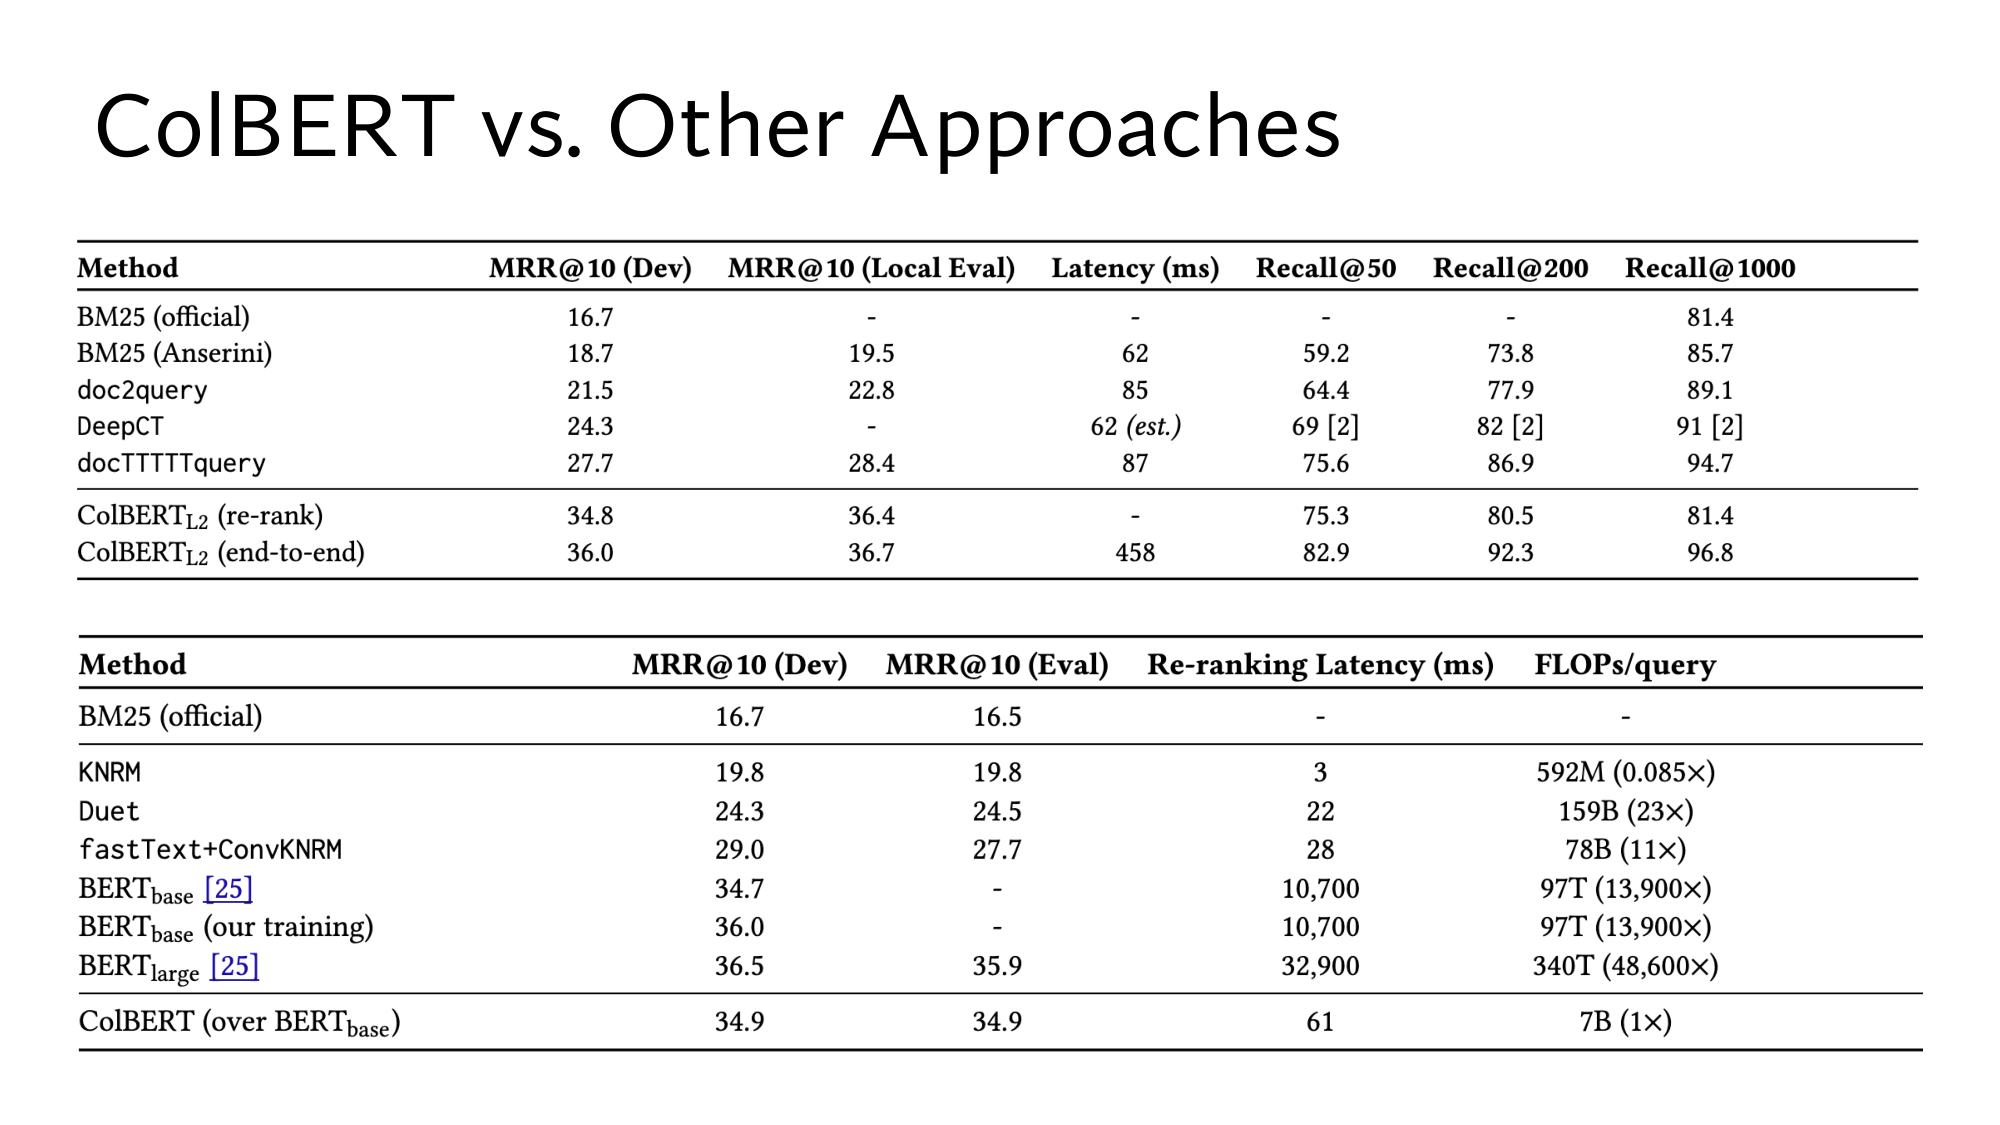
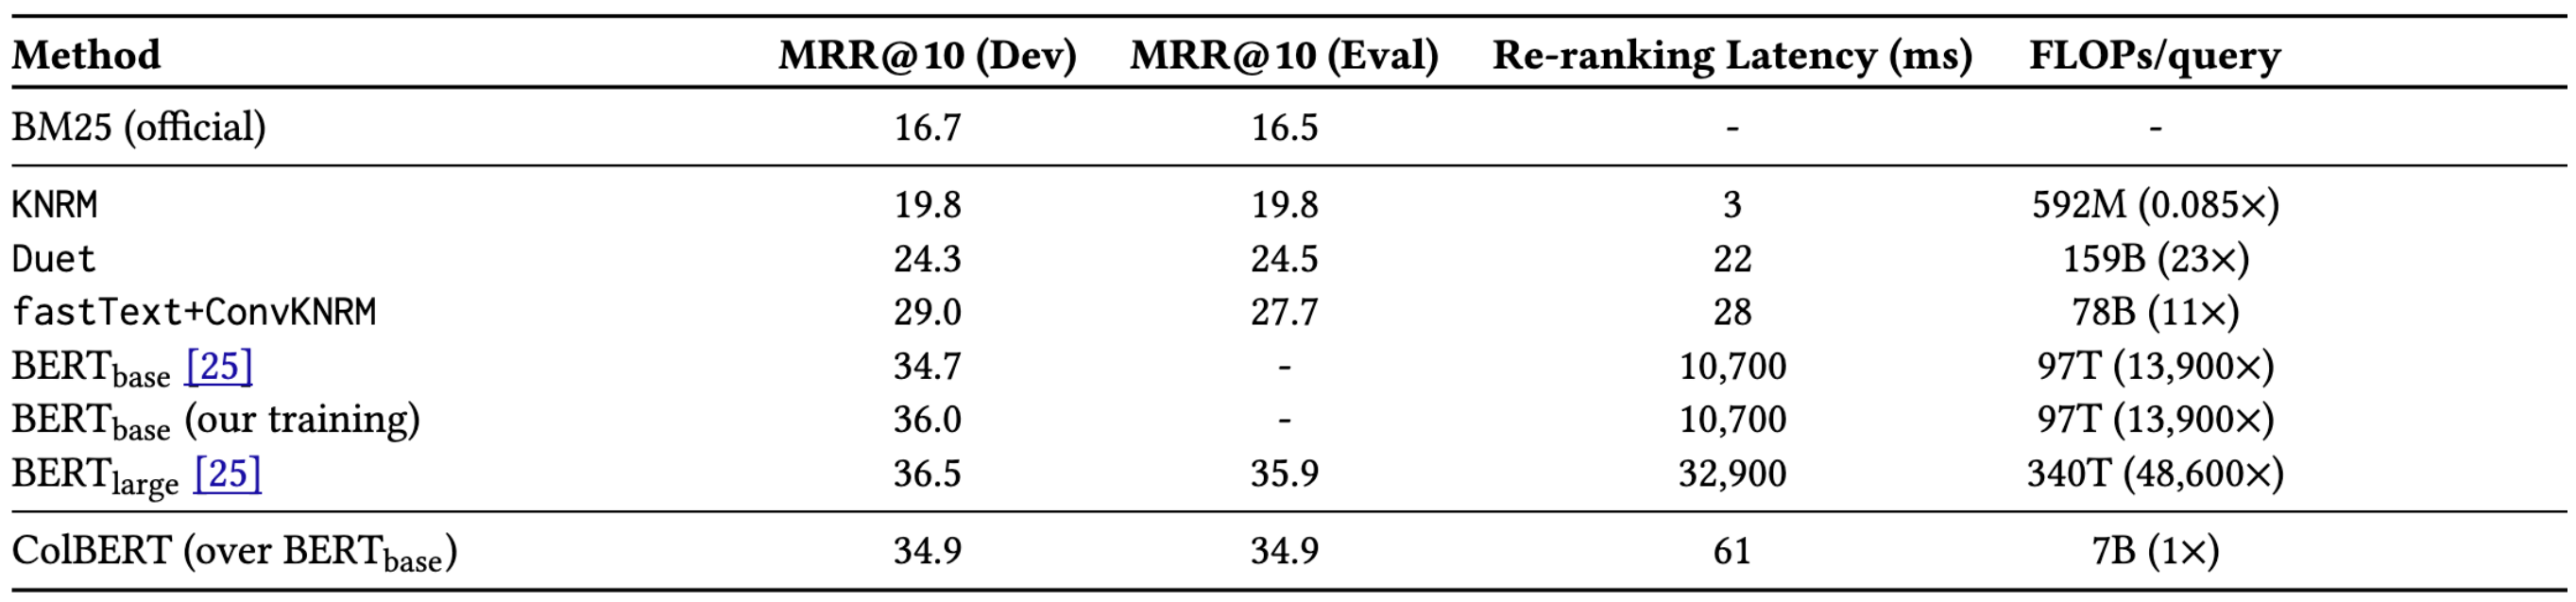
एक model run कितना महँगा है, ये Stanford की ColBERT वाली slide की नीचे वाली table बताती है। उसके आख़िरी column में per query हैं, यानी कितने गुणा और जोड़ लगे। BERT-base cross-encoder को 1,000 passages rerank करने में 97T FLOPs लगते हैं:
T यानी trillion, यानी 1012, यानी एक लाख करोड़। एक passage पर 97T ÷ 1,000 = 97 billion, यानी 9,700 करोड़ FLOPs।
768 numbers वाले दो vectors के dot product में 768 गुणा और 768 जोड़ हैं, यानी 1,536 FLOPs।
9,700 करोड़ ÷ 1,536 = करीब 6.3 करोड़। यानी एक cross-encoder run करीब 6.3 करोड़ dot products के बराबर है।
Humeau के paper ने दोनों तरीकों का समय एक ही GPU पर नापा, एक dialogue वाले काम पर: paper से
Candidates
Bi-encoder
Cross-encoder
1,000
19 ms
2,600 ms
100,000
22 ms
266,000 msनापा नहीं, हिसाब से
1,000 candidates पर cross-encoder 2,600 ÷ 19 = करीब 137 गुना धीमा है। 100,000 पर bi-encoder का समय लगभग नहीं बदलता, क्योंकि candidates के vectors पहले से बने हैं, और सिर्फ़ dot products बढ़ते हैं। Cross-encoder का समय candidates के साथ सीधा बढ़ता है। ये hardware Stanford की slide वाले hardware से अलग है, इसलिए इन ms की तुलना 10,700 ms से मत कीजिए।
बड़ा model ज़्यादा सटीक है, लेकिन और धीमा। Stanford की table में BERT-large MRR@10 36.5 देता है, यानी BERT-base से 1.8 ज़्यादा। लेकिन वो 1,000 passages पर 32,900 ms लेता है, यानी 3.07 गुना समय। पड़ाव 5 के 450 ms में BERT-large सिर्फ़ 450 ÷ 32.9 = 13 passages rerank कर पाता, जबकि BERT-base 42।
Recall ceiling असली numbers में
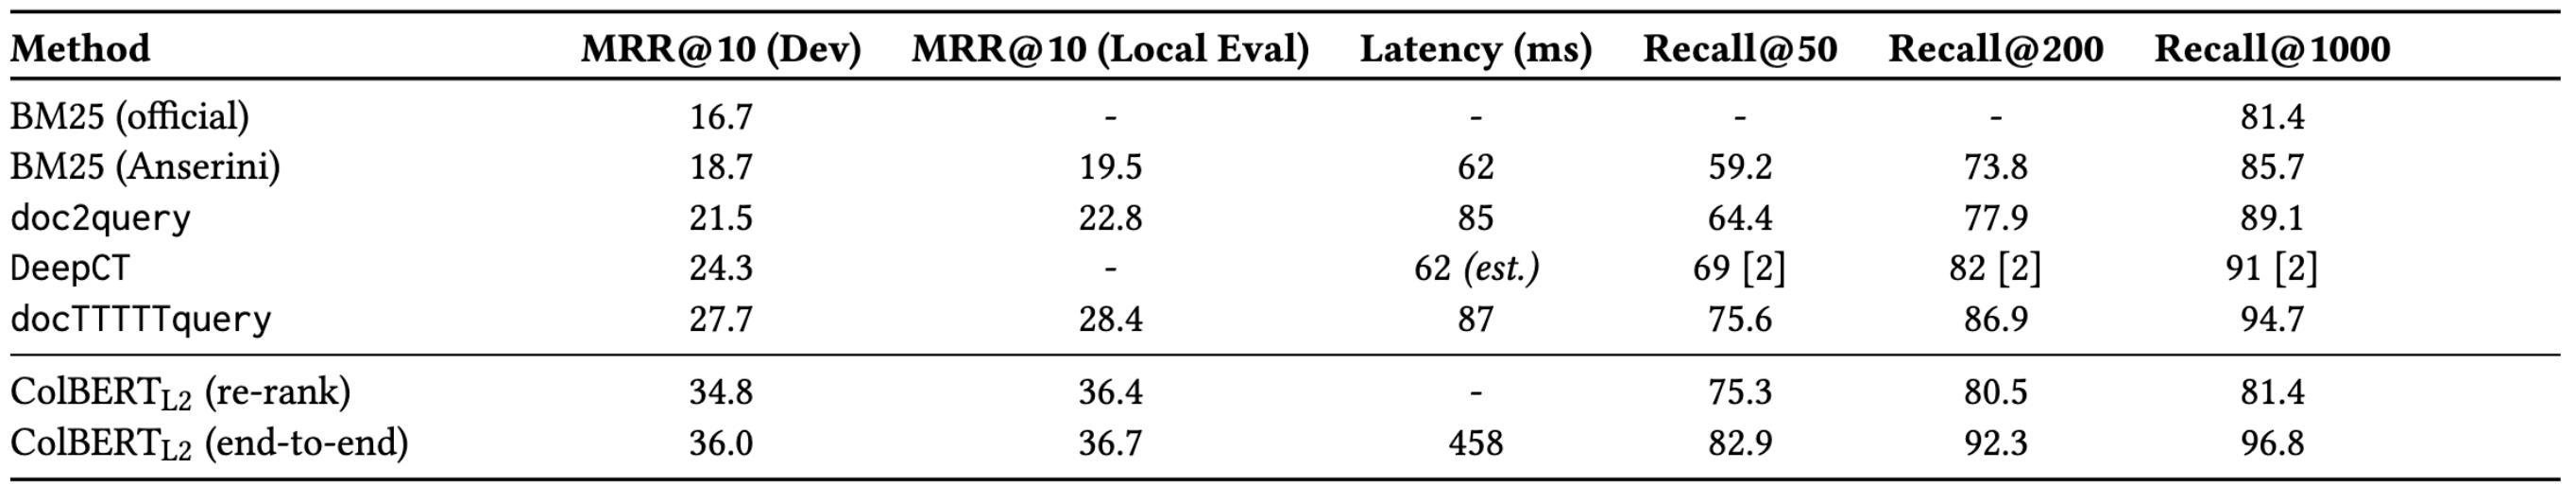
उसी slide की ऊपर वाली table में MS MARCO पर BM25 का Recall@1000 81.4 है। lesson 13 का है: top-k में मिले सही passages ÷ कुल सही passages, जैसे 2 में से 1 मिले तो 0.5। MS MARCO में हर सवाल का औसतन एक सही passage है। इसलिए 81.4 का मतलब करीब ये है कि 100 में से 81.4 सवालों का सही passage BM25 के top-1,000 में है। एक सही passage वाली बात paper से
BERT-base ने BM25 के इन्हीं 1,000 passages को rerank किया था, इसलिए उसका Recall@1000 भी 81.4 से ऊपर नहीं जा सकता। Table की ColBERTL2 (re-rank) वाली row यही दिखाती है: वो भी BM25 के top-1,000 को rerank करती है, और उसका Recall@1000 ठीक 81.4 है। Reranking ने MRR@10 को 16.7 से 34.7 तक पहुँचाया, लेकिन recall की छत BM25 ने 81.4 पर तय कर दी।
Hybrid search इसी छत को ऊँचा करता है, क्योंकि दो lists के मेल में सही passage के आने का मौका एक list से ज़्यादा है। तेज़ step पहले और महँगा step बाद में, इस ढाँचे को lesson 15 में कहते हैं। वहाँ ColBERT पूरे corpus से ढूँढकर Recall@1000 को 96.8 तक ले जाता है।
10अब Stanford की slides खुद पढ़िए
नीचे Stanford की पाँच slides हैं, बिना किसी बदलाव के, और हर slide के बाद उसका ज़रूरी हिस्सा बड़ा करके। हर slide के नीचे कुछ सवाल हैं। पहले खुद जवाब सोचिए, फिर खोलिए। कोई बात अटके, तो जवाब में लिखे पड़ाव पर लौट जाइए। Phone पर slide छोटी दिखे, तो image पर click कीजिए।
Stanford की hybrid search वाली slide, और नीचे उसका पहला point और formula, बड़े करके।
Hybrid search वाली slide पढ़िए
पहला point कहता है कि BM25 paraphrase चूकता है, और dense retrieval rare literals। E1, E2 और E3 में इसके दोनों examples कौन से हैं?
जवाब देखिए
E2 paraphrase है, और BM25 ने उसे rank 3 पर रखा। E1 का E-4012 literal है, और dense ने E1 को rank 2 पर रखा, जबकि BM25 ने rank 1 पर। (पड़ाव 1)
Formula में rankr(d) के साथ k = 60 जुड़ा है। k = 60 पर एक list के rank 1 वाला passage किस passage से हारता है?
जवाब देखिए
हर उस passage से, जो दोनों lists में rank 61 या उससे ऊपर है। दोनों lists वाला passage तब आगे है, जब r, k + 2 से छोटा हो। (पड़ाव 3 और 6)
Slide कहती है no per-corpus tuning। DPR paper का BM25 + DPR इस बात पर खरा क्यों नहीं उतरता?
जवाब देखिए
उसमें λ = 1.1 है, जिसे paper ने dev set पर चुना। RRF में ऐसा कोई number data देखकर नहीं चुनना पड़ता, क्योंकि ranks का पैमाना हर corpus में एक है। (पड़ाव 2 और 7)
Stanford की cross-encoder वाली slide, और नीचे उसके दोनों diagrams, बड़े करके। Inx query के tokens हैं, और Iny passage के।
Cross-encoder वाली slide पढ़िए
Bi-encoder में Score के नीचे ⊙ का निशान है। ये क्या करता है, और cross-encoder में ये क्यों नहीं है?
जवाब देखिए
⊙ Ctxt Emb और Cand Emb का dot product है, यानी lesson 12 वाला score। Cross-encoder में दोनों texts एक ही Encoder में हैं, इसलिए वहाँ दो अलग vectors हैं ही नहीं। वहाँ Dim Reduction एक vector को सीधे एक number बनाता है। (पड़ाव 4 और 8)
Cross-encoder में Aggregator के ऊपर सिर्फ़ Cand Emb है, Ctxt Emb नहीं। ऐसा क्यों?
जवाब देखिए
Cross-encoder में query का अपना अलग vector बनता ही नहीं। Aggregator जो एक vector देता है, वो पूरी जोड़ी का है, और Humeau के paper में ये पहले token का output है, जैसे [CLS]। (पड़ाव 8)
Bi-encoder में Cand Emb पहले से बनाकर index में रख सकते हैं। Cross-encoder में ऐसा क्यों नहीं हो सकता?
जवाब देखिए
क्योंकि Outy vectors भी query के tokens को देखकर बनते हैं, जैसे crowded का vector हर passage के साथ अलग था। Query बदले, तो सब कुछ बदल जाता है। (पड़ाव 4)
Stanford की DPR results वाली slide, और नीचे उसकी table, बड़ी करके। Lesson 12 ने BM25 और DPR की rows पढ़ी थीं। यहाँ BM25 + DPR वाली rows पढ़िए।
Results वाली slide की BM25 + DPR rows पढ़िए
Top-20 में Single वाली BM25 + DPR row किन datasets पर DPR से नीचे है?
जवाब देखिए
NQ पर (76.6 बनाम 78.4) और WQ पर (71.0 बनाम 73.2)। इन दोनों पर BM25 बहुत पीछे था: 59.1 और 55.0। (पड़ाव 7)
SQuAD पर BM25 + DPR 71.5 है। ये BM25 और DPR से कितना आगे है?
जवाब देखिए
BM25 के 68.8 से 2.7 आगे, और DPR के 63.2 से 8.3 आगे। SQuAD पर BM25 अकेला DPR से आगे था, फिर भी मेल दोनों से आगे निकला। (पड़ाव 1 और 7)
क्या BM25 + DPR वाली rows RRF से बनी हैं?
जवाब देखिए
नहीं। DPR paper ने top-2,000 के मेल पर BM25(q, p) + 1.1 · sim(q, p) से scores जोड़े। paper से (पड़ाव 7)
Stanford की ColBERT वाली slide। पहले नीचे वाली reranking table बड़ी करके, फिर ऊपर वाली recall की table। ColBERT की rows lesson 15 में आती हैं। Dev और Eval MS MARCO के दो अलग सवालों के sets हैं।
ColBERT वाली slide की reranking rows पढ़िए
नीचे वाली table में BERTbase [25] का MRR@10 34.7 है। [25] क्या है, और ये reranker किस list को rerank करता है?
जवाब देखिए
[25] Nogueira और Cho का paper है। उसका reranker BM25 के top-1,000 को rerank करता है, और BM25 अकेला 16.7 पर है। paper से (पड़ाव 5 और 8)
FLOPs/query में BERTbase के आगे 97T (13,900×) है। एक passage पर कितने FLOPs हुए, और 13,900× किससे तुलना है?
जवाब देखिए
एक passage पर 97T ÷ 1,000 = 97 billion। 13,900× आख़िरी row के ColBERT के 7B से तुलना है: 97T ÷ 7B = करीब 13,900। (पड़ाव 9)
ऊपर वाली table में ColBERTL2 (re-rank) का Recall@1000 ठीक BM25 (official) जितना, 81.4 क्यों है?
जवाब देखिए
क्योंकि re-rank वाला model BM25 के ही top-1,000 को दोबारा sort करता है। Reranking क्रम बदलती है, list नहीं, इसलिए recall की छत BM25 की रहती है। (पड़ाव 5 और 9)
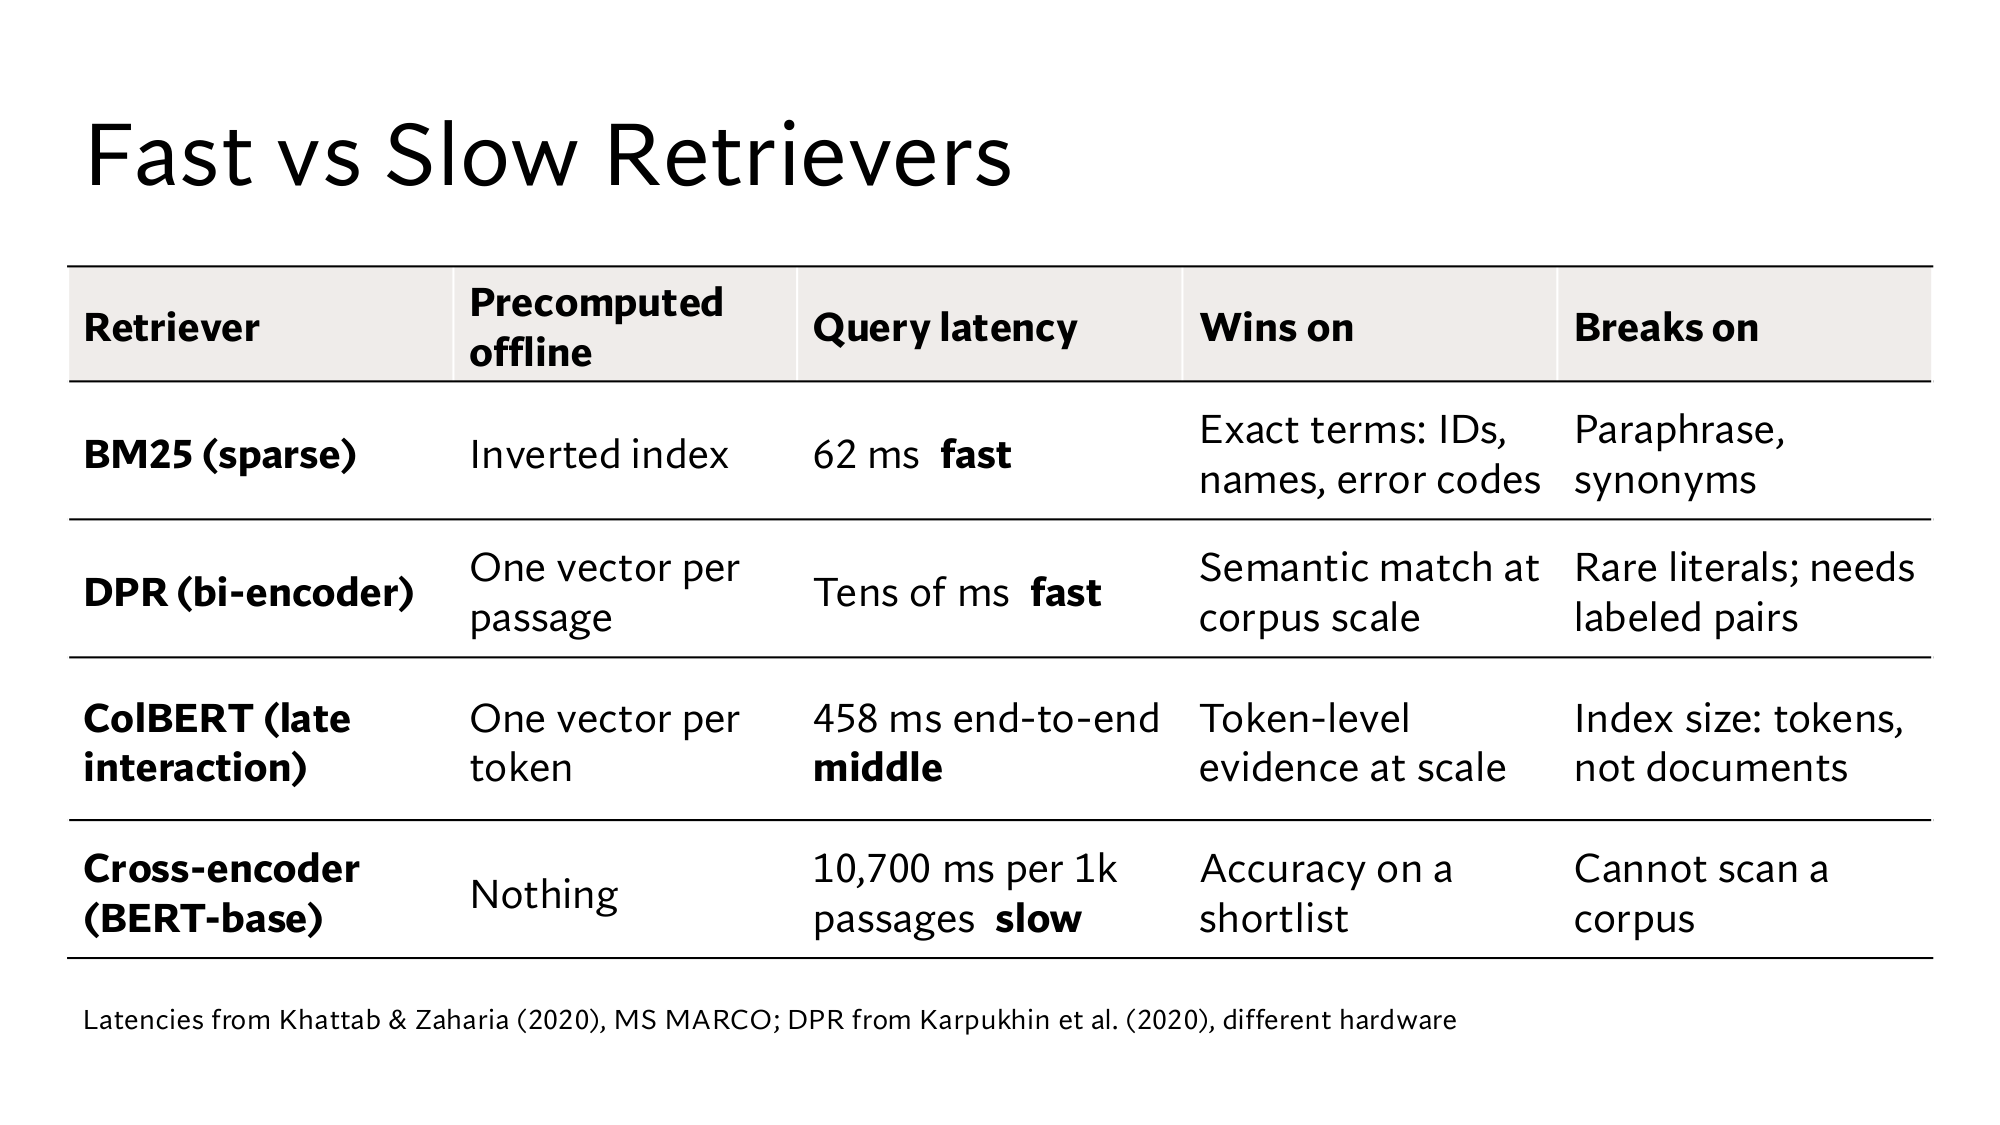
Stanford की तुलना वाली slide, और नीचे उसकी table, बड़ी करके। Lesson 12 ने BM25 और DPR की rows पढ़ी थीं। यहाँ cross-encoder की row पढ़िए।
तुलना वाली slide की cross-encoder row पढ़िए
Cross-encoder की row में Precomputed offline के नीचे Nothing क्यों लिखा है?
जवाब देखिए
क्योंकि उसका हर vector query पर टिका है, इसलिए passage का कुछ भी पहले से नहीं बन सकता। (पड़ाव 4)
Wins on में Accuracy on a shortlist है, और Breaks on में Cannot scan a corpus। 60,000 passages पर इन दोनों का मतलब numbers में क्या है?
जवाब देखिए
पूरे corpus पर एक query के 60,000 × 10.7 ms = 642 seconds लगते, और top-100 shortlist पर 1,070 ms। Shortlist पर reranking MRR@10 को 16.7 से 34.7 तक ले गई थी। (पड़ाव 4 और 5)
इस lesson की 3 बातें
BM25 paraphrase चूकता है, और dense retriever rare literals। Hybrid search दोनों की lists मिलाता है, लेकिन DPR paper का scores वाला जोड़ NQ और WQ पर DPR से पीछे रहा।
RRF हर list से 1 ÷ (k + rank) जोड़ता है। k = 60 पर दोनों lists में rank 61 तक का passage किसी एक list के rank 1 से आगे है। शर्त r < k + 2 है। Min-max का नतीजा list के min और max पर टिका है।
Cross-encoder में attention query और passage के बीच चलता है, इसलिए कुछ पहले से नहीं बनता। एक जोड़ी करीब 6.3 करोड़ dot products जितनी महँगी है। Reranking ने MRR@10 को 16.7 से 34.7 किया, लेकिन Recall@1000 BM25 के 81.4 पर ही रहा।
इस lesson के नए शब्द
Paraphrase
वही बात अलग शब्दों में। जैसे upload failed और upload keeps failing। BM25 इसे चूकता है, क्योंकि वो एक जैसे शब्द गिनता है।
Literal
ऐसा text, जो हूबहू मिलना चाहिए, जैसे error code E-4012 या order ID A77-310। Dense retriever इसे चूक सकता है, और BM25 इसे rare शब्द मानकर पकड़ता है।
Hybrid search
दोनों retrievers, शब्दों वाला और dense, चलाकर उनकी lists मिलाना। जैसे BM25 की E1, E3, E2 और dense की E2, E1, E3 से एक list बनाना।
Reciprocal rank fusion (RRF)
हर list में passage के rank से 1 ÷ (k + rank), फिर सारी lists का जोड़, जहाँ k = 60। जैसे E1: 1 ÷ 61 + 1 ÷ 62 = 0.03252।
Attention
हर token बाकी tokens के vectors का वज़न वाला औसत लेकर अपना नया vector बनाता है, और वज़नों का जोड़ 1 होता है। जैसे crowded [0.5, 0.5] averaged [1.0, 0.0] को 0.6 वज़न दे, तो [0.8, 0.2] बनता है।
Cross-encoder
Query और passage को जोड़कर एक model में डालने वाला reranker, जो जोड़ी का सीधा score देता है। ये हर passage पर पूरा चलता है, जैसे BERT-base में 10.7 ms per passage।
Reranking
तेज़ retriever की shortlist को सटीक model से दोबारा score देकर sort करना। जैसे MS MARCO पर MRR@10 BM25 अकेले 16.7, और BERT-base से rerank के बाद 34.7।
Shortlist
Retriever के ऊपर के कुछ passages, जिन पर reranker चलता है। जैसे 60,000 passages में से top-100, जिन पर cross-encoder 1,070 ms लेता है।
Min-max normalisation
हर list के scores को (x − min) ÷ (max − min) से 0 से 1 पर लाना। जैसे BM25 के 7.2, 3.1 और 1.0 से 1, 0.339 और 0। नतीजा list के min और max पर टिका है।
[CLS] और [SEP]
BERT के input के खास tokens। [CLS] सबसे आगे आता है, और cross-encoder में उसका आख़िरी vector पूरी जोड़ी की बात रखता है। [SEP] query और passage को अलग करता है, जैसे [CLS] query [SEP] passage [SEP]।