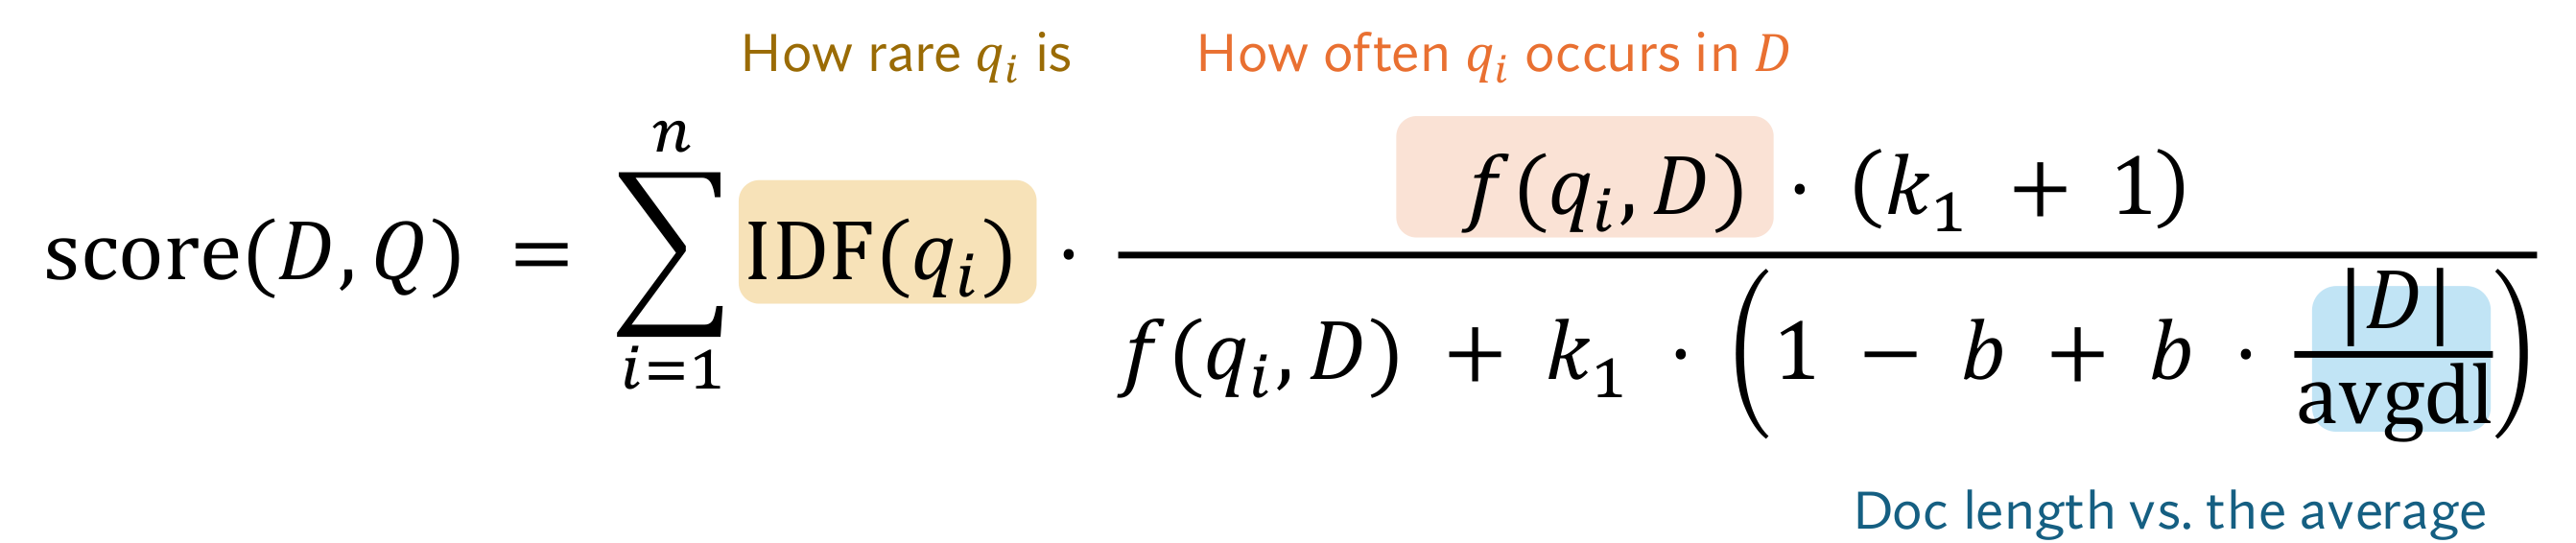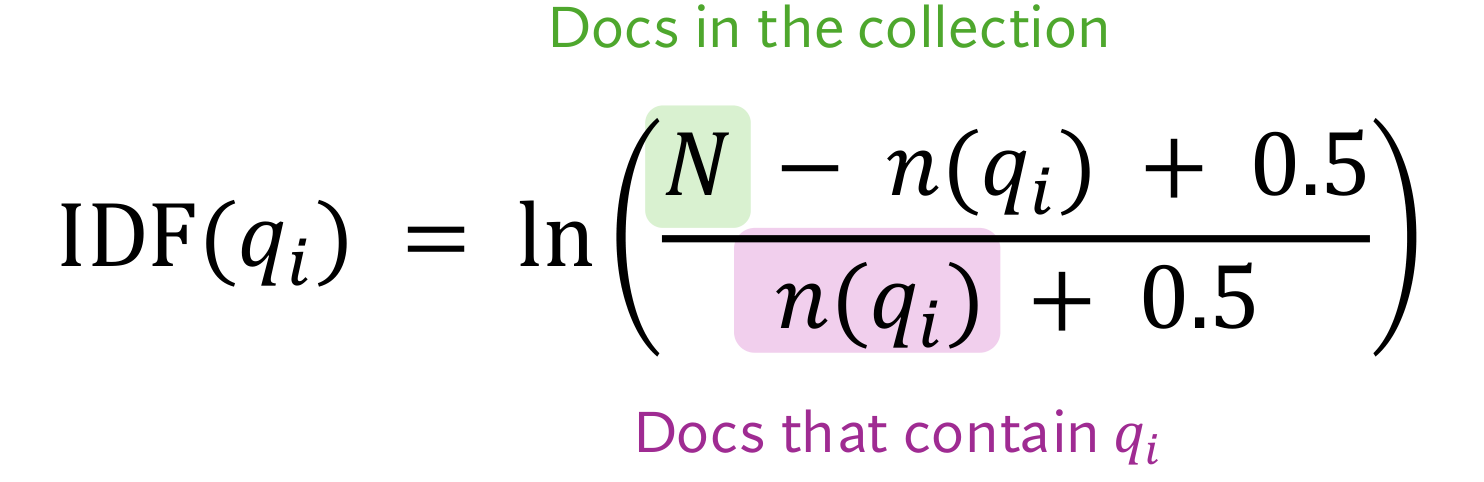BM25 एक retriever है, जो query के हर शब्द पर passage को एक वज़न देता है। इन वज़नों का जोड़ passage का score है। ये वज़न तीन बातों से बनता है: शब्द पूरे corpus में कितना rare है, passage में कितनी बार आया, और passage कितना लंबा है। Stanford की slide इसे आज भी सबसे ज़्यादा इस्तेमाल होने वाला retriever बताती है।
इसकी ज़रूरत lesson 2 में दिखी थी। गिनता है कि query के कितने शब्द passage में भी हैं। Query which office hour is least crowded पर उसने दो passages को बराबर 2 दिया। एक queue log है, जिसमें भीड़ का data और जवाब है। दूसरा 2024 का एक पुराना forum post है, जिसमें सिर्फ़ एक राय है। ये lesson BM25 के तीनों हिस्से एक-एक करके जोड़ता है, और हर बार tie देखता है।
इस lesson की सीढ़ी
सीढ़ी में 10 पड़ाव हैं। पहले 5 आसान version जैसे ही हैं, और पड़ाव 6 से Stanford वाला level शुरू होता है। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
पहले से क्या चाहिए: Lesson 2 (corpus, word overlap, stopwords, score), Lesson 3 (vector, dot product, embedding) और Lesson 4 (e और ln)। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। कहीं अटकें, तो एक पड़ाव पीछे लौटिए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1IDF: rare term को ज़्यादा वज़न
IDF हर शब्द को एक वज़न देता है, और शब्द जितने कम passages में आता है, उसका वज़न उतना बड़ा होता है। Search में query के ऐसे हर शब्द को term कहते हैं। यानी which और is जैसे बहुत आम शब्द, जिन्हें गिनती से पहले हटा देते हैं। इन्हें हटाने पर हमारी query में चार terms बचते हैं: office, hour, least और crowded।
office दो passages में है, और least और crowded सिर्फ़ forum post में, जबकि word overlap चारों को बराबर गिनता है। Term कितने passages में है, उस गिनती को document frequency कहते हैं, और उसे n लिखते हैं। हमारे corpus में N = 6 passages हैं, और milestone सिर्फ़ syllabus में है, यानी n = 1। उसका IDF तीन steps में निकलता है:
जिन passages में term नहीं है, उनकी गिनती में 0.5 जोड़िए: 6 − 1 + 0.5 = 5.5।
जिन passages में term है, उनकी गिनती में भी 0.5 जोड़िए: 1 + 0.5 = 1.5।
पहले number को दूसरे से भाग दीजिए, 5.5 ÷ 1.5 = 3.667, और उसका ln लीजिए: ln 3.667 = 1.299।
Step 3 का भाग बताता है कि term वाले हर एक passage के मुकाबले कितने passages में term नहीं है। 0.5 इसलिए जुड़ता है, ताकि कोई गिनती 0 हो, तब भी भाग बन सके।
Step 3 का lesson 4 से है। ln x वो number है, जिसे e = 2.718 की power बनाने से x मिलता है। जाँच: e1.2993 = 3.667, इसलिए ln 3.667 = 1.299। आगे एक नियम काम आएगा: ln 1 = 0, क्योंकि e0 = 1।
इस वज़न को IDF कहते हैं, यानी inverse document frequency: n जितना छोटा, IDF उतना बड़ा। Formula में यही तीन steps हैं:
IDF = ln N − n + 0.5n + 0.5
Term, और किन passages में
n
हिसाब
IDF
milestonesyllabus
1
ln(5.5 ÷ 1.5)
1.299
officeoffice hours page, queue log
2
ln(4.5 ÷ 2.5)
0.588
thursdaysyllabus, office hours page, queue log
3
ln(3.5 ÷ 3.5)
0
thursday आधे passages में है, उसका भाग 1 है, और ln 1 = 0, इसलिए उसका वज़न 0 है।
अब हमारी query के terms लीजिए। office का IDF 0.588 है। hour सिर्फ़ queue log में है, क्योंकि office hours page पर hours लिखा है, hour नहीं, और retriever इन्हें अलग शब्द मानता है। इसलिए hour, least और crowded, तीनों का n = 1 है, और IDF 1.299।
पहले सोचिए
हर term को अभी एक ही बार गिनिए, और सिर्फ़ उसका IDF जोड़िए। Forum post और queue log का score कितना होगा, और tie किस तरफ़ टूटेगा?
जवाब देखिए
4 decimal तक IDF लेकर forum post को 1.2993 + 1.2993 = 2.599 मिलता है, और queue log को 0.5878 + 1.2993 = 1.887। Tie टूट गया, लेकिन forum post की तरफ़, क्योंकि उसके दोनों terms rare हैं, और queue log का office आम है।
लेकिन queue log में office hour दो बार आता है, Tuesday और Thursday के लिए, और IDF उसे एक ही बार गिनता है। अगला पड़ाव यही गिनती जोड़ता है।
2Term frequency और saturation: गिनती का फ़ायदा एक छत तक
Term frequency f बताती है कि term एक passage में कितनी बार आया। Queue log में office और hour, दोनों की f = 2 है। लेकिन term का पहली बार आना बताता है कि passage उस बारे में है, और दसवीं बार आना उसमें बहुत कम जोड़ता है। इसलिए BM25 सीधे f से गुणा नहीं करता।
वो f से एक नया number बनाता है, जिसे ये lesson TF हिस्सा कहेगा। अभी passage की length को छोड़िए, वो पड़ाव 3 में आती है:
TF हिस्सा = f × 2.2f + 1.2
f = 2 पर इसका हिसाब तीन steps में है:
ऊपर का हिस्सा: 2 × 2.2 = 4.4।
नीचे का हिस्सा: 2 + 1.2 = 3.2।
भाग: 4.4 ÷ 3.2 = 1.375।
जाँच: f = 1 पर ऊपर 2.2 और नीचे 2.2 है, तो हिस्सा ठीक 1। अब f बढ़ाकर देखिए:
f
TF हिस्सा
1
1.000
2
1.375
5
1.774
10
1.964
1 से 2 बार होने पर हिस्सा 0.375 बढ़ा, और 5 से 10 बार होने पर सिर्फ़ 0.190। f बड़ा होने पर नीचे का 1.2 उसके मुकाबले छोटा पड़ जाता है, इसलिए हिस्सा 2.2 के पास पहुँचता है, पर उसे छूता नहीं। इसे saturation कहते हैं: हर अगली गिनती पिछली से कम जोड़ती है, और हिस्सा एक छत से ऊपर नहीं जाता।
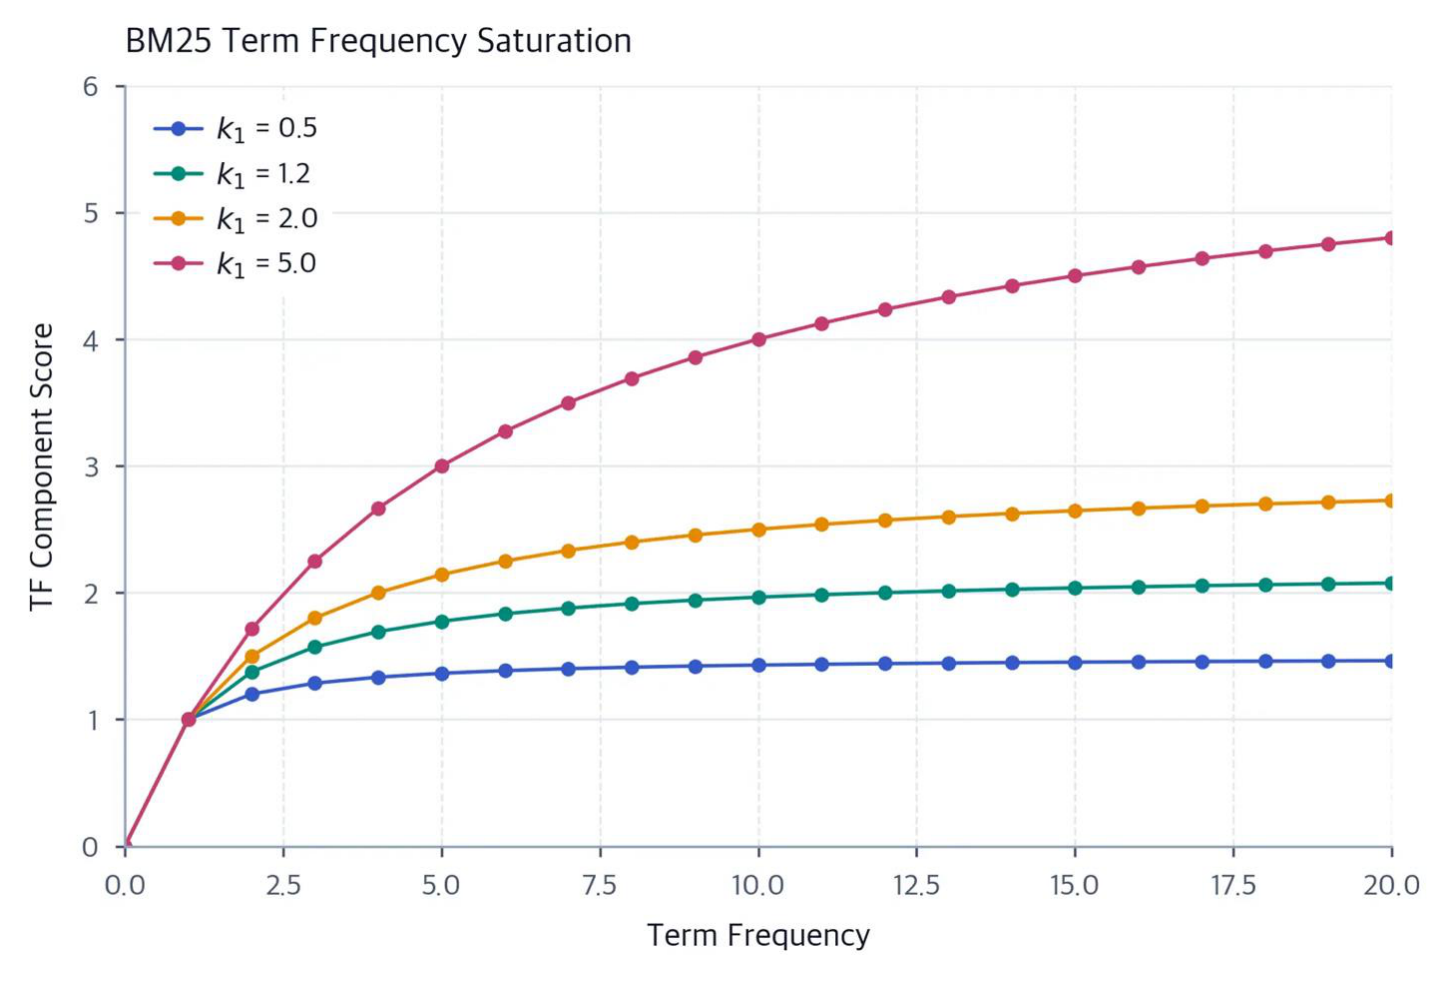
Formula का 1.2 एक knob है, जिसका नाम k1 है, और छत 2.2 असल में k1 + 1 है। k1 छोटा हो, तो छत नीची है और हिस्सा जल्दी भरता है। k1 = 1.2 मेरा चुना है, slide के graph में भी ये line है
अब queue log पर लौटिए। उसमें office और hour दो-दो बार हैं, तो दोनों का TF हिस्सा 1.375 है, और score = 0.588 × 1.375 + 1.299 × 1.375 = 2.595। Forum post के दोनों terms एक-एक बार हैं, तो उसका score 2.599 ही रहा। गिनती जोड़ने से queue log लगभग बराबर आ गया, और फ़र्क सिर्फ़ 0.004 बचा।
पहले सोचिए
k1 = 0 हो, तो TF हिस्सा क्या बन जाता है? पड़ाव 1 के scores से इसका क्या रिश्ता है?
जवाब देखिए
Formula f × 1 ÷ (f + 0) बन जाता है, यानी f ÷ f = 1, अगर f कम से कम 1 है। ये lesson 2 वाला word overlap है, बस IDF के वज़न के साथ। पड़ाव 1 के 2.599 और 1.887 यही k1 = 0 वाले scores थे।
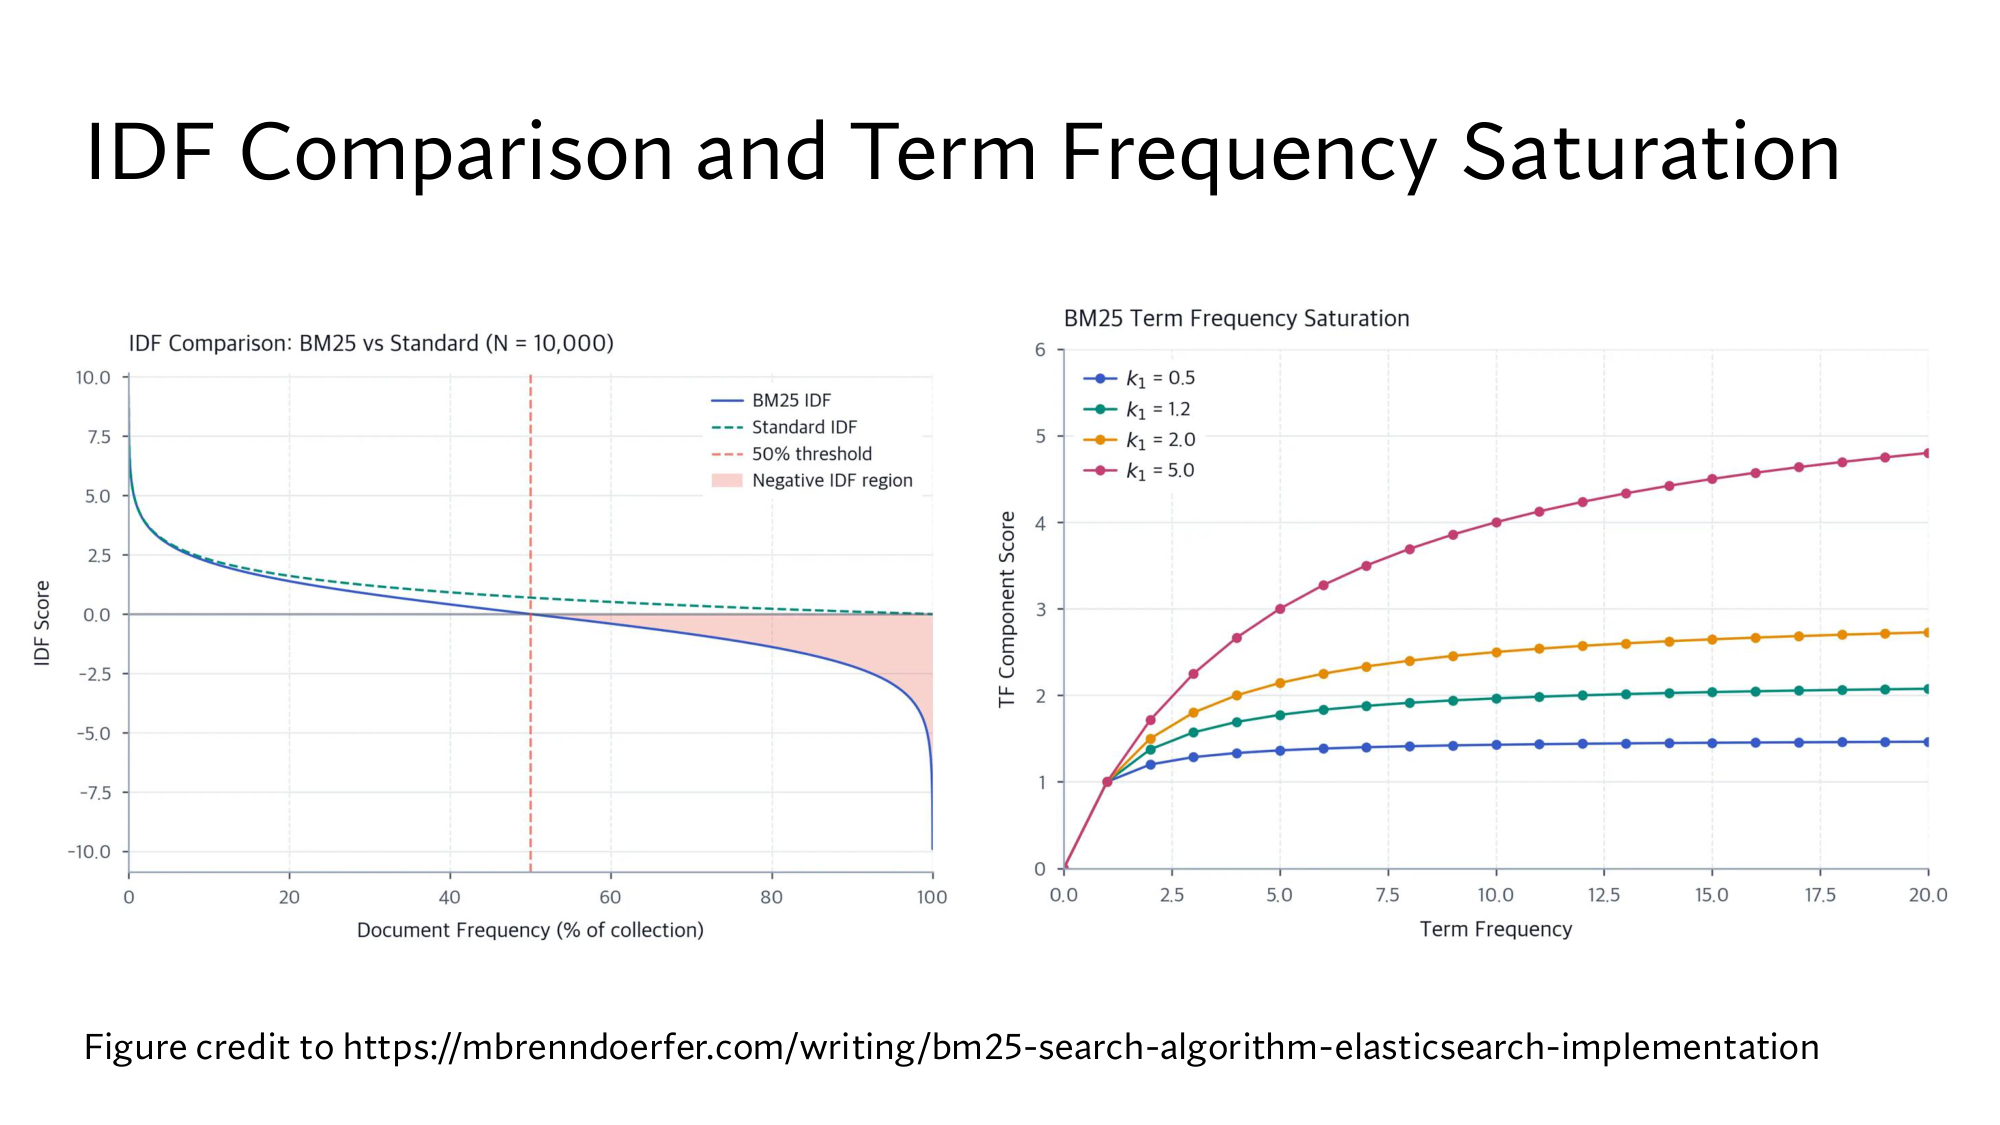
Stanford की slide: दाएँ चार k1 के लिए TF हिस्सा, और बाएँ IDF।
3Length normalization: लंबे passage में term का वज़न घटाना
Length normalization लंबे passage में आए term का TF हिस्सा घटाती है, और छोटे passage में आए term का बढ़ाती है। 1,000 शब्दों के document में office एक बार आना, 20 शब्दों के passage में एक बार आने से कम बताता है।
इसके लिए BM25 हर passage की length को corpus की औसत length से मिलाता है। Passage की length शब्दों में |D| लिखते हैं, और औसत length को avgdl। औसत यानी सारी lengths का जोड़, passages की गिनती से भाग:
जाँच: 16.17 × 6 = 97.02, यानी करीब 97। अब BM25 TF हिस्से के नीचे वाले k1 को इस factor से गुणा करता है:
factor = 1 − b + b × |D|avgdl
|D| ÷ avgdl बताता है कि passage औसत का कितना गुना है। b एक दूसरा knob है, 0 से 1 के बीच, जो तय करता है कि length का कितना असर हो। Queue log के लिए, b = 0.75 पर, factor तीन steps में निकलता है: b = 0.75 मेरा चुना है
|D| ÷ avgdl = 19 ÷ 16.17 = 1.175।
b से गुणा: 0.75 × 1.175 = 0.881।
1 − b जोड़िए: 0.25 + 0.881 = 1.131।
जाँच: औसत length पर factor 0.25 + 0.75 = 1 है, यानी कोई बदलाव नहीं। औसत से लंबे passage का factor 1 से बड़ा है, इसलिए उसका TF हिस्सा छोटा है। जैसे f = 1 पर दोगुनी length वाले passage का हिस्सा 1.000 से घटकर 0.710 रह जाता है।
इसे length normalization कहते हैं। b = 0 पर factor हमेशा 1 है, यानी length का कोई असर नहीं, और b = 1 पर पूरा असर। हमारे passages में queue log 19 शब्दों का है, औसत से लंबा, तो उसका factor 1.131 है। Forum post 14 शब्दों का है, तो उसका factor 0.25 + 0.75 × 14 ÷ 16.17 = 0.899 है।
पहले सोचिए
b = 1 है, और passage औसत से दोगुना लंबा। f = 1 और k1 = 1.2 पर TF हिस्सा कितना होगा?
जवाब देखिए
Factor = 1 − 1 + 1 × 2 = 2। हिस्सा = 2.2 ÷ (1 + 1.2 × 2) = 2.2 ÷ 3.4 = 0.647। ये b = 0.75 वाले 0.710 से भी कम है, क्योंकि length का पूरा असर लगा।
4तीनों हिस्से एक formula में: BM25
BM25 score हर query term के IDF और TF हिस्से का गुणा है, सारे terms पर जोड़कर। जो term passage में नहीं है, उसका हिस्सा 0 है। पूरा हिसाब queue log के office पर कीजिए: f = 2, और पड़ाव 3 का factor, 4 decimal तक 1.1314।
Forum post के least पर factor 0.8995 है, तो TF हिस्सा 2.2 ÷ (1 + 1.2 × 0.8995) = 2.2 ÷ 2.0794 = 1.0580 है। Query which office hour is least crowded, k1 = 1.2 और b = 0.75 पर पूरा हिसाब ये है:
BM25 पुराने forum post को queue log से ऊपर रखता है, 2.749 बनाम 2.473। Length ने पड़ाव 2 का 0.004 का फ़र्क बढ़ाकर 0.276 कर दिया। Formula सिर्फ़ शब्द गिनता है, और उसका कोई हिस्सा ये नहीं देखता कि forum post 2024 की राय है और queue log ताज़ा data।
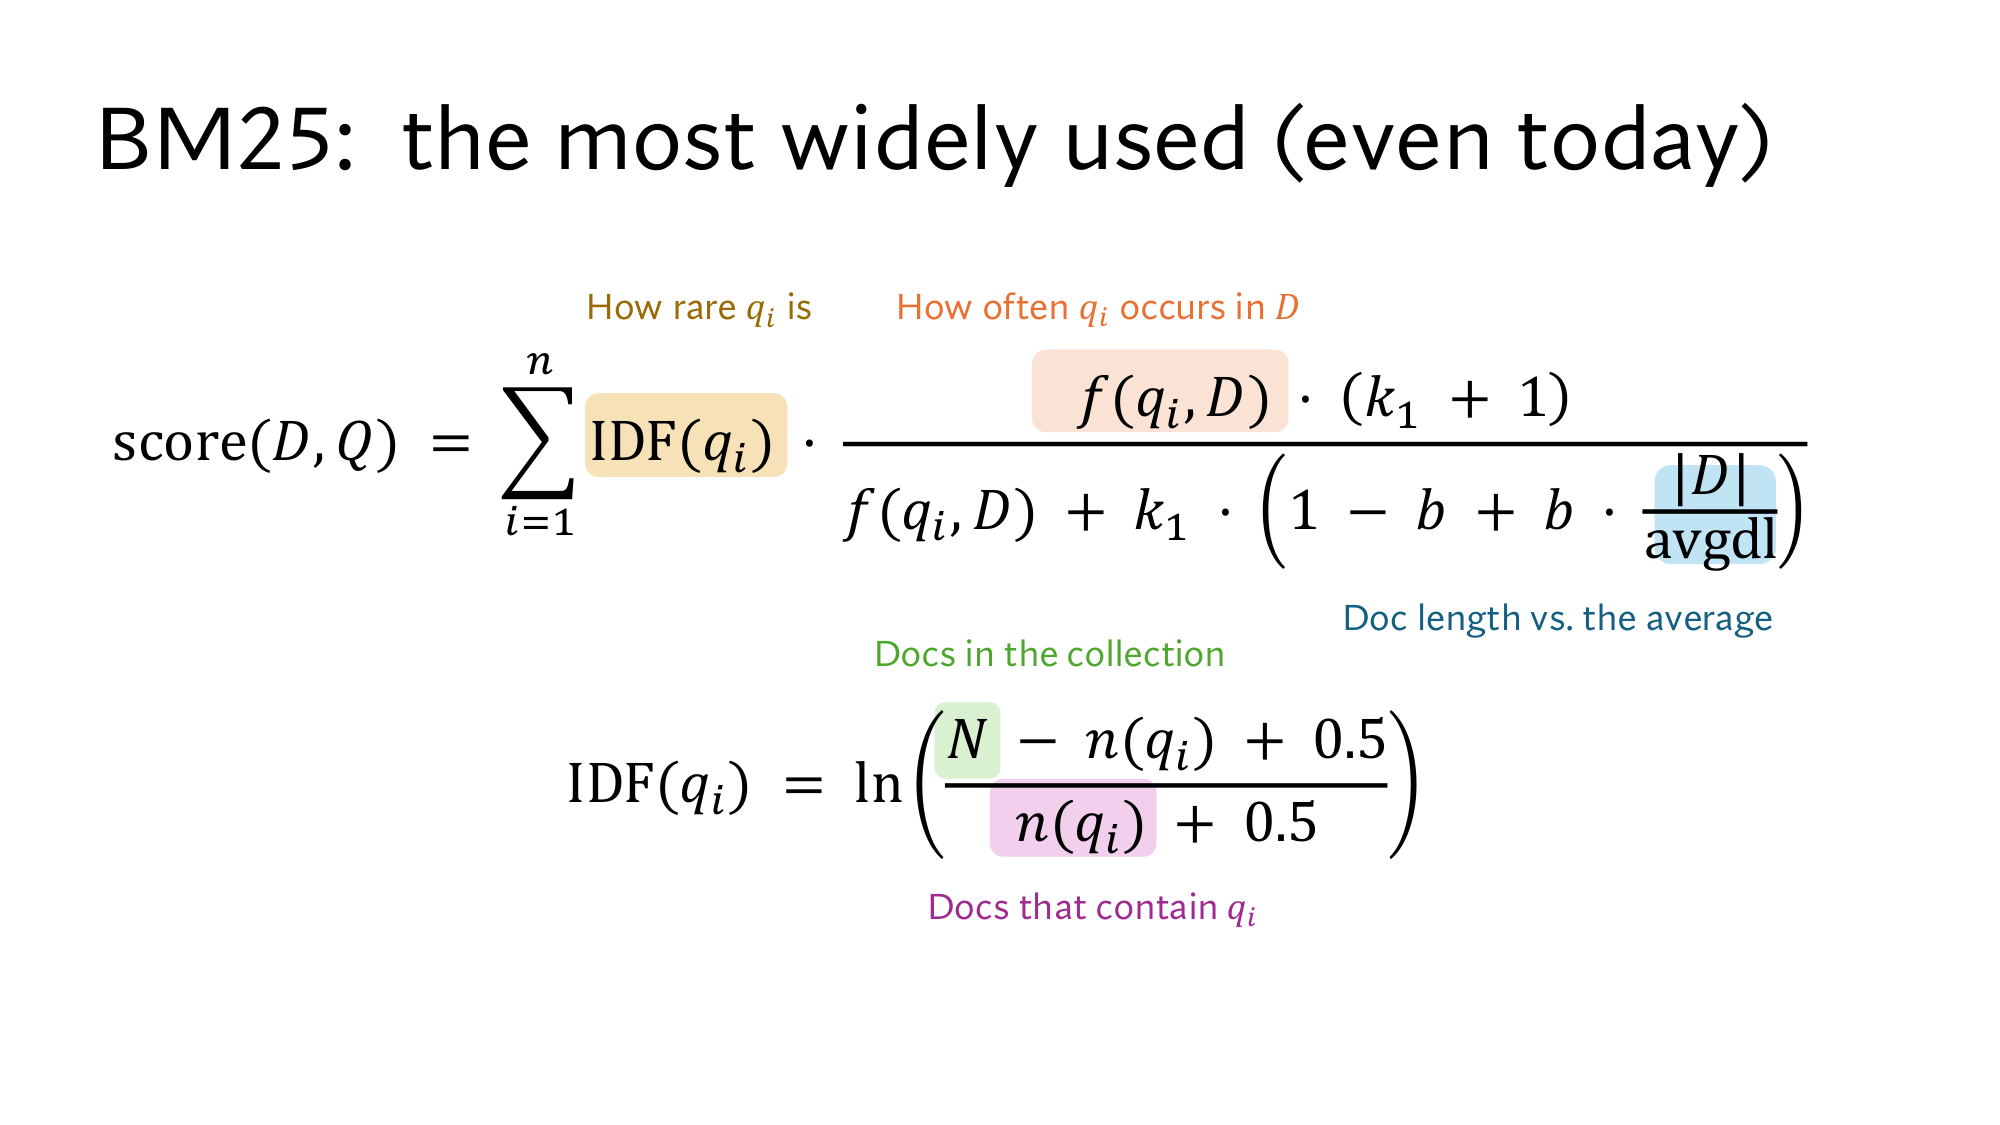
Stanford की slide यही हिसाब एक formula में लिखती है:
score(D, Q) = ∑i = 1 … n IDF(qi) · f(qi, D) · (k1 + 1)f(qi, D) + k1 · (1 − b + b · |D| ÷ avgdl)
lesson 3 से है। इसका मतलब है: नीचे लिखे i से ऊपर लिखे n तक, हर i के लिए आगे वाली चीज़ निकालिए, और सब जोड़ दीजिए। यहाँ i = 1 से 4 तक: 0.7703 + 1.7026 + 0 + 0 = 2.473। Formula में “·” गुणा का निशान है, D वो passage है जिसका score चाहिए, और qi query का i-वाँ term। बाकी हिस्से पड़ाव 1 से 3 के हैं।
Stanford की slide: BM25, the most widely used। रंग वाले हिस्से IDF, f और |D| ÷ avgdl हैं, और नीचे पड़ाव 1 का IDF formula है।
Office hours page वाली row आप निकालिए
Office hours page 16 शब्दों का है, और उसमें office एक बार है। उसका factor, TF हिस्सा और score कितना है?
Query चुनिए, और k1 और b बदलिए। तीन buttons पहले तीन पड़ाव हैं, और हर cell में term की f और उसका वज़न है।
Passage
|D|
Terms
Score
तीसरी query when can I get help from a TA पर हर score 0 है, और इसकी वजह पड़ाव 5 में आती है।
5Inverted index: BM25 तेज़ क्यों है, और कहाँ हारता है
Inverted index हर term के लिए उन passages की list है, जिनमें वो term आता है। BM25 ये lists , यानी सवाल आने से पहले, एक बार बनाता है। हमारी query के terms की lists ऐसी दिखती हैं:
office → office hours page, queue log
hour → queue log
least → पुराना forum post
crowded → पुराना forum post
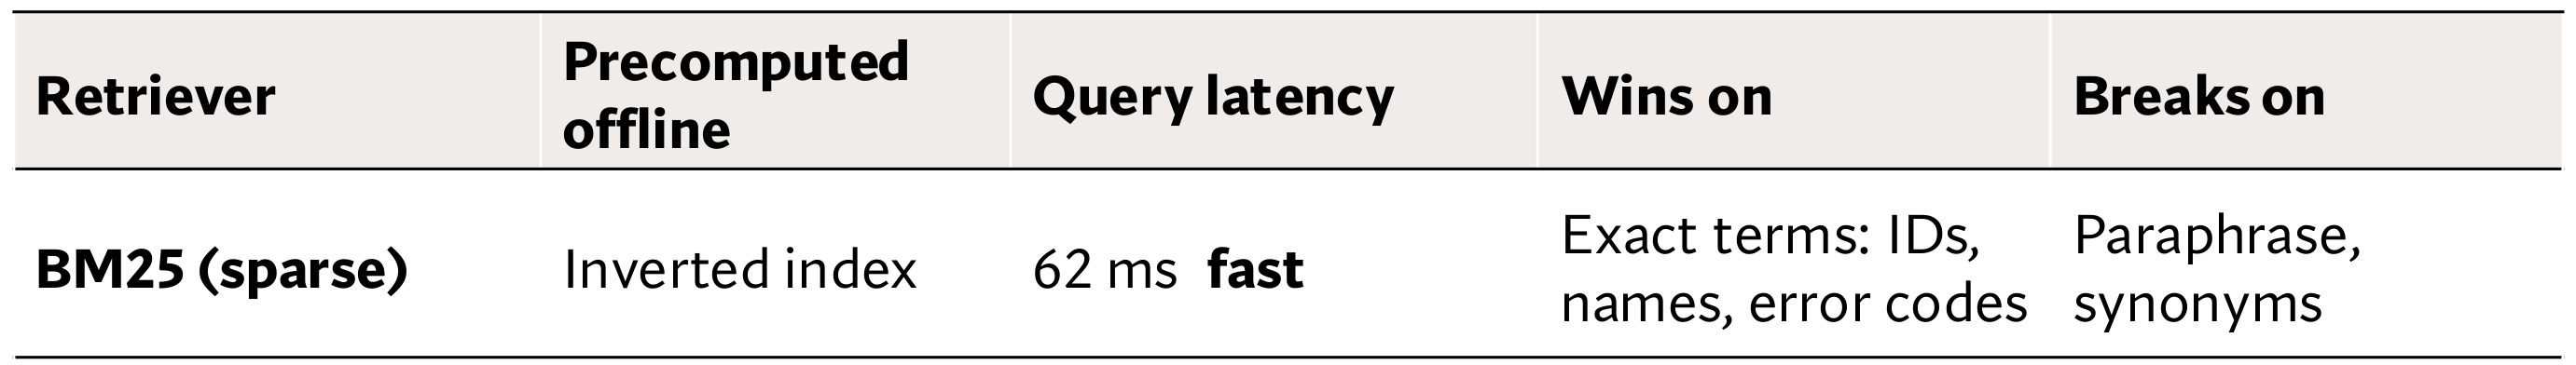
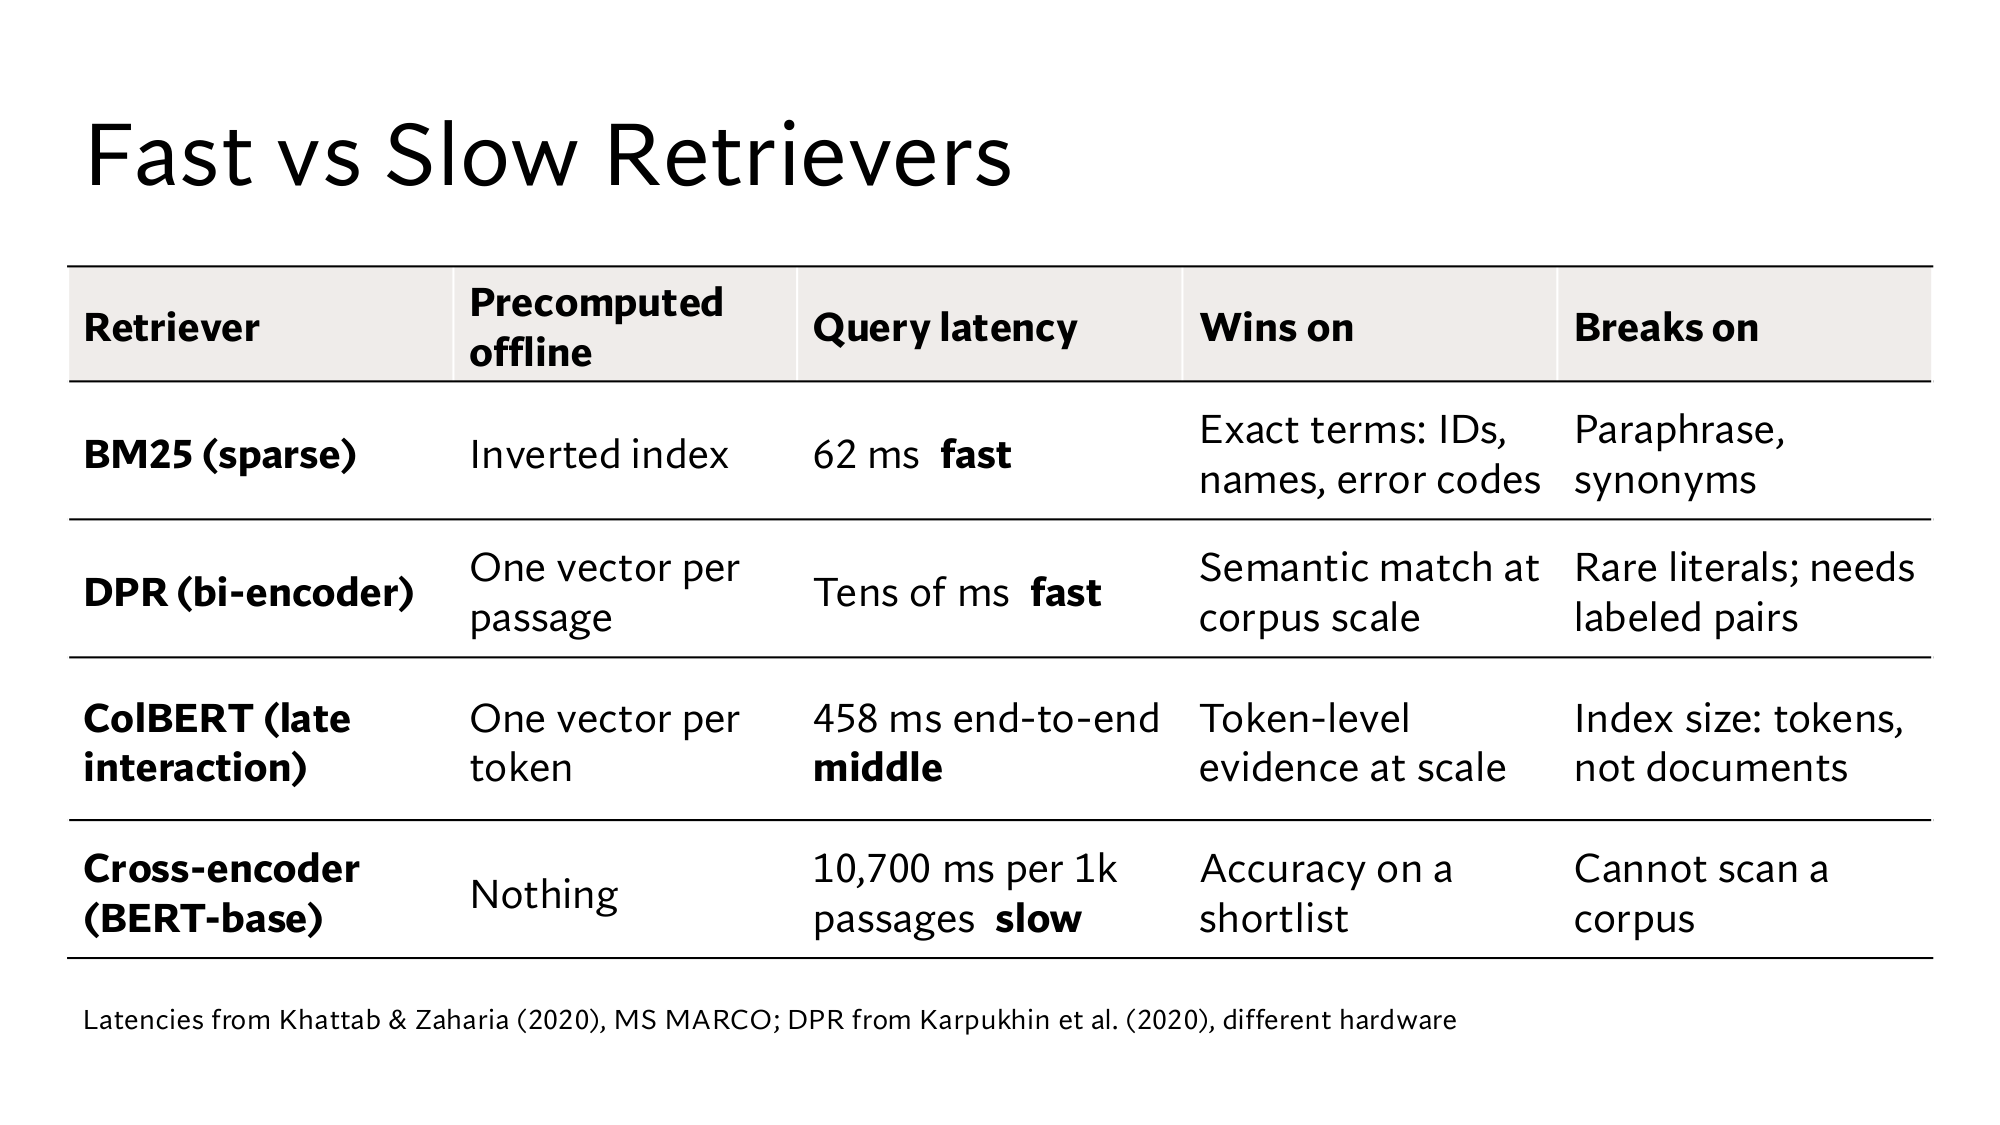
सवाल आने पर BM25 सिर्फ़ ये 4 lists खोलता है, और बाकी 3 passages को छूता भी नहीं। इसलिए वो तेज़ है, और Stanford की तुलना वाली slide में एक बड़े dataset पर 62 ms में जवाब देता है।
BM25 की नज़र में हर passage एक लंबा vector है, जिसमें vocabulary के हर शब्द की एक जगह है। हमारे 69 शब्दों में से forum post में 14 हैं, तो उसकी 55 जगहें 0 हैं, और ऐसे vector को sparse कहते हैं। Lesson 3 के dense हैं: 768 numbers, और लगभग कोई 0 नहीं।
Stanford की slide: Fast vs Slow Retrievers, उसकी BM25 वाली row। बाकी rows lesson 12, 14 और 15 में आती हैं।
उसी row के मुताबिक BM25 exact terms पर जीतता है, जैसे IDs, नाम और error codes। E-4012 जैसा code या तो passage में है या नहीं, और rare होने की वजह से उसका IDF ऊँचा है।
BM25 paraphrase और synonyms पर हारता है, यानी वही बात दूसरे शब्दों में। Widget की तीसरी query का जवाब office hours page में है, लेकिन वहाँ TAs लिखा है, ta नहीं, और help कहीं नहीं है। इसलिए हर score 0 आता है।
Forum post वाली गलती भी यहीं से आती है, क्योंकि BM25 सिर्फ़ शब्द गिनता है। Lesson 12 सवाल-passage जोड़ों से सीखने वाला retriever बनाता है, और lesson 14 दोनों की lists मिलाता है।
यहाँ से Stanford वाला level
ऊपर के पड़ाव आसान version जैसे ही हैं। आगे के पड़ाव Stanford की slides के level तक ले जाते हैं: symbols, graphs, k1 और b, असली पैमाना, और चारों slides।
6Slide के formula का हर symbol
Slide BM25 को दो formulas में लिखती है: एक पूरे score का, और एक IDF का। पड़ाव 4 में आपने score वाला formula पढ़ा था। ये पड़ाव दोनों formulas के हर symbol को queue log वाले number से जोड़ता है।
score(D, Q) = ∑i = 1 … n IDF(qi) · f(qi, D) · (k1 + 1)f(qi, D) + k1 · (1 − b + b · |D| ÷ avgdl)
IDF(qi) = ln N − n(qi) + 0.5n(qi) + 0.5
Slide पर कुछ हिस्सों के ऊपर रंगीन labels हैं। नीचे की table में वो labels भी हैं:
Symbol
मतलब
हमारे example में
Q, D
Query, और जिस passage का score चाहिए
हमारी query, और D = queue log
∑, i = 1 … n
Query के सारे n terms पर जोड़
n = 4
qi
Query का i-वाँ term
q1 = office, q2 = hour, q3 = least, q4 = crowded
IDF(qi)
Term का वज़न, label How rare qi is
office के लिए 0.588
f(qi, D)
Term passage में कितनी बार है, label How often qi occurs in D
office 2, hour 2, least 0, crowded 0
k1
Saturation का knob
1.2
b
Length के असर का knob
0.75
|D| ÷ avgdl
Passage की length बनाम औसत, label Doc length vs. the average
19 ÷ 16.17 = 1.175
N
Corpus में कुल documents, label Docs in the collection
6
n(qi)
कितने documents में term है, label Docs that contain qi
office के लिए 2
0.5
हर गिनती में जोड़ा गया छोटा number
office के लिए 4.5 ÷ 2.5
score(D, Q)
सारे terms के वज़न का जोड़
0.7703 + 1.7026 + 0 + 0 = 2.473
ध्यान दीजिए कि slide पर n दो जगह है। ∑ के ऊपर वाला n query के terms की गिनती है, और IDF के formula में n(qi) document frequency है। दोनों अलग चीज़ें हैं।
ऊपर वाला k1 + 1 क्या करता है
Numerator का k1 + 1 हर term के TF हिस्से को एक ही number, 2.2, से गुणा करता है। इसलिए हर passage का पूरा score भी 2.2 से गुणा होता है, और passages का क्रम नहीं बदलता। जैसे k1 + 1 हटा दें, तो forum post 2.749 ÷ 2.2 = 1.250 पर आता है, और queue log 2.473 ÷ 2.2 = 1.124 पर। Forum post फिर भी ऊपर है।
Robertson और Zaragoza बताते हैं कि कई versions k1 + 1 क्यों रखते हैं। इससे औसत length के passage में एक बार आए term का वज़न ठीक उसका IDF बनता है। paper से हमारे numbers पर: f = 1 और factor = 1 पर TF हिस्सा 2.2 ÷ 2.2 = 1 है, तो वज़न = IDF × 1।
Length का असर: पूरी table
पड़ाव 3 ने दो lengths के TF हिस्से बताए थे। f = 1, k1 = 1.2 और b = 0.75 पर तीन lengths की पूरी table ये है:
Passage की length
Factor
TF हिस्सा
औसत का आधा
0.25 + 0.75 × 0.5 = 0.625
1.257
औसत जितनी
0.25 + 0.75 × 1 = 1
1.000
औसत की दोगुनी
0.25 + 0.75 × 2 = 1.75
0.710
वही एक बार आया term छोटे passage में 1.257 पाता है, और लंबे में 0.710। जैसे दोगुनी length पर: 2.2 ÷ (1 + 1.2 × 1.75) = 2.2 ÷ 3.1 = 0.710। Queue log के लिए |D| ÷ avgdl = 1.175 है, यानी वो औसत से 17.5% लंबा है।
गिनती को length से छोटा करना
Length वाले factor को एक और तरह से पढ़ सकते हैं। इसके लिए भाग का एक नियम चाहिए: ऊपर और नीचे को एक ही number से भाग दें, तो भाग नहीं बदलता। जैसे 6 ÷ 3 = 2, और (6 ÷ 2) ÷ (3 ÷ 2) = 3 ÷ 1.5 = 2।
TF हिस्से के ऊपर और नीचे को factor से भाग दीजिए। तब नीचे का k1 × factor सिर्फ़ k1 रह जाता है, और f की जगह f ÷ factor आ जाता है:
मतलब BM25 पहले गिनती को length से छोटा करता है, फिर उस पर पड़ाव 2 वाला saturation लगाता है। Robertson और Zaragoza BM25 को ठीक इसी तरह लिखते हैं। paper से Queue log के office पर ये तीन steps में दिखता है:
छोटी हुई गिनती: 2 ÷ 1.1314 = 1.7677।
पड़ाव 2 का formula: ऊपर 1.7677 × 2.2 = 3.8889, नीचे 1.7677 + 1.2 = 2.9677।
Forum post में least की 1 बार की गिनती 1 ÷ 0.8995 = 1.1117 बनती है, और 1.1117 × 2.2 ÷ (1.1117 + 1.2) = 2.4457 ÷ 2.3117 = 1.0580। Length ने queue log की 2 गिनतियों को 1.77 जैसा बना दिया, और forum post की 1 गिनती को 1.11 जैसा।
7IDF के किनारे, और slide के दोनों graphs
Slide के बाएँ graph में BM25 का IDF और पुराना IDF हैं, और दाएँ में चार k1 के लिए TF हिस्सा। इन्हें पढ़ने के लिए पहले IDF के किनारे देखिए, यानी बहुत आम और बहुत rare terms। Graphs से exact numbers पढ़ना मुश्किल है, इसलिए ये पड़ाव वही numbers formulas से निकालता है। हिसाब मेरा
IDF के किनारे: ln के दो और नियम, negative IDF और TF-IDF
पड़ाव 1 में ln का एक नियम आया था: ln 1 = 0। Slide का IDF graph पढ़ने के लिए दो नियम और चाहिए:
1 से छोटे number का ln negative है, और उल्टे भाग का ln बस minus हो जाता है। जैसे ln 2 = 0.693, तो ln(1 ÷ 2) = −0.693, क्योंकि e−0.693 = 0.5।
गुणा का ln, ln का जोड़ है: ln(a × b) = ln a + ln b। जैसे ln 4 = ln(2 × 2) = 0.693 + 0.693 = 1.386।
दूसरे नियम का मतलब है कि भाग 10 गुना बढ़े, तो ln सिर्फ़ ln 10 = 2.303 बढ़ता है। इसलिए ln बहुत बड़े भागों को छोटे वज़नों में दबा देता है। 10,000 passages में से सिर्फ़ 1 में आने वाले term का भाग 9,999.5 ÷ 1.5 = 6,666 है, लेकिन उसका IDF सिर्फ़ 8.805।
पहले नियम से negative IDF निकलता है। जो term आधे से ज़्यादा passages में हो, उसका भाग 1 से छोटा है। जैसे 6 में से 5 passages वाले term का भाग 1.5 ÷ 5.5 है। ये milestone के भाग 5.5 ÷ 1.5 का उल्टा है, इसलिए उसका IDF −1.299 है। दूसरे छोर पर, जो term किसी passage में नहीं, उसके लिए 0.5 के बिना भाग 6 ÷ 0 बनता, जिसका कोई value नहीं।
BM25 से पुराने TF-IDF में वज़न ln(N ÷ n) है। N ÷ n बताता है कि term कितने passages में से एक में आता है। office 6 में से 2 में है, यानी हर 3 में से 1 में, तो उसका वज़न ln 3 = 1.099। ये वज़न कभी negative नहीं होता, और TF-IDF इसे सीधे गिनती से गुणा करता है: queue log में office के लिए 2 × 1.099 = 2.20।
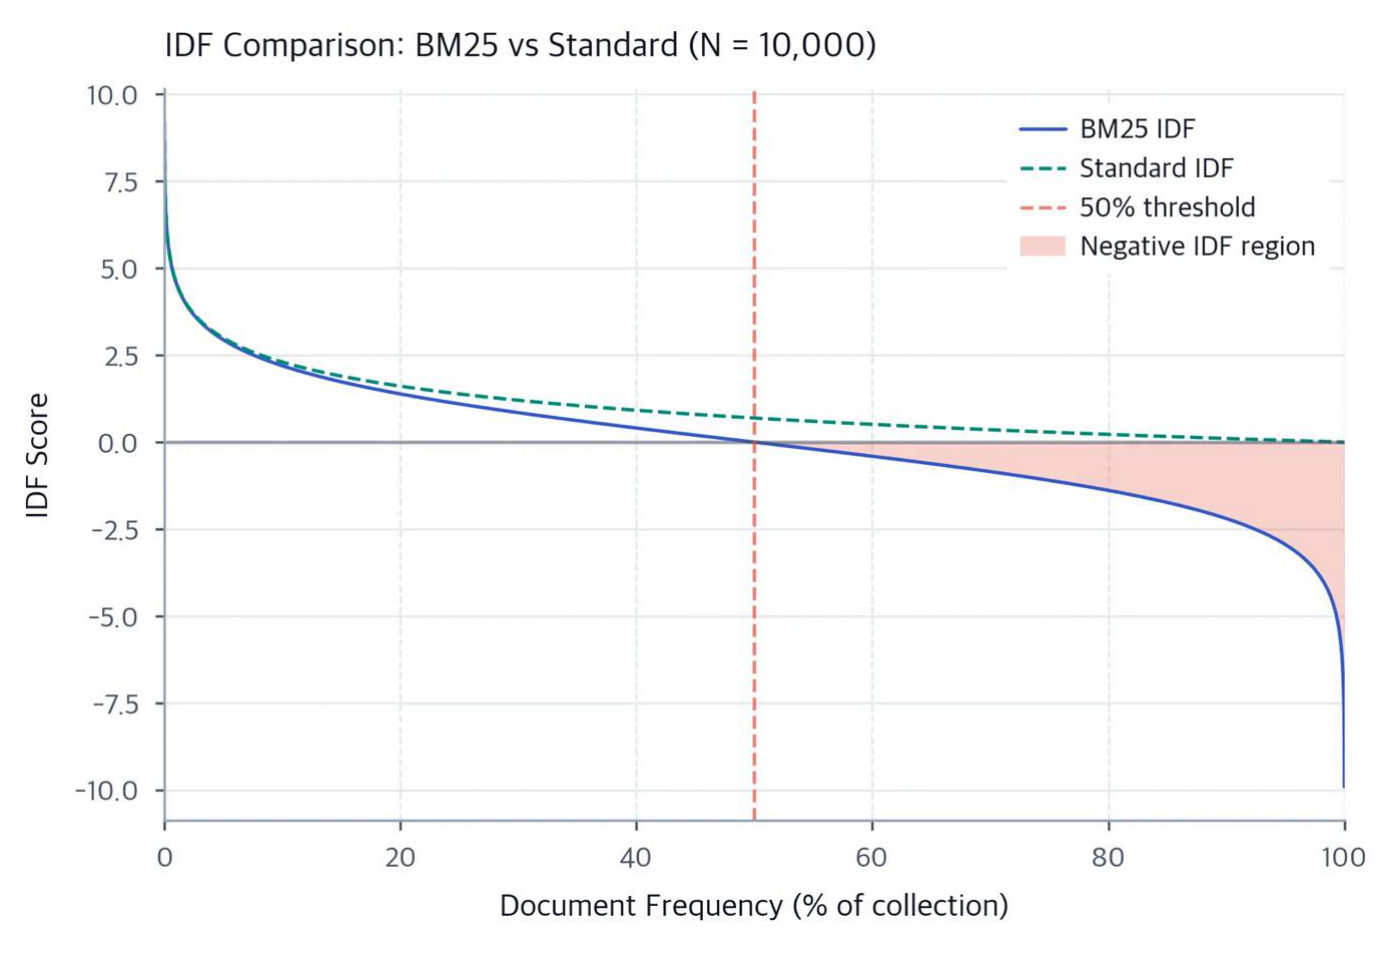
बायाँ graph: BM25 का IDF और पुराना IDF
बायाँ graph N = 10,000 documents पर है। नीली line BM25 का IDF है, और हरी dashed line standard IDF, यानी TF-IDF वाला ln(N ÷ n)। Graph के source code में यही दोनों formulas हैं। figure के source से Graph की x-axis पर term वाले documents का % है। जैसे 10% यानी 10,000 में से 1,000 documents।
Term कितने documents में
BM25 IDF
ln(N ÷ n)
0.01%n = 1
8.805
9.210
1%n = 100
4.590
4.605
10%n = 1,000
2.197
2.303
50%n = 5,000
0
0.693
90%n = 9,000
−2.197
0.105
100%n = 10,000
−9.904
0
10% वाली row का हिसाब: BM25 के लिए (10,000 − 1,000 + 0.5) ÷ (1,000 + 0.5) = 9,000.5 ÷ 1,000.5 = 8.996, और ln 8.996 = 2.197। Standard IDF के लिए 10,000 ÷ 1,000 = 10, और ln 10 = 2.303। Table से ये बातें दिखती हैं:
Rare terms पर दोनों लगभग बराबर हैं, इसलिए graph के बाएँ हिस्से में दोनों lines साथ चलती हैं।
50% पर BM25 का IDF ठीक 0 है, क्योंकि तब ऊपर और नीचे, दोनों 5,000.5 हैं, और ln 1 = 0। Graph की लाल dashed line यही 50% threshold है।
50% के बाद BM25 का IDF negative है, और यही graph का Negative IDF region है। 90% का भाग 10% के भाग का उल्टा है, इसलिए उल्टे भाग वाले नियम से IDF बस minus हो जाता है: +2.197 से −2.197।
Standard IDF कभी 0 से नीचे नहीं जाता, क्योंकि n कभी N से बड़ा नहीं होता, और 100% पर वो ln 1 = 0 है।
Negative IDF का मतलब है कि ऐसे term का मिलना passage का score घटाता है। Figure के source के मुताबिक कई implementations इसलिए negative IDF को 0 पर रोकते हैं, या ऐसे terms को score से पहले हटा देते हैं। figure के source से हमारे corpus में stopword the 3 passages में है, यानी ठीक आधे में, तो उसका IDF 0 है।
0.5 कहाँ से आया: RSJ weight का पूरा हिसाब
BM25 का IDF Robertson और Spärck Jones के एक पुराने वज़न से निकला है, जिसे RSJ weight कहते हैं। paper से RSJ weight चार गिनतियों से बनता है। N और n वही हैं। R उन documents की गिनती है, जो query के लिए सच में काम के हैं, यानी relevant। r बताता है कि उन relevant documents में से कितनों में term है।
w = ln (r + 0.5) · (N − R − n + r + 0.5)(n − r + 0.5) · (R − r + 0.5)
पहले मान लीजिए कि हमें पता है कि milestone वाले सवाल के लिए syllabus relevant है। तब R = 1 और r = 1, और N = 6, n = 1:
BM25 के पास ये जानकारी नहीं होती कि कौन सा document relevant है। तब R = 0 और r = 0 रखते हैं:
r + 0.5 = 0.5।
N − R − n + r + 0.5 = 6 − 0 − 1 + 0 + 0.5 = 5.5।
n − r + 0.5 = 1 + 0.5 = 1.5।
R − r + 0.5 = 0.5।
भाग: (0.5 × 5.5) ÷ (1.5 × 0.5) = 2.75 ÷ 0.75 = 3.667, और ln 3.667 = 1.299, यानी ठीक milestone का IDF।
दूसरे हिसाब में ऊपर और नीचे के 0.5 कट जाते हैं, और ln((N − n + 0.5) ÷ (n + 0.5)) बचता है। 0.5 के बिना यही हिसाब (0 × 5) ÷ (1 × 0) = 0 ÷ 0 बनता, जिसका कोई value नहीं। Paper इसी वजह से हर गिनती में 0.5 जोड़ता है, ताकि भाग और log कभी अटके नहीं। paper से
दायाँ graph: चार k1, चार curves
दायाँ graph पड़ाव 2 वाला TF हिस्सा चार k1 के लिए दिखाता है, बिना length के, यानी factor = 1 पर। हर curve की छत k1 + 1 है। Formula से कुछ points:
k1
f = 2
f = 10
f = 20
0.5छत 1.5
1.200
1.429
1.463
1.2छत 2.2
1.375
1.964
2.075
2.0छत 3
1.500
2.500
2.727
5.0छत 6
1.714
4.000
4.800
k1 = 5 और f = 20 वाली cell का हिसाब: ऊपर 20 × 6 = 120, नीचे 20 + 5 = 25, और भाग 120 ÷ 25 = 4.8। Graph में हर curve f = 0 पर 0 से शुरू होती है, और f = 1 पर 1 से गुज़रती है। फिर वो अपनी छत की तरफ़ झुकती है। k1 = 0.5 वाली curve जल्दी सपाट हो जाती है, और f = 20 पर अपनी छत 1.5 के बहुत पास है। k1 = 5 वाली curve f = 20 पर भी चढ़ रही है, क्योंकि 4.8 अभी छत 6 से काफ़ी नीचे है।
f = 1 पर हर curve 1 पर है, क्योंकि तब ऊपर और नीचे दोनों 1 + k1 हैं। छत तक कोई curve नहीं पहुँचती: k1 = 1.2 पर f = 100 पर भी हिस्सा 220 ÷ 101.2 = 2.174 है। हर अगली गिनती कितना जोड़ती है, ये भी देखिए। पहली बार 1.000, दूसरी बार 0.375, तीसरी बार 1.571 − 1.375 = 0.196, और दसवीं बार 1.964 − 1.941 = 0.023।
Paper के मुताबिक ये formula किसी गहरे model से सीधे नहीं निकला। BM25 बनाने वालों ने term की गिनती के एक probability model में saturation वाला आकार देखा। फिर उस आकार पर सबसे सीधा formula f ÷ (k + f) बैठाया। paper से
8k1 और b कौन चुनता है
k1 और b hyperparameters हैं: BM25 इन्हें data से नहीं सीखता, इन्हें search बनाने वाला चुनता है।Hyperparameter किसी formula या model का ऐसा number है, जिसे training नहीं बदलती। BM25 में कोई training है ही नहीं, इसलिए k1 और b ही उसके चुनने लायक numbers हैं।
आम तरीका ये है कि कुछ सवाल अलग रखिए, जिनके सही passages पता हैं। फिर k1 और b की कई values पर देखिए कि सही passages कितने ऊपर आते हैं, और सबसे अच्छी जोड़ी रखिए। सवालों के ऐसे set को dev set, यानी development set, कहते हैं। सही passages ऊपर आए या नहीं, ये नापना lesson 13 सिखाता है।
Robertson और Zaragoza के मुताबिक कई experiments में 0.5 से 0.8 तक का b, और 1.2 से 2 तक का k1 ठीक चलते हैं। साथ में वो कहते हैं कि सबसे अच्छी values documents और queries की किस्म पर टिकी हैं। paper से
b को 0 और 1 के बीच रखने की वजह भी paper देता है। कोई document लंबा दो वजहों से होता है। एक, लिखने वाला वही बात ज़्यादा शब्दों में कहता है, और तब गिनती को length से पूरा भाग देना ठीक है, यानी b = 1। दो, document में सच में ज़्यादा बातें हैं, और तब length से भाग देना गलत है, यानी b = 0। असली documents में दोनों वजहें मिली होती हैं। paper से
DPR paper ने Wikipedia के passages पर Lucene का BM25 चलाया, और dev sets पर k1 = 0.9 और b = 0.4 चुने। ये दोनों values ऊपर वाली range से बाहर हैं। paper से इन values पर भी हमारी query का क्रम नहीं बदलता: forum post 2.666 और queue log 2.420। हिसाब मेरा
पहले सोचिए
पड़ाव 4 के widget में b = 0 कीजिए, और k1 को 1.2 से 1.3 पर ले जाइए। Forum post और queue log का क्या होगा, और क्यों?
जवाब देखिए
Queue log 2.630 के साथ forum post (2.599) से ऊपर आ जाता है। b = 0 पर length का असर नहीं है, और k1 बढ़ने पर queue log की दो-दो बार वाली गिनती का वज़न बढ़ता है। b = 0 पर क्रम k1 ≈ 1.21 पर पलटता है।
b = 0.75 पर इसके लिए k1 करीब 3.13 चाहिए। Widget का slider 3 तक जाता है, और वहाँ forum post अब भी 2.810 बनाम 2.799 से आगे है।
ये पलटना queue log के data की वजह से नहीं हुआ। Queue log में office hour दो बार लिखा है, और k1 बढ़ने पर दोहराव का वज़न बढ़ा। Search बनाने वाला k1 और b पूरे corpus के लिए एक बार चुनता है, हर सवाल के लिए अलग नहीं। जो setting इस सवाल पर queue log को ऊपर लाती है, वो दूसरे सवालों पर गलत passages को भी ऊपर ला सकती है। जैसे वो passages, जिनमें कोई शब्द बार-बार भरा है।
पहले सोचिए
आपकी company के help center में एक Complete user guide है, जो वहाँ के औसत article से 10 गुना लंबा है। उसमें हर आम term करीब 20 बार आता है, और वो लगभग हर query पर सबसे ऊपर आता है। k1 और b किस तरफ़ बदलेंगे?
जवाब देखिए
b बढ़ाइए, और k1 घटाइए। k1 = 1.2 और b = 0.75 पर guide का factor 0.25 + 0.75 × 10 = 7.75 है, और TF हिस्सा 20 × 2.2 ÷ (20 + 1.2 × 7.75) = 44 ÷ 29.3 = 1.502। औसत length वाले article में term एक बार है, तो उसका हिस्सा 1.000 है।
b = 1 पर guide का factor 10 है, और हिस्सा 44 ÷ (20 + 12) = 1.375। साथ में k1 = 0.5 करने पर हिस्सा 20 × 1.5 ÷ (20 + 0.5 × 10) = 30 ÷ 25 = 1.200। Article 1.000 पर ही रहता है, इसलिए फ़र्क 0.502 से घटकर 0.200 रह गया। फिर dev set पर नापिए कि सही articles ऊपर आए या नहीं।
9असली पैमाने पर BM25
असली inverted index में हर term की list की हर entry में passage के साथ उसकी f भी रहती है। हमारी query के terms की lists ऐसी दिखती हैं:
office → (office hours page, f = 1), (queue log, f = 2)
hour → (queue log, f = 2)
least → (पुराना forum post, f = 1)
crowded → (पुराना forum post, f = 1)
List की लंबाई ही n है, जैसे office की list में 2 entries हैं, तो n = 2, और उससे IDF निकलता है। Index हर passage की |D| और corpus का avgdl भी रखता है। सवाल आने पर BM25 4 lists में कुल 5 entries पढ़ता है, और सिर्फ़ 3 passages के score बनाता है।
BM25 को sparse vectors के dot product की तरह लिखना
DPR paper के मुताबिक TF-IDF और BM25 सवाल और passage को बहुत लंबे sparse vectors की तरह देखते हैं। इन vectors में हर शब्द का अपना वज़न है। paper से इसे समझने के लिए lesson 3 का चाहिए। Dot product में दोनों vectors के एक ही जगह वाले numbers का गुणा करते हैं, और सब जोड़ते हैं। जैसे [1, 0, 1] और [2, 5, 3] का dot product 1 × 2 + 0 × 5 + 1 × 3 = 5 है।
हमारे corpus पर vocabulary के 69 शब्दों के लिए 69 numbers वाला vector बनाइए। Passage के vector में हर शब्द की जगह उसका वज़न है, यानी IDF × TF हिस्सा, और जो शब्द passage में नहीं, उसकी जगह 0। Query के vector में query के 4 terms की जगह 1 है, और बाकी 65 जगह 0।
इन दोनों का dot product ठीक BM25 score है, क्योंकि गुणा सिर्फ़ उन जगहों पर 0 से अलग है, जहाँ दोनों vectors में number है। Forum post पर ये least और crowded वाली दो जगहें हैं: 1 × 1.3747 + 1 × 1.3747 = 2.749। बाकी 67 जगहों पर कम से कम एक तरफ़ 0 है। Inverted index असल में इन sparse vectors को term के हिसाब से रखने का तरीका है, ताकि 0 वाली जगहें पढ़नी ही न पड़ें।
62 ms किस data पर नपा
Stanford की तुलना वाली slide के नीचे लिखा है कि latencies Khattab और Zaharia (2020) के ColBERT paper से हैं, MS MARCO पर। उस paper में 62 ms Anserini के BM25 का number है, और Anserini, Lucene पर बना एक search toolkit है। paper से
MS MARCO में web pages के 88 लाख passages हैं, जो Bing पर लोगों के 10 लाख असली सवालों के results से इकट्ठे हुए। Paper में हर query पर इन 88 लाख में से top 1,000 passages लौटे, और latency एक CPU thread पर नपी। Paper के मुताबिक BM25 इतना तेज़ इसलिए है, क्योंकि उसके steps सस्ते हैं, और ऐसी search पर दशकों से काम हुआ है। paper से
DPR paper में Lucene का BM25 एक CPU thread पर हर second 23.7 सवाल निपटाता है। 1 second = 1,000 ms, तो हर सवाल पर 1,000 ÷ 23.7 = 42 ms लगते हैं। उसका inverted index 2.1 करोड़ passages पर करीब 30 minute में बनता है। DPR के vectors और index में 8.8 + 8.5 = 17.3 घंटे लगते हैं। paper से दोनों papers का hardware और corpus अलग है। इसलिए 62 ms और 42 ms की सीधी तुलना नहीं बनती, बस दोनों दसियों ms में हैं।
Papers में BM25 की ताकत और कमज़ोरी
DPR paper कहता है कि BM25 जैसे तरीके बहुत खास keywords और phrases को अच्छी तरह पकड़ते हैं। paper से Slide की row के IDs, नाम और error codes ऐसे ही शब्द हैं। उसी paper का एक example कमज़ोरी दिखाता है। सवाल है: Who is the bad guy in lord of the rings? इसका जवाब इस passage में है: Sala Baker is best known for portraying the villain Sauron in the Lord of the Rings trilogy.
सवाल bad guy कहता है, और passage villain। इसलिए paper के मुताबिक term-based system को ये passage ढूँढने में दिक्कत होगी। Dense retriever bad guy और villain के vectors को पास ला सकता है। paper से ये slide के Breaks on: Paraphrase, synonyms का असली example है।
10अब Stanford की slides खुद पढ़िए
नीचे BM25 की चार slides हैं, वैसी की वैसी। हर slide के नीचे कुछ सवाल हैं। पहले खुद जवाब सोचिए, फिर खोलिए। कोई symbol अटके, तो जवाब में लिखे पड़ाव पर लौट जाइए।
Phone पर slide छोटी दिखे, तो image पर click कीजिए। वो पूरे size में खुलेगी।
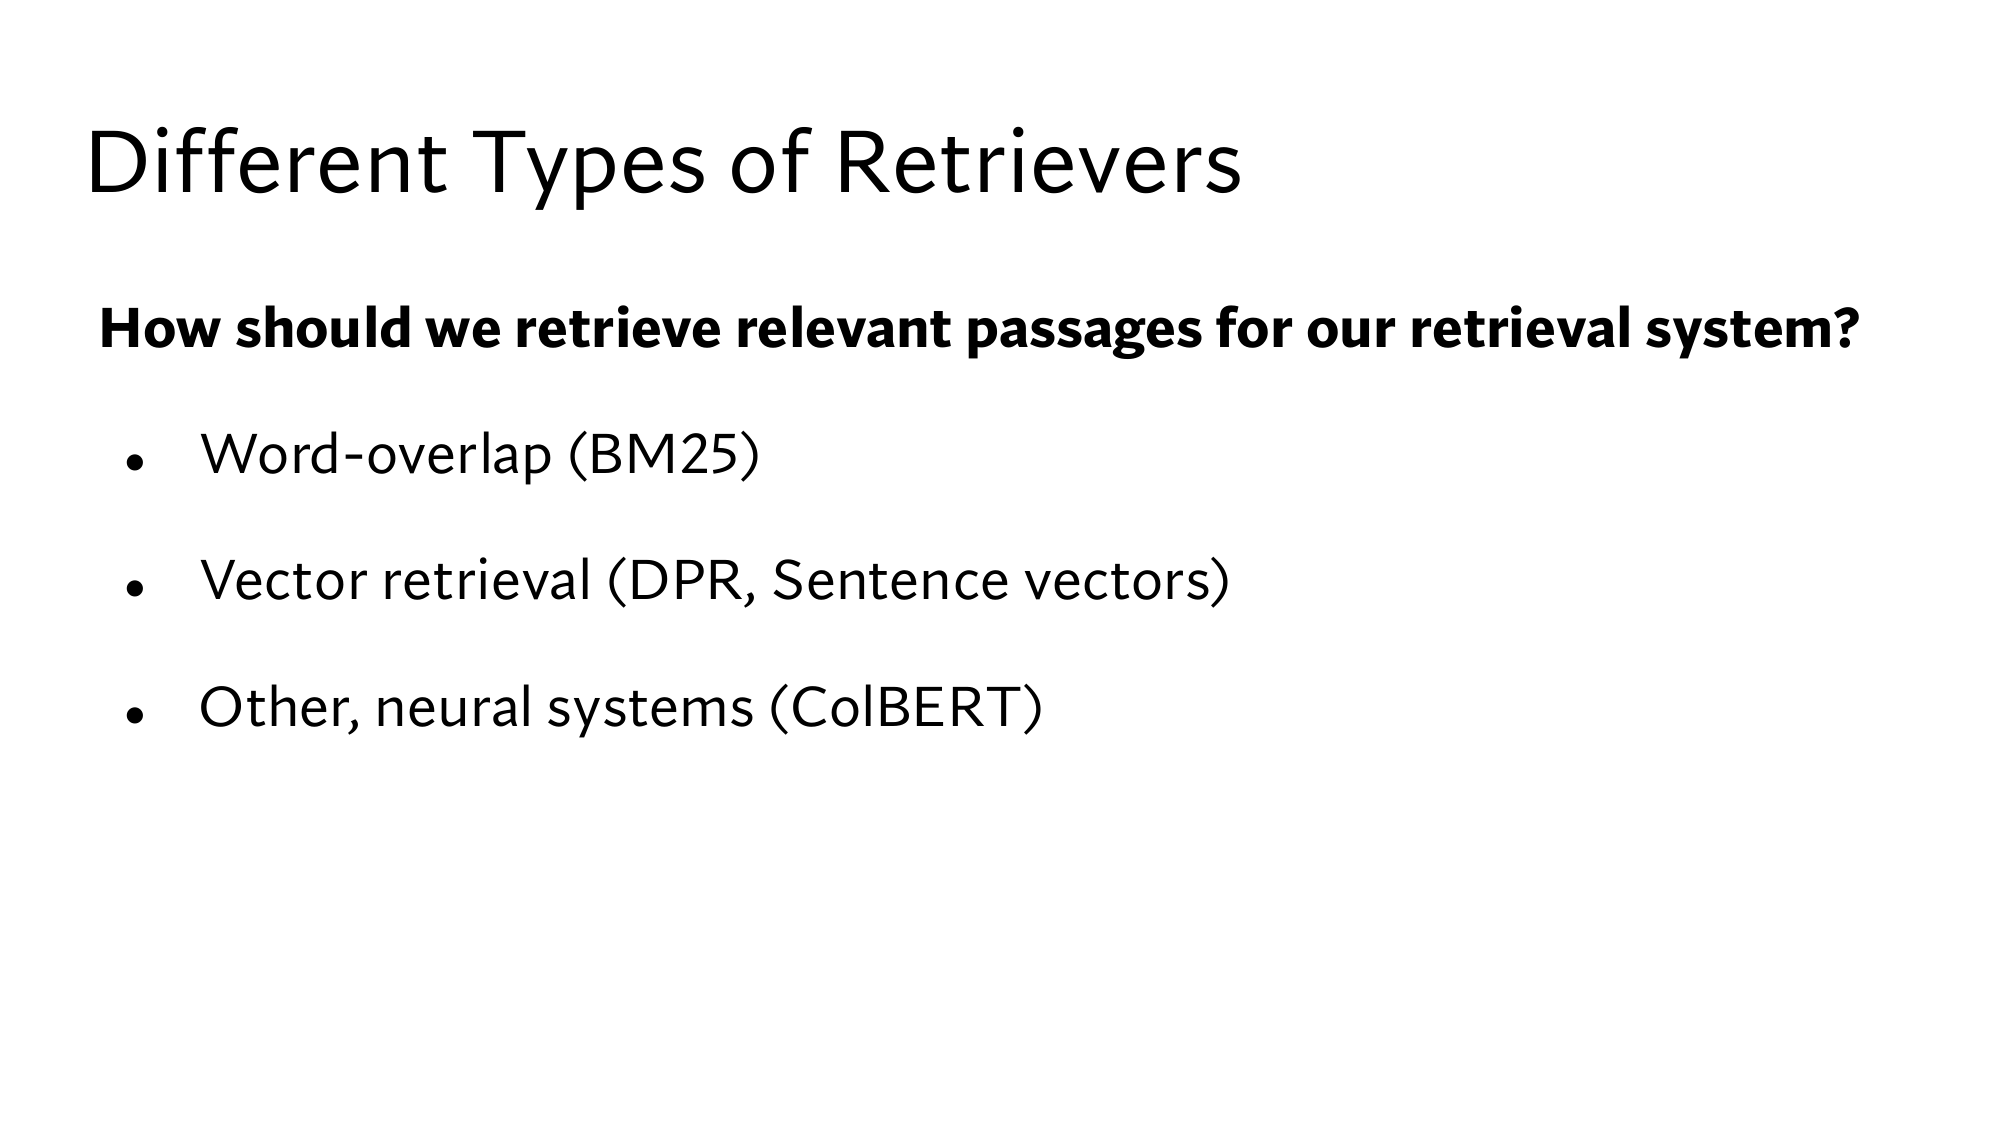
Stanford की slide: Different Types of Retrievers।
Retrievers की किस्मों वाली slide पढ़िए
Slide BM25 को word-overlap कहती है। Lesson 2 के word overlap से BM25 में कौन सी तीन बातें नई हैं?
जवाब देखिए
Rare terms को ज़्यादा वज़न (IDF), गिनती का फ़ायदा एक छत तक (k1), और लंबे passages का हिस्सा घटाना (b)। k1 = 0 पर BM25 सिर्फ़ IDF के वज़न वाला word overlap बचता है। (पड़ाव 1, 2 और 3)
Word-overlap और vector retrieval में score किस चीज़ से बनता है?
जवाब देखिए
BM25 में score उन्हीं terms से बनता है, जो query और passage दोनों में हूबहू हैं, यानी लंबे sparse vectors का dot product। Vector retrieval में encoder हर text का छोटा dense vector बनाता है, और score उन vectors का dot product है। (पड़ाव 5 और 9)
Stanford की slide: BM25, the most widely used, और नीचे उसके दोनों formulas, बड़े करके।
BM25 वाली slide पढ़िए
पीले box वाला IDF(qi) hour के लिए कितना है? उसमें हरे और गुलाबी box के numbers क्या हैं?
जवाब देखिए
हरा N = 6 है, और गुलाबी n(hour) = 1, क्योंकि hour सिर्फ़ queue log में है। IDF = ln((6 − 1 + 0.5) ÷ (1 + 0.5)) = ln(5.5 ÷ 1.5) = 1.299। (पड़ाव 1 और 6)
नीले box का |D| ÷ avgdl queue log के लिए कितना है, और उसके आसपास का पूरा bracket कितना बनता है?
ऊपर वाला (k1 + 1) हटा दें, तो क्या passages का क्रम बदलेगा?
जवाब देखिए
नहीं। हर term का हिस्सा 2.2 से भाग होता है, इसलिए हर score 2.2 से भाग होता है। Forum post 1.250 पर, और queue log 1.124 पर आता है, और क्रम वही रहता है। (पड़ाव 6)
Stanford की slide: IDF Comparison and Term Frequency Saturation, और नीचे उसके दोनों graphs, बड़े करके।
Graphs वाली slide पढ़िए
बाएँ graph में नीली line ठीक 50% पर 0 को क्यों काटती है?
जवाब देखिए
50% पर n = N ÷ 2 है, तो ऊपर N − n + 0.5 और नीचे n + 0.5 बराबर हैं। भाग 1 है, और ln 1 = 0। (पड़ाव 1 और 7)
हरी dashed line कभी 0 से नीचे क्यों नहीं जाती, और 100% पर दोनों lines कहाँ हैं?
जवाब देखिए
हरी line ln(N ÷ n) है, और n कभी N से बड़ा नहीं होता, इसलिए भाग कम से कम 1 है। 100% पर वो ln 1 = 0 पर है। नीली line वहाँ formula के हिसाब से ln(0.5 ÷ 10,000.5) = −9.904 तक गिरती है। (पड़ाव 7)
दाएँ graph की चारों lines f = 1 पर एक ही point से क्यों गुज़रती हैं? और k1 = 5 वाली line किस height की तरफ़ जा रही है?
जवाब देखिए
f = 1 पर हिस्सा (k1 + 1) ÷ (1 + k1) = 1 है, k1 कुछ भी हो। k1 = 5 वाली line अपनी छत 6 की तरफ़ जा रही है, और f = 20 पर 4.8 पर है। Graph में length नहीं है, यानी ये factor = 1 वाली हालत है। (पड़ाव 2 और 7)
Stanford की slide: Fast vs Slow Retrievers, और नीचे उसकी BM25 वाली row, बड़ी करके। बाकी rows lesson 12, 14 और 15 में आती हैं।
तुलना वाली slide पढ़िए
Precomputed offline column में BM25 के आगे Inverted index है। हमारे corpus में query आने से पहले क्या-क्या बन चुका होता है?
जवाब देखिए
हर term की list, जिसकी हर entry में passage और उसकी f है। List की लंबाई से n, और उससे IDF। साथ में हर passage की |D| और avgdl = 16.17। (पड़ाव 5 और 9)
62 ms किस हालत में नपा, और DPR paper का BM25 कितना तेज़ था?
जवाब देखिए
Anserini का BM25, MS MARCO के 88 लाख passages, हर query पर top 1,000, और एक CPU thread। DPR paper में Lucene का BM25 हर second 23.7 सवाल निपटाता है, यानी करीब 42 ms हर सवाल पर। Slide खुद लिखती है कि DPR वाले numbers अलग hardware के हैं। (पड़ाव 9)
Wins on और Breaks on वाले cells को हमारे corpus से दिखाइए।
जवाब देखिए
E-4012 जैसा rare code किसी एक passage में हो, तो उसका IDF ऊँचा है, और वो passage ऊपर आता है। when can I get help from a TA पर हर score 0 है। जवाब वाले page पर TAs लिखा है, और help है ही नहीं। (पड़ाव 1 और 5)
इस lesson की 3 बातें
BM25 score = हर query term का IDF × TF हिस्सा, फिर सब terms का जोड़। IDF rare terms को वज़न देता है, k1 गिनती को saturate करता है, और b गिनती को length से छोटा करता है।
k1 और b hyperparameters हैं, जिन्हें dev set पर पूरे corpus के लिए चुनते हैं। हमारी query पर आम values से forum post ऊपर रहता है। b = 0 और k1 = 1.3 पर queue log ऊपर आता है, लेकिन सिर्फ़ दोहराव की वजह से।
Inverted index की वजह से BM25 सिर्फ़ query के terms की lists पढ़ता है। इसलिए वो दसियों ms में चलता है, और exact terms पर भरोसेमंद है। अलग शब्दों वाली query पर वो हारता है, और passage में data है या राय, ये नहीं देखता।
इस lesson के नए शब्द
Term
Search में query का एक शब्द। जैसे which office hour में office और hour।
Document frequency, n(q)
कितने documents में term q है। जैसे milestone का n = 1, और office का 2।
IDF
ln((N − n + 0.5) ÷ (n + 0.5)), rare term का बड़ा वज़न। जैसे milestone का 1.299, और office का 0.588।
TF-IDF
Term की गिनती × ln(N ÷ n), BM25 से पुराना तरीका। जैसे N = 6, n = 2, f = 2 पर 2 × ln 3 = 2.20।
Term frequency, f(q, D)
Term q document D में कितनी बार है। जैसे queue log में office की f = 2।
Saturation और k1
गिनती बढ़ने पर फ़ायदा धीरे-धीरे भरता है, k1 + 1 की छत तक। जैसे k1 = 1.2 पर f = 1, 2, 10 का हिस्सा 1.000, 1.375, 1.964।
Length normalization, b और avgdl
औसत से लंबे documents का TF हिस्सा घटाना, b जितना असर। जैसे avgdl = 16.17 और b = 0.75 पर दोगुने लंबे document का हिस्सा 0.710।
BM25
हर query term का IDF × TF हिस्सा, सब terms का जोड़। जैसे forum post का 2.749, और queue log का 2.473।
Hyperparameter
Formula या model का ऐसा number, जिसे training नहीं बदलती, और जिसे dev set पर आज़माकर चुनते हैं। जैसे BM25 के k1 और b, जिन्हें DPR paper ने 0.9 और 0.4 चुना।
Inverted index
हर term के documents की list। जैसे office → office hours page, queue log।
Sparse और dense vector
ज़्यादातर 0 वाला लंबा vector, और लगभग पूरा भरा छोटा vector। जैसे forum post के vector की 69 में से 55 जगहें 0 हैं।