Document को chunks में काटते ही हर chunk अपने आस-पास का text खो देता है, और अक्सर वही text बताता था कि बात किसकी है। ये lesson ये context लौटाने के दो तरीके सिखाता है। Contextual retrieval में एक LLM हर chunk का context लिखता है, और late chunking में encoder पहले पूरा document पढ़ता है।
Lesson 7 में queue log का chunk office hour averaged 3. नहीं बताता था कि किस दिन की बात है। ये lesson यही दिक्कत 50 companies की filings पर देखता है।
इस lesson की सीढ़ी
सीढ़ी में 9 पड़ाव हैं। पहले 4 आसान version जैसे ही हैं, और 5 से 9 आपको Stanford की slides के level तक ले जाते हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
Context lossगिनकर दिखा पाएँगे कि ACME वाला chunk top-20 में सिर्फ़ 40% बार क्यों आता है।
Contextual retrievalScore के 1 से 5 होने का हिसाब, और failures के 5.7% से 2.9% पर आने का मतलब समझा पाएँगे।
Late chunkingNaive और late chunking के vectors हाथ से निकाल पाएँगे, और cosine से उनका फ़र्क दिखा पाएँगे।
पहले से क्या चाहिए: Lesson 2 (word overlap), Lesson 3 (embedding, cosine) और Lesson 7 (chunk, contextual embedding, mean pooling)। पड़ाव 5 से आगे Lesson 4 (conditional probability), Lesson 6 (rerank) और Lesson 11 (TF-IDF, BM25) भी काम आते हैं। Lesson 13 (Recall@k, nDCG) और Lesson 14 (hybrid search, attention) इस lesson के बाद आते हैं, लेकिन उनके शब्द यहाँ भी काम आते हैं। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1Context loss: काटने के बाद chunk नहीं बताता कि बात किसकी है
Context loss का मतलब है: काटने के बाद chunk में वो शब्द नहीं बचते, जो बताते कि बात किसकी है। document का वो टुकड़ा है, जिसे retriever लौटाता है। नाम अक्सर document में सबसे ऊपर एक बार आता है, इसलिए नीचे वाले chunks नाम के बिना रह जाते हैं।
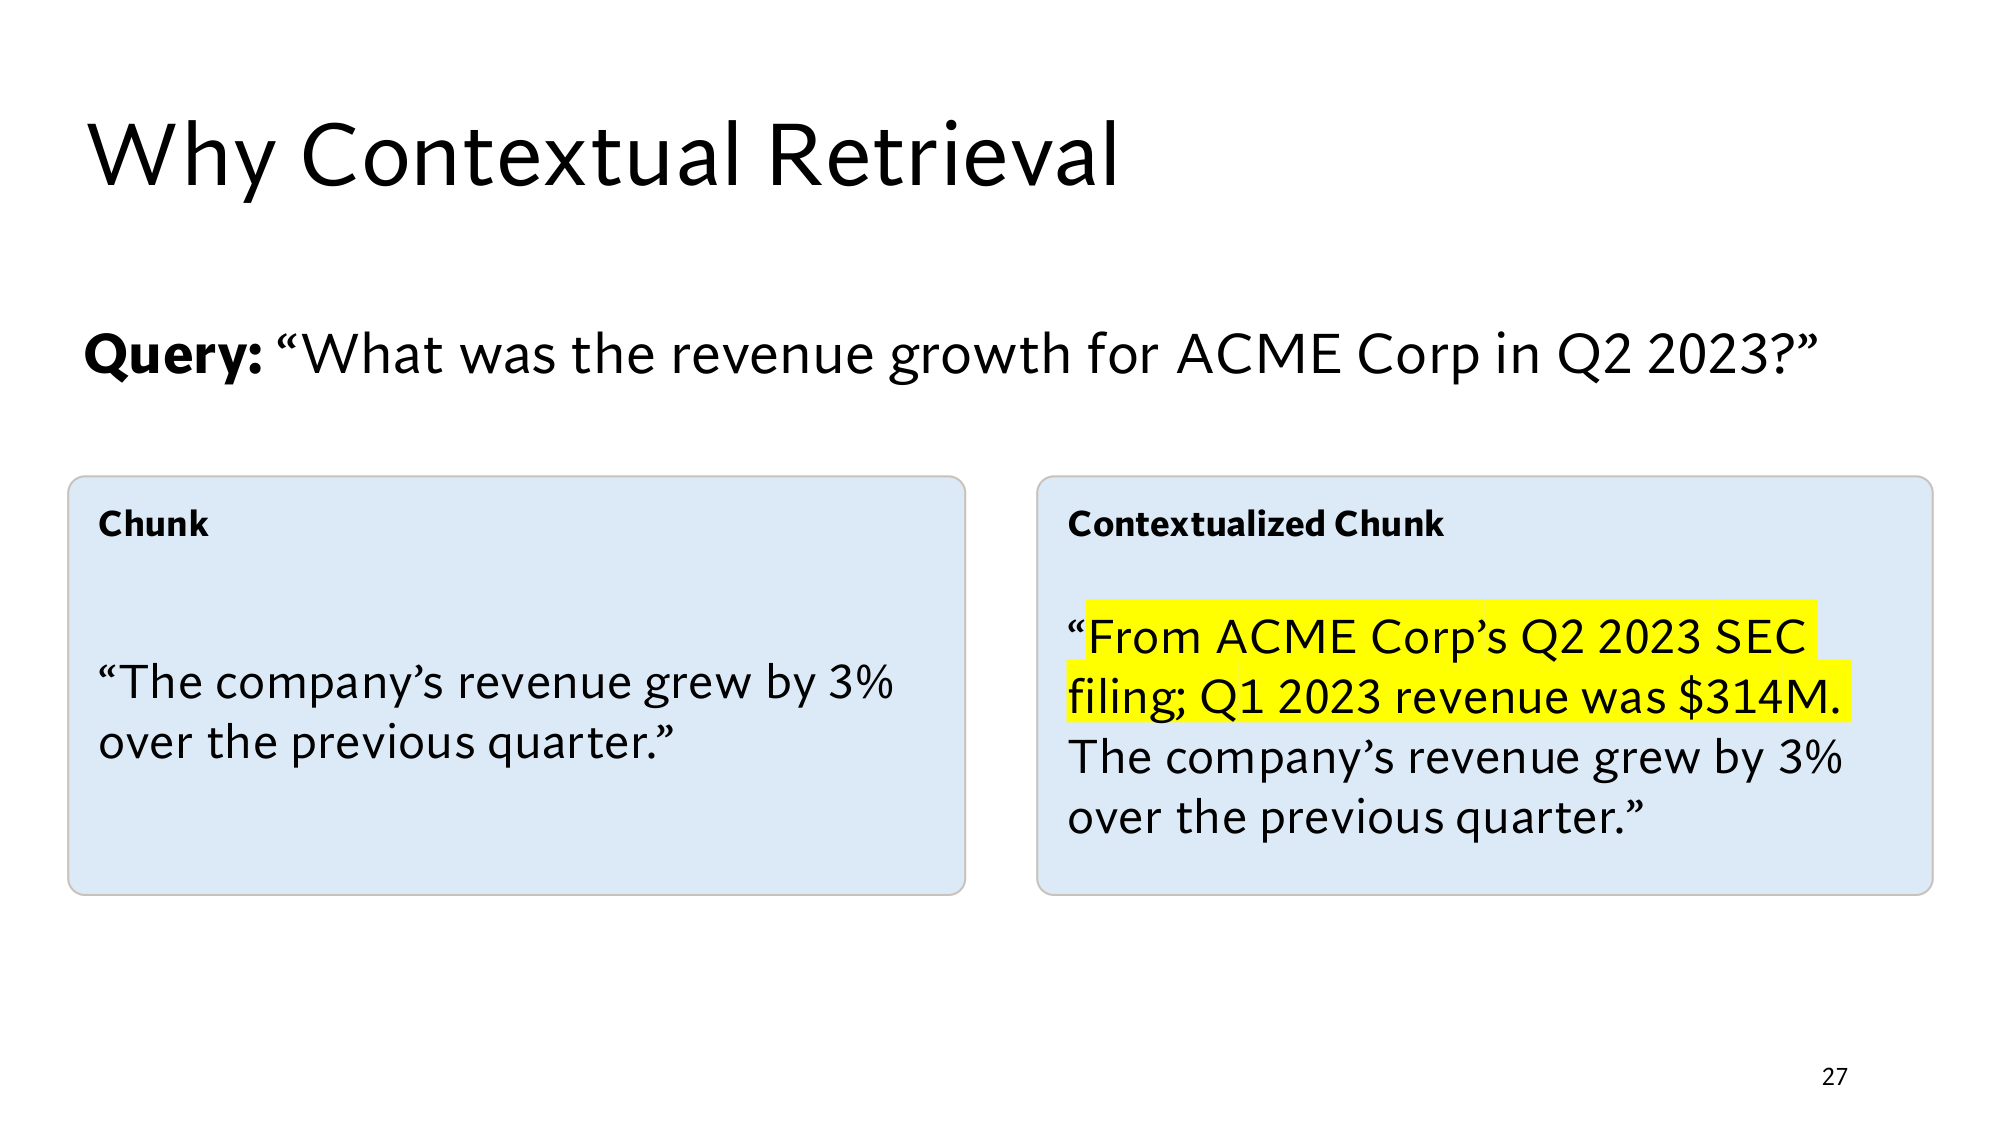
Slides का example लीजिए। Corpus में 50 companies की Q2 2023 वाली filings हैं, हर company की एक। 50 companies मेरा example है हर filing में लगभग यही line है: The company’s revenue grew by X% over the previous quarter. Query है: What was the revenue growth for ACME Corp in Q2 2023? ACME की filing में नाम और quarter सबसे ऊपर लिखे हैं, इसलिए जवाब वाले chunk में न ACME है, न Q2 2023।
अब lesson 2 के से गिनिए, यानी query के कितने शब्द chunk में भी हैं। वहाँ queue log का score 2 था, क्योंकि उसमें office और hour थे। What, was, the, for और in जैसे हटाने पर query के 6 शब्द बचते हैं: revenue, growth, ACME, Corp, Q2 और 2023। ACME वाले chunk में सिर्फ़ revenue है, क्योंकि उसमें growth नहीं, grew लिखा है। इसलिए उसका score 1 है, और बाकी 49 chunks का भी 1। ये गिनती मेरी है
पहले सोचिए
पचासों chunks का score 1 है, और बराबर score वाले chunks का क्रम random है। Retriever top-20 लौटाता है। ACME वाला chunk कितने % बार top-20 में आएगा?
जवाब देखिए
बराबरी में ACME वाला chunk 50 में से हर जगह पर बराबर मौके से आ सकता है। इनमें से 20 जगहें top-20 में हैं, इसलिए मौका 20 ÷ 50 = 0.4, यानी 40% है। बाकी 60% बार सही chunk top-20 से बाहर रहता है।
यानी जवाब corpus में है, फिर भी retriever उसे 60% बार नहीं लौटाता। Embedding भी नहीं बचाता, क्योंकि embedding model सिर्फ़ chunk का text पढ़ता है। उस text में ACME लिखा ही नहीं, इसलिए vector में ACME की कोई जानकारी नहीं आ सकती।
Lesson 7 का हर chunk के साथ metadata रखता है, लेकिन 60,000 chunks का metadata हाथ से कोई नहीं लिखेगा।
2Contextual retrieval: LLM हर chunk के आगे उसका context लिखता है
Contextual retrieval हर chunk के आगे एक छोटा context जोड़ता है, जिसे एक LLM पूरा document पढ़कर लिखता है। Anthropic ने ये तरीका 2024 में publish किया। ये पर, यानी queries आने से पहले, चार steps चलाता है:
हर chunk के लिए LLM को पूरा document और वो chunk दीजिए।
LLM उस chunk का 50 से 100 tokens का छोटा context लिखता है।
उस context को chunk के आगे जोड़िए। इस नए text को contextualized chunk कहते हैं।
Contextualized chunk का embedding बनाइए, और उसे शब्दों वाले index में भी डालिए, जो lesson 11 में आता है।
ACME वाले chunk के आगे LLM ये context लिखता है। रंगीन हिस्सा LLM का लिखा है, और बाकी पुराना chunk:
From ACME Corp’s Q2 2023 SEC filing; Q1 2023 revenue was $314M. The company’s revenue grew by 3% over the previous quarter.
Stanford की slide: ऊपर query, बाएँ अकेला chunk, और दाएँ वही chunk, पीले context के साथ। Image पर click करने से वो पूरे size में खुलती है।
पहले सोचिए
Query के 6 शब्द revenue, growth, ACME, Corp, Q2 और 2023 हैं। Contextualized chunk का word overlap score अब कितना है? दूसरी companies के contextualized chunks का कितना होगा?
जवाब देखिए
ACME वाले chunk का score 5 है: revenue, ACME, Corp, Q2 और 2023। Growth अब भी नहीं है। दूसरी companies के context में उनका अपना नाम होगा, इसलिए उनका score ज़्यादा से ज़्यादा 3 है: revenue, Q2 और 2023। ये गिनती मेरी है
Context जुड़ने पर ACME वाला chunk 49 chunks की बराबरी से निकलकर सबसे ऊपर आ गया। Embedding model को भी अब ऐसा text मिलता है, जिसमें ACME और Q2 2023 लिखे हैं।
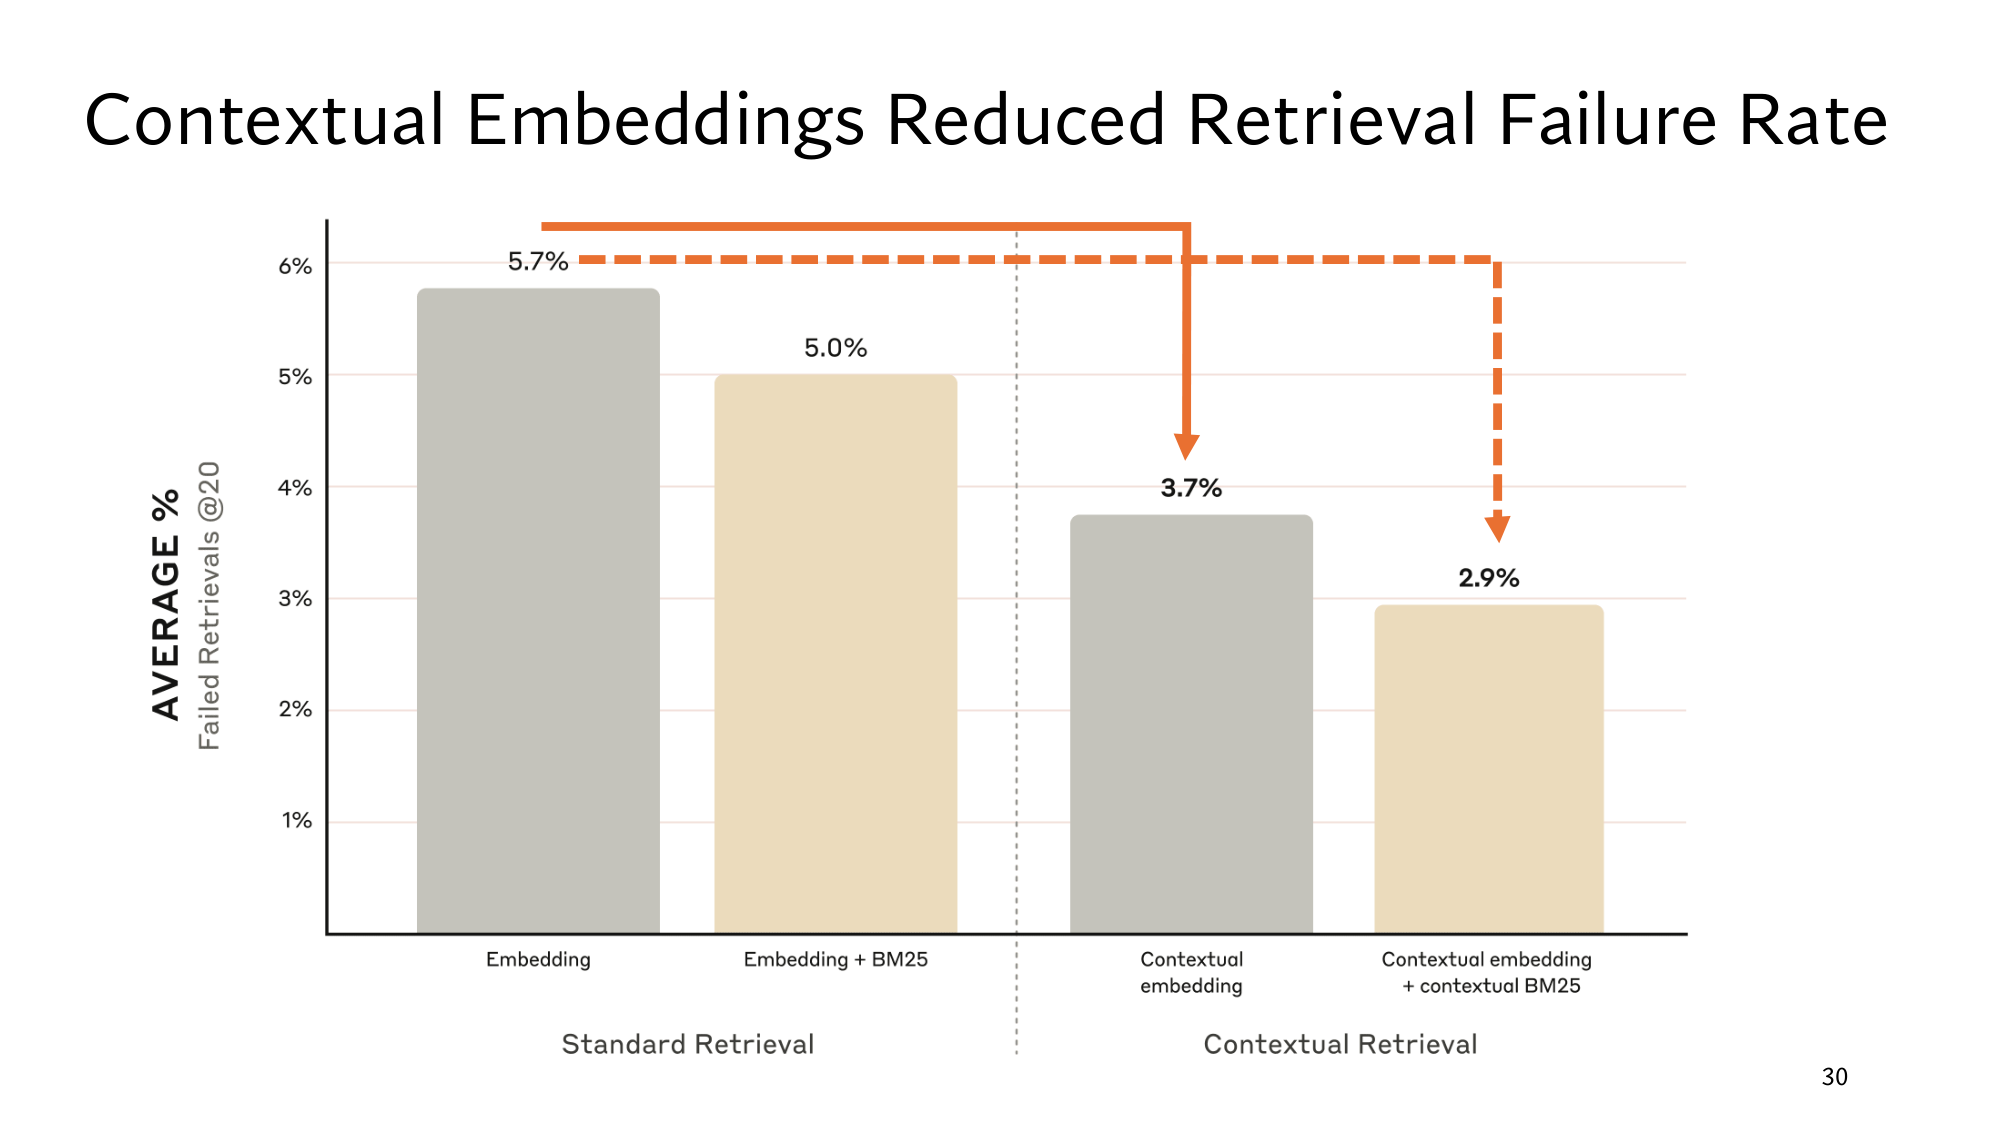
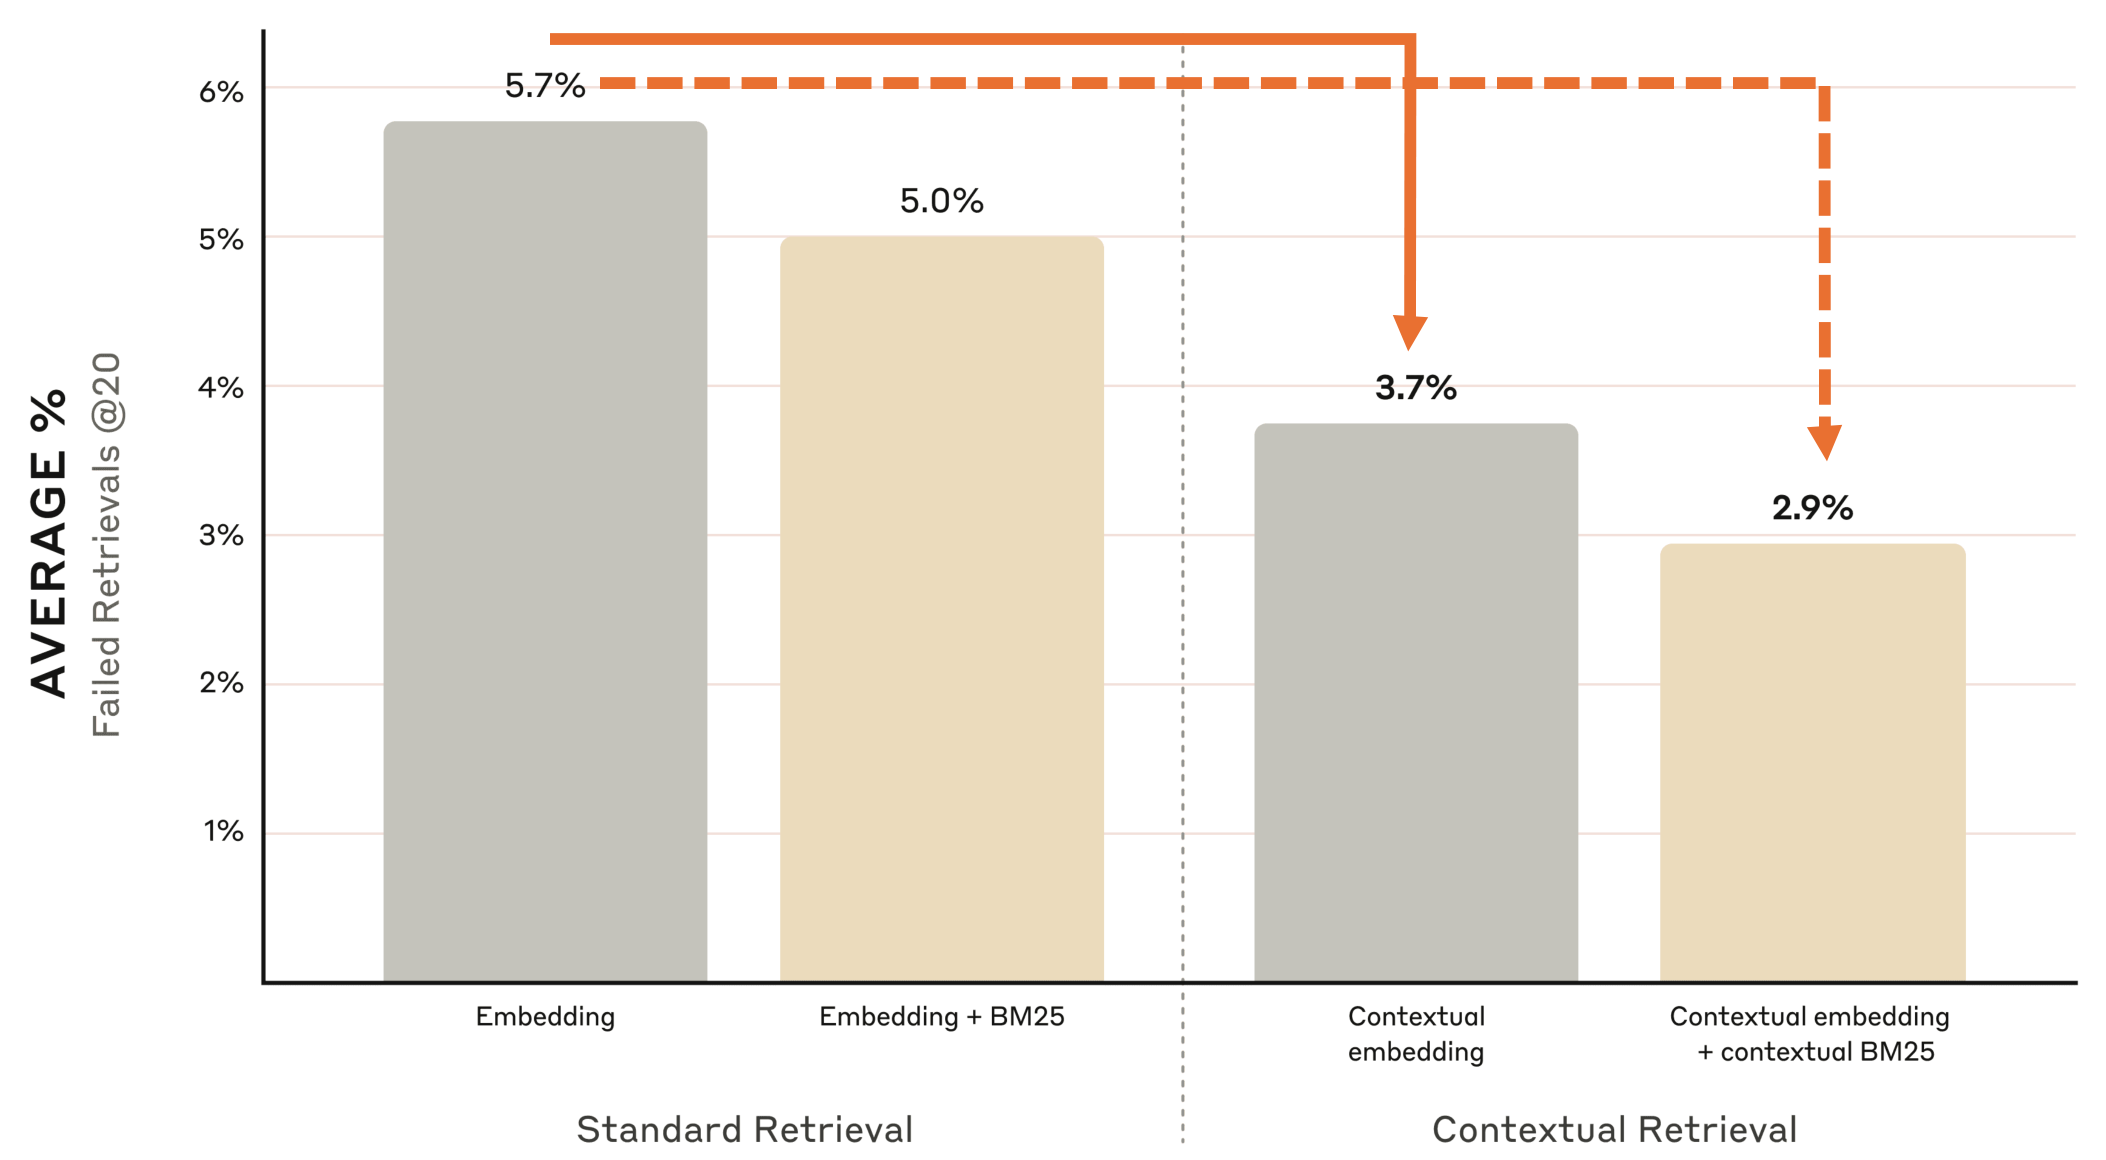
Anthropic के नतीजे: failed retrievals@20
Anthropic ने ये तरीका असली data पर नापा। मानिए कि हर query का एक सही chunk है। तब failed retrievals@20 बताता है कि कितने % queries में वो chunk top-20 में नहीं आया। ये number जितना छोटा, उतना अच्छा।
तरीका
Failed retrievals@20
5.7% से कितनी कमी
Embedding, आम chunks
5.7%
शुरुआत
Embedding + शब्दों वाला index, आम chunks
5.0%
12%
Embedding, contextualized chunks
3.7%
35%
Embedding + शब्दों वाला index, contextualized chunks
2.9%
49%
तीसरी row की कमी 1,000 queries पर साफ़ दिखती है:
आम chunks पर 5.7% × 1,000 = 57 queries fail होती हैं।
Contextualized chunks पर 3.7% × 1,000 = 37 queries fail होती हैं।
57 − 37 = 20 queries बचीं, और 20 ÷ 57 = 0.35। यानी failures 35% कम हुईं।
Failure rate सिर्फ़ 2 points गिरा, 5.7 से 3.7, लेकिन failures 35% घटीं। Points वाली कमी 5.7 − 3.7 है, और % वाली कमी उसी को शुरुआत वाले 5.7 से भाग देती है। शब्दों वाला index भी साथ हो, तो failures 2.9% पर आती हैं, यानी (5.7 − 2.9) ÷ 5.7 = 0.49, करीब आधी। दोनों index की lists मिलाने का तरीका lesson 14 में है।
इसकी कीमत indexing time पर है: हर chunk पर एक LLM call, और हर call में पूरा document। 60,000 chunks हों, तो 60,000 calls लगती हैं। Query time पर कोई extra खर्च नहीं है, क्योंकि context पहले से index में है। एक खतरा भी है: LLM का लिखा context गलत हो, तो वो गलती index में बैठी रहती है।
3Late chunking: पहले पूरा document encode, फिर chunk का औसत
LLM calls महँगी हैं, इसलिए अगला सवाल ये है कि क्या encoder खुद chunk को context दे सकता है। Lesson 7 का हर token का vector आस-पास के शब्दों से बनाता है। जैसे वहाँ late का vector एक sentence में [0.1, 0.9] था, और दूसरे में [0.9, 0.1]। लेकिन encoder सिर्फ़ उतना text देखता है, जितना उसे मिला।
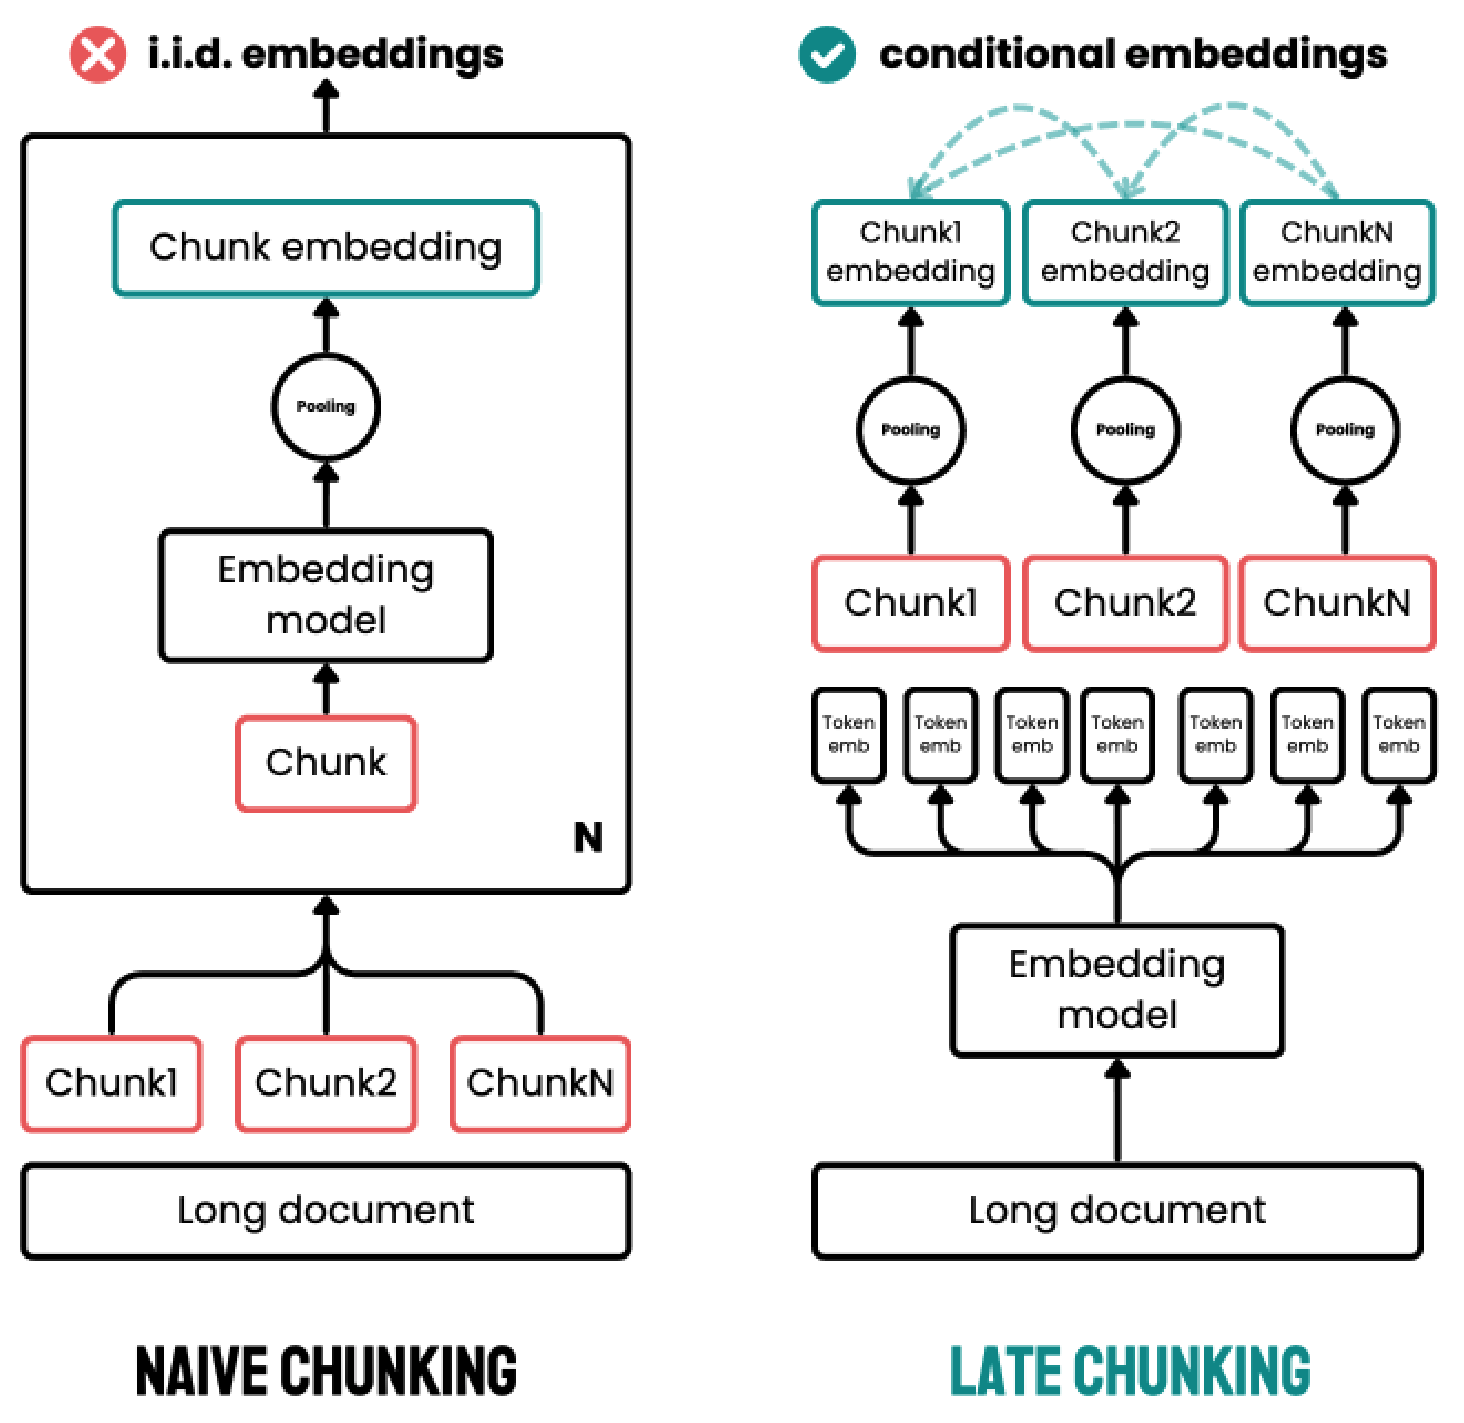
आम तरीका encoder को सिर्फ़ chunk देता है: पहले काटिए, फिर हर chunk को अलग से encode कीजिए। इसे naive chunking कहते हैं। इसमें chunk के tokens को बाकी document की कोई खबर नहीं होती।
Late chunking ये क्रम उल्टा कर देता है: encoder पहले पूरा document पढ़ता है, और काटना उसके बाद होता है।
पूरा document एक long-context encoder में डालिए, यानी ऐसे encoder में, जो एक बार में बहुत लंबा text पढ़ सके। जैसे 8,192 tokens, करीब 10 pages। paper से
Encoder हर token का vector देता है, और हर vector पूरे document को देखकर बनता है।
हर chunk के tokens के vectors का औसत लीजिए। ये उस chunk का vector है।
ये औसत lesson 7 वाली है, जैसे [0.9, 0.1], [0.7, 0.3] और [0.8, 0.2] से [0.8, 0.2]। काटना encoding के बाद, यानी देर से होता है, इसलिए नाम late है।
एक छोटा document लीजिए: CS 329Z project milestone policy. It is due Week 6. दूसरा chunk It is due Week 6 है। हर vector का पहला number बताता है कि बात milestone की कितनी है, और दूसरा कि homework की कितनी। numbers मेरे बनाए हैं
Token
Naive: chunk अकेला
Late: पूरा document
It
[0.5, 0.5]
[0.9, 0.1]
is
[0.5, 0.5]
[0.8, 0.2]
due
[0.6, 0.4]
[0.9, 0.1]
Week
[0.4, 0.6]
[0.9, 0.1]
6
[0.5, 0.5]
[1.0, 0.0]
Mean pooling
[0.5, 0.5]
[0.9, 0.1]
आख़िरी row ऐसे निकली:
Naive का पहला number: (0.5 + 0.5 + 0.6 + 0.4 + 0.5) ÷ 5 = 2.5 ÷ 5 = 0.5। दूसरा भी 0.5 आता है।
Naive में It को नहीं पता कि बात milestone की है या homework की, इसलिए vector बीच में है। Late में encoder ने पहला sentence भी पढ़ा था, इसलिए सारे tokens milestone की तरफ़ झुके।
Query When is the project milestone due? का vector [0.95, 0.05] मानिए। Lesson 3 की dot product को दोनों lengths के गुणा से भाग देती है, जैसे 0.74 ÷ (0.82 × 0.91) = 0.99। Naive chunk से cosine तीन steps में निकलता है:
Lengths: query की √(0.95² + 0.05²) = √0.905 = 0.951, और chunk की √(0.5² + 0.5²) = √0.5 = 0.707।
भाग: 0.5 ÷ (0.951 × 0.707) = 0.5 ÷ 0.672 = 0.74।
Late chunk [0.9, 0.1] पर यही हिसाब 0.86 ÷ (0.951 × 0.906) = 1.00 देता है। Late chunk की दिशा query से लगभग पूरी मिलती है, जबकि naive chunk 0.74 पर रह जाता है।
पहले सोचिए
अब homework वाली query लीजिए, vector [0.05, 0.95]। Naive chunk [0.5, 0.5] और late chunk [0.9, 0.1], दोनों से इसका cosine निकालिए। Naive chunk की कमज़ोरी क्या दिखी?
Naive chunk दोनों queries पर 0.74 देता है, यानी milestone वाला chunk homework के सवाल पर भी उतना ही ऊपर आता है। ये query मेरी है
Stanford की slide: बीच में naive chunking, और दाएँ late chunking।
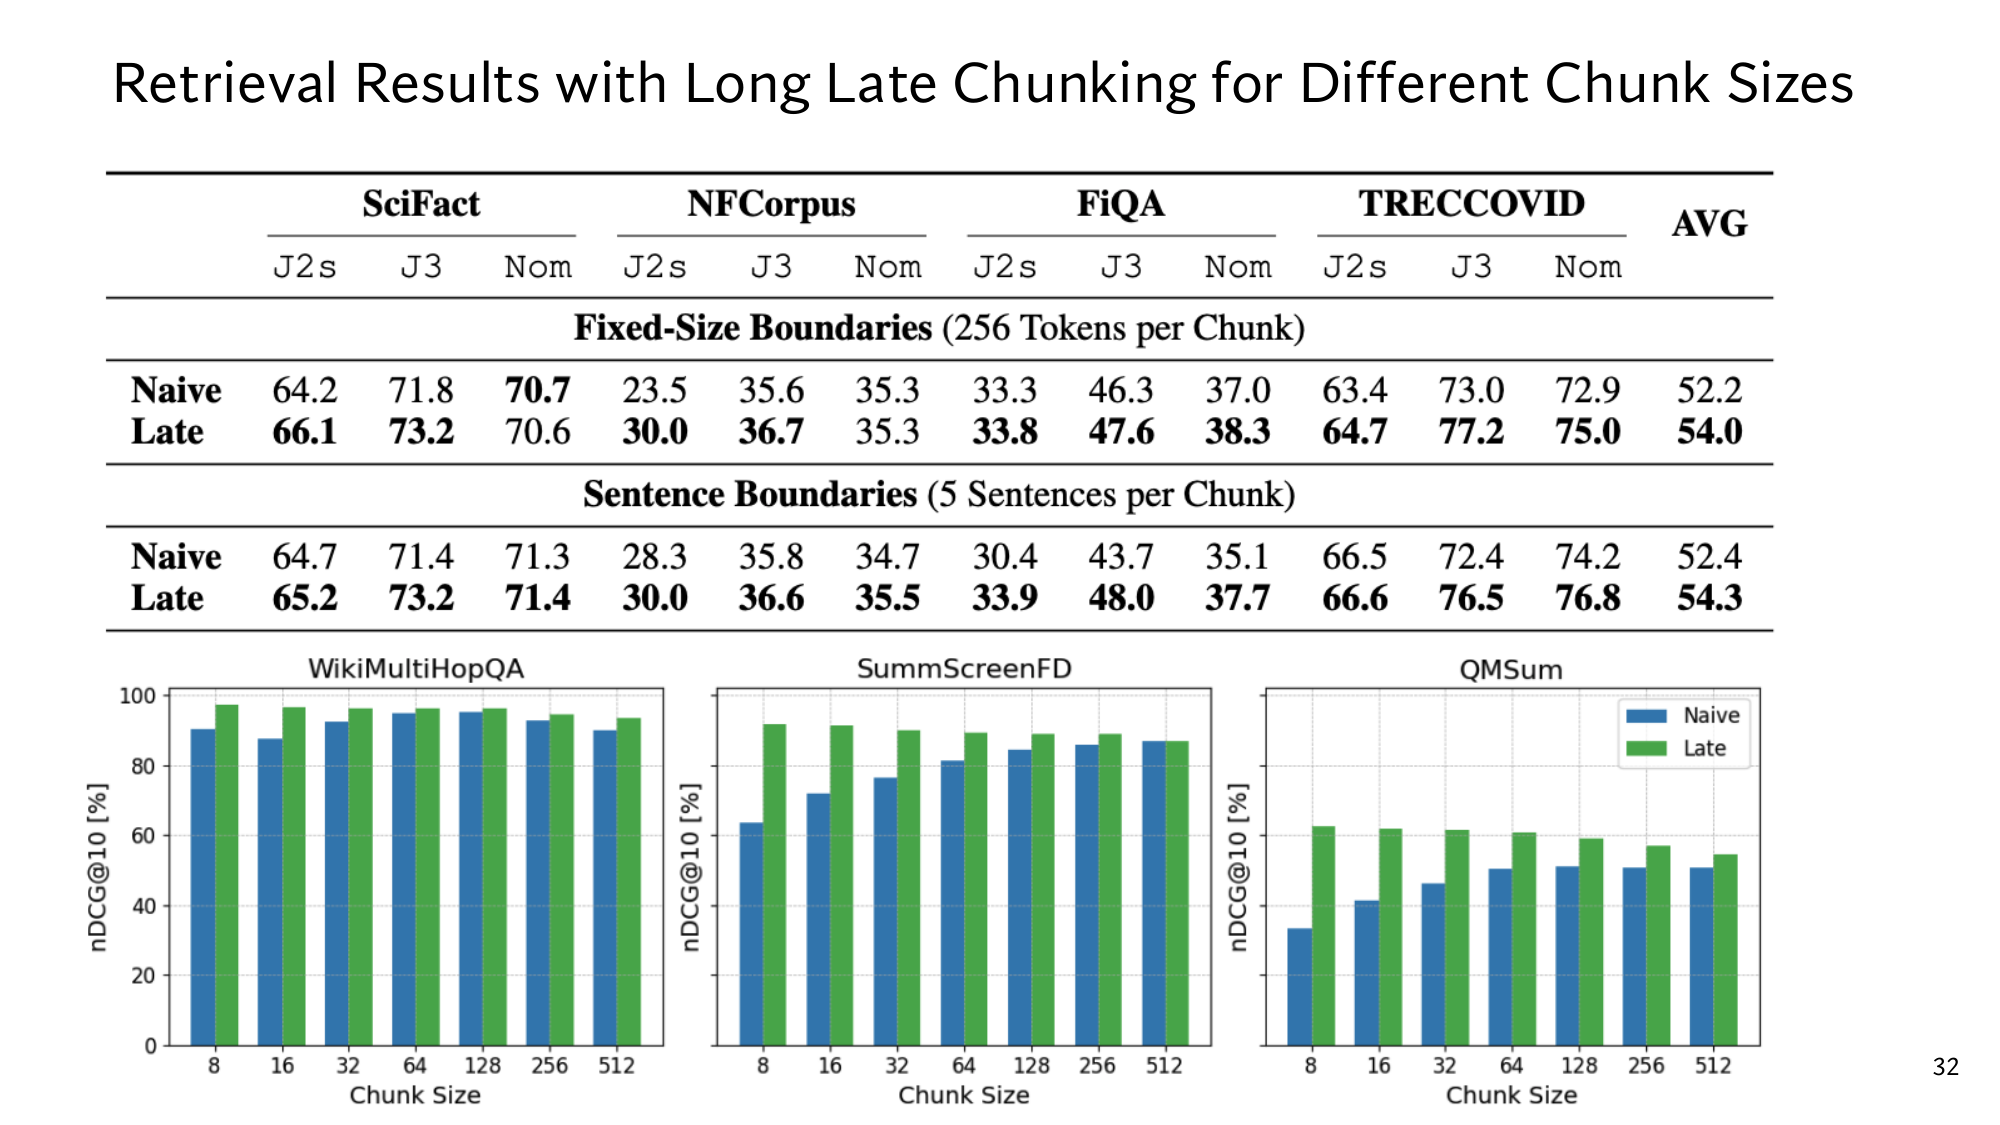
Paper में 256 tokens वाले chunks पर late chunking का औसत score 52.2 से 54.0 हुआ। ये 0 से 100 तक का ranking score है, जिसे lesson 13 खोलता है। फ़ायदा सबसे छोटे chunks पर सबसे बड़ा है, क्योंकि छोटा chunk सबसे ज़्यादा context खोता है।
4दोनों तरीकों की तुलना: context text में या vector में
दोनों तरीके context अलग जगह रखते हैं: contextual retrieval उसे chunk के text में लिखता है, और late chunking सिर्फ़ vector में। बाकी फ़र्क इसी से निकलते हैं:
Contextual retrieval
Late chunking
Context कौन देता है
LLM, text लिखकर
Encoder, vectors में
Indexing का खर्च
हर chunk पर एक LLM call
हर document पर एक encoder run
Chunk लंबा होता है?
हाँ, 50–100 tokens
नहीं
शब्दों वाले index को फ़ायदा
हाँ, नए शब्द text में हैं
नहीं
ACME वाली query पर ये फ़र्क सीधा दिखता है। Late chunking के बाद भी chunk के text में ACME नहीं है, इसलिए word overlap का score 1 ही रहता है। यानी शब्दों वाले index पर सिर्फ़ contextual retrieval मदद करता है, और embedding पर दोनों। Late chunking की एक हद भी है: पूरा document encoder की लंबाई की limit में आना चाहिए, नहीं तो context फिर कटता है।
पहले सोचिए
Corpus बहुत बड़ा है, LLM calls का budget कम है, chunks 64 tokens के हैं, और retriever सिर्फ़ embeddings पर चलता है। आप कौन सा तरीका लेंगे? Retriever सिर्फ़ शब्दों वाला index हो, तो?
जवाब देखिए
Late chunking। उसमें LLM call नहीं लगती, और छोटे chunks पर उसका फ़ायदा सबसे ज़्यादा है। सिर्फ़ शब्दों वाले index पर late chunking कुछ नहीं करता, क्योंकि उसका context text में नहीं जाता। तब contextual retrieval लीजिए।
यहाँ से Stanford वाला level
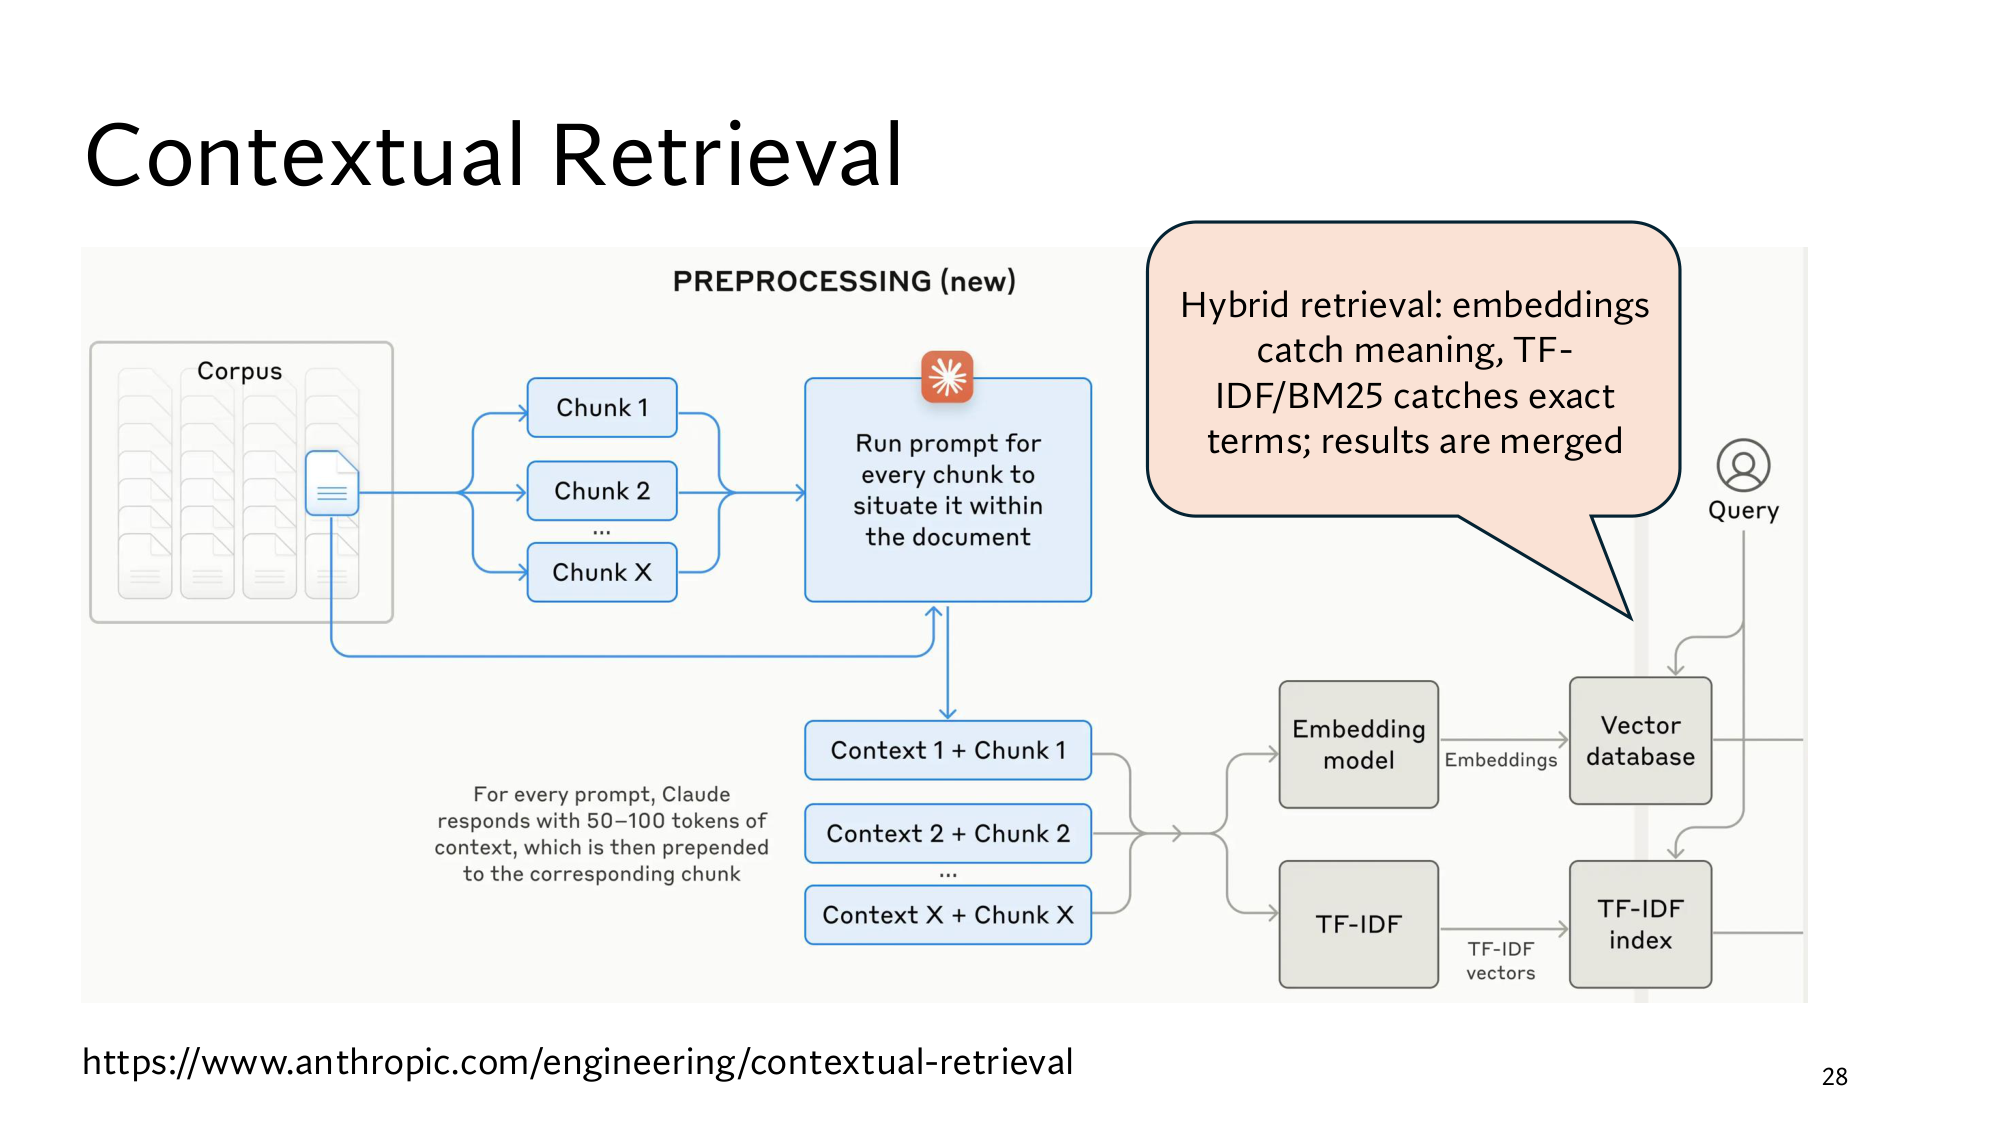
ऊपर के 4 पड़ाव आसान version जैसे ही हैं। आगे के 5 पड़ाव आपको Stanford की slides के level तक ले जाते हैं। पहले Anthropic की पूरी pipeline और उसके numbers हैं, फिर late chunking अंदर से, और उसके paper के नतीजे। उसके बाद दोनों तरीके एक ही example पर हैं, और आख़िर में आप slides खुद पढ़ते हैं। हर गणित वहीं समझाया है, जहाँ वो पहली बार आता है।
5Anthropic की पूरी pipeline: diagram, prompt, खर्च और metric
पड़ाव 2 में contextual retrieval के चार steps आए थे। Stanford की slide यही steps Anthropic के एक diagram में दिखाती है, और ये पड़ाव उसका हर box पढ़ता है। इस पड़ाव के numbers Anthropic के blog post Introducing Contextual Retrieval से हैं, और slide का diagram भी उसी post से है।
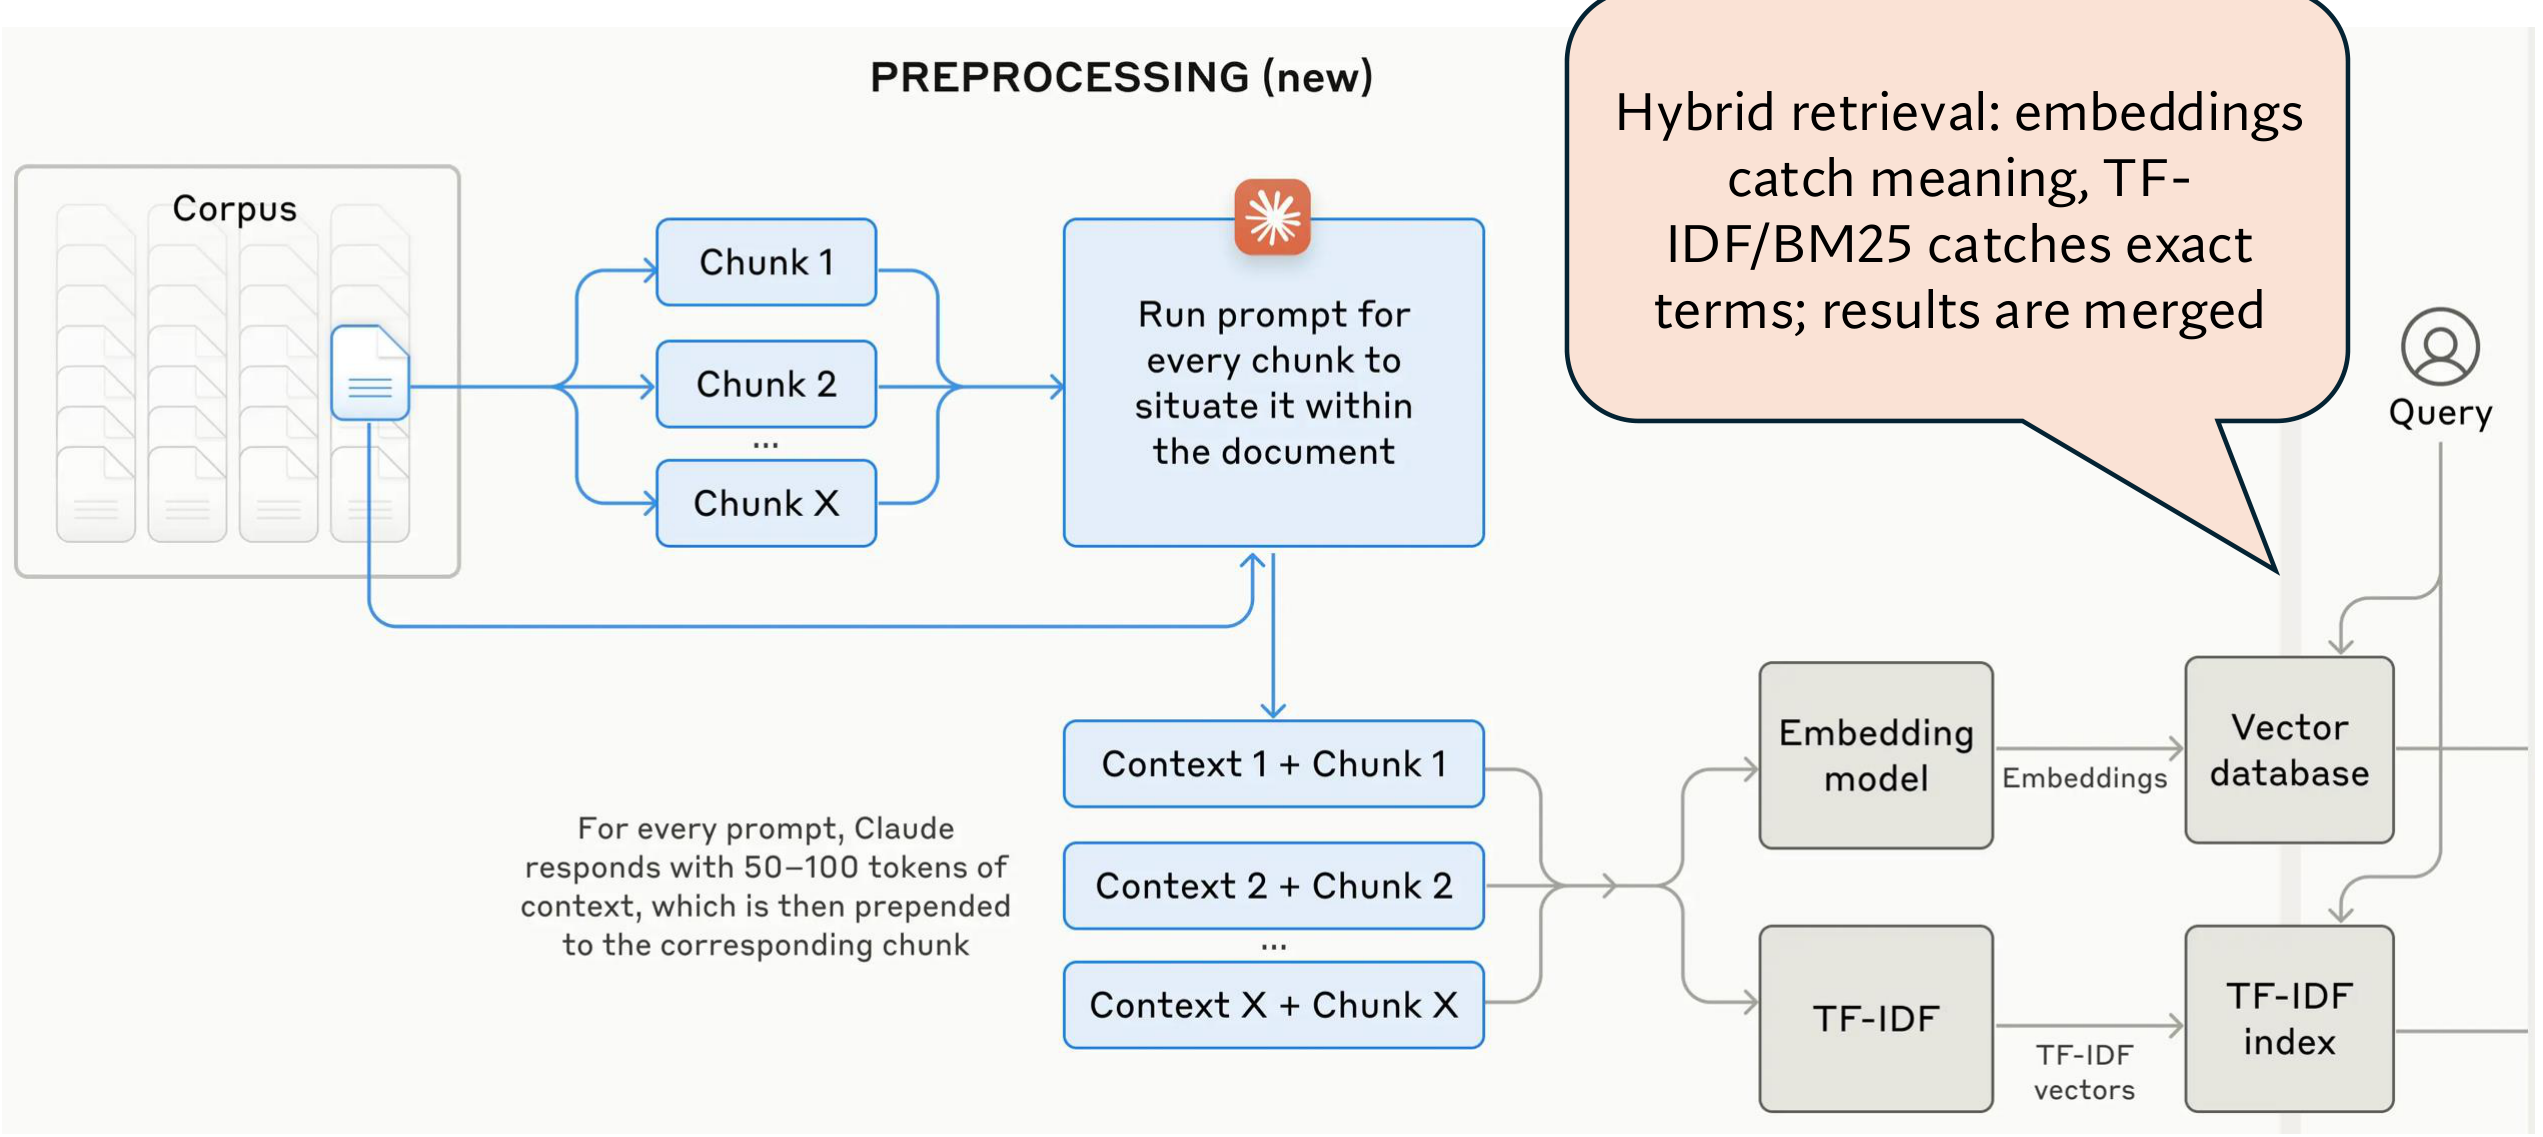
Stanford की contextual retrieval वाली slide का diagram, बड़ा करके। Image पर click करने से वो पूरे size में खुलती है।
Diagram बाएँ से दाएँ ऐसे चलता है:
PREPROCESSING (new): ये पूरा हिस्सा indexing time पर चलता है। New का मतलब है कि आम RAG pipeline में ये step नहीं होता।
Corpus से Chunk 1 … Chunk X: corpus का एक document chunks में कटता है। X यहाँ chunks की गिनती है।
Run prompt for every chunk: हर chunk पर एक LLM call होती है। नीचे से आती लंबी नीली line पूरा document इसी box तक ले जाती है, क्योंकि LLM को chunk के साथ पूरा document भी चाहिए।
Context 1 + Chunk 1: LLM का 50–100 tokens का जवाब chunk के आगे जुड़ता है। Slide इसे prepended लिखती है, यानी आगे जोड़ा हुआ।
Embedding model से Vector database: हर contextualized chunk का embedding बनता है, और vector database में जाता है।
TF-IDF से TF-IDF index: वही contextualized chunks शब्दों वाले index में भी पहुँचते हैं।
Query: query आने पर वो दोनों index में जाती है। इस वक्त कोई LLM call नहीं होती।
Box पर TF-IDF लिखा है, जबकि chart और blog BM25 कहते हैं। हर शब्द की गिनती को उसकी rarity के वज़न से गुणा करता है। जैसे N = 6, n = 2 और f = 2 पर 2 × ln 3 = 2.20। इसी idea का सुधरा रूप है, जो गिनती के फ़ायदे पर छत लगाता है और लंबे passages का वज़न घटाता है। Blog का index BM25 वाला है, और उसका नाम Contextual BM25 है। blog से
ऊपर का callout कहता है कि embeddings मतलब पकड़ते हैं, TF-IDF/BM25 exact शब्द पकड़ता है, और system दोनों के results मिलाता है। दो retrievers की lists मिलाने को कहते हैं। जैसे BM25 की list E1, E3, E2 और dense की E2, E1, E3 से एक list बनाना। Blog दोनों lists को rank fusion से मिलाता है, और ये तरीका lesson 14 में है। blog से
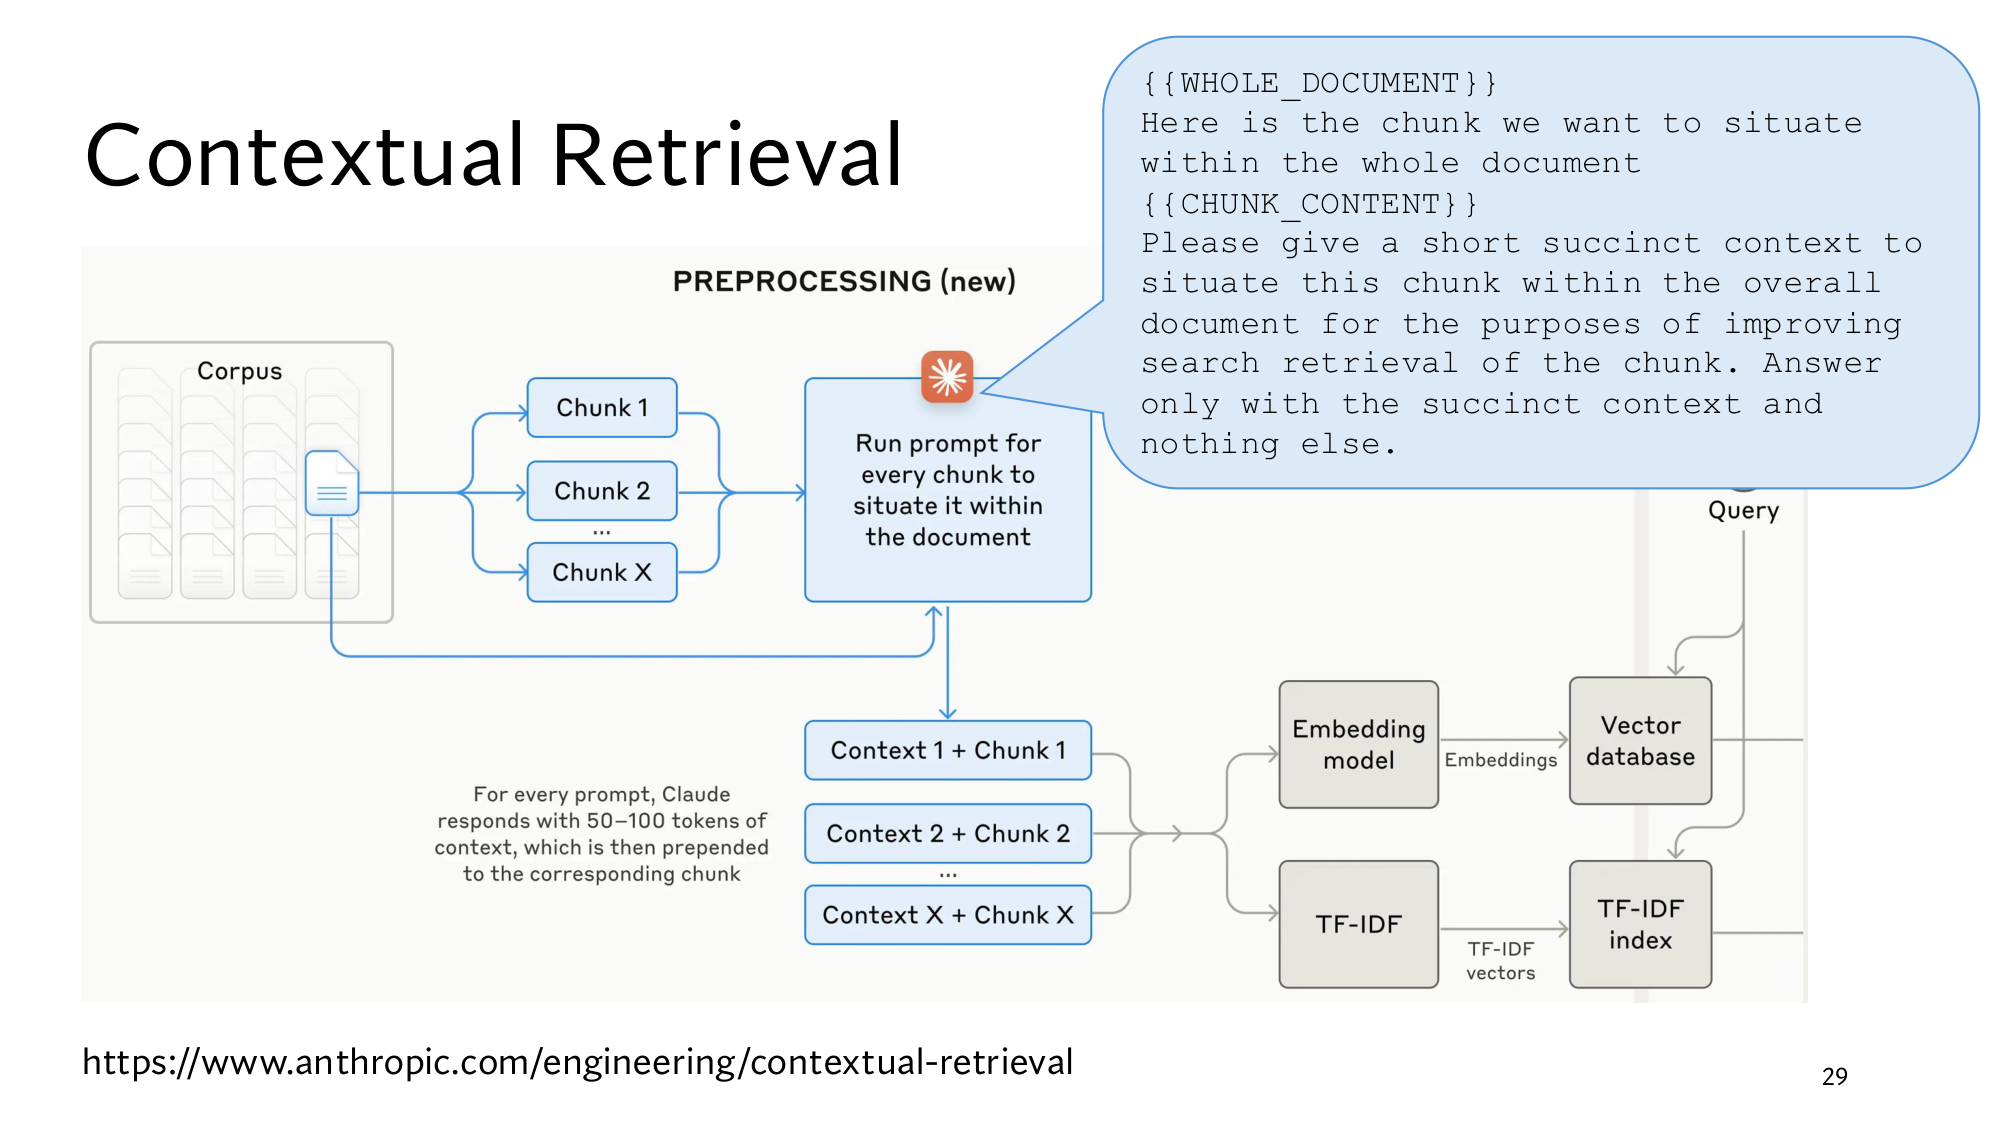
Prompt, line by line
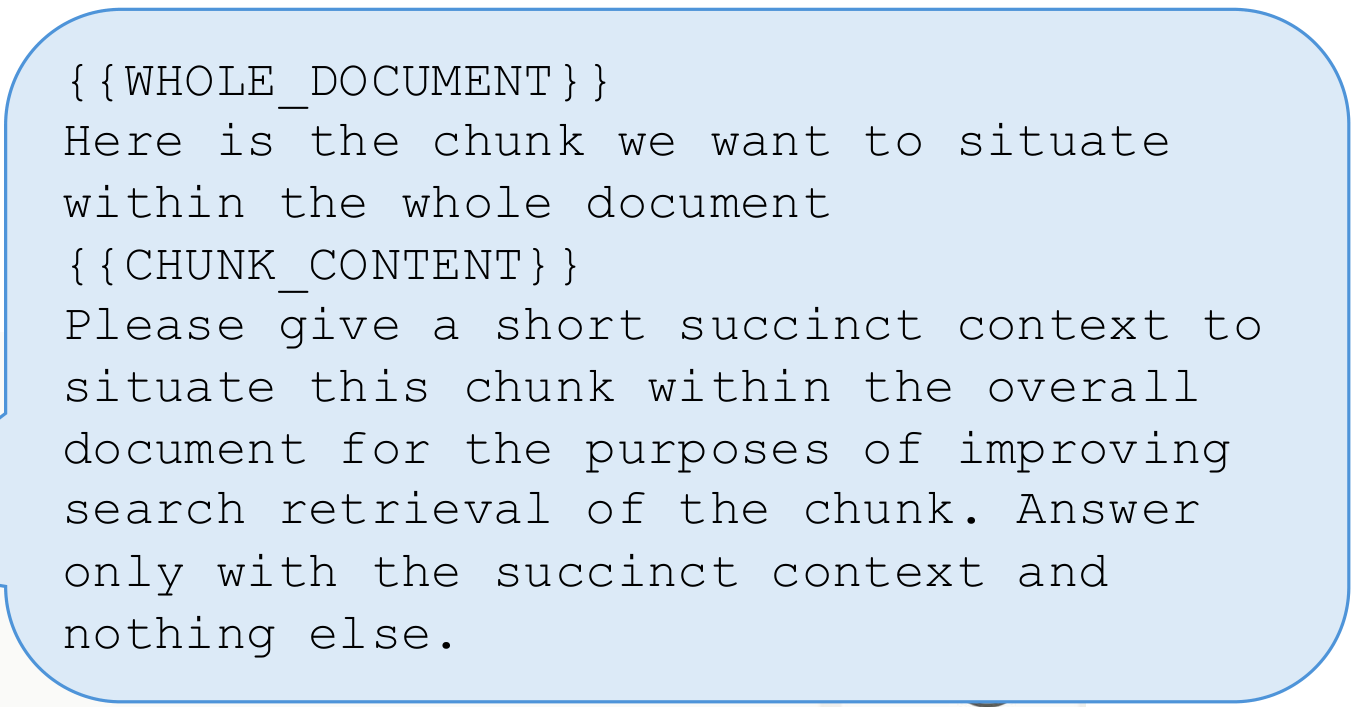
Stanford की slide पर LLM का prompt, बड़ा करके।
Prompt में चार हिस्से हैं। {{WHOLE_DOCUMENT}} एक placeholder है, यानी खाली जगह, जिसमें program हर call पर पूरा document भरता है। फिर एक line बताती है कि आगे वो chunk है, जिसकी जगह document में बतानी है। {{CHUNK_CONTENT}} में program वो chunk भरता है। आख़िरी हिस्सा LLM से search के लिए छोटा context माँगता है, और कहता है कि जवाब में उसके सिवा कुछ न हो।
आख़िरी शर्त ज़रूरी है, क्योंकि program LLM का पूरा जवाब बिना बदले chunk के आगे जोड़ता है। LLM अगर Sure, here is the context: जैसी line भी लिखे, तो वो line भी हर chunk के साथ index में पहुँच जाएगी। Blog के prompt में document <document> tags के अंदर है, और chunk <chunk> tags के अंदर, जो slide पर नहीं दिखते। Anthropic ने ये prompt Claude 3 Haiku पर चलाया। blog से
LLM calls का खर्च, और prompt caching
पड़ाव 2 में खर्च एक line में आया था: हर chunk पर एक call, और हर call में पूरा document। Blog के assumptions पर ये गिनती देखिए: chunk 800 tokens का, document 8,000 tokens का, instructions 50 tokens, और हर context 100 tokens। blog से
एक document में 8,000 ÷ 800 = 10 chunks हैं, इसलिए 10 LLM calls।
हर call में LLM 8,000 + 800 + 50 = 8,850 tokens पढ़ता है।
दसों calls मिलाकर 10 × 8,850 = 88,500 tokens, यानी document की लंबाई का 88,500 ÷ 8,000 = करीब 11 गुना।
LLM हर call पर 100 tokens लिखता है, यानी 10 × 100 = 1,000 tokens। हिसाब मेरा
Step 3 का सबसे बड़ा हिस्सा वही document है, जो दसों calls में दोहराया गया। Prompt caching इसी दोहराव को सस्ता करती है। इसमें LLM service prompt का एक हिस्सा पहली call के बाद याद रखती है, यहाँ पूरा document। अगली calls उसे दोबारा पूरी कीमत पर नहीं पढ़तीं। Blog के मुताबिक तब पूरा खर्च हर 10 लाख document tokens पर $1.02 आता है। blog से
Index भी बढ़ता है। 800 tokens के chunk में 100 tokens का context जुड़े, तो 100 ÷ 800 = 0.125, यानी हर chunk 12.5% लंबा होता है। हिसाब मेरा
Blog दो बातें और कहता है। पूरा knowledge base 2 लाख tokens से छोटा हो, यानी करीब 500 pages, तो उसे सीधे prompt में डाल दीजिए, और RAG की ज़रूरत नहीं। दूसरी बात lesson 7 से जुड़ती है: हर chunk के साथ document की एक आम summary जोड़ने से फ़ायदा बहुत कम हुआ। blog से
Chart का metric, औसत और reranking
Chart के y-axis पर AVERAGE % और Failed Retrievals @20 लिखा है। Blog अपने metric को 1 minus recall@20 कहता है, यानी सही documents में से कितने % top-20 chunks में नहीं आए। blog से Lesson 13 का top-k में मिले सही chunks ÷ कुल सही chunks है, जैसे 2 में से 1 मिले, तो 0.5। हर query का एक ही सही chunk हो, तो 1 − Recall@20 वही है, जो lesson 13 का है, यानी 1 − Hit@20।
AVERAGE का मतलब है कि हर bar चार तरह के data का औसत है: codebases, fiction, ArXiv papers और science papers। Embedding model वो था, जो उनके tests में सबसे अच्छा निकला, यानी Gemini Text 004, और उन्होंने हर query पर top-20 chunks देखे। blog से Blog के मुताबिक context जोड़ने से हर embedding model और हर तरह के data पर सुधार हुआ।
Chart दो हिस्सों में बँटा है। बाएँ Standard Retrieval है, यानी आम chunks, और दाएँ Contextual Retrieval, यानी contextualized chunks। हर हिस्से में पहली bar सिर्फ़ embedding की है, और दूसरी embedding के साथ BM25 की। तीसरी bar का नाम Contextual embedding है, और यहाँ इसका मतलब contextualized chunk का embedding है, lesson 7 वाला token का नहीं।
पड़ाव 2 में % वाली कमी का नियम आया था: (पुराना − नया) ÷ पुराना। Blog एक step और जोड़ता है। Lesson 6 का एक धीमा लेकिन सटीक model है, जो लौटी हुई list को दोबारा sort करता है। Anthropic ने पहले top-150 chunks लिए, Cohere के reranker से उन्हें दोबारा sort किया, और ऊपर के 20 रखे। blog से
तरीका
Failed@20
Points कम
% कम
आम chunks, embedding
5.7
–
–
आम chunks, embedding + BM25
5.0
0.7
12%
Contextualized, embedding
3.7
2.0
35%
Contextualized, embedding + BM25
2.9
2.8
49%
ऊपर वाला + reranking
1.9
3.8
67%
हर row 5.7 से तुलना करती है। जैसे आख़िरी row: (5.7 − 1.9) ÷ 5.7 = 3.8 ÷ 5.7 = 0.67। Blog ने model को 5, 10 और 20 chunks देकर भी देखा, और 20 chunks सबसे अच्छे रहे। blog से
पहले सोचिए
आम chunks पर embedding + BM25 का failure rate 5.0% था, और contextualized chunks पर 2.9%। BM25 वाले system में context जोड़ने से failures कितने % घटीं?
जवाब देखिए
(5.0 − 2.9) ÷ 5.0 = 2.1 ÷ 5.0 = 0.42, यानी 42%। Blog वाला 49% शुरुआत 5.7 से नापता है, और ये 42% शुरुआत 5.0 से। % वाली कमी हमेशा इस पर टिकी है कि तुलना किस number से हो रही है। हिसाब मेरा
6Late chunking अंदर से: conditional embeddings, attention और pooling का formula
पड़ाव 3 में late chunking का नतीजा दिखा था: It का vector [0.5, 0.5] की जगह [0.9, 0.1] बना। ये पड़ाव दिखाता है कि encoder ऐसा कैसे करता है, और paper इसे formula में कैसे लिखता है।
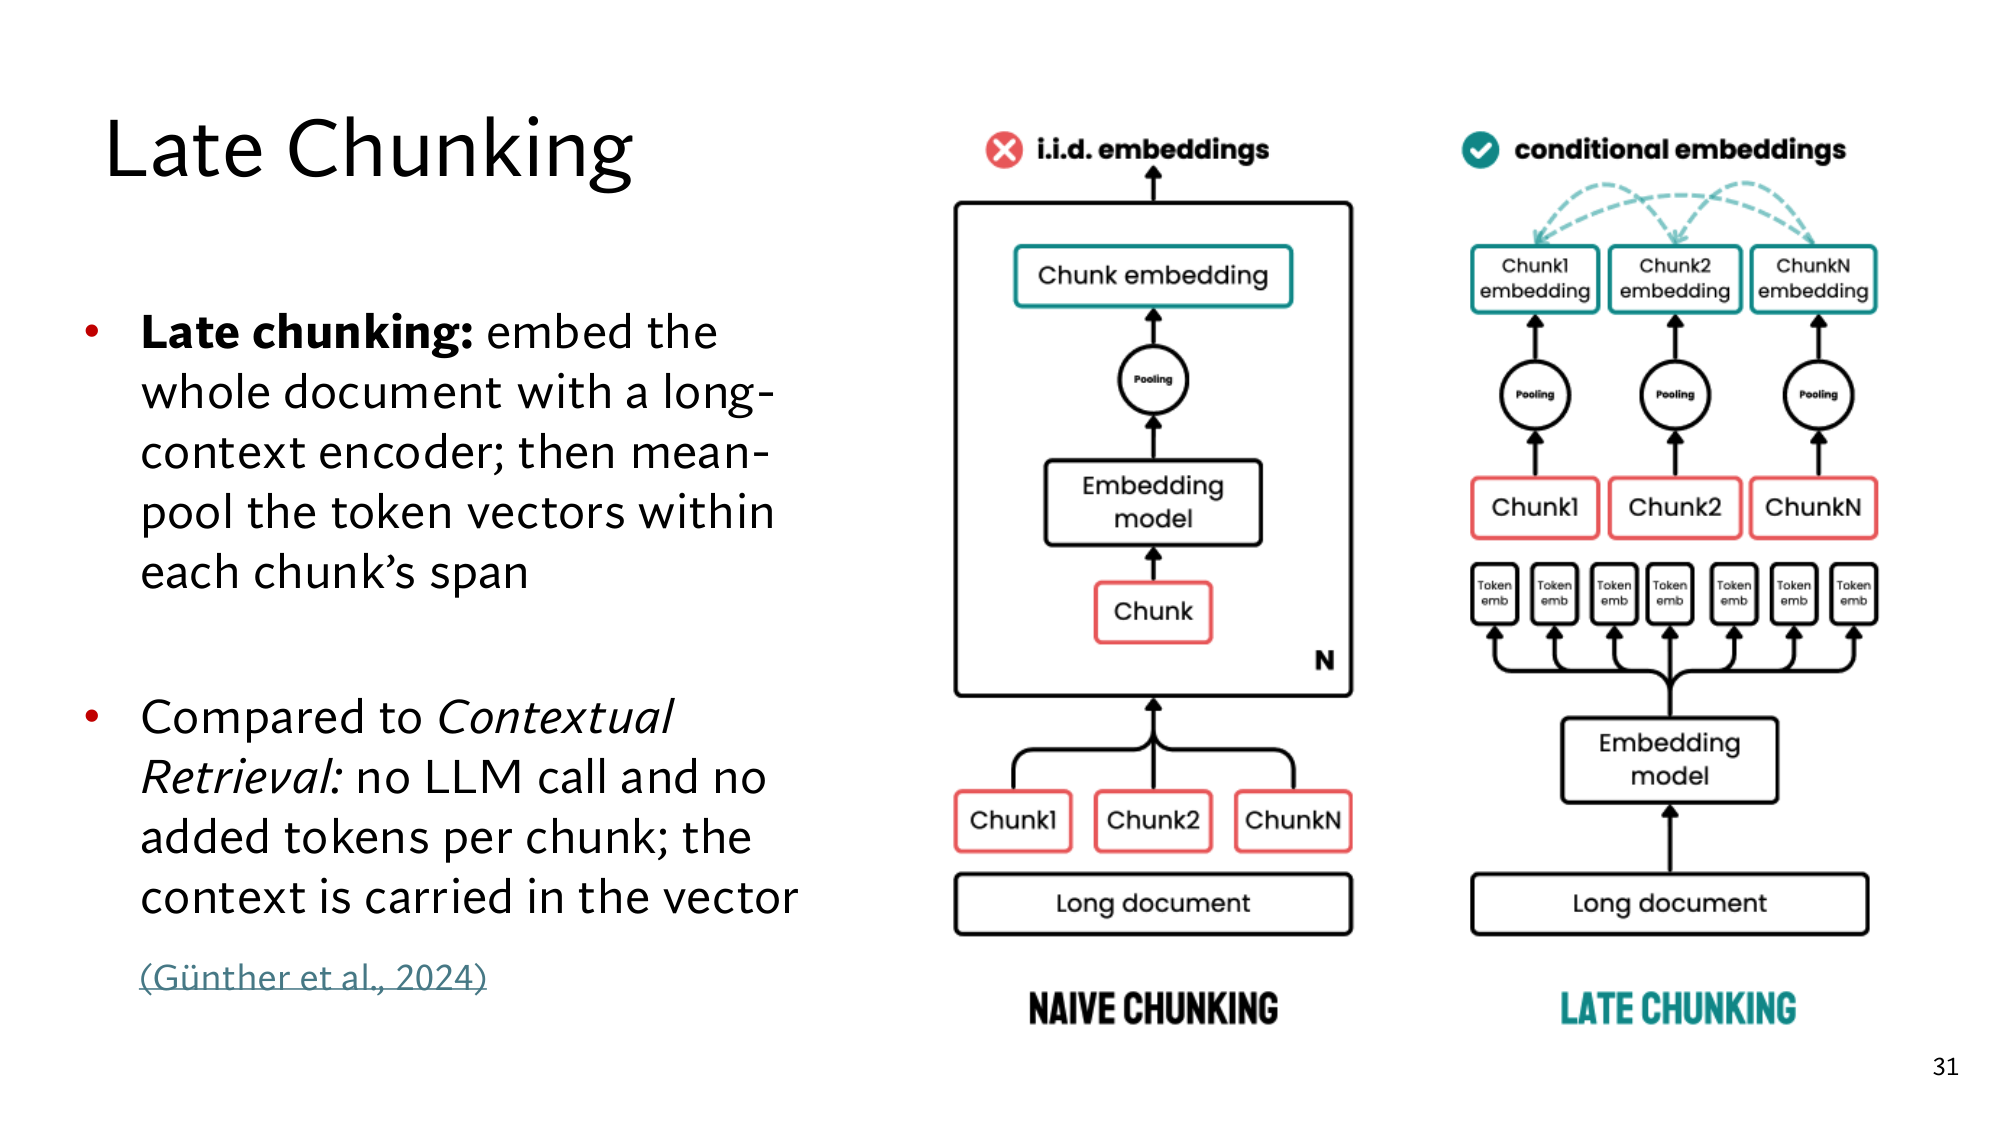
i.i.d. और conditional embeddings
Slide के diagram पर naive वाले हिस्से के ऊपर i.i.d. embeddings लिखा है, और late वाले के ऊपर conditional embeddings। i.i.d. statistics का शब्द है, और उसका पूरा रूप independent and identically distributed है। यहाँ इसका मतलब है: हर chunk का vector एक ही model से बनता है, और दूसरे chunks से बिल्कुल अलग, यानी independent।
Conditional शब्द lesson 4 की से आता है, जहाँ p(A | B) का मतलब था: B पता हो, तो A की probability। जैसे p(भरा | Tuesday) = 0.80। Late chunking में हर chunk का vector पूरे document पर conditional है, यानी document को देखकर बनता है। Diagram में chunk embeddings के बीच के dashed arrows यही दिखाते हैं: हर chunk के vector पर बाकी chunks का असर है।
Naive वाले box के कोने में N लिखा है। इसका मतलब है कि ये box N बार चलता है, हर chunk पर एक बार, और हर बार model सिर्फ़ एक chunk देखता है। Late में model एक ही बार चलता है, और Token emb वाले छोटे boxes हर token का vector हैं।
Token को पूरा document कैसे दिखता है
Encoder के अंदर हर token का vector दूसरे tokens के vectors से बदलता है, और ये काम करता है। Attention हर token के लिए बाकी tokens के vectors का वज़न वाला औसत लेता है। वज़न वाले औसत में हर vector को उसके वज़न से गुणा करके जोड़ते हैं, और सारे वज़नों का जोड़ 1 होता है।
मान लीजिए It का शुरू का vector [0.5, 0.5] है, और milestone का [1.0, 0.0]। Attention milestone को 0.8 वज़न देता है, और It को खुद 0.2। numbers मेरे बनाए हैं
यही पड़ाव 3 की table का late वाला [0.9, 0.1] है। Naive chunking में milestone chunk के अंदर है ही नहीं। तब It सिर्फ़ It, is, due, Week और 6 से औसत ले सकता है, और वो सब बीच में हैं। असली encoder में ये कई layers में होता है, और वज़न model खुद निकालता है।
Paper यही असर एक असली encoder पर दिखाता है। उसने Wikipedia के Berlin वाले article को sentences में काटा, और हर sentence के vector का शब्द Berlin के vector से cosine निकाला। Model jina-embeddings-v2-small था। paper से
Sentence
Naive
Late
Berlin is the capital and largest city of Germany…
0.8486
0.8495
Its more than 3.85 million inhabitants…
0.7084
0.8249
The city is also one of the states of Germany…
0.7535
0.8498
पहले sentence में Berlin लिखा है, इसलिए दोनों तरीकों में cosine लगभग बराबर है। दूसरे और तीसरे sentence में सिर्फ़ Its और The city हैं। वहाँ late chunking cosine को 0.7084 से 0.8249, और 0.7535 से 0.8498 तक ले जाता है।
Paper का pooling formula
Paper late chunking को एक algorithm की तरह लिखता है। Chunker text को characters के हिसाब से chunks में काटता है। Tokenizer text के tokens बनाता है, और हर token की characters वाली लंबाई देता है। Model हर token का vector देता है, जिसे paper ϑ लिखता है: ϑ1 से ϑm तक, जहाँ m tokens की गिनती है। paper से
फिर algorithm tokens पर एक-एक करके चलता है, और उनकी characters वाली लंबाई जोड़ता जाता है। जोड़ chunk की लंबाई तक पहुँचे, तो chunk वहीं ख़त्म होता है। इससे हर chunk के पहले और आख़िरी token की position मिलती है, जिन्हें paper cuestart और cueend लिखता है। उसके बाद हर chunk का vector ये है:
ei = ∑j = cuestartcueend ϑj(cueend + 1) − cuestart
lesson 3 से है: नीचे लिखी जगह से ऊपर लिखी जगह तक सब जोड़ते जाइए, जैसे a1b1 + a2b2। अब अपने document पर चलाइए, जिसमें हर शब्द को एक token मानिए और full stops छोड़ दीजिए। ये सरल रूप मेरा है तब CS से policy तक tokens 1 से 5 हैं, और It से 6 तक tokens 6 से 10।
Chunk 2 के लिए cuestart = 6 और cueend = 10।
ऊपर का जोड़, पहले number के लिए: ϑ6 से ϑ10 तक 0.9 + 0.8 + 0.9 + 0.9 + 1.0 = 4.5।
नीचे: (10 + 1) − 6 = 5, यानी chunk में 5 tokens। +1 इसलिए है कि 6 से 10 तक गिनें, तो 6 और 10 दोनों गिनती में आते हैं।
e2 का पहला number: 4.5 ÷ 5 = 0.9, जो पड़ाव 3 का late वाला number है।
Naive chunking भी यही औसत लेता है। फ़र्क सिर्फ़ ϑ में है: naive में ϑ6 से ϑ10 उस run से आते हैं, जिसमें model ने सिर्फ़ chunk 2 पढ़ा था। Model text के शुरू में [CLS] और आख़िर में [SEP] जैसे खास tokens भी जोड़ता है, जो किसी शब्द के नहीं हैं। Paper इनके vectors पहले और आख़िरी chunk के औसत में डालता है। paper से
Late chunking के लिए model को दोबारा train नहीं करना पड़ता। Paper के मुताबिक ये हर उस long-context embedding model पर चलता है, जो mean pooling करता है, और हर chunking तरीके के साथ चलता है। paper से
7Paper के नतीजे: table, chunk size और long late chunking
Stanford की आख़िरी slide पर paper के दो नतीजे हैं: ऊपर एक table, और नीचे तीन charts। दोनों का score है, जो lesson 13 में आता है। nDCG@10 देखता है कि top-10 में सही chunks कितने ऊपर हैं, और 0 से 1 के बीच रहता है, जैसे 2.5 ÷ 3.631 = 0.689। Paper इसे 100 से गुणा करके % में लिखता है, तो 0.689 वाला score 68.9 होता। slide पर सिर्फ़ charts पर nDCG@10 लिखा है, table का metric paper से
Table: 4 datasets और 3 models
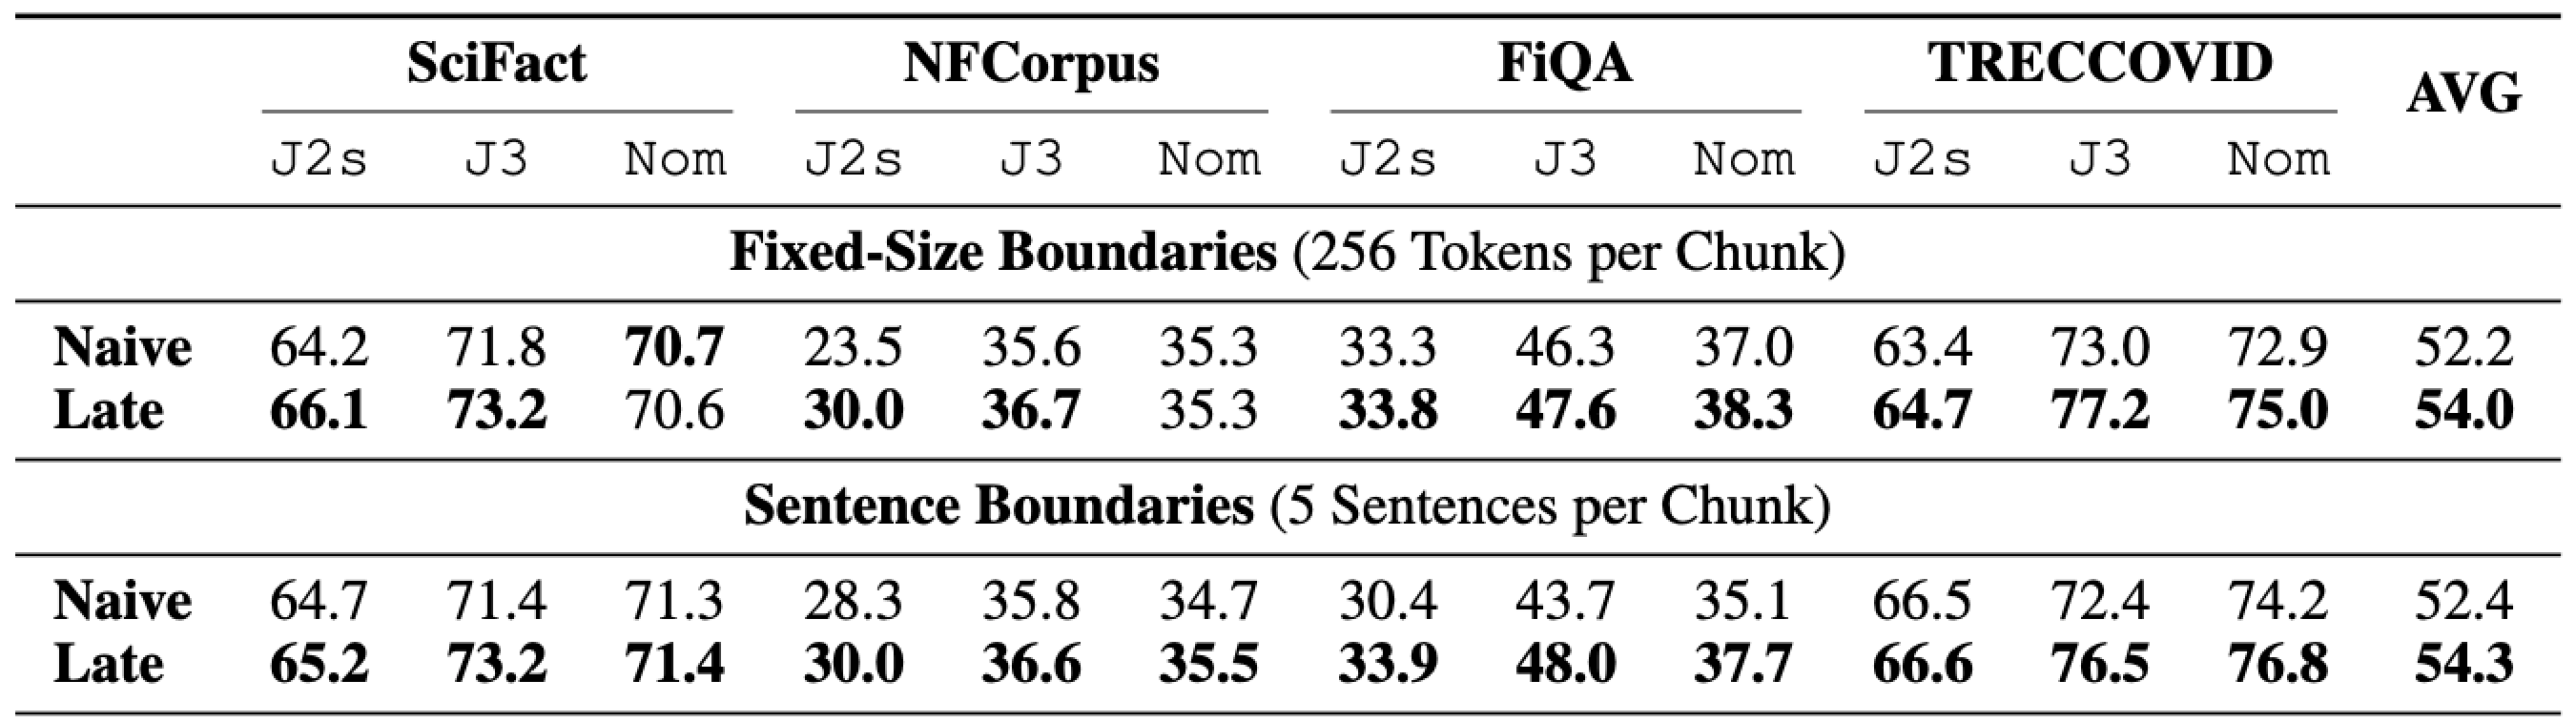
Table के columns में 4 datasets हैं: SciFact, NFCorpus, FiQA और TRECCOVID। ये BeIR नाम के benchmark के छोटे datasets हैं, यानी queries, documents और सही जवाबों के तैयार sets। हर dataset के नीचे 3 embedding models हैं: J2s यानी jina-embeddings-v2-small, J3 यानी jina-embeddings-v3, और Nom यानी nomic-embed-text-v1। paper से
Rows में दो तरह की boundaries हैं: 256-256 tokens वाले chunks, और 5-5 sentences वाले chunks। हर जोड़े में ऊपर naive है और नीचे late, और bold वाला number दोनों में बड़ा है। AVG column 12 numbers का सीधा औसत है: बारहों को जोड़िए, और 12 से भाग दीजिए। Fixed-size वाली rows पर: हिसाब मेरा
Naive का औसत: 627.0 ÷ 12 = 52.25, जिसे table 52.2 लिखती है।
Late का जोड़ 648.5 है, और 648.5 ÷ 12 = 54.04, यानी 54.0।
यानी late chunking औसत में 54.04 − 52.25 = 1.79, करीब 1.8 points आगे है। % में ये 1.79 ÷ 52.25 = 0.034, यानी करीब 3.4% का सुधार है। Sentence वाली rows में औसत 52.4 से 54.3 हुआ, यानी करीब 1.9 points।
Fixed-size वाले 12 जोड़ों में late chunking 10 बार आगे है। SciFact पर Nom के साथ वो 70.7 से 70.6 पर थोड़ा पीछे है, और NFCorpus पर Nom के साथ दोनों 35.3 पर बराबर हैं। सबसे बड़ा फ़ायदा NFCorpus पर J2s के साथ है: 23.5 से 30.0, यानी 6.5 points। Paper के मुताबिक NFCorpus में लंबे documents हैं। paper से लंबा document ज़्यादा chunks में कटता है, इसलिए वहाँ chunk ज़्यादा context खोता है।
Paper में एक तीसरी row भी है, जो slide पर नहीं है: semantic sentence boundaries, यानी मिलते-जुलते sentences एक chunk में। वहाँ भी औसत 52.4 से 53.8 हुआ। Paper ने lesson 7 वाला भी जाँचा। उसमें नया chunk पिछले के आख़िरी कुछ tokens दोहराता है, जैसे 7 शब्दों की तारीख के लिए 6 शब्द। 256 tokens के chunks में 16 tokens के overlap से न साफ़ फ़ायदा हुआ, न नुकसान। paper से
Chunk size वाले तीन charts
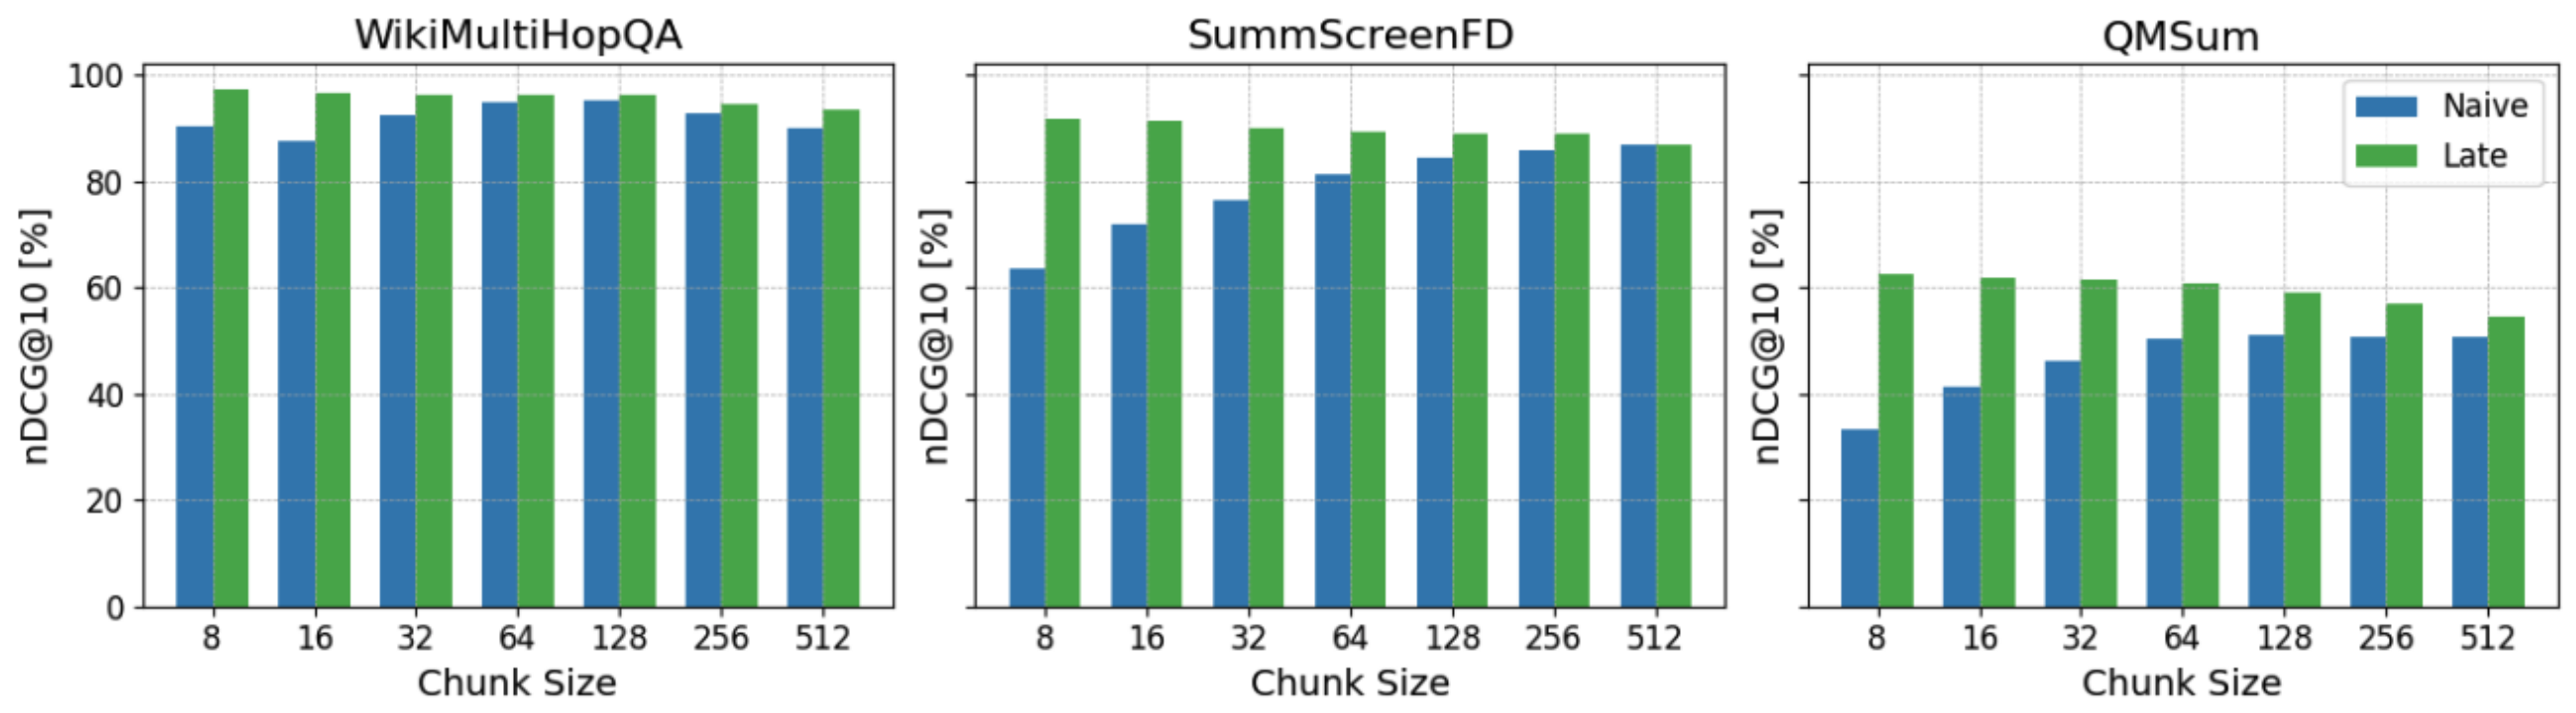
नीचे के तीन charts में x-axis पर chunk size है: 8, 16, 32, 64, 128, 256 और 512 tokens। हर अगला size पिछले का दोगुना है। y-axis पर nDCG@10 है, % में। नीली bars naive हैं, और हरी late।
तीनों datasets, WikiMultiHopQA, SummScreenFD और QMSum, LongEmbed नाम के benchmark से हैं, जिसमें लंबे documents पर reading comprehension के सवाल हैं। Model J2s था। paper से
Charts से exact numbers पढ़ना ठीक नहीं, इसलिए उनका आकार देखिए:
हर chart में छोटे chunks पर हरी bar नीली से साफ़ ऊपर है।
SummScreenFD और QMSum पर chunk बड़ा होने के साथ नीली bars ऊपर उठती हैं, और हरी bars लगभग वहीं रहती हैं। इसलिए फ़र्क घटता जाता है। WikiMultiHopQA पर दोनों रंग हर size पर ऊँचे हैं।
SummScreenFD पर 512 tokens वाली दोनों bars लगभग बराबर हैं। QMSum पर 8 tokens वाली नीली bar सबसे नीचे है, और वहीं फ़र्क सबसे बड़ा है।
Naive chunking को context तभी मिलता है, जब chunk खुद बड़ा हो। Late chunking को context पूरे document से मिलता है, chunk का size कुछ भी हो।
Long late chunking: जब document encoder की limit से लंबा हो
Slide का title Long Late Chunking कहता है। पड़ाव 4 की हद याद कीजिए: document encoder की limit में आना चाहिए। LongEmbed के कई documents J2s की 8,192 tokens की limit से लंबे हैं। Paper इनके लिए long late chunking लाता है। इसमें document को lmax tokens की बड़ी windows में पढ़िए, और हर नई window पिछली window के आख़िरी ω tokens दोहराकर शुरू कीजिए। paper से
मान लीजिए document में 20,000 tokens हैं, lmax = 8,192 और ω = 1,000। ω और document मेरे चुने हैं
पहली window tokens 1 से 8,192 तक पढ़ती है।
दूसरी window 1,000 tokens पीछे से, यानी token 7,193 से शुरू होती है, और 8,192 tokens पढ़कर 15,384 पर रुकती है।
तीसरी window 14,385 से शुरू होकर document के आख़िर, यानी token 20,000 तक जाती है।
दूसरी window के पहले 1,000 tokens सिर्फ़ context देते हैं, और उनके vectors पहली window वाले ही रहते हैं। इस तरह token 8,193 का vector भी अपने से पहले के 1,000 tokens देखकर बनता है। Slide के charts इसी long late chunking के हैं। Paper के मुताबिक इसलिए यहाँ scores उस पिछले experiment से ऊँचे हैं, जिसमें paper ने documents 8,192 tokens पर काट दिए थे। paper से
Late chunking कहाँ काम नहीं आया
Paper दो जगह late chunking को कमज़ोर पाता है। कुछ reading comprehension datasets पर बड़े chunks के साथ naive chunking बेहतर रहा। Paper का अंदाज़ा है कि वहाँ जवाब एक खास sentence है, जो बेमेल text के बीच छिपा है। Needle-8192 और Passkey-8192 नाम के बनावटी datasets में एक छोटी काम की बात बेमेल text के बीच रखी है। वहाँ आस-पास का context किसी काम का नहीं। paper से
यानी late chunking तभी मदद करता है, जब आस-पास का text सच में chunk का मतलब बताता हो। ACME की filing में company का नाम ऐसा ही text है। Paper ये भी दिखाता है कि long-context model के साथ भी chunking फ़ायदेमंद है। NarrativeQA पर J2s से बिना chunking के, 8,192 tokens पर, nDCG@10 32.73 था, और 512 tokens के chunks के साथ 47.63। paper से ये lesson 7 वाली बात है: एक vector में बहुत सारा text घुल जाता है।
8दोनों तरीके एक ही ACME example पर
Paper ने late chunking की contextual retrieval से तुलना एक छोटे experiment में की, और example वही ACME वाला है। एक बनावटी financial document के 5 chunks हैं। Query What is ACME Corp’s revenue growth for Q2 2023? है, जो slide की query से थोड़ी अलग लिखी है। सही chunk It highlighted a 3% revenue growth over the previous quarter. है, जिसमें company का नाम नहीं है। paper से
Paper ने हर chunk का query से cosine तीन तरीकों से निकाला। Contextual retrieval के लिए Claude 3 Haiku ने हर chunk के आगे context लिखा, और तीनों तरीकों में embedding model jina-embeddings-v2-small-en था। paper से
Chunk
Naive
Late
Contextual
1The recent SEC filing provided insights into ACME Corp’s performance for Q2 2023.
0.8505
0.8305
0.8069
2, सही chunkIt highlighted a 3% revenue growth over the previous quarter.
0.6343
0.8516
0.8590
3The company, which had a revenue of $314 million in the prior quarter, showed steady progress.
0.6169
0.8424
0.8546
4They attributed this growth to strategic initiatives…
0.5191
0.7997
0.8234
5The report emphasized the company’s resilience…
0.6007
0.8022
0.8061
पहले सोचिए
Retriever हर तरीके में सबसे बड़े cosine वाला एक chunk लौटाए, तो कौन सा chunk आएगा? Naive में सही chunk किस जगह पर है?
जवाब देखिए
Naive में chunk 1 आता है, 0.8505 के साथ, क्योंकि उसमें ACME Corp और Q2 2023 लिखे हैं, लेकिन growth का number नहीं। सही chunk 0.6343 के साथ दूसरी जगह पर है। Late में सही chunk 0.8516 के साथ सबसे ऊपर है, और contextual में 0.8590 के साथ।
दोनों तरीकों में सही chunk का cosine करीब 0.85 है। Paper का नतीजा यही है कि दोनों तरीके लगभग एक जैसे scores देते हैं, और late chunking को extra LLM नहीं चाहिए। ये एक document पर छोटा experiment है, इसलिए इससे बड़े corpus पर कौन जीतेगा, ये तय नहीं होता।
Contextual वाले chunks में LLM का context ACME और Q2 2023 जैसे शब्द जोड़ सकता है। तब वहाँ शब्दों वाला index भी सही chunk पकड़ सकता है। Late chunking के chunks का text वैसा ही रहता है, जैसा पड़ाव 4 में आया था।
Paper एक training तरीका भी देता है, जिसका नाम span pooling है। इसमें training के दौरान document का vector सिर्फ़ जवाब वाले हिस्से के tokens का औसत होता है। इससे model हर token में आस-पास की काम की बात भरना सीखता है। Loss lesson 12 वाले जैसा है, जिसमें scores 1.0, 2.0 और 1.5 पर loss 1.68 आया था। इस training से फ़ायदा छोटा लेकिन लगातार रहा। paper से
9अब Stanford की slides खुद पढ़िए
नीचे इस हिस्से की छहों Stanford slides हैं, बिना किसी बदलाव के। हर slide के नीचे कुछ सवाल हैं। पहले खुद जवाब सोचिए, फिर खोलिए। कोई बात अटके, तो जवाब में लिखे पड़ाव पर लौट जाइए। Phone पर slide छोटी दिखे, तो image पर click कीजिए, वो पूरे size में खुलेगी।
Stanford की slide: Why Contextual Retrieval।
पहली slide पढ़िए
बाएँ वाले chunk में query के 6 शब्दों में से कितने हैं, और ये chunk retriever के लिए मुश्किल क्यों है?
जवाब देखिए
सिर्फ़ revenue, यानी score 1। 50 companies की filings में यही line है, इसलिए पचासों chunks बराबर हैं, और top-20 का मौका 40% है। (पड़ाव 1)
पीला हिस्सा किसने लिखा, और उसे ACME और Q2 2023 कहाँ से मिले?
जवाब देखिए
LLM ने, contextual retrieval के prompt से। उसे chunk के साथ पूरा document मिला था, जिसके ऊपर company का नाम और quarter लिखे थे। (पड़ाव 2 और 5)
पीला हिस्सा बताता है कि Q1 2023 की revenue $314M थी। Q2 2023 की revenue कितनी निकलती है?
जवाब देखिए
Revenue 3% बढ़ी। 314 का 3% = 314 × 0.03 = 9.42, और 314 + 9.42 = 323.42, यानी करीब $323M। Context ने chunk को वो जानकारी भी दी, जो जवाब लिखने वाले को चाहिए। हिसाब मेरा (पड़ाव 2)
Stanford की slide: Contextual Retrieval, hybrid retrieval वाले callout के साथ। इसका diagram पड़ाव 5 में बड़ा करके है।
Pipeline वाली slide पढ़िए
Corpus से prompt वाले box तक जाती लंबी नीली line क्या ले जाती है?
जवाब देखिए
पूरा document। LLM को हर chunk के साथ पूरा document चाहिए, तभी वो बता पाता है कि chunk किस बारे में है। (पड़ाव 5)
Callout कहता है results are merged। कौन से results, और उन्हें मिलाने से क्या मिलता है?
जवाब देखिए
Vector database और TF-IDF/BM25 index, दोनों की lists। Embeddings मतलब पकड़ते हैं और BM25 exact शब्द, इसलिए contextualized chunks पर failures 3.7% से 2.9% पर आती हैं। (पड़ाव 2 और 5)
Query आने पर कितनी LLM calls लगती हैं?
जवाब देखिए
एक भी नहीं। LLM सिर्फ़ PREPROCESSING में चलता है, और query सीधे दोनों index में जाती है। (पड़ाव 2 और 5)
Stanford की slide: वही pipeline, ऊपर LLM के prompt के साथ। Prompt पड़ाव 5 में बड़ा करके है।
Prompt वाली slide पढ़िए
{{WHOLE_DOCUMENT}} और {{CHUNK_CONTENT}} क्या हैं?
जवाब देखिए
दोनों placeholders हैं, यानी खाली जगहें। Program हर call पर पहली में पूरा document भरता है, और दूसरी में वो chunk। (पड़ाव 5)
Prompt आख़िर में Answer only with the succinct context and nothing else क्यों कहता है?
जवाब देखिए
LLM का पूरा जवाब बिना बदले chunk के आगे जुड़ता है। जवाब में कोई और line हो, तो वो भी हर chunk के साथ index में चली जाएगी। (पड़ाव 5)
8,000 tokens के document में 800 tokens के chunks हैं, और instructions 50 tokens के। Caching के बिना ये prompt कुल कितने tokens पढ़ता है?
जवाब देखिए
10 calls, हर call में 8,000 + 800 + 50 = 8,850 tokens, यानी कुल 88,500, document का करीब 11 गुना। Prompt caching इसी दोहराव को सस्ता करती है। (पड़ाव 5)
Stanford की slide: Contextual Embeddings Reduced Retrieval Failure Rate, और नीचे उसका chart, बड़ा करके।
Chart वाली slide पढ़िए
हर bar किस चीज़ का औसत है, और y-axis का metric क्या है?
जवाब देखिए
चार तरह के data का औसत: codebases, fiction, ArXiv papers और science papers, Gemini Text 004 embeddings के साथ। Metric failed retrievals@20 है, जिसे blog 1 minus recall@20 कहता है। (पड़ाव 5)
नारंगी solid और dashed arrows कौन सी दो कमियाँ दिखाते हैं?
Title कहता है Contextual Embeddings। क्या यहाँ contextual embedding का मतलब lesson 7 वाला है?
जवाब देखिए
नहीं। यहाँ इसका मतलब contextualized chunk का embedding है, यानी उस text का vector, जिसके आगे LLM का context जुड़ा है। Lesson 7 का contextual embedding हर token का अपने sentence के हिसाब से vector है। (पड़ाव 5)
Stanford की slide: Late Chunking, और नीचे उसका diagram, बड़ा करके।
Late chunking वाली slide पढ़िए
Diagram पर लिखे i.i.d. embeddings और conditional embeddings का क्या मतलब है?
जवाब देखिए
i.i.d.: हर chunk का vector दूसरे chunks से बिल्कुल अलग बनता है। Conditional: हर chunk का vector पूरे document को देखकर बनता है, और dashed arrows यही असर दिखाते हैं। (पड़ाव 6)
Naive वाले box के कोने में N क्यों लिखा है, और late में model कितनी बार चलता है?
जवाब देखिए
N chunks हैं, इसलिए naive में model N बार चलता है, हर बार एक chunk पर। Late में model हर document पर एक बार चलता है। (पड़ाव 3 और 6)
बाएँ दूसरा bullet कहता है no LLM call and no added tokens per chunk, और फिर the context is carried in the vector। शब्दों वाले index के लिए इसका क्या मतलब है?
जवाब देखिए
Chunk का text नहीं बदलता, इसलिए BM25 को ACME नहीं मिलता, और ACME वाले chunk का word overlap score 1 ही रहता है। (पड़ाव 4)
Stanford की slide: Retrieval Results with Long Late Chunking for Different Chunk Sizes, और नीचे उसकी table और charts, बड़े करके।
नतीजों वाली slide पढ़िए
Table में J2s, J3 और Nom क्या हैं, और fixed-size वाली late row का AVG 54.0 कैसे बना?
जवाब देखिए
ये तीन embedding models हैं। 54.0, late row के 12 numbers का औसत है: 648.5 ÷ 12 = 54.04। (पड़ाव 7)
Table में late chunking कहाँ naive से आगे नहीं है?
जवाब देखिए
Fixed-size rows में SciFact पर Nom के साथ, 70.6 बनाम 70.7, और NFCorpus पर Nom के साथ, जहाँ दोनों 35.3 हैं। Sentence वाली rows में late हर जगह आगे है। (पड़ाव 7)
Charts में फ़र्क कहाँ सबसे बड़ा है, और title का Long क्या बताता है?
जवाब देखिए
सबसे छोटे chunks पर, क्योंकि naive chunking को वहाँ सबसे कम context मिलता है। Long का मतलब long late chunking है: encoder की limit से लंबे documents को overlap वाली windows में पढ़ना। (पड़ाव 7)
इस lesson की 3 बातें
काटने से chunk अपना context खोता है। ACME वाला chunk 49 chunks के बराबर रह गया, और top-20 में सिर्फ़ 40% बार आता है।
Contextual retrieval हर chunk के आगे LLM से context लिखवाता है। Failed retrievals@20 5.7% से 2.9% पर आया, और reranking के साथ 1.9% पर, यानी 67% कम। कीमत indexing time पर है: caching के बिना LLM document के करीब 11 गुना tokens पढ़ता है।
Late chunking पूरे document से conditional vectors बनाता है, फिर हर chunk का औसत लेता है। Paper में औसत score 52.2 से 54.0 हुआ, और फ़ायदा छोटे chunks पर सबसे बड़ा रहा। ACME वाले test में दोनों तरीकों ने सही chunk को सबसे ऊपर रखा।
इस lesson के नए शब्द
Context loss
काटने के बाद chunk ये न बता पाए कि वो किस document या विषय की बात है। जैसे The company’s revenue grew by 3% में company का नाम नहीं है।
Contextual retrieval
हर chunk के आगे LLM का लिखा 50–100 tokens का context जोड़कर index करना। जैसे From ACME Corp’s Q2 2023 SEC filing।
Failed retrievals@20
हर query का एक सही chunk हो, तो कितने % queries में वो top-20 में नहीं आया। छोटा बेहतर। जैसे 1,000 queries में 29 fail हों, तो 2.9%।
Naive chunking
पहले काटना, फिर हर chunk को अकेले encode करना। तब It is due Week 6 का vector [0.5, 0.5] रहता है।
Late chunking
पहले पूरा document encode करना, फिर हर chunk के token vectors पर mean pooling। तब It is due Week 6 का vector [0.9, 0.1] बनता है।
Long-context encoder
ऐसा encoder, जो एक बार में बहुत लंबा text पढ़ सके। जैसे 8,192 tokens, यानी करीब 10 pages।
Prompt caching
LLM service prompt का बार-बार आने वाला हिस्सा पहली call के बाद याद रखती है, जैसे पूरा document। इसलिए अगली calls में वो हिस्सा सस्ता पड़ता है। Blog के मुताबिक तब contextual retrieval का खर्च हर 10 लाख document tokens पर $1.02 है।
i.i.d. और conditional embeddings
i.i.d.: हर chunk का vector दूसरे chunks से बिल्कुल अलग बनना, जैसे naive chunking में। Conditional: हर chunk का vector पूरे document को देखकर बनना, जैसे late chunking में It का [0.9, 0.1]।
Long late chunking
Encoder की limit से लंबे document को overlap वाली बड़ी windows में पढ़कर late chunking करना। जैसे 20,000 tokens को 8,192 tokens की windows में, हर नई window 1,000 tokens पीछे से शुरू।