Retriever को नापने का मतलब है: कुछ queries पर उसकी lists देखना, और गिनना कि सही passages कितने आए और कितने ऊपर आए। इसके लिए पहले हर query के सही passages लिखने पड़ते हैं, और फिर हर metric इन lists से एक number बनाता है।
Lesson 2 में recall मोटे तौर पर गिना था। अब एक retriever को उन्हीं 3 queries पर चलाइए। पहली query पर सही passage पहले rank पर आता है, दूसरी पर दूसरे rank पर, और तीसरी पर कहीं नहीं। Top-3 में 3 में से 2 queries पर सही passage पहुँचा, यानी 0.667।
फिर आप retriever सुधारते हैं, और दूसरी query का सही passage पहले rank पर आ जाता है। Prompt में एक ही passage जाए, तो अब उस query का जवाब भी बनेगा। फिर भी top-3 वाली गिनती 0.667 पर अटकी रहती है। ये lesson ऐसे numbers बनाता है, जो ये बदलाव देख सकें।
इस lesson की सीढ़ी
सीढ़ी में 5 पड़ाव हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
MRR@kReciprocal rank निकाल पाएँगे, और दिखा पाएँगे कि सुधार MRR में दिखता है।
Recall@kRecall@k निकाल पाएँगे, सही k चुन पाएँगे, और Stanford की MRR और Recall वाली slide पढ़ पाएँगे।
nDCG@knDCG हाथ से निकाल पाएँगे, Stanford की दूसरी slide पढ़ पाएँगे, और सही metric चुन पाएँगे।
पहले से क्या चाहिए: Lesson 2 (corpus के 6 passages, top-K, recall, recall ceiling), Lesson 3 (∑ का निशान) और Lesson 4 (ln)। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1Relevance labels और sets: पहले सही passages लिखिए
Relevance labels वो list है, जिसमें कोई इंसान हर query के आगे उसके सही passages लिखता है। Retriever खुद नहीं बता सकता कि उसकी list सही है, इसलिए नापने से पहले किसी को passages पढ़कर ये list बनानी पड़ती है। हर passage को एक grade भी मिल सकता है। 3 यानी बहुत काम का, 1 यानी थोड़ा काम का, और 0 यानी काम का नहीं।
पूरे lesson में lesson 2 के corpus वाली यही 3 चलेंगी। मान लीजिए एक हर query पर 5 passages लौटाता है, और bracket में हर passage का grade है। ये retriever और grades मेरे बनाए हैं
Query
Retriever का क्रम (grade)
सही passages
q1: Least crowded office hour?
queue log (3), पुराना forum post (0), office hours page (1), syllabus (0), project page (0)
syllabus (0), Homework 1 announcement (0), project page (0), पुराना forum post (0), queue log (0)
office hours page, grade 2
q1 के दो सही passages हैं। Queue log में भीड़ का data है, और office hours page बताता है कि Thursday 9am वाला office hour Zoom पर है। असली जवाब queue log में है, इसलिए उसे grade 3 मिला, और office hours page को 1। q3 का सही passage retriever की list में कहीं नहीं है।
Sets: सही passages को छोटे नाम देना
Metrics के formulas इन lists को छोटे नाम देते हैं, और इसके लिए sets चाहिए। Set चीज़ों का एक group है, जिसे { } के अंदर लिखते हैं, और उसमें क्रम मायने नहीं रखता।
Query q के सही passages का set Rq लिखते हैं, जैसे Rq1 = {queue log, office hours page}। Retriever के ऊपर के k passages का set Topk(q) है। ये k lesson 2 वाला ही है, बस formulas में इसे छोटा लिखते हैं। तो Top3(q1) = {queue log, पुराना forum post, office hours page}। Sets के साथ तीन निशान और आते हैं:
∩ दो sets की वो चीज़ें देता है, जो दोनों में हैं। Rq1 ∩ Top3(q1) = {queue log, office hours page}, यानी q1 के दोनों सही passages top-3 में हैं।
∅ खाली set है, जिसमें कुछ नहीं। q3 पर {office hours page} ∩ {syllabus, Homework 1 announcement, project page} में कुछ भी common नहीं, इसलिए वो ∅ है।
|A| बताता है कि set A में कितनी चीज़ें हैं। |Rq1| = 2, और सारी queries के set Q के लिए |Q| = 3।
Labels की एक कीमत भी है। हर query के सही passages किसी इंसान को पढ़कर तय करने पड़ते हैं, और ये महँगा है। अगर वो कोई सही passage छोड़ दे, तो retriever उसे लाकर भी हर metric में हारता है।
2Hit@k और Failed@k: सही passage पहुँचा या नहीं
Hit@k हर query पर देखता है कि top-k में कोई सही passage है या नहीं, और फिर queries का औसत लेता है। अगर है, तो उस query को 1 मिलता है, नहीं तो 0। k = 3 पर q1 के top-3 में queue log और office hours page हैं, इसलिए 1। q2 के top-3 में syllabus है, इसलिए 1। q3 के top-3 में कोई सही passage नहीं, इसलिए 0।
तीनों queries के numbers जोड़िए: 1 + 1 + 0 = 2।
जोड़ को queries की गिनती से भाग दीजिए, यानी औसत लीजिए: 2 ÷ 3 = 0.667।
Hit@3 = 0.667, और ये शुरू वाला number है।
“सच हो तो 1, झूठ हो तो 0” वाले इस नियम का एक निशान है: । जैसे 𝟙[2 > 1] = 1, और 𝟙[2 > 3] = 0। Hit@k में शर्त ये है कि Rq ∩ Topk(q) खाली न हो, और इसे ≠ ∅ लिखते हैं, जहाँ ≠ का मतलब है “बराबर नहीं”। q3 पर ∩ खाली है, इसलिए 𝟙[Rq3 ∩ Top3(q3) ≠ ∅] = 0। Formula में ऊपर के दोनों steps यही हैं:
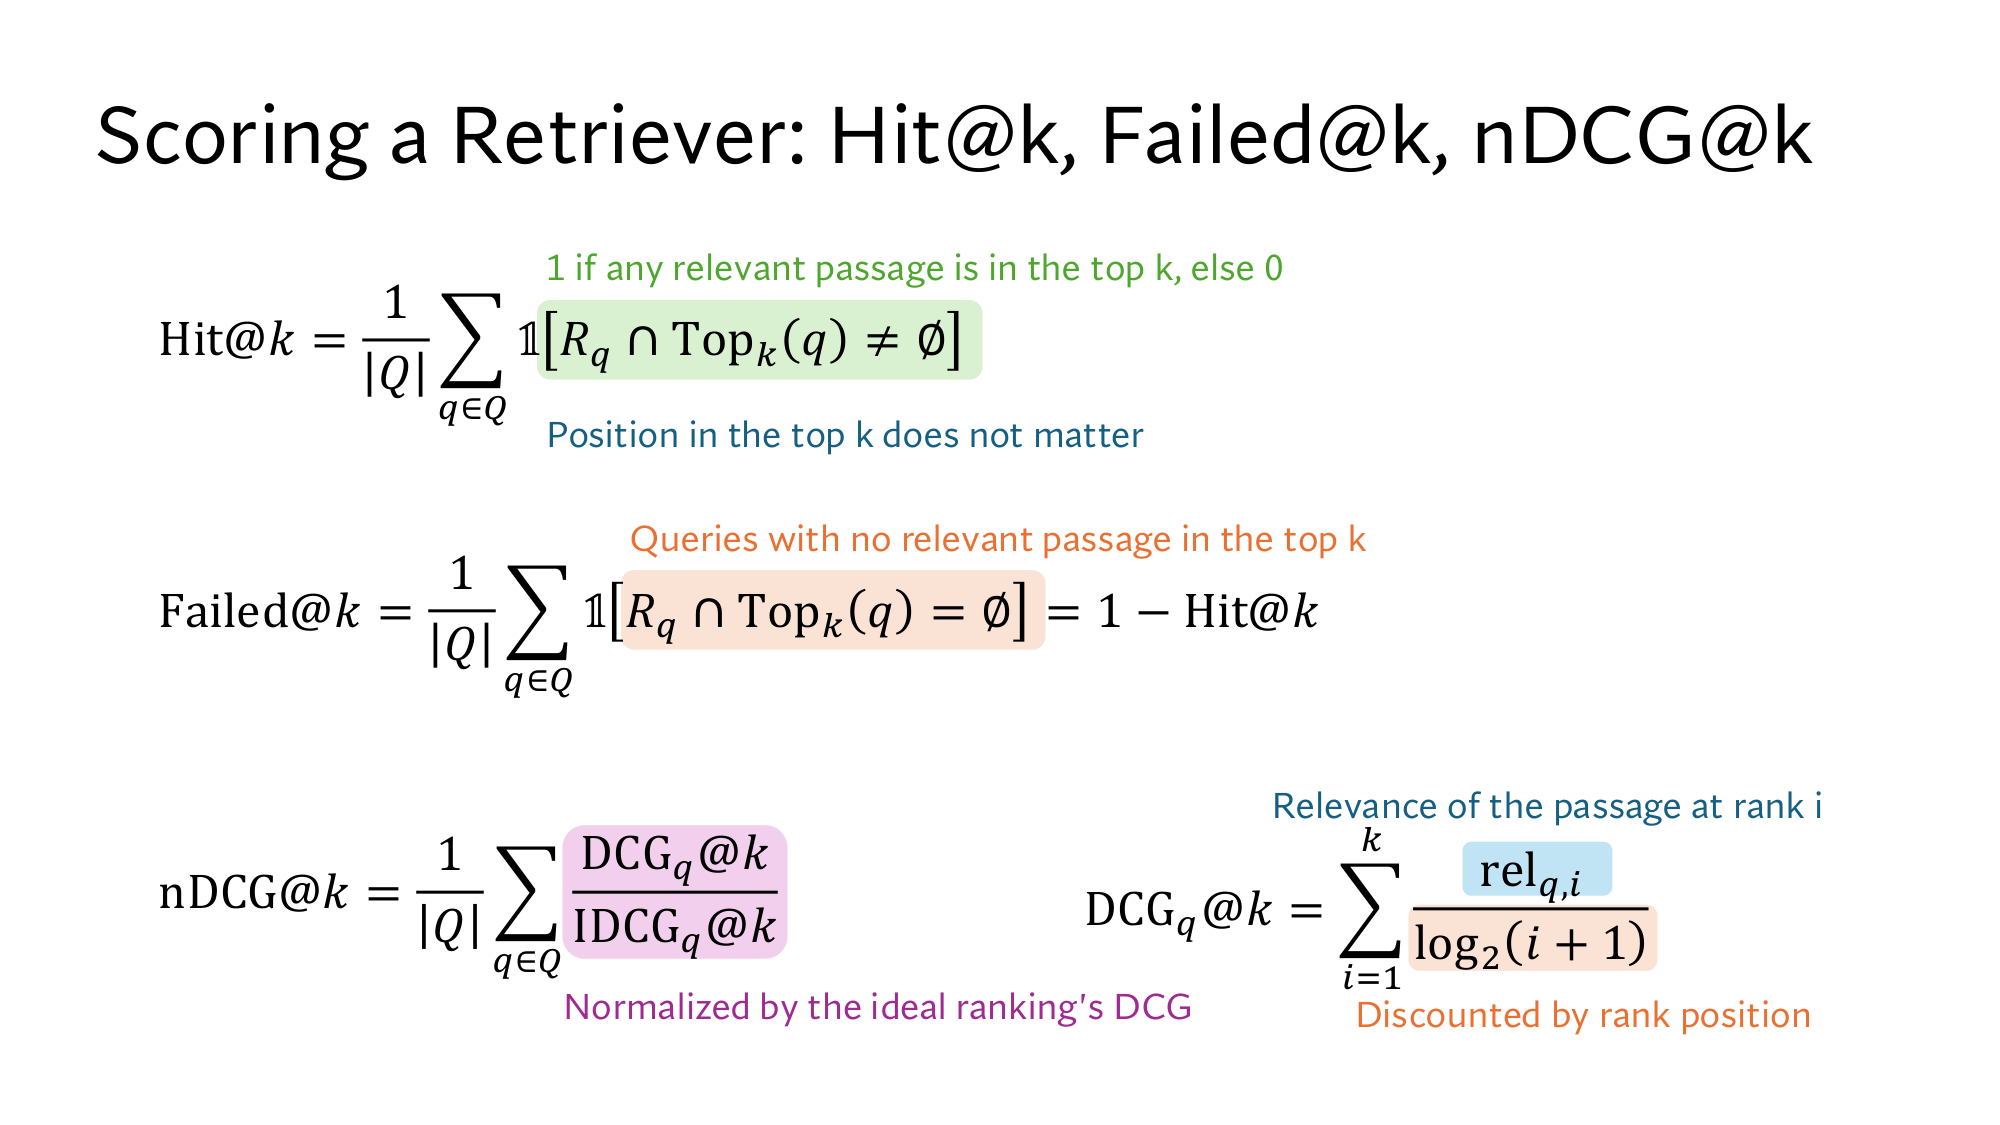
Hit@k = 1|Q|∑q ∈ Q 𝟙[Rq ∩ Topk(q) ≠ ∅]
q ∈ Q
Q की हर query q पर जोड़िए। ∈ का मतलब है “इस set में से एक”। यहाँ 1 + 1 + 0 = 2।
1 ÷ |Q|
Queries की गिनती से भाग, यानी औसत। यहाँ 2 ÷ 3 = 0.667।
Failed@k इसका उल्टा है: कितनी queries पर top-k में एक भी सही passage नहीं पहुँचा। हर query पर Hit का 1 या Failed का 1 लगता है, कभी दोनों नहीं, इसलिए Failed@k = 1 − Hit@k। यहाँ Failed@3 = 1 − 0.667 = 0.333, क्योंकि 3 में से 1 query, q3, fail हुई।
Hit@3 = 0.667 ही यहाँ lesson 2 की है, क्योंकि 3 में से 2 से ज़्यादा जवाब passages से नहीं बन सकते। यही numbers आगे दूसरे नामों से आते हैं। Lesson 8 का Failed@20 ही है, क्योंकि वहाँ हर query का एक सही chunk था। Lesson 12 की Hit@20 है।
अब शुरू वाला सुधार देखिए। q2 का syllabus rank 2 से rank 1 पर आया, लेकिन दोनों बार वो top-3 के अंदर है, इसलिए q2 को दोनों बार 1 मिला। Hit@k ये नहीं देखता कि top-k के अंदर सही passage कहाँ है। Stanford की slide भी Hit@k के नीचे यही लिखती है: Position in the top k does not matter।
k = 1 लें, तो ये सुधार दिखता है: Hit@1 पहले 1 ÷ 3 = 0.333 था, और सुधार के बाद 2 ÷ 3 = 0.667 है। लेकिन तब Hit@1 rank 2 और rank 5 में फ़र्क नहीं करता, क्योंकि दोनों पर 0 मिलता है। मतलब हर k पर Hit@k क्रम का बस एक टुकड़ा देखता है।
3MRR@k: पहला सही passage कितना ऊपर है
Reciprocal rank पहले सही passage के rank का उल्टा है, यानी 1 ÷ rank, और MRR इसी का queries पर औसत है। किसी number का उल्टा, यानी 1 को उस number से भाग। पहला सही passage rank 1 पर हो, तो 1 ÷ 1 = 1। Rank 2 पर हो, तो 1 ÷ 2 = 0.5, और rank 3 पर 1 ÷ 3 = 0.333। Top-k में कोई सही passage न हो, तो 0।
अब k = 3 पर तीनों queries देखिए। q1 का पहला सही passage queue log rank 1 पर है, तो 1। q2 का syllabus rank 2 पर है, तो 0.5। q3 के top-3 में कोई सही passage नहीं, तो 0।
तीनों reciprocal ranks जोड़िए: 1 + 0.5 + 0 = 1.5।
3 queries से भाग दीजिए: 1.5 ÷ 3 = 0.5।
इस औसत को MRR कहते हैं, यानी mean reciprocal rank, और यहाँ MRR@3 = 0.5। Formula में यही दो steps हैं:
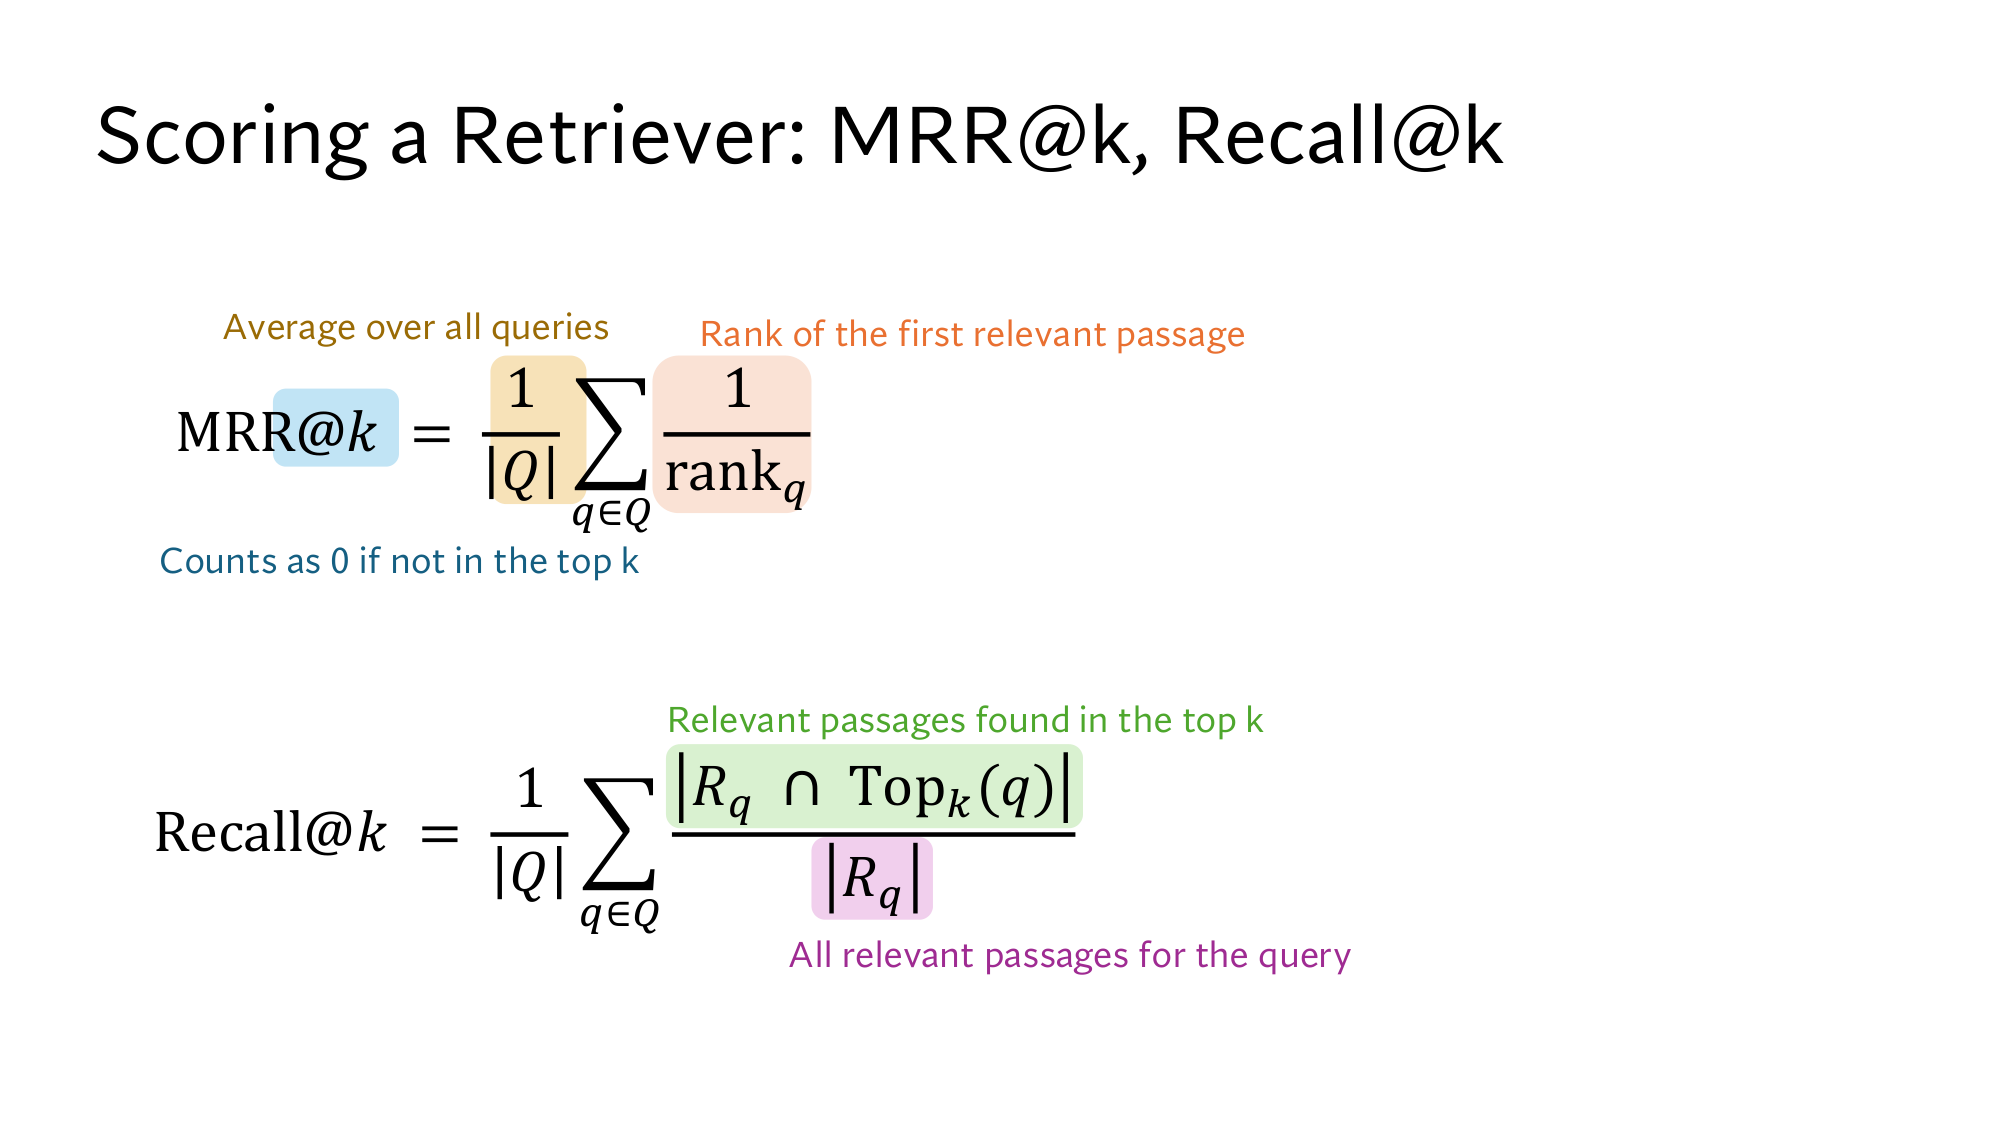
MRR@k = 1|Q|∑q ∈ Q1rankq
rankq
Query q का पहला सही passage किस rank पर है: q1 पर 1, और q2 पर 2। q3 पर top-3 में कोई नहीं, इसलिए 0।
अब शुरू वाला सुधार देखिए। q2 का syllabus rank 1 पर आया, तो q2 का reciprocal rank 0.5 से 1 हो गया, और MRR@3 = (1 + 1 + 0) ÷ 3 = 0.667। Hit@3 नहीं हिला था, लेकिन MRR@3 0.5 से 0.667 पर गया।ये सुधार मेरा बनाया example है
MRR तब सबसे काम का है, जब एक सही passage काफ़ी हो, जैसे q2 पर, जिसकी पूरी तारीख syllabus में है। Lesson 14 और 15 के retrievers की तुलना भी MRR@10 से होती है।
लेकिन MRR सिर्फ़ पहला सही passage देखता है। q1 में office hours page rank 3 पर हो या top-3 से बाहर, q1 का reciprocal rank 1 ही रहता है। जबकि q1 के पूरे जवाब को दोनों passages चाहिए: queue log से समय, और office hours page से ये कि वो Zoom पर है।
4Recall@k: सारे सही passages में से कितने पहुँचे
Recall@k हर query पर गिनता है कि उसके सारे सही passages में से कितना हिस्सा top-k में आया, और फिर queries का औसत लेता है। q1 जैसी query पर एक सही passage काफ़ी नहीं है, क्योंकि reader को queue log से समय मिलता है और office hours page से जगह।
k = 3 पर q1 के 2 में से 2 सही passages मिले, q2 का 1 में से 1, और q3 का 1 में से 0।
हर query का हिस्सा: q1 पर 2 ÷ 2 = 1, q2 पर 1 ÷ 1 = 1, और q3 पर 0 ÷ 1 = 0।
औसत: (1 + 1 + 0) ÷ 3 = 0.667।
इस number को Recall@k कहते हैं। Lesson 2 में मोटे तौर पर आया था, जैसे 100 में से 60 सवालों पर सही passage मिला, तो 0.6। ये उसका पक्का रूप है।
k = 1 पर Recall और Hit का फ़र्क दिखता है। q1 के top-1 में सिर्फ़ queue log है, यानी 2 में से 1, तो 0.5। q2 और q3 पर 0। Recall@1 = (0.5 + 0 + 0) ÷ 3 = 0.167, जबकि Hit@1 = 0.333। Hit@1 ने q1 को पूरा 1 दिया, और Recall@1 ने सिर्फ़ आधा, क्योंकि office hours page छूट गया।
Recall@k = 1|Q|∑q ∈ Q|Rq ∩ Topk(q)||Rq|
|Rq ∩ Topk(q)|
Top-k में मिले सही passages की गिनती। k = 1 पर q1 के लिए |{queue log}| = 1।
|Rq|
उस query के कुल सही passages। q1 के लिए 2, तो q1 का हिस्सा 1 ÷ 2 = 0.5।
Recall@k की एक कमज़ोरी है: k बढ़ाने पर वो कभी नहीं घटता, क्योंकि top-k में passages सिर्फ़ जुड़ते हैं, निकलते नहीं। k = 1,000 पर recall बहुत ऊँचा दिखेगा, लेकिन lesson 2 के हिसाब से में करीब 14 passages ही समाते हैं। इसलिए Recall@k उसी k पर देखिए, जितने passages आप सच में prompt में डालते हैं। Recall@k भी top-k के अंदर का क्रम नहीं देखता: q1 पर queue log rank 1 पर हो या rank 3 पर, Recall@3 वही रहता है।
Lesson 10 में का recall exact search की list से तुलना करता है: exact top-10 में से 9 मिले, तो 0.9। Recall@k की तुलना इंसान के लिखे relevance labels से होती है।
Stanford की slide: MRR@k और Recall@k के formulas। अब आप इसकी हर line पढ़ सकते हैं। Image पर click करने से वो पूरे size में खुलती है।
5nDCG@k: ज़्यादा काम का passage ऊपर है या नहीं
nDCG@k हर grade को उसके rank के हिसाब से घटाकर जोड़ता है, फिर उस जोड़ को सबसे अच्छे क्रम वाले जोड़ से भाग देता है। इसलिए वो दो चीज़ें साथ देखता है: passage कितना काम का है, और कितना ऊपर है। अब तक के तीनों metrics में passage या तो सही था या गलत।
पहले सोचिए
q1 का क्रम उलट दीजिए: office hours page (1), पुराना forum post (0), queue log (3)। Hit@3, reciprocal rank और Recall@3 में से q1 पर कौन सा number बदलेगा?
जवाब देखिए
एक भी नहीं। Hit 1 है, reciprocal rank भी 1 है, क्योंकि office hours page भी सही है, और Recall 2 में से 2 है। लेकिन reader के लिए ये list बदतर है, क्योंकि भीड़ का data अब तीसरे rank पर है।
पहली कोशिश ये हो सकती है कि top-k के grades जोड़ दें। लेकिन पुराने क्रम में 3 + 0 + 1 = 4 है, और उलटे क्रम में 1 + 0 + 3 = 4, यानी जोड़ grade देखता है, क्रम नहीं। इसलिए हर grade को उसके rank के हिसाब से घटाते हैं, ताकि नीचे वाला passage कम गिने।
log2(rank + 1) से भाग
घटाने के लिए grade को (rank + 1) से भाग देते हैं। log2 x का मतलब है: 2 को किस power तक उठाएँ, कि x मिले। 21 = 2, 22 = 4 और 23 = 8, इसलिए log2 2 = 1, log2 4 = 2 और log2 8 = 3। 3 का log2 1 और 2 के बीच है, क्योंकि 3 भी 2 और 4 के बीच है: log2 3 = 1.585। जाँच: 21.585 = 3.000।
ये lesson 4 वाले जैसा ही है। वहाँ base e था, जो करीब 2.718 है, और यहाँ base 2 है। Rank में 1 इसलिए जोड़ते हैं, ताकि rank 1 पर भाजक log2 2 = 1 हो, और सबसे ऊपर वाला passage अपना पूरा grade रखे:
Rank
log2(rank + 1)
Grade का कितना हिस्सा गिनता है
1
log2 2 = 1
1 ÷ 1 = 1
2
log2 3 = 1.585
1 ÷ 1.585 = 0.631
3
log2 4 = 2
1 ÷ 2 = 0.5
अब q1 के पुराने क्रम का जोड़ निकालिए:
Rank 1, queue log: 3 ÷ 1 = 3।
Rank 2, पुराना forum post: 0 ÷ 1.585 = 0।
Rank 3, office hours page: 1 ÷ 2 = 0.5।
जोड़: 3 + 0 + 0.5 = 3.5।
उलटे क्रम में office hours page rank 1 पर है और queue log rank 3 पर: 1 ÷ 1 + 0 + 3 ÷ 2 = 1 + 1.5 = 2.5। अब क्रम दिखता है, क्योंकि 3.5 और 2.5 अलग हैं। इस जोड़ को कहते हैं, यानी discounted cumulative gain। Gain यानी grade, cumulative यानी जोड़, और discounted यानी rank के हिसाब से घटाया हुआ।
IDCG से भाग: हर query को 0 से 1 के बीच लाना
एक दिक्कत बाकी है: DCG कितना बड़ा हो सकता है, ये query पर टिका है। q1 के दो सही passages हैं, grade 3 और 1, इसलिए उसका DCG 3.631 तक जा सकता है। q3 का एक ही सही passage है, grade 2, इसलिए उसका DCG 2 से ऊपर नहीं जा सकता। सीधा औसत लें, तो ज़्यादा सही passages वाली queries का वज़न ज़्यादा रहेगा।
इसलिए हर query का DCG उसी query के सबसे अच्छे possible क्रम के DCG से भाग देते हैं, जिसे IDCG, यानी ideal DCG कहते हैं। q1 का सबसे अच्छा क्रम queue log (3), office hours page (1) है, इसलिए IDCG = 3 ÷ 1 + 1 ÷ 1.585 = 3.631। ये क्रम सारे labels से बनता है, retriever की list से नहीं, इसलिए q3 का IDCG 2 है।
अब पुराने क्रम का 3.5 ÷ 3.631 = 0.964 है, और उलटे क्रम का 2.5 ÷ 3.631 = 0.689। इस भाग को nDCG कहते हैं, जहाँ n का मतलब normalized है। ये 0 से 1 के बीच रहता है, और 1 का मतलब है कि इससे अच्छा क्रम हो ही नहीं सकता।
Hit, reciprocal rank और Recall ने उलटा क्रम नहीं पकड़ा, लेकिन nDCG 0.964 से 0.689 पर गिरा। Formula में यही हिसाब है, और फिर हर query के nDCG का औसत:
यहाँ relq,i rank i वाले passage का grade है, जो q1 के पुराने क्रम में 3, 0 और 1 है। बाकी दो queries पर भी यही हिसाब चलता है। q3 का सही passage top-3 में नहीं है, इसलिए उसका DCG 0 है, और nDCG भी 0।
Query, k = 3
DCG
IDCG
nDCG
q1queue log (3), forum post (0), office hours page (1)
3.5
3.631
0.964
q2project page (0), syllabus (3), Homework 1 (0)
?
3
?
q3syllabus (0), Homework 1 (0), project page (0)
0
2
0
दूसरी row आप निकालिए
q2 का सही passage syllabus (grade 3) rank 2 पर है। उसका DCG और nDCG कितना है? फिर तीनों queries का nDCG@3 निकालिए।
जवाब देखिए
DCG = 3 ÷ log2 3 = 3 ÷ 1.585 = 1.893। IDCG = 3 ÷ 1 = 3, क्योंकि सबसे अच्छे क्रम में syllabus rank 1 पर होता। nDCG = 1.893 ÷ 3 = 0.631।
nDCG@3 = (0.964 + 0.631 + 0) ÷ 3 = 0.532।
q1 का क्रम बदलिए
“ऊपर” दबाकर passage को एक rank ऊपर कीजिए, और k बदलिए। सही passages पर रंगीन border है। उलटा क्रम बनाइए, और nDCG 0.689 देखिए।
Metric (सिर्फ़ q1)
Value
Stanford की slide: Hit@k, Failed@k और nDCG@k के formulas। अब आप इसकी हर line पढ़ सकते हैं।
एक retriever, चार numbers
अब शुरू वाले retriever के चारों numbers एक साथ रखिए। List वही है और k = 3 है, फिर भी चार अलग numbers आते हैं:
Query
Hit@3
Reciprocal rank
Recall@3
nDCG@3
q1
1
1
1
0.964
q2
1
0.5
1
0.631
q3
0
0
0
0
औसत
0.667
0.5MRR@3
0.667
0.532
शुरू वाला सुधार अब फिर देखिए। q2 का syllabus rank 1 पर आए, तो उसका nDCG 3 ÷ 3 = 1 हो जाता है, और nDCG@3 = (0.964 + 1 + 0) ÷ 3 = 0.655। MRR@3 भी 0.667 होता है, जबकि Hit@3 और Recall@3 0.667 पर ही रहते हैं।
nDCG की कीमत ये है कि उसे grades चाहिए, जो सही-गलत वाले labels से भी महँगे हैं। Lesson 8 के late chunking वाले scores यही nDCG@10 थे, % में। हर metric अलग सवाल का जवाब देता है:
Metric
किस सवाल का जवाब देता है
कब लें
Hit@k, Failed@k
Reader को कम से कम एक सही passage मिला?
Recall ceiling नापने के लिए
MRR@k
पहला सही passage कितना ऊपर है?
जब एक सही passage काफ़ी हो
Recall@k
सारे सही passages में से कितने मिले?
जब जवाब कई passages में बँटा हो
nDCG@k
ज़्यादा काम के passages ऊपर हैं?
जब grades हों, और क्रम मायने रखता हो
पहले सोचिए
एक support bot के prompt में top-5 passages जाते हैं, और ज़्यादातर जवाब एक passage में हैं। Retriever A का पहला सही passage हर query पर rank 2 पर है। Retriever B का आधी queries पर rank 1 पर है, और आधी पर top-5 में नहीं। दोनों का MRR@5 और Hit@5 निकालिए। आप कौन सा लेंगे?
जवाब देखिए
MRR@5: A = 0.5, और B = (1 + 0) ÷ 2 = 0.5, यानी बराबर। Hit@5: A = 1.0, और B = 0.5।
A लीजिए। A हर query पर reader तक सही passage पहुँचाता है, और B आधी queries पर कुछ नहीं देता। सिर्फ़ MRR देखते, तो ये फ़र्क दिखता ही नहीं।
गहरे version में और क्या है
गहरे version में ये पूरा lesson है, और उसके बाद 5 पड़ाव और, जो Stanford की slides के level तक ले जाते हैं:
पड़ाव 6: slides के symbols, और sets और 𝟙 के नियम, जिनसे Failed@k = 1 − Hit@k निकलता है।
पड़ाव 7: discount का गणित: 1 ÷ rank और 1 ÷ log2(rank + 1) की table, harmonic series, और ideal DCG।
पड़ाव 8: queries का औसत, % और points, और Stanford का nDCG@10 वाला chart।
पड़ाव 9: papers में ये metrics: DPR का Hit@20, MS MARCO का MRR@10 और ColBERT का Recall@1000।
पड़ाव 10: Stanford की तीनों slides, जिन्हें आप खुद पढ़ते हैं।
हर metric के लिए relevance labels चाहिए: हर query के सही passages Rq, और कभी उनके grades।
Hit@k पूछता है कि सही passage पहुँचा या नहीं, और MRR कि पहला सही passage कितना ऊपर है। Recall@k पूछता है कि सारे सही passages में से कितने पहुँचे, और nDCG कि ज़्यादा काम का passage ऊपर है या नहीं।
एक number से पूरी बात नहीं दिखती। Hit@k या Recall@k उसी k पर देखिए, जितने passages prompt में जाते हैं, और क्रम के लिए MRR या nDCG देखिए।
इस lesson के नए शब्द
Relevance labels
हर query के लिए पहले से तय सही passages, कभी grades के साथ। जैसे q1 के लिए queue log (grade 3) और office hours page (grade 1)।
Set, ∩, ∅, |A|
चीज़ों का group, दो sets की common चीज़ें, खाली set, और set में कितनी चीज़ें हैं। जैसे |{queue log, office hours page}| = 2, और q3 पर Rq3 ∩ Top3(q3) = ∅।
𝟙[शर्त]
शर्त सच हो तो 1, नहीं तो 0। जैसे q3 के top-3 में कोई सही passage नहीं है, तो 𝟙[Rq3 ∩ Top3(q3) ≠ ∅] = 0।
Hit@k
कितने हिस्से queries में top-k में कम से कम एक सही passage है। जैसे k = 3 पर 3 में से 2 queries, यानी 0.667।
Failed@k
1 − Hit@k, यानी कितने हिस्से queries में top-k में एक भी सही passage नहीं। जैसे Failed@3 = 1 − 0.667 = 0.333।
MRR@k
पहले सही passage के rank का उल्टा (1 ÷ rank), queries का औसत, और top-k में न हो तो 0। जैसे ranks 1, 2 और कोई नहीं, तो (1 + 0.5 + 0) ÷ 3 = 0.5।
Recall@k
Top-k में मिले सही passages ÷ कुल सही passages, queries का औसत। जैसे k = 1 पर q1 में 2 में से 1 मिला, तो 0.5।
log2
2 को किस power तक उठाएँ कि number मिले। जैसे log2 4 = 2, और log2 3 = 1.585।
DCG और IDCG
हर rank का grade ÷ log2(rank + 1), फिर जोड़। IDCG सबसे अच्छे क्रम का DCG। जैसे q1 का क्रम queue log (3), forum post (0), office hours page (1): DCG 3.5, IDCG 3.631।
nDCG@k
DCG ÷ IDCG, 0 से 1 के बीच, जो grade और क्रम दोनों देखता है। जैसे q1 के उलटे क्रम पर 2.5 ÷ 3.631 = 0.689।