ColBERT एक retriever है, जो passage के हर token का अलग vector रखता है। Query के हर token के लिए वो passage में सबसे अच्छा match ढूँढता है, और इन matches के scores जोड़कर passage का score बनाता है। Passages के सारे token vectors सवाल आने से पहले बन जाते हैं, इसलिए ColBERT तेज़ भी रहता है। इसे Khattab और Zaharia ने 2020 में बनाया।
इसकी ज़रूरत lesson 12 के आख़िर में दिखी थी: error 4012 जैसा rare code passage के एक vector में दब जाता है। Query error 4012 पर जवाब एक लंबे FAQ में है, लेकिन एक vector वाला bi-encoder एक छोटे, गलत passage को ऊपर रखता है। Lesson 14 का cross-encoder ये गलती ठीक करता है, लेकिन हर passage पर 10.7 ms लेता है।
इस lesson की सीढ़ी
सीढ़ी में 4 पड़ाव हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
पहले से क्या चाहिए: Lesson 3 (dot product, cosine), Lesson 7 (token के vectors, mean pooling), Lesson 13 (MRR@k, Recall@k) और Lesson 14 (cross-encoder, reranking)। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1एक vector में 4012 दब जाता है
Bi-encoder पूरे passage को एक vector में समेटता है, और लंबे passage में एक ज़रूरी token उस vector में दब सकता है। बहुत से bi-encoders ये vector से बनाते हैं। Lesson 7 में इसका मतलब था: सारे token vectors का हर number जोड़िए, और tokens की गिनती से भाग दीजिए। जैसे [0.9, 0.1] और [0.7, 0.3] का औसत [0.8, 0.2] है।
अब query error 4012 लीजिए, जिसमें 2 tokens हैं। हर token के vector में 3 numbers हैं। पहला number बताता है कि token error या upload की बात कितनी करता है, दूसरा code 4012 की बात कितनी, और तीसरा बाकी विषयों की। Query के tokens हैं error = [1, 0, 0] और 4012 = [0, 1, 0]। vectors मेरे बनाए हैं
Course के लंबे FAQ में grading, late days और Zoom की बातें हैं, और एक line error 4012 का हल बताती है। छोटे upload note में बस इतना है कि upload errors होते रहते हैं। असली FAQ में सैकड़ों tokens होंगे, यहाँ हिसाब के लिए 6 हैं।
Text
Tokens और उनके vectors
औसत vector
Query
error [1, 0, 0], 4012 [0, 1, 0]
[0.5, 0.5, 0]
Course FAQ6 tokens, जवाब इसी में
grading, late, days, zoom: हर एक [0, 0, 1]। error [0.9, 0, 0.1], 4012 [0.1, 0.95, 0]
पहला number: सिर्फ़ error और 4012 का पहला number 0 नहीं है। 0.9 + 0.1 = 1.0, और 1.0 ÷ 6 = 0.167।
दूसरा number: सिर्फ़ 4012 का 0.95 है, और 0.95 ÷ 6 = 0.158।
तीसरा number: चार tokens के 1, और error का 0.1, यानी 4.1। फिर 4.1 ÷ 6 = 0.683।
तीसरा number सबसे बड़ा है, यानी FAQ का vector ज़्यादातर बाकी विषयों की तरफ़ है। अब lesson 3 वाला लीजिए, जो दो vectors का dot product उनकी लंबाइयों के गुणा से भाग देकर देता है। जैसे [1, 0] और [1, 1] का cosine 1 ÷ (1 × 1.414) = 0.707 है। Query के औसत से FAQ के औसत का cosine 0.32 आता है, और upload note के औसत का 0.73।
इसलिए गलत upload note ऊपर आया, और जवाब वाला FAQ नीचे। FAQ में 4012 था, लेकिन औसत में उसका हिस्सा 6 में से 1 ही रहा। Lesson 14 ने ऐसी हालत में से BM25 को साथ लिया था। ColBERT दूसरा रास्ता लेता है: वो tokens का औसत लेता ही नहीं।
2MaxSim: query के हर token का सबसे अच्छा match
ColBERT passage के हर token का अपना vector रखता है, और query के हर token का vector भी अलग रखता है। ये lesson 7 वाले token vectors ही हैं, यानी हर token का vector उसके आस-पास के शब्दों के असर से बनता है। फ़र्क बस इतना है कि ColBERT इनका औसत नहीं लेता।
Lesson 12 के DPR की तरह document encoder ये vectors बनाकर एक में रखता है, यानी सवाल आने से पहले। सवाल आने पर query encoder सिर्फ़ query के tokens के vectors बनाता है।
Score दो steps में बनता है। पहले query के हर token के लिए passage के हर token से लीजिए, और सबसे बड़ा रखिए। फिर query के सारे tokens के ये सबसे बड़े numbers जोड़िए। इस score को MaxSim कहते हैं।
पहले सोचिए
औसत में grading, late, days और zoom ने 4012 को दबा दिया था। क्या MaxSim में भी ये चार tokens FAQ का score घटाएँगे?
जवाब देखिए
नहीं। Query के दोनों tokens से इन चारों का dot product 0 है, और MaxSim हर query token का सिर्फ़ सबसे बड़ा dot product रखता है। FAQ में दोनों के लिए 0 से बड़ा match है, इसलिए ये चार tokens जोड़ में आते ही नहीं।
नीचे की table में हर row FAQ का एक token है, और हर column query का एक token। हर cell उनका dot product है, और हर column का सबसे बड़ा cell रंगा है।
FAQ का token
Query का error [1, 0, 0]
Query का 4012 [0, 1, 0]
grading, late, days, zoomहर एक [0, 0, 1]
0
0
error[0.9, 0, 0.1]
0.9
0
4012[0.1, 0.95, 0]
0.1
0.95
Column का सबसे बड़ा
0.9
0.95
जैसे query के error और FAQ के 4012 का dot product: 1 × 0.1 + 0 × 0.95 + 0 × 0 = 0.1। Error वाले column में सबसे बड़ा number 0.9 है, और 4012 वाले में 0.95। इसलिए FAQ का MaxSim = 0.9 + 0.95 = 1.85 है।
Upload note की table इसी तरह बनती है:
Upload note का token
Query का error [1, 0, 0]
Query का 4012 [0, 1, 0]
upload[0.8, 0.1, 0.1]
0.8
0.1
errors[0.95, 0.05, 0]
0.95
0.05
happen[0.5, 0, 0.5]
0.5
0
Column का सबसे बड़ा
0.95
0.1
Upload note का MaxSim = 0.95 + 0.1 = 1.05 है, इसलिए अब जवाब वाला FAQ ऊपर है: 1.85 बनाम 1.05। Upload note में 4012 से मिलने वाला कोई token नहीं है, इसलिए 4012 वाले column में उसका max सिर्फ़ 0.1 है।
Formula में यही दो steps हैं। Stanford की slide passage को d लिखती है, document से:
Sq,d = ∑i ∈ q maxjqi · dj
qi
Query के token i का vector। जैसे error = [1, 0, 0]।
dj
Passage के token j का vector। जैसे FAQ का 4012 = [0.1, 0.95, 0]।
maxj
Passage के सारे tokens j में से सबसे बड़ा dot product। FAQ पर error वाले column में 0.9।
∑i ∈ q
Query के हर token i का max, फिर उनका । ∈ का मतलब है “इसका हिस्सा”। FAQ पर 0.9 + 0.95 = 1.85।
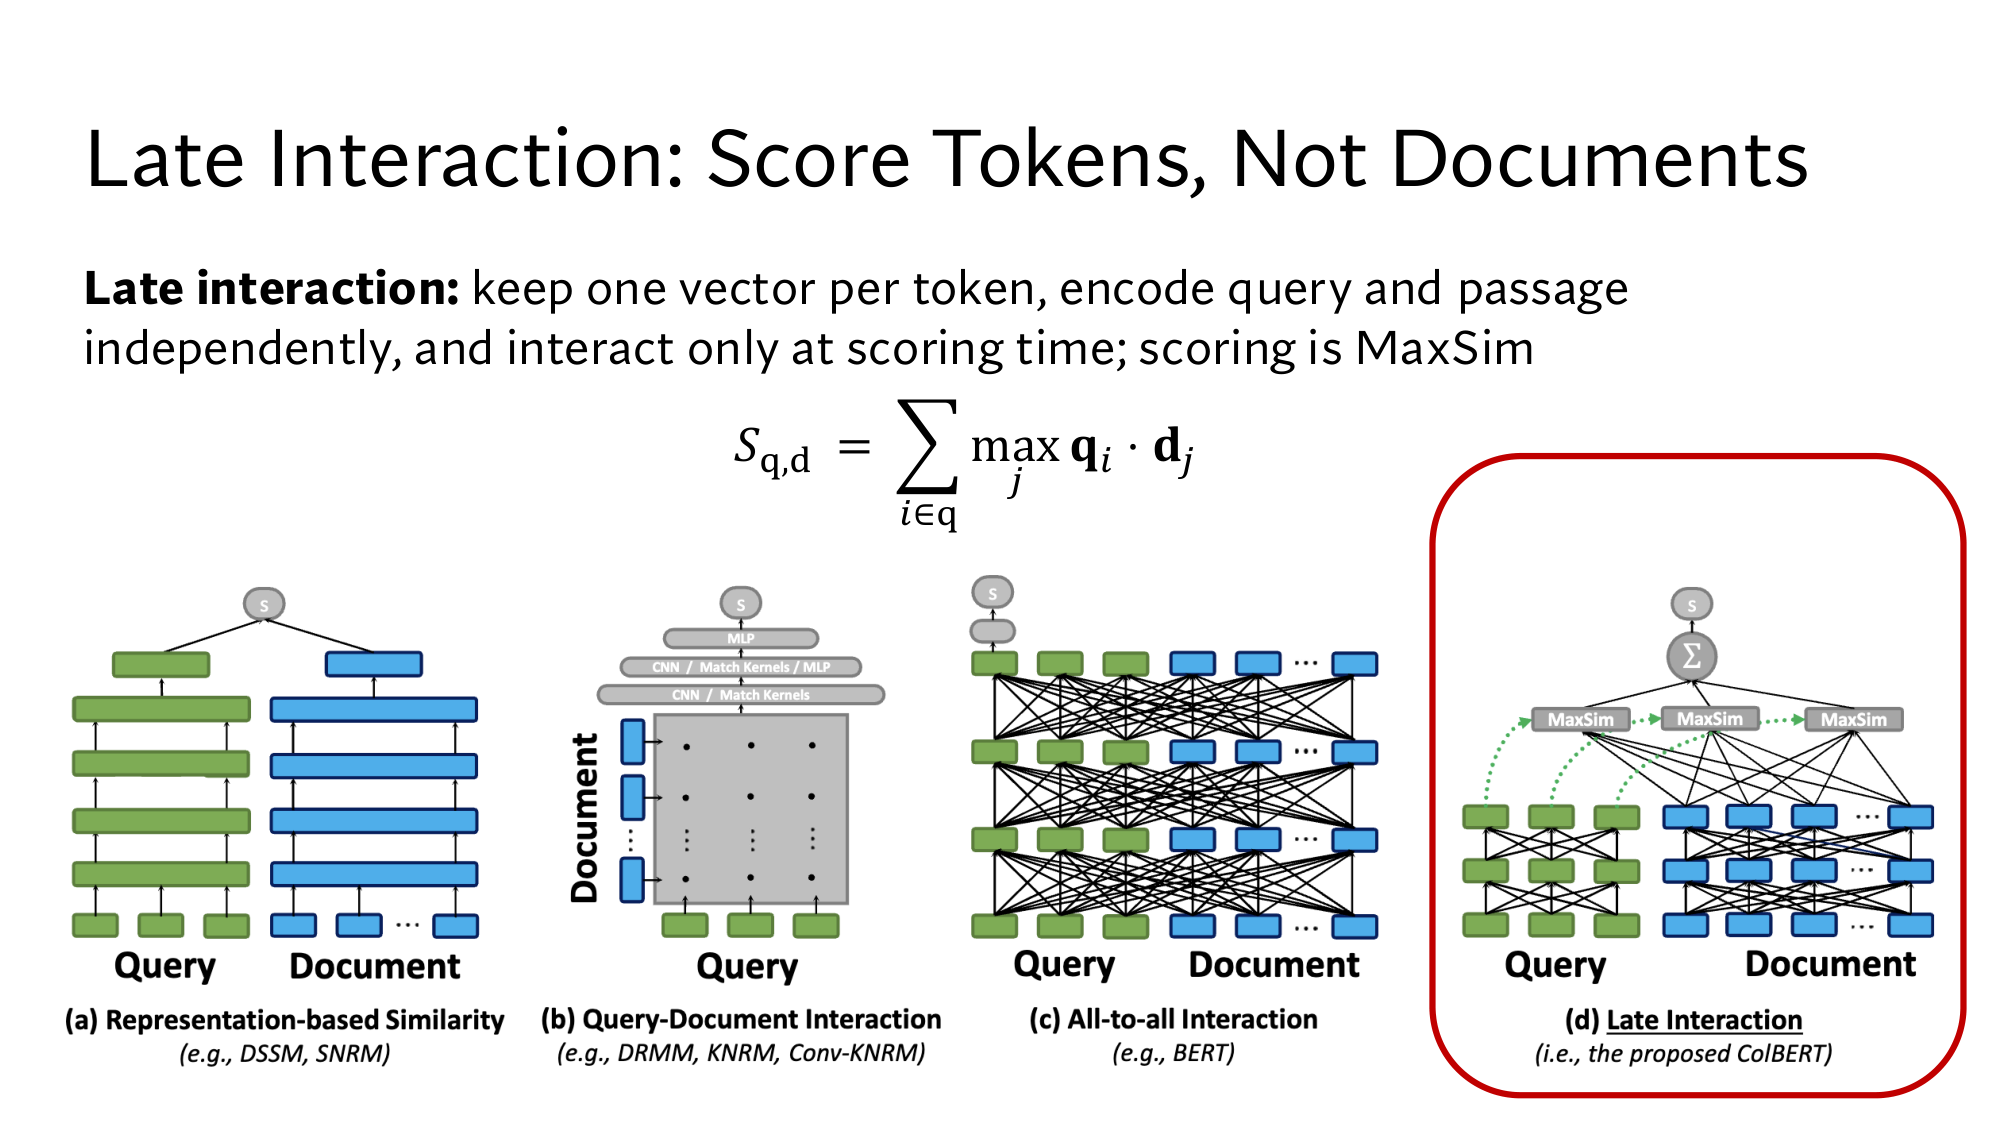
इस तरीके में query और passage के tokens अलग-अलग encode होते हैं, और सिर्फ़ आख़िरी step पर, यानी scoring पर, मिलते हैं। इसे late interaction कहते हैं, और ColBERT इसी पर बना retriever है। Stanford की slide यही परिभाषा लिखती है:
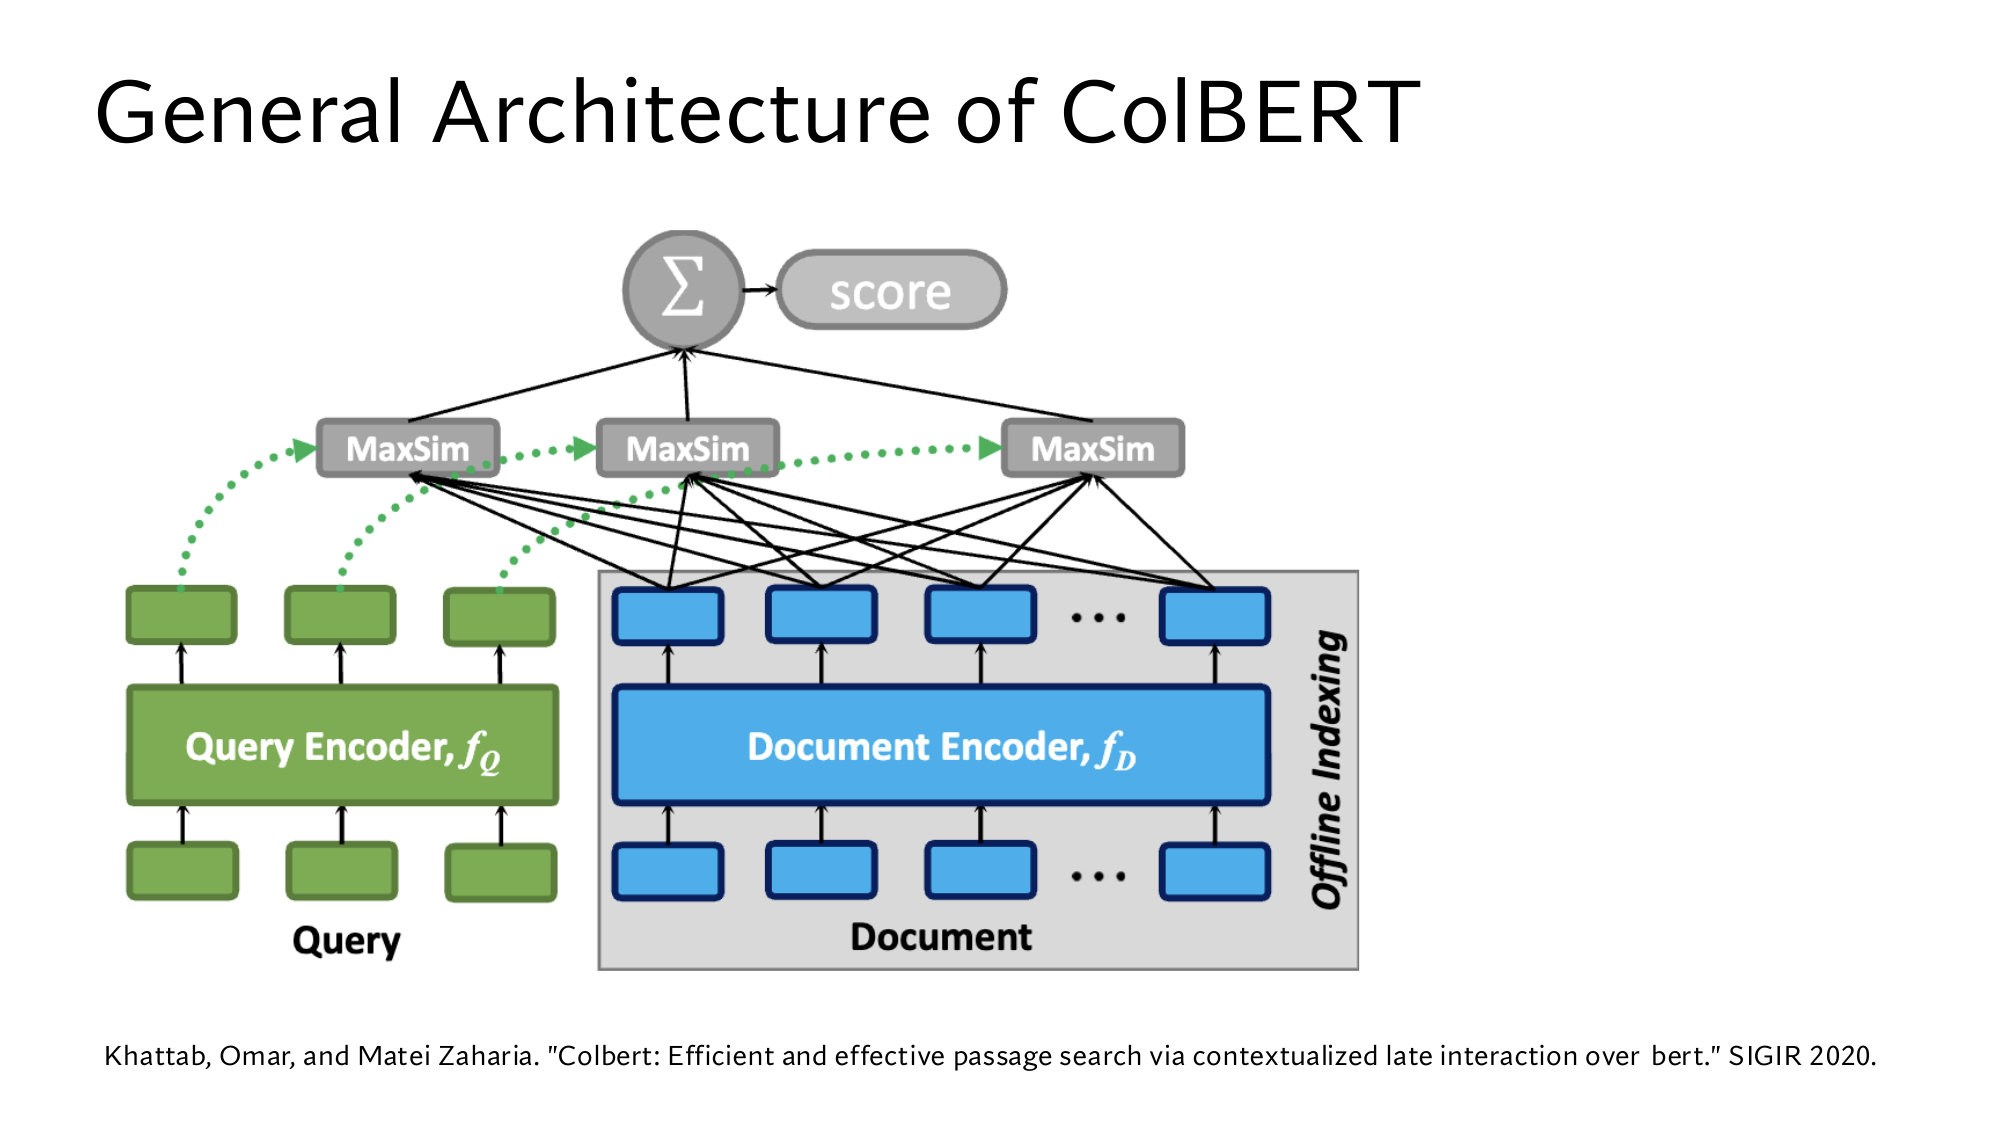
Stanford की slide: Late Interaction। ऊपर परिभाषा है, और बीच में MaxSim का formula। नीचे लाल घेरे वाला (d) ColBERT है, (a) lesson 12 जैसा bi-encoder, और (c) lesson 14 जैसा cross-encoder।Stanford की slide: ColBERT का ढाँचा। Query encoder fQ query के tokens के vectors बनाता है, और document encoder fD passage के, Offline Indexing वाले box में। हर MaxSim box एक query token का max है, और ∑ उनका जोड़।
पहले सोचिए
Query में तीसरा token जोड़िए: upload = [1, 0, 0]। Upload note का MaxSim अब कितना होगा, और FAQ का कितना?
जवाब देखिए
नए token के upload note से dot products 0.8, 0.95 और 0.5 हैं। सबसे बड़ा 0.95 है, upload से नहीं, errors से। Upload note का MaxSim = 1.05 + 0.95 = 2.0। FAQ पर नए token का max 0.9 है, इसलिए FAQ 1.85 + 0.9 = 2.75 पर है, और अब भी आगे है।
MaxSim table खुद चलाइए
Passage और query चुनिए। यहाँ हर row query का token है, और हर column passage का।
ColBERT की एक हद भी है। उसमें passage के vectors query देखे बिना बनते हैं, जबकि cross-encoder में query के tokens से passage के tokens को देखते हैं। इसलिए पुरानी राय और असली data जैसा फ़र्क, जो दोनों को साथ पढ़ने पर दिखता है, cross-encoder बेहतर पकड़ सकता है।
3कीमत: 100 गुना vectors, लेकिन बहुत कम काम
हर token का vector रखने की कीमत index में है: vectors की गिनती passages से नहीं, tokens से बढ़ती है। मान लीजिए 60,000 passages हैं, और हर एक में करीब 100 tokens। Bi-encoder 60,000 vectors रखता है, और ColBERT 60,000 × 100 = 60 लाख, यानी 100 गुना vectors। Bytes में फ़र्क इससे कम है, क्योंकि ColBERT के vectors छोटे होते हैं। मेरा example
इसके बदले क्या मिलता है, ये दो चीज़ों से नापते हैं। पहली चीज़ है latency: query भेजने से जवाब आने तक का समय, ms में। जैसे lesson 14 का cross-encoder 1,000 passages पर 10,700 ms लेता है, तो उसकी latency 10,700 ms है।
दूसरी चीज़ computer का काम है, जिसे FLOPs में गिनते हैं, यानी कितने गुणा और जोड़ लगे। हमारे vectors में 3 numbers हैं, इसलिए एक dot product में 3 गुणा और 3 जोड़ हैं, यानी 6 FLOPs। FAQ के MaxSim में 2 × 6 = 12 dot products थे, इसलिए 12 × 6 = 72 FLOPs लगे।
Stanford की slide ColBERT को MS MARCO पर नापती है। Lesson 14 में आया था कि उसमें Bing search के असली सवाल और 88 लाख passages हैं। Rerank वाली rows में model BM25 के top-1,000 को दोबारा sort करता है। lesson 13 का है: पहले सही passage के rank का उल्टा, जैसे rank 2 पर 0.5। Table इसे 100 से गुणा करके लिखती है।
Method
MRR@10
Latency
FLOPs per query
BM25 (official)
16.7
–
–
BERT-base cross-encoder, rerank
34.7
10,700 ms
97T
ColBERT, rerank
34.9
61 ms
7B
ColBERT, end-to-end
36.0
458 ms
–
T यानी trillion, यानी 1012, और B यानी billion, यानी 109। इसलिए 97T ÷ 7B = 97,000 ÷ 7 = करीब 13,900। मतलब rerank में ColBERT का काम cross-encoder से करीब 13,900 गुना कम है, और MRR@10 लगभग बराबर है: 34.9 बनाम 34.7। Latency भी 10,700 ms की जगह 61 ms है।
फ़र्क इसलिए है कि cross-encoder हर passage के साथ BERT पूरा चलाता है। ColBERT query पर BERT एक बार चलाता है, और passages के vectors पहले से बने हैं, इसलिए हर passage पर बस MaxSim बचता है।
End-to-end वाली row में ColBERT किसी और की list पर नहीं टिकता, बल्कि खुद पूरे 88 लाख passages में ढूँढता है। इसमें 458 ms लगते हैं, और MRR@10 36.0 आता है। इसका बड़ा फ़ायदा shortlist में है। बताता है कि सही passages में से कितना हिस्सा top-1,000 में आया, जैसे 2 में से 1 आया तो 0.5। ColBERT का Recall@1000 96.8 है, और BM25 (Anserini नाम के toolkit वाला) का 85.7, यानी 11.1 points ज़्यादा।
4Cascade: सस्ता step पहले, सटीक step आख़िर में
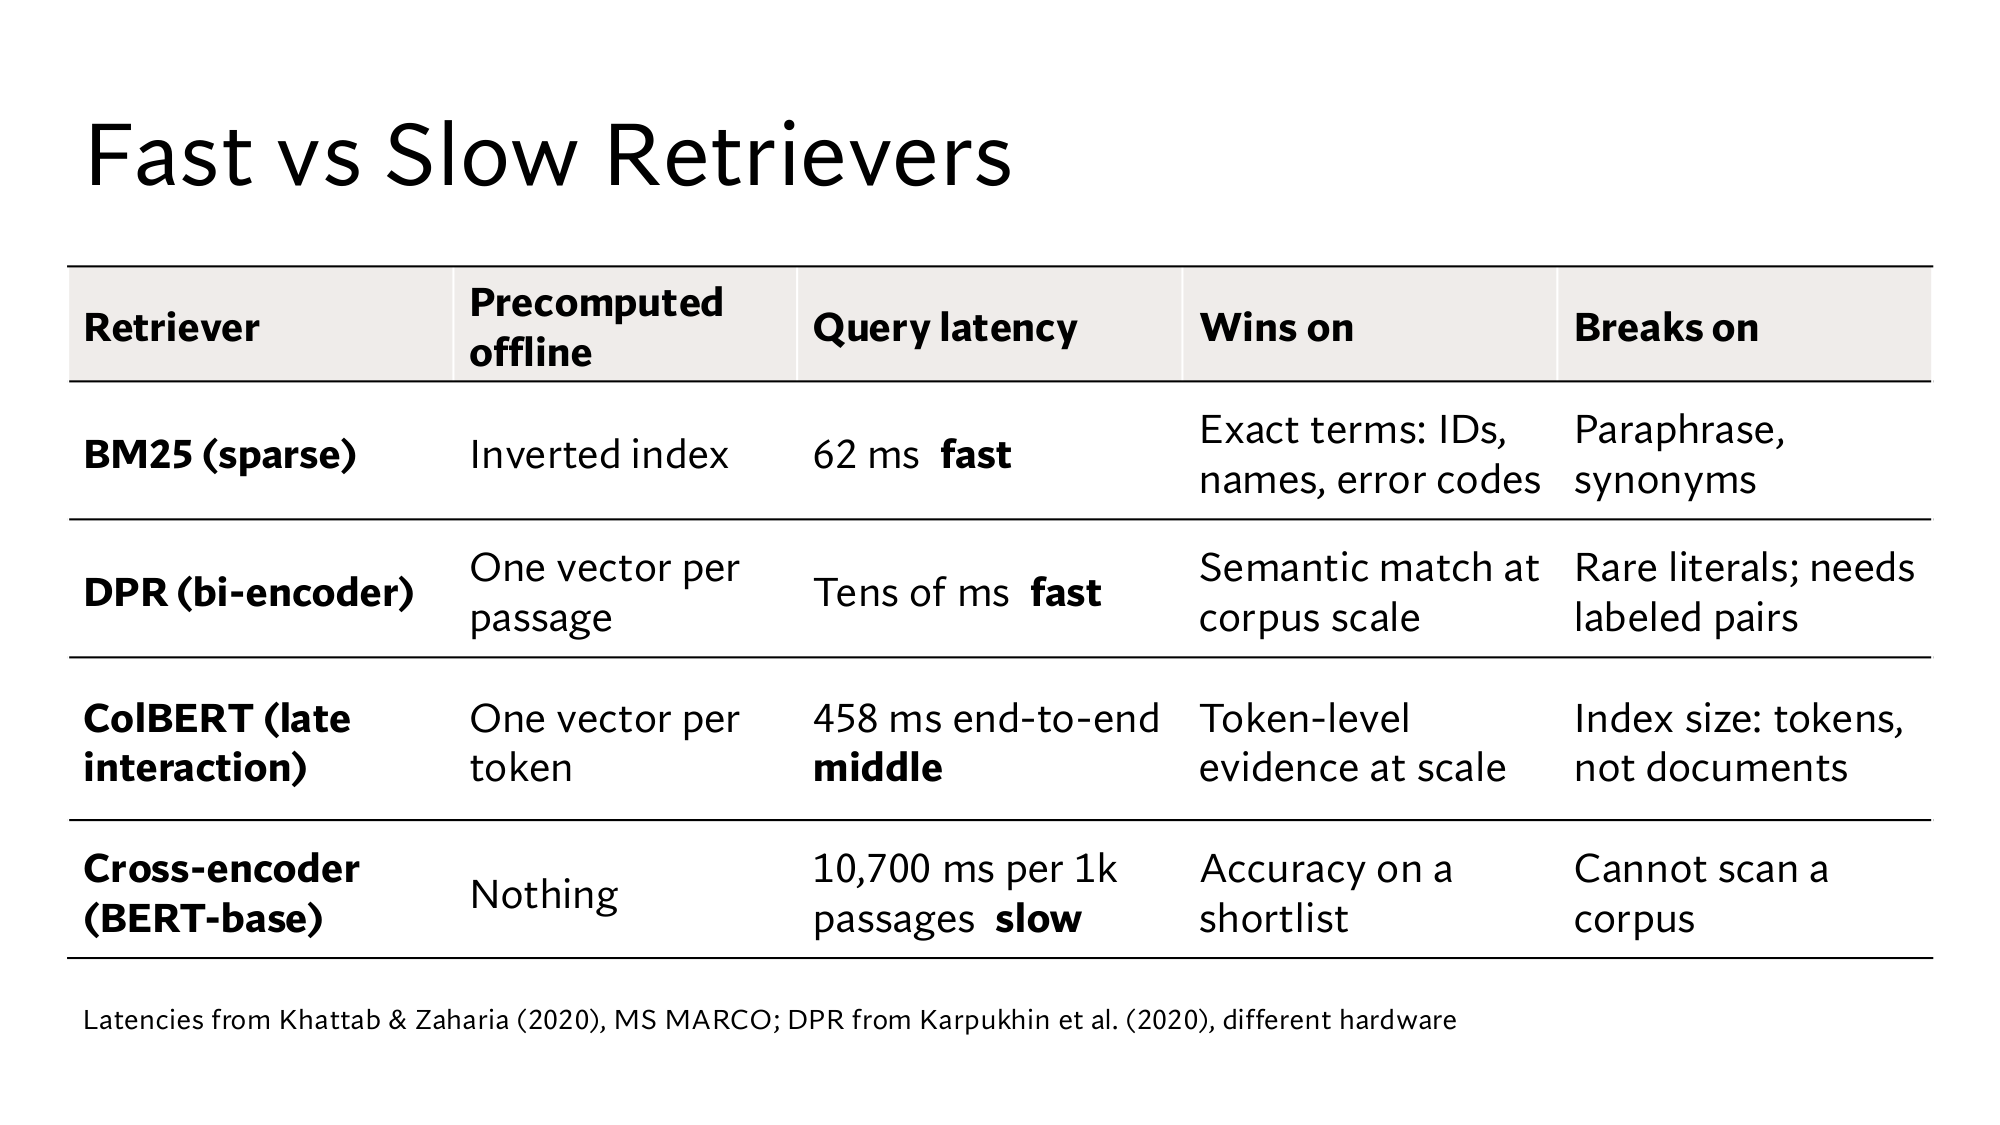
अब आपके पास चार retrievers हैं: BM25, DPR, ColBERT और cross-encoder। Stanford की ये slide चारों को एक table में रखती है:
Stanford की slide: Fast vs Slow Retrievers। Columns बताते हैं कि पहले से क्या बनता है, एक query का समय, और retriever कहाँ जीतता और कहाँ हारता है। ColBERT की row आप पढ़ चुके हैं: हर token का vector, 458 ms, और tokens से बढ़ता index।
असली systems इन्हें एक line में लगाते हैं। सबसे सस्ता retriever पूरे corpus से लंबी shortlist निकालता है, और हर अगला step कम passages पर ज़्यादा महँगा और सटीक काम करता है। इस line को cascade कहते हैं। एक cascade ऐसा दिख सकता है: मेरा example
BM25 + DPRकरोड़ों में से top-1,000, RRF से
ColBERT rerank1,000 में से top-50
Cross-encoder50 में से top-5
LLM5 passages पढ़कर जवाब
हर step का खर्च उसकी list के size से तय होता है। ColBERT 1,000 passages को करीब 61 ms में rerank करता है। Cross-encoder 50 passages पर 50 × 10.7 = 535 ms लेता है, जबकि पूरे 1,000 पर उसे 10,700 ms लगते।
हर step पिछले step की shortlist पर टिका है, इसलिए पहले step का recall पूरे cascade की छत है। ये lesson 14 वाली है। सही passage पहले step की 1,000 की list में नहीं आया, तो बाद का कोई step उसे नहीं ला सकता। इसीलिए पहले step में BM25 और DPR, दोनों हैं, और उनकी lists को मिलाता है।
पहले सोचिए
आपका corpus product manuals का है, और users अक्सर model numbers से ढूँढते हैं, जैसे XR-2209। Cascade के पहले step से BM25 हटा दें, तो क्या होगा?
जवाब देखिए
पहले step में सिर्फ़ DPR बचेगा, जो rare literals चूकता है। XR-2209 वाले passages shortlist में ही नहीं आएँगे, और बाद का कोई reranker उन्हें वापस नहीं ला सकता।
गहरे version में और क्या है
गहरे version में ये पूरा lesson है, और उसके बाद 6 पड़ाव और, जो Stanford की slides के level तक ले जाते हैं:
पड़ाव 5: MaxSim का पूरा गणित, और max की जगह औसत लेने पर गलत passage क्यों लौटता है।
पड़ाव 6: Query और passage को मिलाने के चार ढाँचे, और paper के experiments।
पड़ाव 7: ColBERT के encoders अंदर से, और training का loss।
पड़ाव 8: Index के bytes, गिने हुए FLOPs, और 61 ms कहाँ खर्च होते हैं।
पड़ाव 9: End-to-end search के दो stages: पहले उम्मीदवार passages, फिर उन पर पूरा MaxSim।
पड़ाव 10: Stanford की चारों ColBERT slides, जिन्हें आप खुद पढ़ते हैं।
एक vector वाला bi-encoder लंबे passage के एक ज़रूरी token को औसत में दबा सकता है। Error 4012 पर FAQ का cosine 0.32 रहा, और गलत upload note का 0.73।
ColBERT हर token का vector रखता है, और MaxSim query के हर token का सबसे बड़ा dot product जोड़ता है। FAQ को 1.85 मिला, और upload note को 1.05।
Rerank में ColBERT cross-encoder जितना सटीक है, 34.9 बनाम 34.7, और करीब 13,900 गुना कम FLOPs लेता है। कीमत 100 गुना vectors है। Cascade में सस्ता step पहले आता है, और सटीक step आख़िर में।
इस lesson के नए शब्द
Late interaction
Query और passage के token vectors अलग-अलग बनें, और सिर्फ़ scoring पर मिलें। जैसे ColBERT में passage के vectors offline बनते हैं, और dot products query आने पर।
MaxSim
Query के हर token का passage के tokens से सबसे बड़ा dot product, फिर सबका जोड़। जैसे course FAQ पर 0.9 + 0.95 = 1.85।
ColBERT
Late interaction वाला retriever, जो हर token का vector रखता है और MaxSim से score देता है। 2020 में Khattab और Zaharia ने बनाया। जैसे MS MARCO पर उसका Recall@1000 96.8 है।
Latency
Query भेजने से जवाब आने तक का समय, ms में। जैसे cross-encoder की latency 1,000 passages पर 10,700 ms है, और ColBERT rerank की 61 ms।
FLOPs
कितने गुणा और जोड़ लगे, यानी computer का काम। जैसे 3 numbers वाले dot product में 6 FLOPs, और 768 numbers वाले में 1,536।
Cascade
Retrievers की line, जिसमें हर अगला step कम passages पर ज़्यादा सटीक और महँगा काम करता है। जैसे करोड़ों से 1,000, फिर 50, फिर 5।