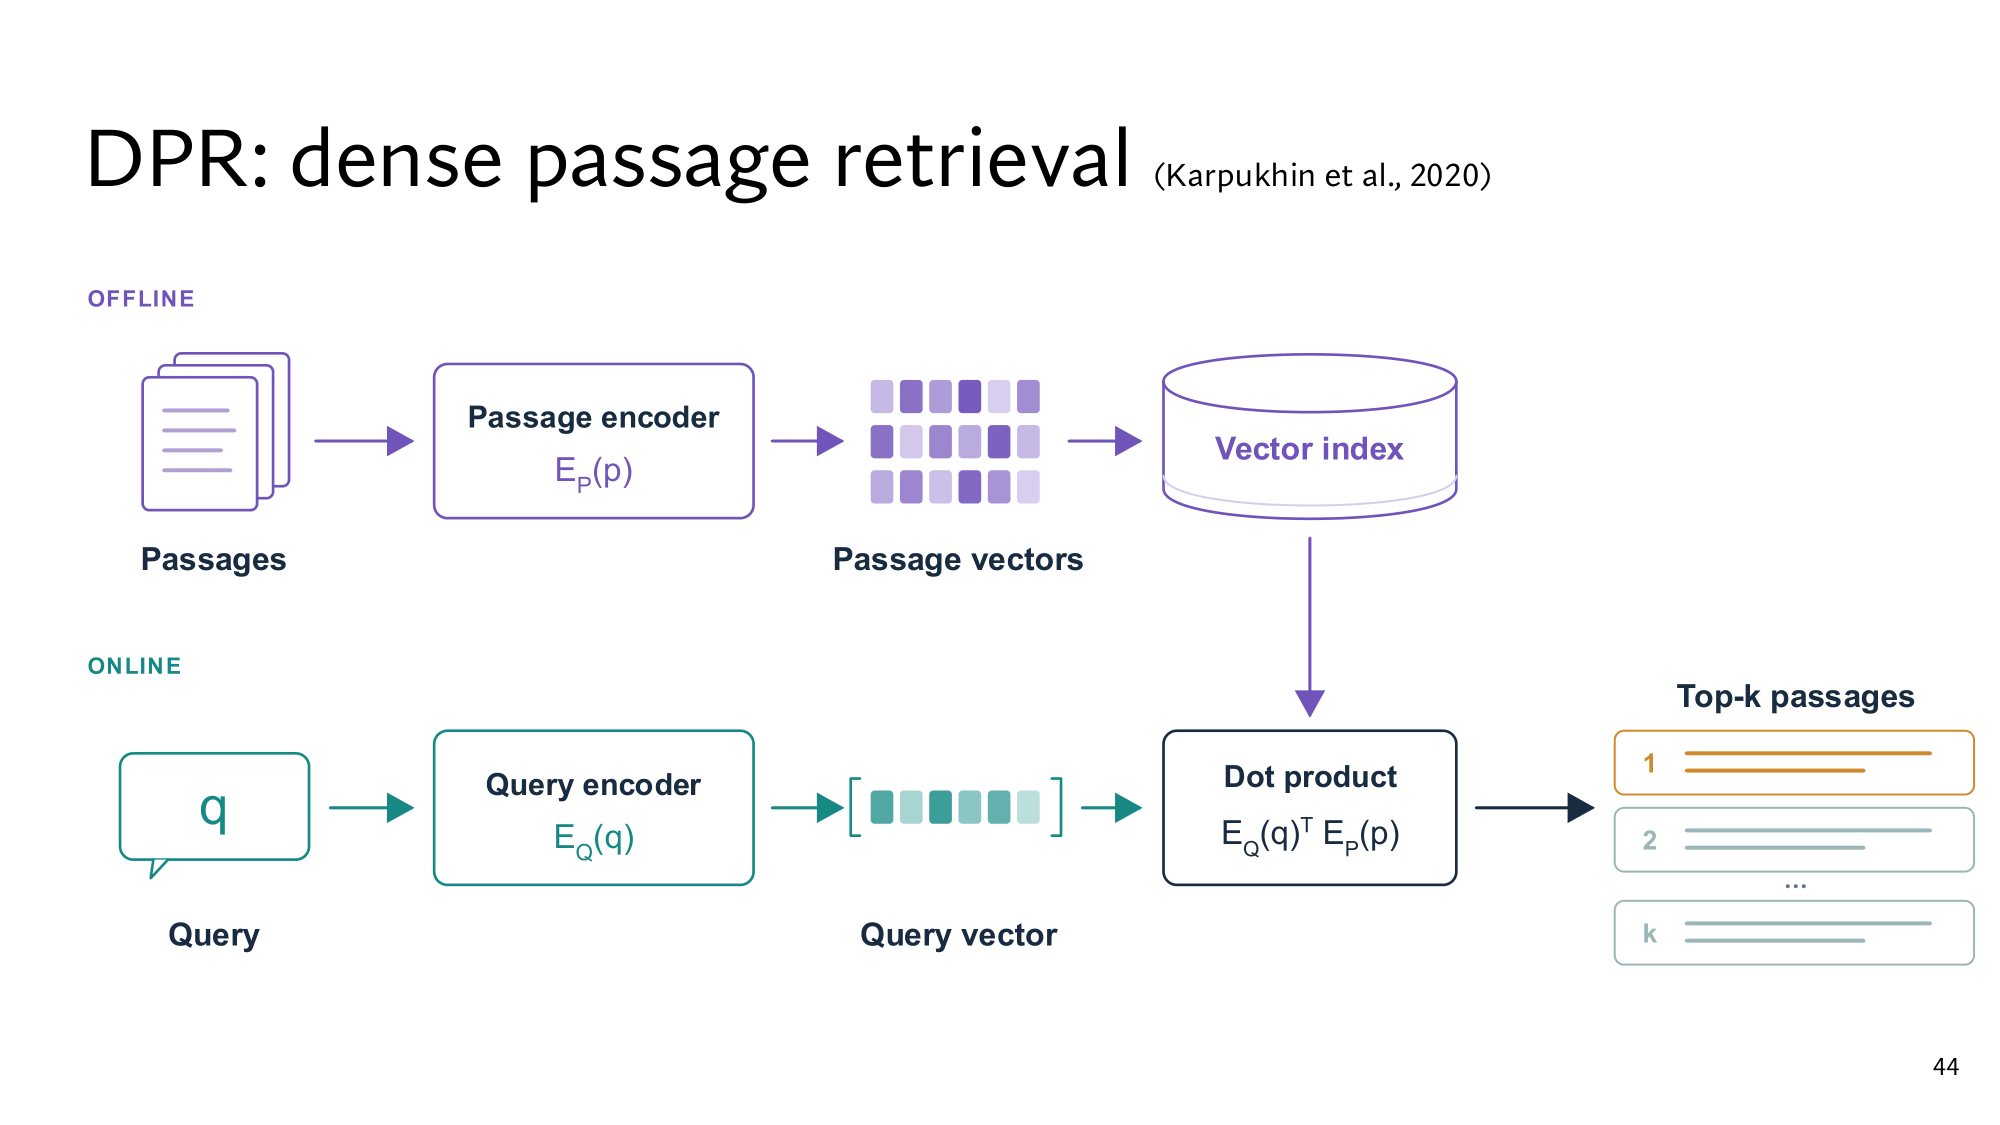
DPR एक retriever है, जो सवाल और हर passage को vector में बदलता है। फिर वो उन passages को चुनता है, जिनका सवाल के vector से dot product सबसे बड़ा हो। ये vectors दो encoders बनाते हैं, और दोनों encoders सवाल और सही passage के जोड़ों पर train होते हैं। DPR का पूरा नाम Dense Passage Retrieval है, और lesson 5 के RAG का retriever यही था।
इसकी ज़रूरत lesson 11 में दिखी थी। सवाल which office hour is least crowded पर BM25 ने 2024 के एक पुराने forum post को 2.749 देकर सबसे ऊपर रखा। जवाब queue log में है, जो 2.473 के साथ दूसरी जगह पर रहा, क्योंकि उसमें least और crowded शब्द नहीं हैं। DPR के encoders train होकर इस सवाल के vector को queue log के vector के पास लाते हैं।
इस lesson की सीढ़ी
सीढ़ी में 5 पड़ाव हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
पहले से क्या चाहिए: Lesson 3 (vector, dot product, encoder), Lesson 4 (softmax, ln, loss) और Lesson 11 (BM25)। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1दो encoders और एक dot product
DPR में दो अलग encoders हैं: question encoder EQ सवाल का vector बनाता है, और passage encoder EP हर passage का। वो model है, जो text पढ़कर तय लंबाई का vector देता है। DPR के दोनों encoders पहले से से शुरू होते हैं, और DPR उन्हें सवाल-passage जोड़ों पर करता है।
Score दोनों vectors का है:
s(q, p) = EQ(q)⊤ EP(p)
यहाँ सिर्फ़ dot product लिखने का एक तरीका है, और Stanford की slide ऐसे ही लिखती है।
अब एक छोटे example पर देखिए। असली vector में 768 numbers होते हैं, यहाँ सिर्फ़ 4 हैं, ताकि आप हिसाब हाथ से कर सकें। vectors मेरे बनाए हैं
Text, और encoder से बना उसका vector
सवाल से dot product
सवाल: least crowded office hour[1.0, 0.5, 0.5, 1.0]
–
Queue log, जिसमें जवाब है[0.2, 0.4, 0.4, 0.4]
1.0
पुराना forum post[0.8, 1.0, 0.4, 0.5]
2.0
Homework 1 की announcement[0.5, 0.4, 0.6, 0.5]
1.5
Queue log का score ऐसे निकला: 1.0 × 0.2 + 0.5 × 0.4 + 0.5 × 0.4 + 1.0 × 0.4 = 1.0। Encoders अभी train नहीं हुए हैं, इसलिए गलत forum post 2.0 के साथ सबसे ऊपर है। पड़ाव 2 की training यही क्रम बदलती है।
DPR सवाल और passage को अलग-अलग पढ़ता है, और इसका फ़ायदा speed में है। उसका काम दो हिस्सों में बँटता है:
, यानी सवाल आने से पहले: passage encoder हर passage का vector एक बार बनाता है, और सबको एक में रखता है।
Online, यानी सवाल आने पर: question encoder सिर्फ़ एक बार चलता है। फिर index के vectors से dot product निकलते हैं, और सबसे बड़े k scores वाले passages लौटते हैं।
अगर एक ही model सवाल और passage को साथ पढ़ता, तो हर सवाल पर उसे हर passage के साथ अलग से चलना पड़ता। Lesson 5 के Wikipedia में करीब 2.1 करोड़ passages थे, यानी हर सवाल पर 2.1 करोड़ बार model चलता। DPR में model हर सवाल पर सिर्फ़ 1 बार चलता है। दो encoders वाले इस ढाँचे को bi-encoder कहते हैं।
Stanford की slide: DPR का offline और online हिस्सा। ऊपर offline हिस्सा है, और नीचे online। अब आप इसका हर box पढ़ सकते हैं। Image पर click करने से वो पूरे size में खुलती है।
पहले सोचिए
सवाल का vector दोगुना कर दीजिए, यानी [2.0, 1.0, 1.0, 2.0]। तीनों scores क्या होंगे, और क्या क्रम बदलेगा?
जवाब देखिए
Scores 2.0, 4.0 और 3.0 हो जाते हैं। Dot product के हर गुणा में एक number सवाल के vector से आता है। वो दोगुना हुआ, तो हर गुणा दोगुना हुआ, और उनका जोड़ भी: queue log के लिए 2.0 × 0.2 + 1.0 × 0.4 + 1.0 × 0.4 + 2.0 × 0.4 = 2.0। हर score दोगुना हुआ, लेकिन क्रम वही रहा, और forum post अब भी सबसे ऊपर है। पड़ाव 2 में ये बात काम आएगी।
2Contrastive loss: सही passage को गलत passages से आगे करना
Contrastive loss सही passage के score की तुलना गलत passages के scores से करता है। सही passage जितना आगे होता है, loss उतना छोटा होता है। DPR के दोनों encoders इसी loss को छोटा करने के लिए train होते हैं।
इस तुलना के लिए हर training सवाल के साथ दो तरह के passages चाहिए:
Positive
सवाल का सही passage। Training data में ये हर सवाल के साथ लिखा होता है। हमारे सवाल के लिए ये queue log है।
Negative
उसी सवाल के लिए गलत passage। हमारे example में forum post और Homework 1 की announcement।
तुलना इसलिए ज़रूरी है, क्योंकि retriever सिर्फ़ ऊपर वाले passages आगे भेजता है, यानी उसके लिए क्रम मायने रखता है। पड़ाव 1 के सवाल में आपने देखा कि सवाल का vector लंबा करने से सारे scores बढ़ते हैं, लेकिन क्रम वही रहता है। अगर training सिर्फ़ positive का score बढ़ाने को कहे, तो encoder यही आसान रास्ता ले सकता है।
अब पड़ाव 1 के scores पर loss निकालिए: queue log 1.0, forum post 2.0 और Homework 1.5। Loss तीन steps में निकलता है:
हर score का लीजिए: 2.72, 7.39 और 4.48। e एक खास number है, करीब 2.718, इसलिए e1.0 = 2.72 और e2.0 = 2.718 × 2.718 = 7.39। तीनों का जोड़ 14.59 है।
Positive का हिस्सा निकालिए: 2.72 ÷ 14.59 = 0.186।
इस हिस्से का −ln लीजिए: −ln 0.186 = 1.68। यही loss है। ln बताता है कि e को किस power तक उठाएँ, तो वो number मिले। जाँच: e−1.68 = 1 ÷ e1.68 = 1 ÷ 5.37 = 0.186।
Step 1 और 2 मिलकर हैं, और step 3 lesson 4 वाला है। Formula में यही तीन steps हैं:
𝓛 = − ln es+es+ + ∑ es−
ऊपर positive का escore है (2.72), और नीचे positive और सारे negatives के escore का जोड़ (14.59)।
पहले सोचिए
तीनों scores में 1 जोड़ दीजिए: 2.0, 3.0 और 2.5। Loss कितना होगा?
जवाब देखिए
1.68 ही। Score में 1 जोड़ने से escore 2.72 गुना हो जाता है, क्योंकि ea+1 = ea × e। जैसे e2.0 = e1.0 × 2.72 = 7.39। ऊपर और नीचे, दोनों 2.72 से गुणा होते हैं, और भाग में ये कट जाता है। इसलिए queue log का हिस्सा 0.186 ही रहता है।
नीचे की table में चार हालात हैं। आख़िरी दो rows training के दो stages हैं, और पड़ाव 3 बीच वाला stage इस्तेमाल करता है। scores मेरे बनाए हैं
Scores (queue log, forum post, Homework)
Queue log का हिस्सा
Loss
Training से पहले: 1.0, 2.0, 1.5
0.186
1.68
सवाल का vector दोगुना: 2.0, 4.0, 3.0
0.090
2.41
कुछ training के बाद: 3.0, 2.0, 0.5
0.690
0.372
Training के बाद: 5.0, 2.0, 0.5
0.943
0.059
सवाल का vector दोगुना करने पर loss 1.68 से बढ़कर 2.41 हो जाता है, क्योंकि forum post और आगे निकल गया। तो लंबे vector वाला आसान रास्ता यहाँ काम नहीं करता।
Training चलने पर queue log आगे निकलता है, और loss 1.68 से 0.372 और फिर 0.059 तक घटता है।
इसलिए encoders के पास loss घटाने का एक ही रास्ता है: queue log का score बाकी दोनों से ज़्यादा करना।
Contrastive loss खुद चलाइए
तीनों scores बदलिए। Loss तब छोटा होता है, जब queue log बाकी दोनों से काफ़ी ऊपर हो। तीनों को बराबर खिसकाइए, तो loss नहीं बदलता।
3Negatives: batch से और BM25 से
Contrastive loss को हर सवाल के लिए negatives चाहिए, और negatives जितने ज़्यादा, तुलना उतनी कड़ी। लेकिन हर negative को passage encoder से गुज़ारना पड़ता है, और ये महँगा है। DPR दो जगह से negatives लेता है, जिनमें ये खर्च कम है।
Batch के बाकी सवालों के positives
In-batch negatives का मतलब है: batch के बाकी सवालों के positives को इस सवाल के negatives मानना। Training सवालों को छोटे groups में चलाती है, जिन्हें batch कहते हैं। Batch के हर सवाल का positive उसी step में encode हो चुका होता है, इसलिए इन negatives पर कोई extra encoding नहीं लगती।
नीचे कुछ training के बाद का 3 सवालों वाला एक batch है। हर row में bold number उस सवाल का positive है, और उसी row के बाकी numbers उसके negatives। scores मेरे बनाए हैं
सवाल ↓ / passage →
Queue log
Syllabus
Office hours
Loss
Least crowded office hour?
3.0
1.0
0.5
0.197
When is the milestone due?
0.8
3.0
1.2
0.244
Where are office hours held?
0.3
2.5
2.0
?
तीसरी row आप निकालिए
Positive office hours page है, score 2.0। Negatives queue log (0.3) और syllabus (2.5) हैं। Loss कितना है, और ये row बाकी दो से अलग क्यों है?
जवाब देखिए
e0.3 = 1.35, e2.5 = 12.18 और e2.0 = 7.39, जिनका जोड़ 20.92 है। Office hours page का हिस्सा 7.39 ÷ 20.92 = 0.353 है, और loss = −ln 0.353 = 1.041। इस row में गलत syllabus (2.5) सही page (2.0) से ऊपर है, इसलिए इसका loss सबसे बड़ा है।
Paper में batch 128 सवालों का है, इसलिए हर सवाल को 127 in-batch negatives मिलते हैं। paper से
BM25 वाले hard negatives
Hard negative वो गलत passage है, जो सवाल से मिलता-जुलता दिखता है, लेकिन जिसमें जवाब नहीं होता। हमारे सवाल के लिए forum post ऐसा ही passage है। उसमें least और crowded, दोनों शब्द हैं, लेकिन भीड़ का कोई data नहीं है।
In-batch negatives ज़्यादातर आसान होते हैं, क्योंकि वो दूसरे सवालों के passages हैं। Hard negatives पर loss बड़ा आता है, और loss जितना बड़ा हो, training encoders को उतना ज़्यादा बदलती है। कुछ training के बाद queue log 3.0 पर है, और दोनों negatives की तुलना ऐसी दिखती है: scores मेरे बनाए हैं
Negative
Loss, सिर्फ़ इसी negative के साथ
Encoder क्या सीखता है
Homework की announcementआसान negative, score 0.5
0.079queue log का हिस्सा 0.924
लगभग कुछ नहीं, क्योंकि फ़र्क पहले से साफ़ है
Forum posthard negative, score 2.0
0.313, करीब 4 गुनाqueue log का हिस्सा 0.731
सवाल के शब्द काफ़ी नहीं, passage में भीड़ का data चाहिए
पहली row ऐसे निकली: e3.0 = 20.09 और e0.5 = 1.65, जिनका जोड़ 21.73 है। Queue log का हिस्सा 20.09 ÷ 21.73 = 0.924 है, और loss = −ln 0.924 = 0.079।
ऐसे passages ढूँढने के लिए DPR, BM25 का इस्तेमाल करता है। हर training सवाल के लिए वो BM25 के ऊपर वाले passages में से एक passage लेता है, जिसमें जवाब नहीं है। ये तरीका इसलिए काम करता है, क्योंकि BM25 वही गलती करता है जो encoders से छुड़वानी है। इस सवाल पर भी BM25 ने forum post को ही सबसे ऊपर रखा था।
ध्यान दीजिए: Hard negatives लेने से पहले labels check कीजिए। कभी BM25 के ऊपर वाले passage में सचमुच जवाब होता है, बस उसका label छूट गया होता है। तब encoder सही passage को नीचे धकेलना सीखता है।
4DPR, BM25 से कितना आगे है
DPR paper retriever को top-k retrieval accuracy से नापता है: कितने % सवालों में जवाब वाला passage top-k में आया। NQ dataset में Google पर लोगों के असली सवाल हैं। उस पर top-20 accuracy BM25 की 59.1% है, और DPR की 78.4%।
1,000 सवालों में ये 591 और 784 सवाल हैं। मतलब DPR के साथ 193 और सवालों में reader तक जवाब वाला passage पहुँचता है।
DPR 5 में से 4 datasets पर आगे है। SQuAD पर वो पीछे है, 63.2 बनाम 68.8, क्योंकि वहाँ लोगों ने passage पढ़कर सवाल लिखे थे। इसलिए उन सवालों में passage के ही शब्द हैं, और exact शब्द मिलाना BM25 का काम है। ये वजह paper में है
पाँचों datasets के numbers
Dataset
BM25
DPR
NQ
59.1
78.4
TriviaQA
66.9
79.4
WQ
55.0
73.2
TREC
70.9
79.8
SQuAD
68.8
63.2
Top-20 accuracy (%), test set पर। यहाँ DPR हर dataset पर अलग train हुआ है।
DPR को labeled जोड़े चाहिए, और paper ने ये भी नापा कि कितने। NQ पर सिर्फ़ 1,000 जोड़ों से train हुआ DPR भी BM25 से आगे है, और जोड़े बढ़ाने पर accuracy और बढ़ती है।
5DPR कहाँ कमज़ोर है
DPR पूरे corpus के पैमाने पर semantic match में जीतता है, लेकिन उसकी तीन कमज़ोरियाँ हैं:
Error 4012 जैसा code सिर्फ़ एक-दो passages में हो, तो BM25 उसे rare मानकर ऊपर रखता है। DPR का vector पूरे passage की बात समेटता है, और उसमें ऐसा एक code आसानी से दब जाता है। Lesson 15 इसी case से शुरू होता है।
Passage का vector सवाल देखे बिना बनता है, इसलिए सवाल और passage सिर्फ़ आख़िरी dot product पर मिलते हैं। Lesson 14 का reranker इसी कमी पर काम करता है।
Training के लिए labeled सवाल-passage जोड़े चाहिए, भले 1,000 ही हों।
BM25 की ताकत और कमज़ोरी इसकी उल्टी है। इसलिए lesson 14 BM25 और DPR, दोनों की lists मिलाता है।
गहरे version में और क्या है
गहरे version में ये पूरा lesson है, और उसके बाद 4 पड़ाव और, जो Stanford की slides के level तक ले जाते हैं:
पड़ाव 6: slide के symbols, जैसे qi, ℝd, θ और ∇। साथ में gradient का गणित: दर क्या है, ∂ का मतलब, दरों वाला chain rule, और सवाल के vector पर एक कदम।
पड़ाव 7: matrix, transpose और पूरे batch का एक गुणा S = QP⊤, और paper के experiments कि कौन से negatives कितने काम के हैं।
पड़ाव 8: paper का असली पैमाना और पूरे नतीजे: 2.1 करोड़ passages, 768 numbers वाले vectors, 255 negatives, speed, और ORQA और REALM से तुलना।
पड़ाव 9: Stanford की चारों DPR slides, जिन्हें आप खुद पढ़ते हैं।
DPR एक bi-encoder है: दो BERT encoders, और score उनके vectors का dot product। Passages के vectors offline index में बनते हैं, इसलिए हर सवाल पर question encoder सिर्फ़ एक बार चलता है।
Contrastive loss positive के score की तुलना negatives से करता है: softmax, फिर −ln। सारे scores बराबर बढ़ाने से ये loss नहीं घटता।
Negatives batch से मुफ़्त मिलते हैं, और मुश्किल वाले BM25 से। DPR 5 में से 4 datasets पर BM25 से आगे है, लेकिन exact शब्दों वाले सवालों पर BM25 अब भी जीत सकता है।
इस lesson के नए शब्द
DPR
Dense Passage Retrieval: दो BERT encoders वाला bi-encoder retriever, जो सवाल-passage जोड़ों पर contrastive loss से train होता है। 2020 में Karpukhin और साथियों ने बनाया, और lesson 5 के RAG का retriever यही था।
Bi-encoder
सवाल और passage के लिए दो अलग encoders, और score उनका dot product। Passages पहले से encode होते हैं। जैसे 2.1 करोड़ passages हों, तब भी हर सवाल पर model 1 बार चलता है।
Pretraining
बहुत सारे आम text पर model की पहली, बड़ी training। जैसे BERT पहले आम text पर train होता है।
Fine-tuning
पहले से trained model को अपने काम के data पर और train करना। जैसे DPR, BERT को सवाल-passage जोड़ों पर train करता है।
Positive और negative passage
सवाल का सही passage (pi+), और गलत passages (pi,j−)। जैसे least crowded सवाल का positive queue log है, और negatives forum post और Homework।
Contrastive loss
Positive और negatives के scores पर softmax, फिर positive का −ln। ये सिर्फ़ scores के फ़र्क देखता है। जैसे scores 1.0, 2.0, 1.5 पर loss 1.68, और 5.0, 2.0, 0.5 पर 0.059।
Batch
Training में एक साथ चलने वाले सवालों का group। जैसे DPR में 128 सवालों का batch।
In-batch negatives
Batch के बाकी सवालों के positives को negatives की तरह इस्तेमाल करना। जैसे 128 के batch में हर सवाल को 127 negatives मिलते हैं।
Hard negative
सवाल से मिलता-जुलता, लेकिन गलत passage। DPR इन्हें BM25 के ऊपर वाले passages से लेता है। जैसे इस सवाल पर forum post।
Top-k retrieval accuracy
कितने % सवालों में top-k में जवाब वाला passage है। जैसे NQ पर top-20 में DPR की 78.4%।