Agentic RAG में ढूँढना pipeline का तय step नहीं रहता। एक LLM हर कदम पर तय करता है कि ढूँढना है या नहीं, क्या ढूँढना है, और जो मिला वो काफ़ी अच्छा है या नहीं। ऐसे LLM को agent कहते हैं, और ये lesson ये फ़ैसले लेने के दो तरीके दिखाता है: Self-RAG और CRAG।
इसकी ज़रूरत lesson 11 में दिखी थी। सवाल which office hour is least crowded पर BM25 ने पुराने forum post को 2.749 दिया, और queue log को 2.473। K = 1 पर prompt में सिर्फ़ forum post जाता है, और LLM लिखता है midweek afternoons [P4], जहाँ [P4] उसी post का ID है। ये lesson 1 वाला गलत जवाब है, बस अब citation के साथ। उल्टी गलती भी होती है: 17 × 3 कितना है? पर भी pipeline 60,000 passages में ढूँढती है।
इस lesson की सीढ़ी
सीढ़ी में 5 पड़ाव हैं। हर पड़ाव के नीचे लिखा है कि उसके बाद आप क्या कर पाएँगे।
पहले से क्या चाहिए: Lesson 1 (next-token prediction, vocabulary), Lesson 6 (pipeline, query rewriting, ITER-RETGEN) और Lesson 14 (reranker)। जो पड़ाव आपको पहले से आता है, उसे छोड़कर अगले पर जाइए। जिस शब्द के नीचे बिंदुओं वाली line और ▾ हो, उस पर click करने से उसका मतलब खुलता है।
1Agent: action, observation और loop
Agent एक LLM है, जो loop में काम करता है। वो अगला काम चुनता है, वो काम होता है, और फिर वो नतीजा पढ़कर अगला काम चुनता है। Agent का चुना काम action कहलाता है, जैसे search करना या जवाब लिखना। Action को असल में एक program करता है, जैसे search engine, और उसे tool कहते हैं। Tool जो नतीजा लौटाता है, और agent जिसे अगले कदम से पहले पढ़ता है, उसे observation कहते हैं।
Loop की ज़रूरत lesson 6 में दिखी थी। वहाँ दो बार ढूँढता था, और ये गिनती इंसान ने पहले से लिख दी थी। लेकिन Jed Hoyer वाले सवाल पर model ने तीन searches कीं, और 17 × 3 को एक भी नहीं चाहिए। कोई तय गिनती दोनों पर सही नहीं बैठती, इसलिए गिनती वही तय करे, जो हर search का नतीजा पढ़ रहा है।
अब एक छोटा loop देखिए। User छोटे रूप में पूछता है OH timings? Retriever lesson 6 वाला word overlap है, जो गिनता है कि query के कितने शब्द passage में भी हैं। ये loop मेरा example है
कदम
Agent का action
Observation
1
Search: OH timings
हर passage का score 0
2
Search: CS 329Z office hours schedule
Office hours page पर 2, queue log पर 1
3
जवाब: Tuesday 4pm, Room 104, or Thursday 9am, Zoom [P2]
Loop ख़त्म
पहली query के शब्द oh और timings किसी passage में नहीं हैं। दूसरी query के office और hours, दोनों office hours page में हैं, इसलिए उसका score 2 है। Queue log में office है, लेकिन hours की जगह hour लिखा है, इसलिए उसका score 1 है। जवाब का [P2] office hours page का ID है।
दूसरा कदम पहले कदम के observation से निकला: कुछ नहीं मिला, इसलिए agent ने query दोबारा लिखी। ये lesson 6 वाली है। Lesson 6 की Advanced RAG pipeline हर query को rewrite करती है, और इसमें हर query पर एक extra LLM call लगती है। Agent के हर कदम पर भी एक LLM call लगती है, लेकिन rewrite वाला कदम यहाँ तभी आया, जब search खाली लौटी।
पहले सोचिए
मान लीजिए user ने पहली बार में ही office hour timings लिखा। Observation में किसका score कितना होगा, और क्या agent को query दोबारा लिखनी पड़ेगी?
जवाब देखिए
Queue log में office और hour, दोनों हैं, इसलिए उसका score 2 है। Office hours page में सिर्फ़ office है, इसलिए 1। Search खाली नहीं लौटी, तो query बदलने की वजह नहीं। लेकिन queue log में समय है, जगह नहीं, इसलिए agent को अब ये तय करना है कि जो मिला वो काफ़ी है या नहीं। ये अगले पड़ाव का तीसरा फ़ैसला है।
2तीन फ़ैसले, और pipeline कहाँ चूकती है
ढूँढने वाले agent के सामने हर कदम पर तीन फ़ैसले आते हैं। पहला, ढूँढें या सीधे जवाब दें। दूसरा, कौन सी query भेजें। तीसरा, जो मिला वो काफ़ी अच्छा है या नहीं। पड़ाव 1 के loop में तीनों दिखे: agent ने ढूँढना चुना, फिर नई query लिखी, और फिर नतीजे को काफ़ी मानकर जवाब लिखा।
Pipeline ये फ़ैसले नहीं लेती, वो हर सवाल पर वही steps चलाती है। नीचे हर फ़ैसले के लिए एक सवाल है, जिस पर pipeline चूकती है:
फ़ैसला
सवाल
Pipeline क्या करती है
Agent क्या कर सकता है
1. ढूँढें?
17 × 3 कितना है?
60,000 passages में ढूँढती हैऔर करीब 2,500 tokens prompt में डालती है
0 searches, सीधा जवाब: 51
2. कौन सी query?
OH timings?
वही query भेजती है, 0 passages पाती है
Search खाली आई, तो query बदलता है
3. काफ़ी अच्छा?
Least crowded, K = 1
अकेला forum post भेजती है
Post 2024 की राय है, तो दोबारा ढूँढता है
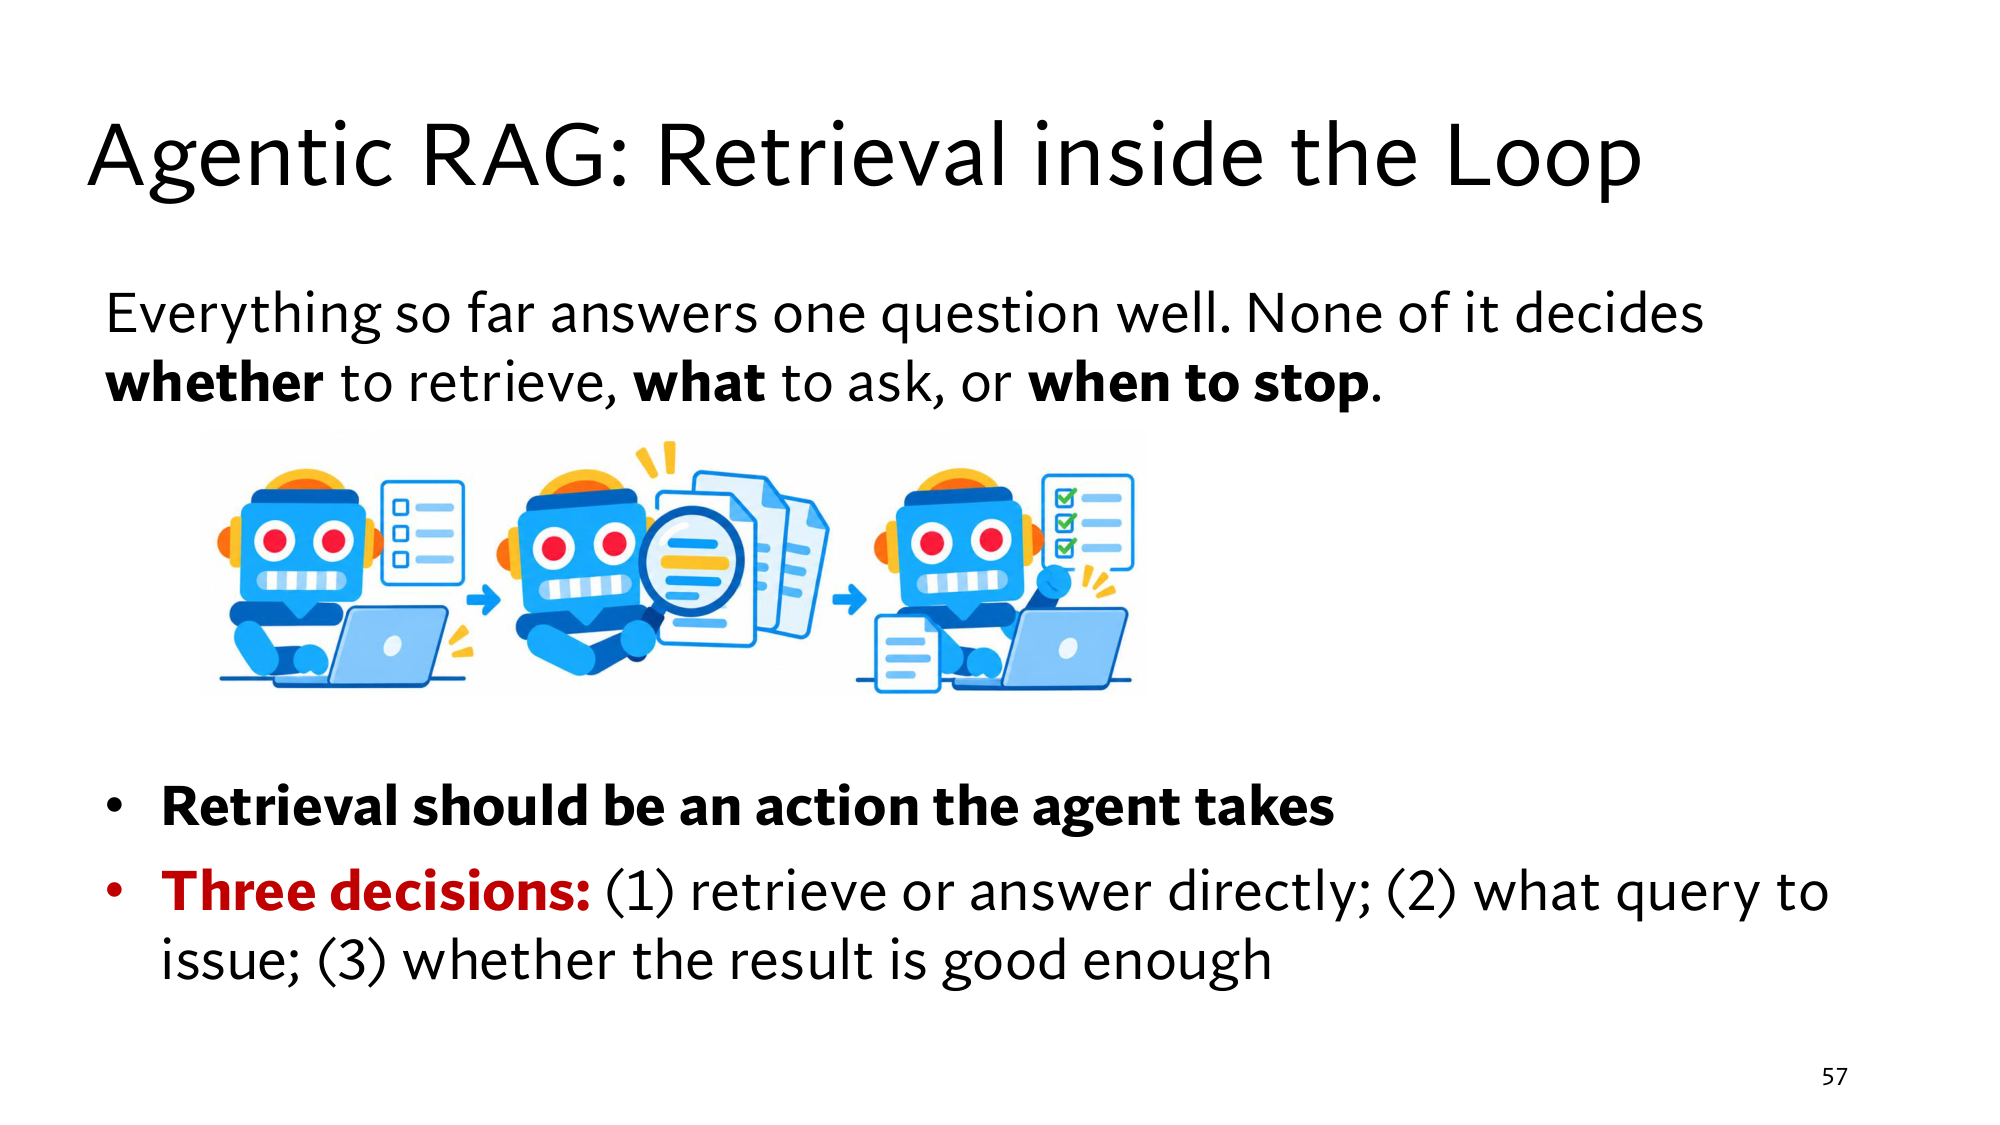
RAG में ढूँढना जब agent का action बन जाए, और ये तीनों फ़ैसले हर कदम पर हों, तो उसे agentic RAG कहते हैं। Stanford की slide यही कहती है:
Stanford की slide: loop के अंदर retrieval। ऊपर लिखा है कि अब तक की कोई चीज़ तय नहीं करती कि ढूँढना है या नहीं, क्या पूछना है, और कब रुकना है। नीचे वही तीन फ़ैसले हैं। Image पर click करने से वो पूरे size में खुलती है।
ऊपर का when to stop और नीचे का तीसरा फ़ैसला एक ही बात है। नतीजा काफ़ी अच्छा है, तो agent रुककर जवाब लिखता है, और नहीं है, तो फिर से ढूँढता है।
अब सवाल ये है कि ये फ़ैसले कौन ले। ये lesson दो जवाब देता है। Self-RAG में जवाब लिखने वाला model खुद फ़ैसले लेता है, और CRAG में एक अलग, छोटा model नतीजा परखता है।
3Self-RAG: फ़ैसले tokens में
सबसे सीधा तरीका ये है कि वही LLM फ़ैसले ले, जो जवाब लिख रहा है, क्योंकि वो सवाल और passages, दोनों पढ़ रहा है। दिक्कत ये है कि LLM सिर्फ़ लिखता है, और अलग से कोई फ़ैसला नहीं सुनाता।
Self-RAG इसका हल ये निकालता है कि फ़ैसले भी tokens बन जाएँ। वो model की में कुछ खास tokens जोड़ता है, जिन्हें reflection tokens कहते हैं। Model की खास training होती है, और फिर वो इन्हें बाकी text की तरह लिखता है। Self-RAG Asai और साथियों का 2024 का तरीका है, और इसके मुख्य tokens ये हैं:
Token
मतलब
फ़ैसला
Retrieve
अभी ढूँढना है
फ़ैसला 1
Relevant / Irrelevant
मिला हुआ passage सवाल के काम का है या नहीं
फ़ैसला 3
Supported / Partially
Model का लिखा हिस्सा passage से पूरा साबित होता है, या आधा
फ़ैसला 3 की दूसरी जाँच
Paper में कुछ और tokens भी हैं, जैसे No support। एक चौथी किस्म पूरे जवाब को 1 से 5 तक का score देती है, और वो गहरे version में है।
अब हमारा सवाल लीजिए: Which office hour this week is least crowded? मान लीजिए model ने Retrieve लिखा, और retriever queue log, पुराना forum post और Homework 1 की announcement लाया। Model हर passage के साथ अलग से अगला हिस्सा लिखता है, और हर हिस्से के साथ reflection tokens भी। ये example और tokens मेरे हैं
Passage
Reflection tokens
Model का लिखा हिस्सा
Queue log
Relevant, Supported
Thursday 9am, about 3 waiting.
पुराना forum post
Relevant, Partially
Wednesday afternoon is quietest.
Homework 1 की announcement
?
Homework 1 will be released on Oct 5.
Forum post वाला हिस्सा Partially है, क्योंकि post में midweek लिखा है, Wednesday नहीं, और साथ में usually भी। यानी Wednesday वाली बात passage में आधी ही है। Queue log वाली बात queue log में पूरी लिखी है, इसलिए वो हिस्सा Supported है।
तीसरी row आप निकालिए
Homework वाले हिस्से पर कौन सा token लगेगा? तीनों हिस्सों का क्रम क्या होगा, और जवाब में कौन सा हिस्सा जुड़ेगा?
जवाब देखिए
Irrelevant। Homework की तारीख सच है, और announcement से साबित भी होती है, लेकिन सवाल office hours की भीड़ का है। क्रम है: queue log, फिर forum post, फिर Homework। Queue log वाला हिस्सा Relevant और Supported है, इसलिए जवाब में वही जुड़ता है: Thursday 9am।
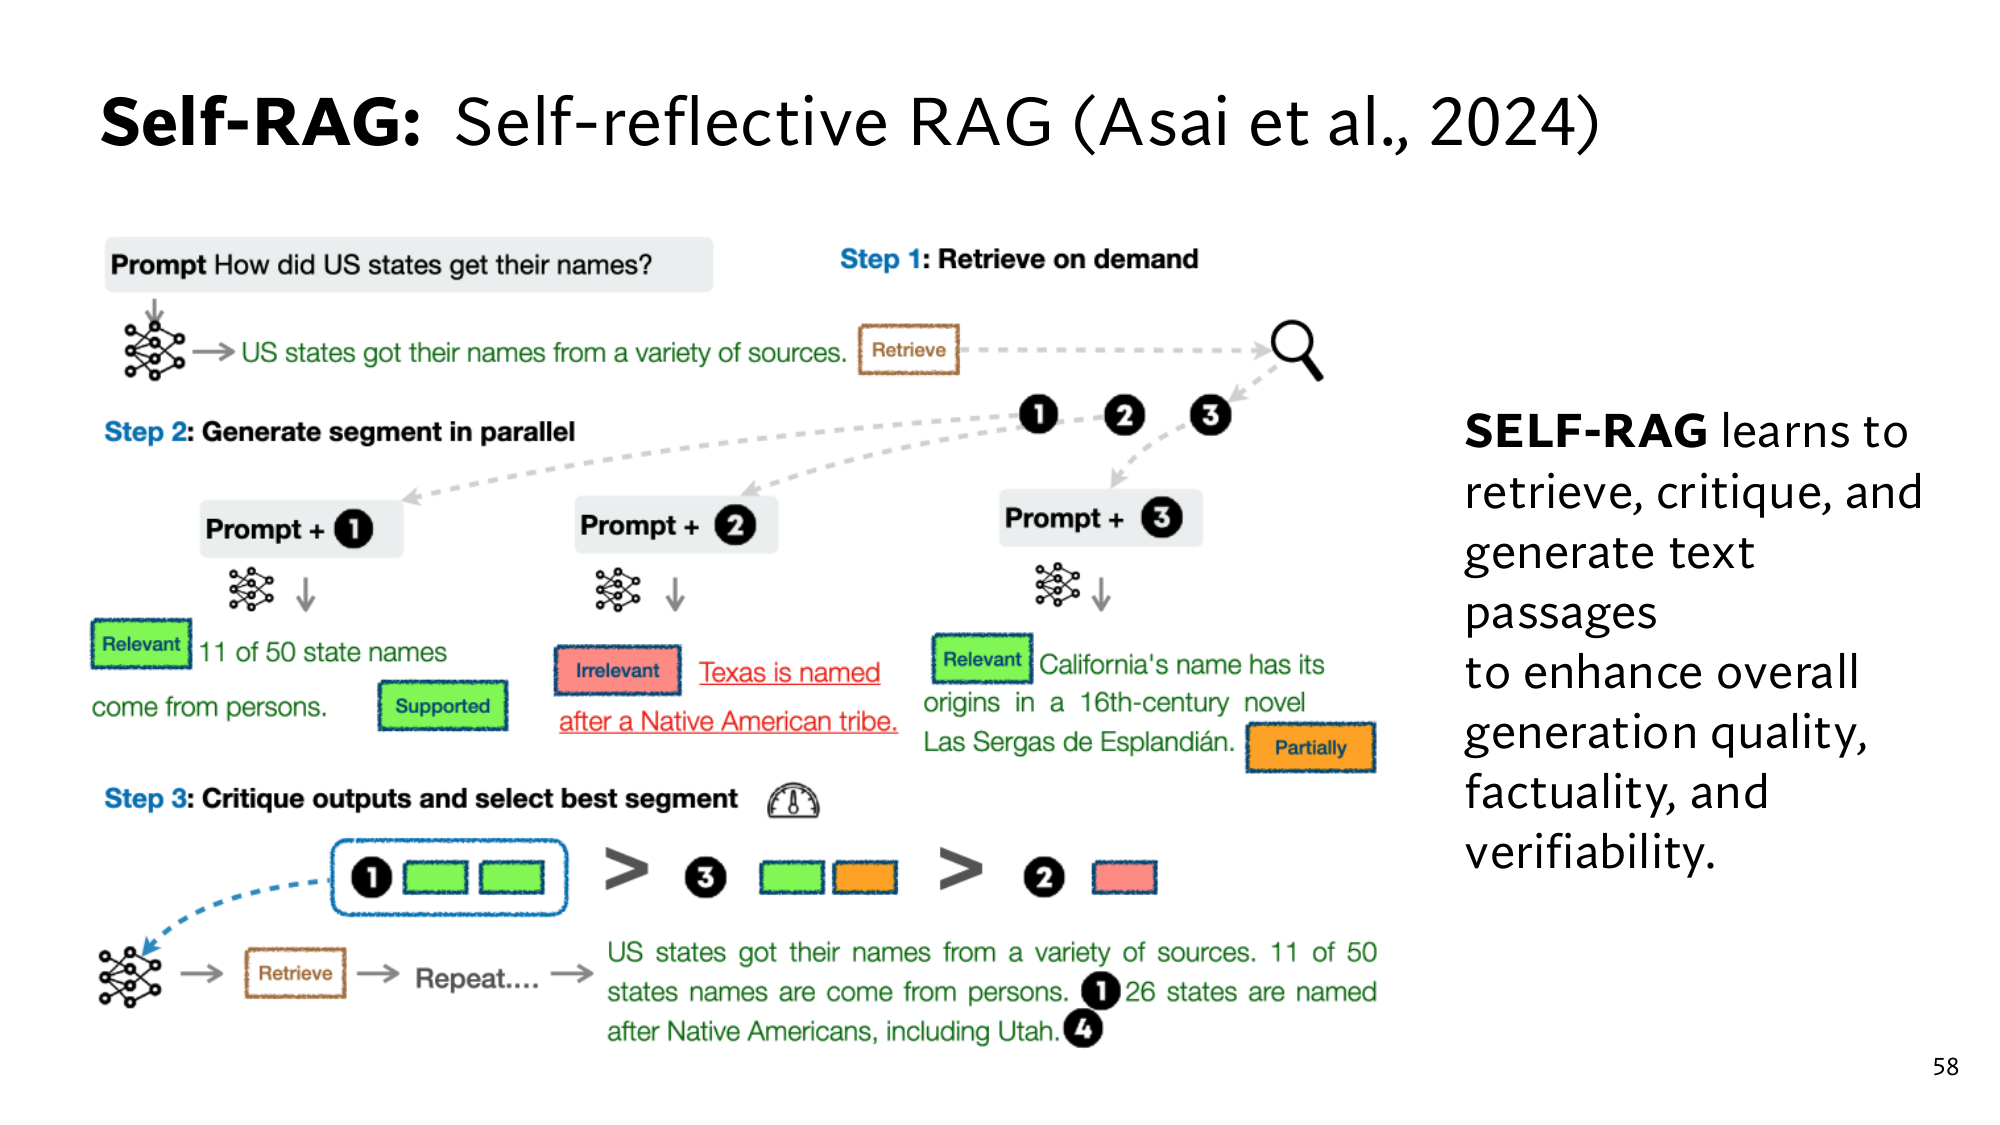
तो Self-RAG हर हिस्से को दो बातों पर परखता है: बात सवाल के काम की है या नहीं, और passage से साबित है या नहीं। Stanford की slide पर paper का अपना example है, और अब आप उसे पढ़ सकते हैं:
Stanford की slide: Self-RAG के तीन steps। हरे box अच्छे tokens हैं, नारंगी box Partially है, और लाल box Irrelevant।
Step 1 में model पहला sentence लिखता है, फिर Retrieve, और तीन passages आते हैं। Step 2 में वो हर passage के साथ एक हिस्सा लिखता है, और step 3 में tokens से क्रम बनता है: 1 > 3 > 2। Texas वाली बात सच है, लेकिन उसका passage Irrelevant है, इसलिए वो सबसे नीचे है। फिर model दोबारा Retrieve लिखता है, और यही दोहराता है।
Self-RAG की कीमत भी है। Generator की खास training चाहिए, इसलिए API से लिया यहाँ नहीं चलता। हर passage के साथ अलग हिस्सा लिखना पड़ता है, यानी lesson 5 के की तरह K बार generation। और Supported सिर्फ़ इतना कहता है कि बात passage में है। वो ये नहीं कहता कि passage अब भी सच है।
4CRAG: अलग evaluator और दो thresholds
ज़्यादातर systems frozen LLM पर बनते हैं, इसलिए फ़ैसला 3 generator के बाहर कोई और ले। पहला idea lesson 14 का है। लेकिन reranker सिर्फ़ क्रम बदलता है। मान लीजिए retriever सिर्फ़ Homework 1 की announcement और project page लाया, जो भीड़ वाले सवाल के लिए बेकार हैं। Reranker तब भी एक को ऊपर रखेगा, और वो prompt में जाएगा। मेरा example
CRAG में एक हल्का model हर document को एक confidence देता है: ये document इस सवाल के लिए कितना सही है। इस model को retrieval evaluator कहते हैं। CRAG का पूरा नाम Corrective RAG है, और ये Yan और साथियों का 2024 का तरीका है। Confidence का अपना मतलब है, इसलिए उस पर एक पहले से तय limit रख सकते हैं, जिसे threshold कहते हैं।
CRAG दो thresholds रखता है, ऊपर वाला और नीचे वाला। यहाँ confidence 0 से 1 के बीच है, और thresholds 0.6 और 0.2 हैं। ये scale और numbers मेरे रखे हैं Paper के अपने numbers गहरे version में हैं। पहले वो case लीजिए, जिसमें retriever एक ही document लाया, यानी K = 1:
अकेला document
Confidence
फ़ैसला
Queue log
0.85
Correct0.6 से ऊपर
पुराना forum post
0.4
Ambiguous0.2 और 0.6 के बीच
Homework 1 की announcement
0.05
Incorrect0.2 से नीचे
कई documents हों, तो एक भी document 0.6 से ऊपर होने पर फ़ैसला Correct है, और Incorrect के लिए सारे 0.2 से नीचे होने चाहिए। Reranker वाले example में Homework 0.05 पर है और project page 0.1 पर, इसलिए फ़ैसला Incorrect है। project page का 0.1 मेरा हर फ़ैसले पर CRAG अलग action चलाता है:
फ़ैसला
Action
Generator को क्या मिलता है
Correct
Knowledge refinement: documents को strips में तोड़िए, बेकार strips हटाइए, बाकी जोड़िए
सवाल + साफ़ किए documents
Incorrect
Documents छोड़िए, query दोबारा लिखिए, web search कीजिए
सवाल + web का नतीजा
Ambiguous
दोनों
सवाल + साफ़ किए documents + web का नतीजा
CRAG का फ़ैसला, K = 1 पर
Retriever एक document लाया है। Evaluator का confidence बदलिए, और देखिए कि CRAG क्या करता है। Thresholds 0.6 और 0.2 हैं। thresholds और तीनों confidence मेरे रखे हैं
Correct वाले रास्ते पर भी document पूरा नहीं जाता। CRAG उसे छोटे टुकड़ों में तोड़ता है, जिन्हें strips कहते हैं। फिर वो हर strip को evaluator से परखता है, और बेकार strips हटाकर बाकी को क्रम से जोड़ता है। इसे knowledge refinement कहते हैं। सवाल When is the milestone due? पर syllabus के तीन sentences तीन strips बनते हैं: मेरा example
Syllabus की strip
रखें?
The project milestone is due Week 6, Thursday 11:59pm.
हाँ, यही जवाब है
Late days may not be applied to the milestone.
हाँ, milestone की deadline से जुड़ी है
The final report is due Week 10.
नहीं, ये final report की बात है
Generator को 3 में से 2 strips मिलती हैं। Week 10 वाली line prompt में नहीं जाती, इसलिए generator उसे milestone की तारीख नहीं समझ सकता।
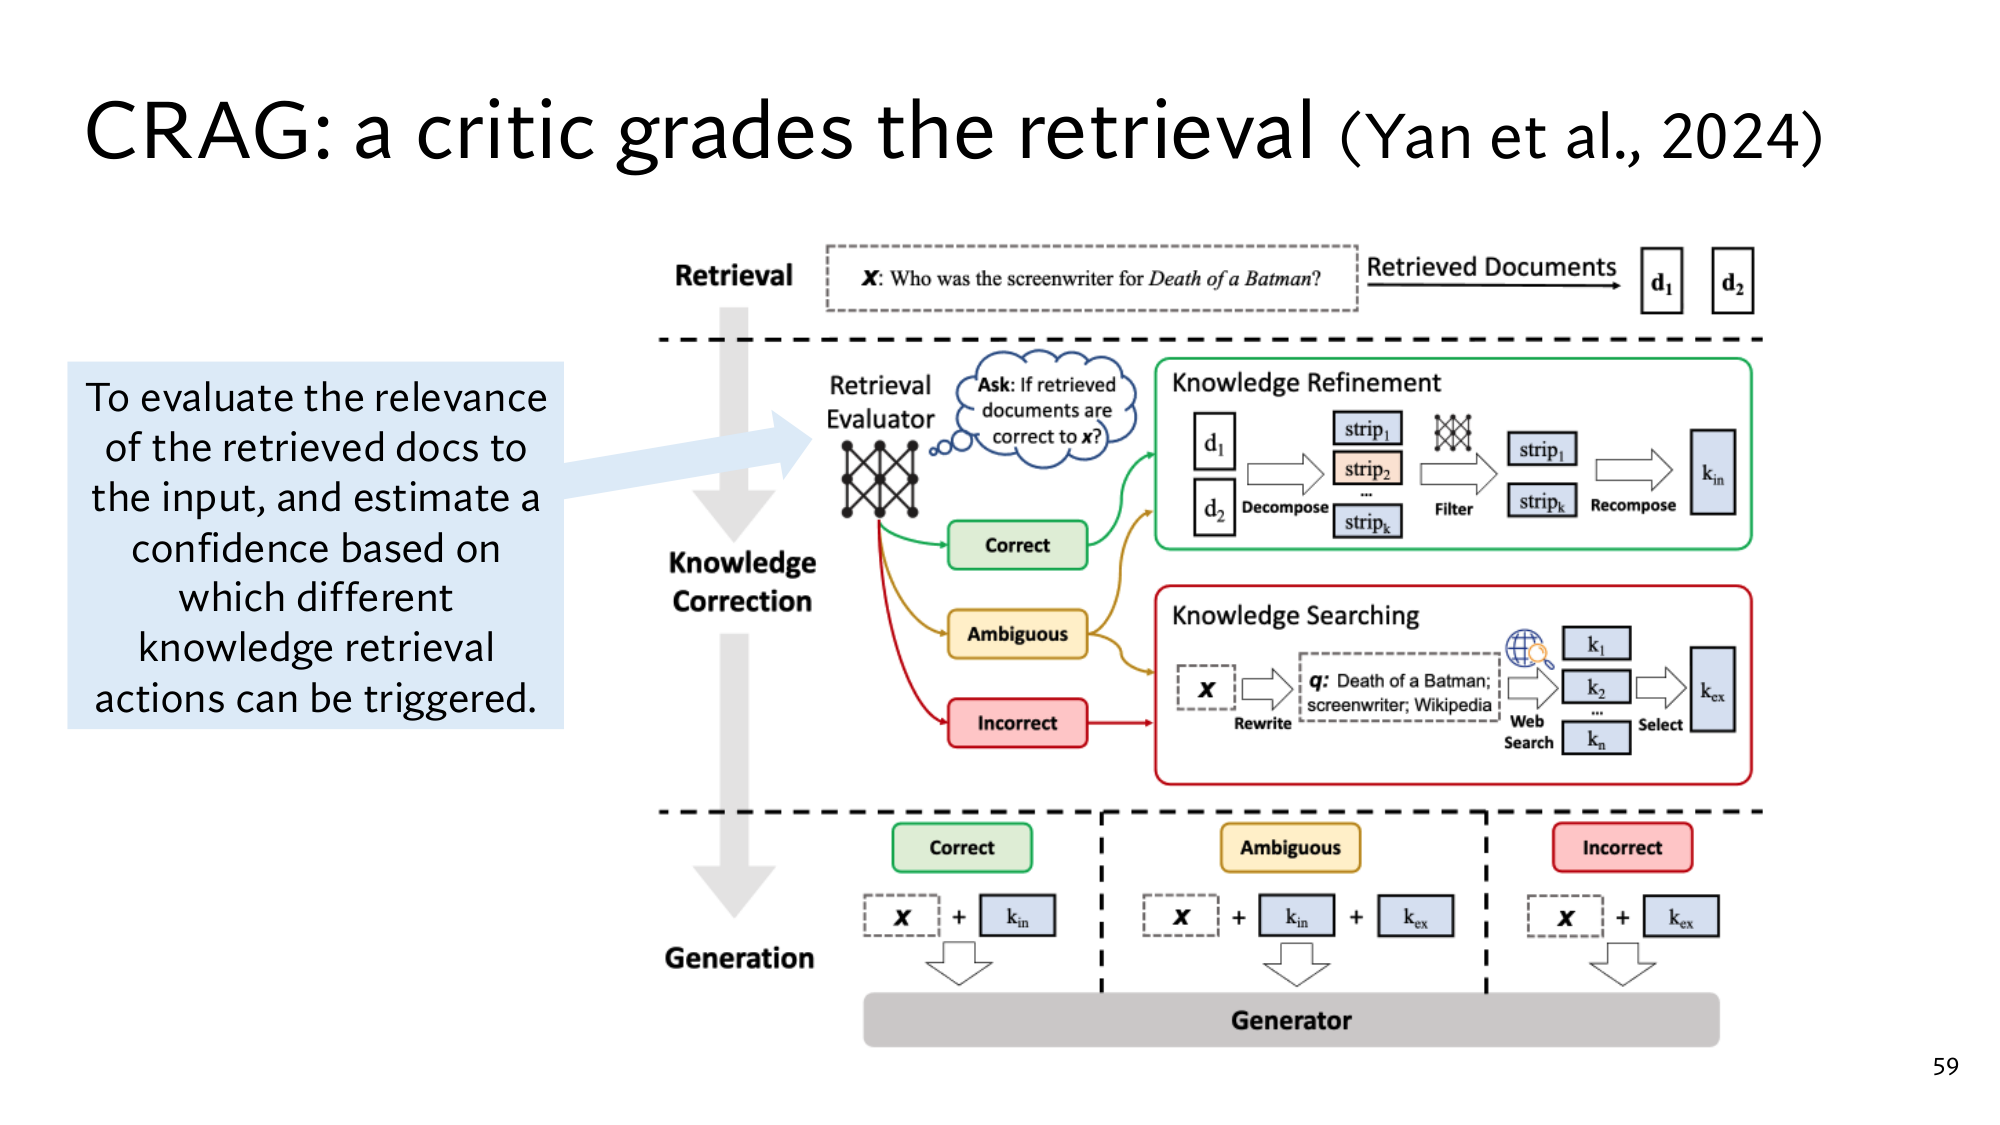
Incorrect वाले रास्ते पर CRAG अपने documents छोड़ देता है। एक LLM सवाल को search engine के लायक keywords में दोबारा लिखता है, और CRAG web पर ढूँढता है। Slide पर सवाल Who was the screenwriter for Death of a Batman? है, और नई query के तीन टुकड़े हैं: Death of a Batman, screenwriter और Wikipedia।
Stanford की slide: CRAG। Correct पर Knowledge Refinement चलता है, Incorrect पर Knowledge Searching, और Ambiguous पर दोनों। सबसे नीचे की line दिखाती है कि हर फ़ैसले पर generator को क्या मिलता है।
ध्यान दीजिए: Web से आया हर text भरोसे लायक नहीं होता। उसमें गलत बातें हो सकती हैं, या agent को भटकाने वाली instructions भी, जो lesson 18 में आती हैं। इसीलिए slide पर web search के बाद भी एक Select step है।
पहले सोचिए
K = 1 पर अकेला forum post आया, और evaluator ने उसे 0.4 दिया। CRAG क्या करेगा, और generator को क्या मिलेगा?
जवाब देखिए
0.4, 0.2 और 0.6 के बीच है, इसलिए फ़ैसला Ambiguous है। CRAG forum post को refine करके रखेगा, और query दोबारा लिखकर web search भी करेगा। Generator को सवाल, forum post का साफ़ हिस्सा और web का नतीजा, तीनों मिलेंगे।
5Self-RAG और CRAG साथ-साथ, और उनकी हद
अब शुरू के दोनों सवालों पर लौटिए। 17 × 3 पर ठीक से train हुआ Self-RAG Retrieve नहीं लिखता, और सीधे 51 लिखता है। Paper के example में भी essay वाले prompt पर model नहीं ढूँढता। paper से CRAG यहाँ भी ढूँढेगा, क्योंकि वो हर सवाल पर ढूँढता है, और सिर्फ़ नतीजा परखता है।
K = 1 पर अकेला forum post आए, तो Self-RAG का Wednesday वाला हिस्सा Partially है, और model दोबारा Retrieve लिख सकता है। CRAG का evaluator forum post को 0.4 देता है, इसलिए वो web पर भी ढूँढता है। दोनों में से कोई अब forum post को बिना परखे आगे नहीं भेजता।
Self-RAG
CRAG
फ़ैसला कौन लेता है
Generator खुद, reflection tokens से
अलग evaluator, दो thresholds से
Generator बदलना पड़ता है?
हाँ, खास training
नहीं, कोई भी LLM
फ़ैसला 1: ढूँढें?
Retrieve token से
हमेशा ढूँढता है
फ़ैसला 2: कौन सी query?
अलग से query नहीं लिखताpaper से
Web के लिए query दोबारा लिखता है
फ़ैसला 3: काफ़ी अच्छा?
Relevant और Supported tokens से
Evaluator के confidence से
दोनों की हद भी है। CRAG के thresholds इंसान रखता है, और evaluator भी गलती कर सकता है। Self-RAG के reflection tokens भी model ही लिखता है, इसलिए वो भी गलत हो सकते हैं। और दोनों में से किसी ने ये फ़ैसले खुद कोशिश करके नहीं सीखे।
Lesson 17 में model ये फ़ैसले कोशिश करके और नतीजा देखकर सीखता है: कब ढूँढना है, कौन सी query लिखनी है, और कब रुकना है। Loop में एक गलत फ़ैसला अगले कदमों पर असर डालता है, और ये बात lesson 18 में आती है।
गहरे version में और क्या है
गहरे version में ये पूरा lesson है, और उसके बाद 4 पड़ाव और, जो Stanford की slides के level तक ले जाते हैं:
पड़ाव 6: Self-RAG के चारों तरह के tokens, उनकी probabilities, Retrieve का threshold δ, और हर हिस्से का वज़न वाला score।
पड़ाव 7: Self-RAG की training और paper के नतीजे, points में पढ़े हुए।
पड़ाव 8: CRAG का असली evaluator, −1 से 1 वाला scale, paper के thresholds, documents के set पर फ़ैसले, और नतीजे।
पड़ाव 9: Stanford की तीनों agentic RAG slides, जिन्हें आप खुद पढ़ते हैं।
Agent loop में action लेता है, observation पढ़ता है, और अगला action तय करता है। Agentic RAG में ढूँढना ऐसा ही एक action है।
हर कदम पर तीन फ़ैसले हैं: ढूँढें या नहीं, कौन सी query भेजें, और नतीजा काफ़ी अच्छा है या नहीं। Pipeline ये फ़ैसले नहीं लेती।
Self-RAG ये फ़ैसले generator के अंदर reflection tokens से लेता है। CRAG एक अलग evaluator और दो thresholds से नतीजा परखता है, और गलत retrieval पर web search करता है।
इस lesson के नए शब्द
Agent
Loop में काम करने वाला LLM, जो action चुनता है, observation पढ़ता है, और अगला action तय करता है। जैसे OH timings की search खाली आई, तो agent ने नई query लिखी।
Action और tool
Agent का चुना काम, जैसे OH timings search करना। Tool वो program है, जो ये काम करता है, जैसे search engine।
Observation
Action का नतीजा, जो agent अगले कदम से पहले पढ़ता है। जैसे पहली search का नतीजा: हर passage का score 0।
Agentic RAG
RAG, जिसमें ढूँढना agent का action है, pipeline का तय step नहीं। जैसे 17 × 3 पर 0 searches, और Jed Hoyer वाले सवाल पर 3।
Self-RAG
Generator खुद reflection tokens लिखकर तय करता है कि कब ढूँढना है, और कौन सा हिस्सा रखना है। जैसे forum post वाले हिस्से पर Relevant और Partially।
Reflection tokens
Vocabulary में जोड़े गए खास tokens, जिन्हें model बाकी text की तरह लिखता है। जैसे Retrieve, Relevant या Irrelevant, और Supported या Partially।
CRAG
Corrective RAG: एक evaluator retrieval को Correct, Incorrect या Ambiguous कहता है, और उसी हिसाब से refinement, web search या दोनों चलते हैं। जैसे 0.4 वाला forum post Ambiguous है।
Retrieval evaluator
सवाल और एक document पढ़कर confidence देने वाला हल्का model। जैसे K = 1 पर forum post को 0.4।
Knowledge refinement
Documents को strips में तोड़ना, बेकार strips हटाना, और बाकी को क्रम से जोड़ना। जैसे milestone वाले सवाल पर syllabus की 3 में से 2 strips रहती हैं।
Threshold
पहले से तय limit, जिसके ऊपर या नीचे होने पर अलग action चलता है। जैसे CRAG में 0.6 से ऊपर Correct, और 0.2 से नीचे Incorrect।